Bài trước ta tăng default_statistics_target để thống kê từng cột chi tiết hơn. Nhưng có một loại ước lượng sai mà nó không cứu được: khi nhiều cột tương quan với nhau. Planner mặc định giả định các cột độc lập và nhân xác suất — một giả định sai lầm khi thanh_pho = 'Ha Noi' luôn kéo theo quoc_gia = 'VN'. Bài này đo cái bẫy đó và cách CREATE STATISTICS sửa nó — một công cụ nâng cao nhưng cực kỳ hữu ích.
Vấn đề: planner nhân xác suất của các cột độc lập
Khi bạn viết WHERE thanh_pho = 'Ha Noi' AND quoc_gia = 'VN', planner ước lượng độ chọn lọc bằng cách nhân xác suất từng điều kiện: P(Ha Noi) × P(VN). Với 6 thành phố và 3 quốc gia phân bố đều, đó là 1/6 × 1/3 = 1/18. Trên 2 triệu dòng, ước lượng ~111.000.
Nhưng thực tế thanh_pho = 'Ha Noi' khớp 333.333 dòng, và tất cả đều có quoc_gia = 'VN' — điều kiện thứ hai hoàn toàn thừa. Ước lượng đúng phải là 333.333, không phải 111.000. Planner thiếu 3 lần, vì nó không biết hai cột phụ thuộc nhau.
WHERE thanh_pho = 'Ha Noi' AND quoc_gia = 'VN';
-- Planner: P = 1/6 × 1/3 = 1/18 → ước lượng 111k (thực tế 333k)
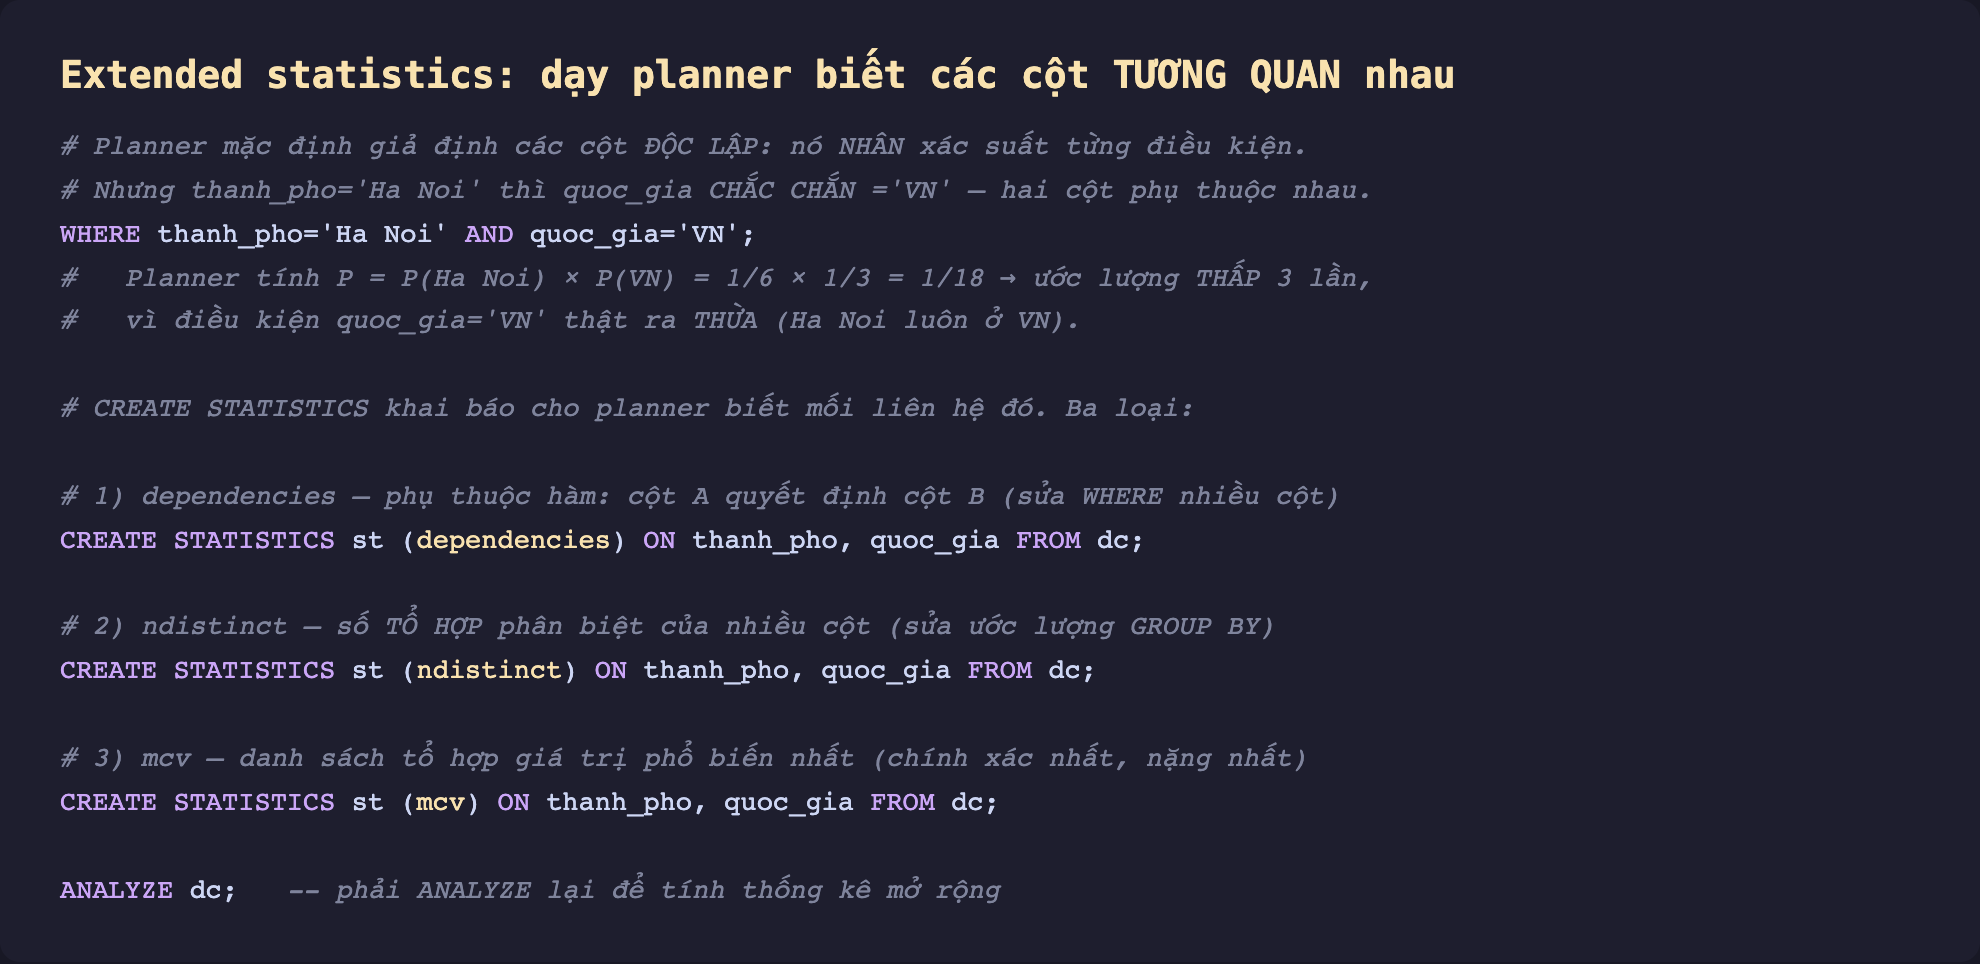
Hình 1: Planner nhân xác suất giả định cột độc lập. CREATE STATISTICS khai báo mối liên hệ giữa cột, với ba loại: dependencies (phụ thuộc hàm), ndistinct (số tổ hợp), mcv (giá trị phổ biến tổ hợp).
Đo thật: từ thiếu 3 lần thành khớp
Tạo extended statistics loại dependencies trên hai cột, rồi ANALYZE:
CREATE STATISTICS st (dependencies) ON thanh_pho, quoc_gia FROM dc;
ANALYZE dc;
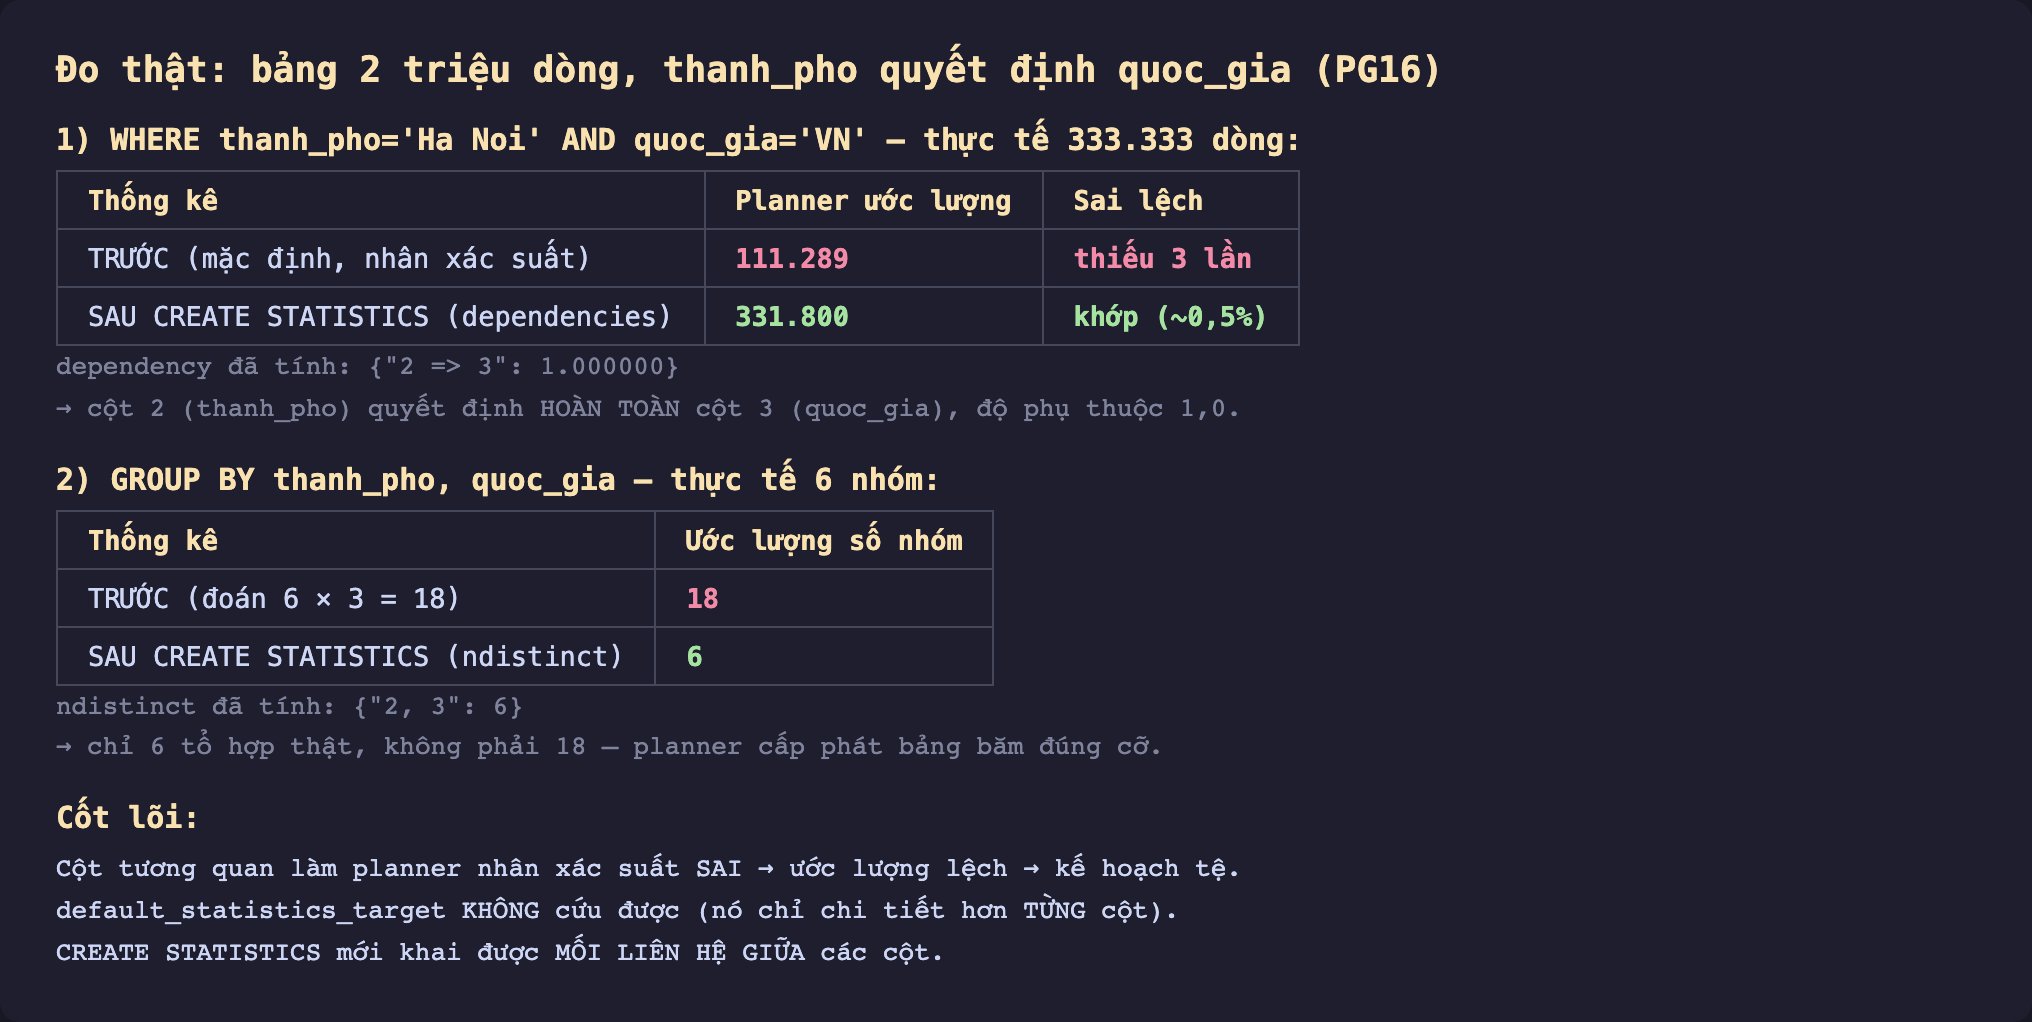
Hình 2: Sau CREATE STATISTICS (dependencies), ước lượng WHERE từ 111.289 (thiếu 3 lần) thành 331.800 (khớp 333.333). Với ndistinct, số nhóm GROUP BY từ 18 (6×3 sai) về đúng 6.
Kết quả rõ ràng:
- Trước: ước lượng
WHERE thanh_pho='Ha Noi' AND quoc_gia='VN'= 111.289 (thiếu 3 lần). - Sau
CREATE STATISTICS (dependencies): ước lượng = 331.800, khớp thực tế (~0,5%).
PostgreSQL đã tính ra phụ thuộc hàm {"2 => 3": 1.000000} — cột 2 (thanh_pho) quyết định hoàn toàn cột 3 (quoc_gia), độ phụ thuộc 1,0. Giờ planner biết điều kiện thứ hai là thừa và không nhân xác suất nữa.
Ba loại extended statistics
CREATE STATISTICS hỗ trợ ba loại, mỗi loại sửa một kiểu ước lượng:
dependencies — phụ thuộc hàm. Sửa ước lượng cho WHERE nhiều cột tương quan, như ví dụ trên. Nhẹ và hiệu quả khi một cột quyết định cột khác.
ndistinct — số tổ hợp phân biệt. Sửa ước lượng số nhóm cho GROUP BY nhiều cột. Đo thật: GROUP BY thanh_pho, quoc_gia — planner mặc định đoán 6 × 3 = 18 nhóm, nhưng thực tế chỉ 6 tổ hợp (mỗi thành phố một quốc gia). Sau CREATE STATISTICS (ndistinct), ước lượng về đúng 6 ({"2, 3": 6}). Ước lượng số nhóm đúng giúp planner chọn đúng giữa HashAggregate và GroupAggregate, và cấp phát bảng băm đúng cỡ.
mcv — giá trị phổ biến tổ hợp. Lưu danh sách các tổ hợp giá trị phổ biến nhất kèm tần suất — chính xác nhất nhưng nặng nhất. Dùng khi dependencies không đủ (ví dụ tương quan một phần, không phải phụ thuộc hoàn toàn).
Có thể khai nhiều loại trong một câu: CREATE STATISTICS st (dependencies, ndistinct, mcv) ON ....
Đánh đổi cần cân nhắc
Phải ANALYZE lại sau khi tạo. CREATE STATISTICS chỉ khai báo thống kê cần tính; giá trị chỉ được điền sau lần ANALYZE kế tiếp. Quên bước này thì thống kê mở rộng rỗng và vô tác dụng.
Chỉ tạo cho cột thật sự tương quan và thật sự query cùng nhau. Extended statistics thêm chi phí cho mỗi ANALYZE. Đừng rải nó lên mọi cặp cột — chỉ tạo khi bạn đo được ước lượng sai (so rows vs actual trong EXPLAIN ANALYZE) do tương quan, và các cột đó xuất hiện chung trong WHERE/GROUP BY của truy vấn quan trọng.
mcv nặng nhất, dùng cuối cùng. Thử dependencies/ndistinct trước — chúng nhẹ và giải quyết phần lớn trường hợp. Chỉ thêm mcv khi tương quan phức tạp mà hai loại kia chưa đủ.
Nhớ các bậc sửa ước lượng. Thứ tự chẩn đoán một ước lượng sai: (1) thống kê có mới không → ANALYZE; (2) cột lệch một mình đoán sai → SET STATISTICS cao hơn; (3) nhiều cột tương quan → CREATE STATISTICS. Ba công cụ cho ba nguyên nhân khác nhau.
Ba ý mang về
- Planner giả định các cột độc lập và nhân xác suất — nên với cột tương quan, nó ước lượng sai: đo thật,
WHEREtrên hai cột phụ thuộc bị thiếu 3 lần (111k thay vì 333k) vì điều kiện thứ hai thực ra thừa. CREATE STATISTICSkhai báo mối liên hệ giữa cột màdefault_statistics_targetkhông làm được:dependenciessửa ước lượngWHERE(về khớp 331k),ndistinctsửa số nhómGROUP BY(18 về đúng 6),mcvcho tổ hợp phức tạp.- Chỉ tạo cho cột thật sự tương quan và query cùng nhau, và nhớ
ANALYZElại để điền giá trị — extended statistics là bậc thứ ba trong chẩn đoán ước lượng sai, sau ANALYZE và SET STATISTICS.
Phần sau ta tổng hợp toàn bộ chủ đề ước lượng: Phần sau hệ thống hóa các nguyên nhân planner ước lượng sai và cách nhận diện từng loại từ EXPLAIN ANALYZE.
