Suốt bốn bài về thống kê, ta thấy ước lượng sai dẫn tới kế hoạch tệ. Giờ tổng hợp: khi nào planner ước lượng sai, và vì sao? Câu trả lời có một mẫu chung — PostgreSQL chỉ dùng được thống kê cột khi điều kiện có dạng đơn giản: cột <toán tử> hằng_số. Khi điều kiện khác dạng đó, nó mất thống kê và rơi về những con số đoán mù cứng nhắc. Bài này đo bốn thủ phạm phổ biến trên bảng 2 triệu dòng, và chỉ cách sửa từng loại.
Selectivity mặc định: con số planner dùng khi bí
PostgreSQL có sẵn các selectivity mặc định — dùng khi nó không có (hoặc không dùng được) thống kê:
- Điều kiện bằng (
=) không ước lượng nổi → 0,5% số dòng. - Điều kiện khoảng (
>,<) không ước lượng nổi → 33% số dòng.
Những con số này là phỏng đoán mù, thường sai xa thực tế. Chìa khóa là biết khi nào planner buộc phải dùng chúng.
-- Bốn dạng điều kiện planner KHÔNG ước lượng được từ thống kê cột:
WHERE upper(email) = '...';   -- hàm bọc cột
WHERE email LIKE '%abc%';     -- LIKE tiền tố mở (wildcard đầu)
WHERE id > trang_thai;        -- cột so với cột
WHERE id + 0 > 0;             -- biểu thức trên cột
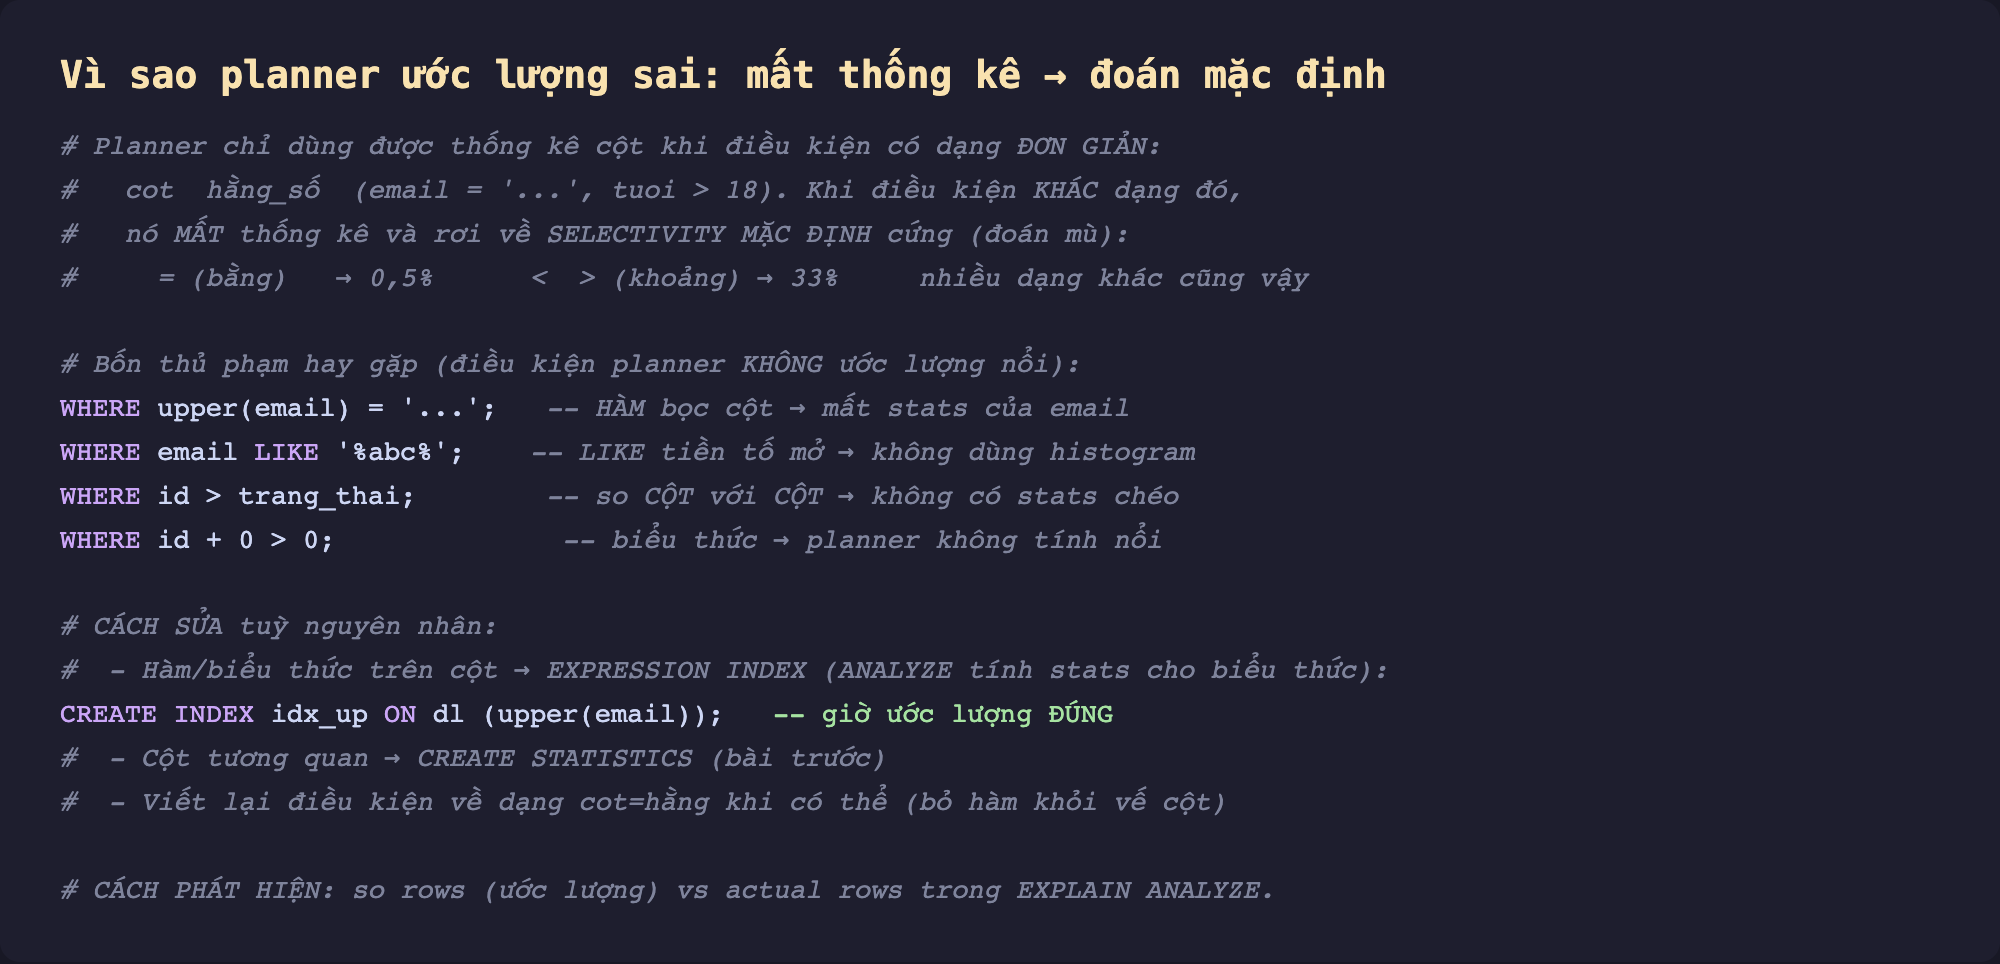
Hình 1: Planner chỉ ước lượng được điều kiện dạng cột <toán tử> hằng. Bốn dạng khác — hàm bọc cột, LIKE tiền tố mở, cột-vs-cột, biểu thức — làm nó mất thống kê và đoán mặc định.
Đo thật: bốn nguyên nhân, bốn mức sai
Chạy EXPLAIN ANALYZE cho bốn dạng điều kiện trên bảng dl 2 triệu dòng, so rows (ước lượng) với actual rows:
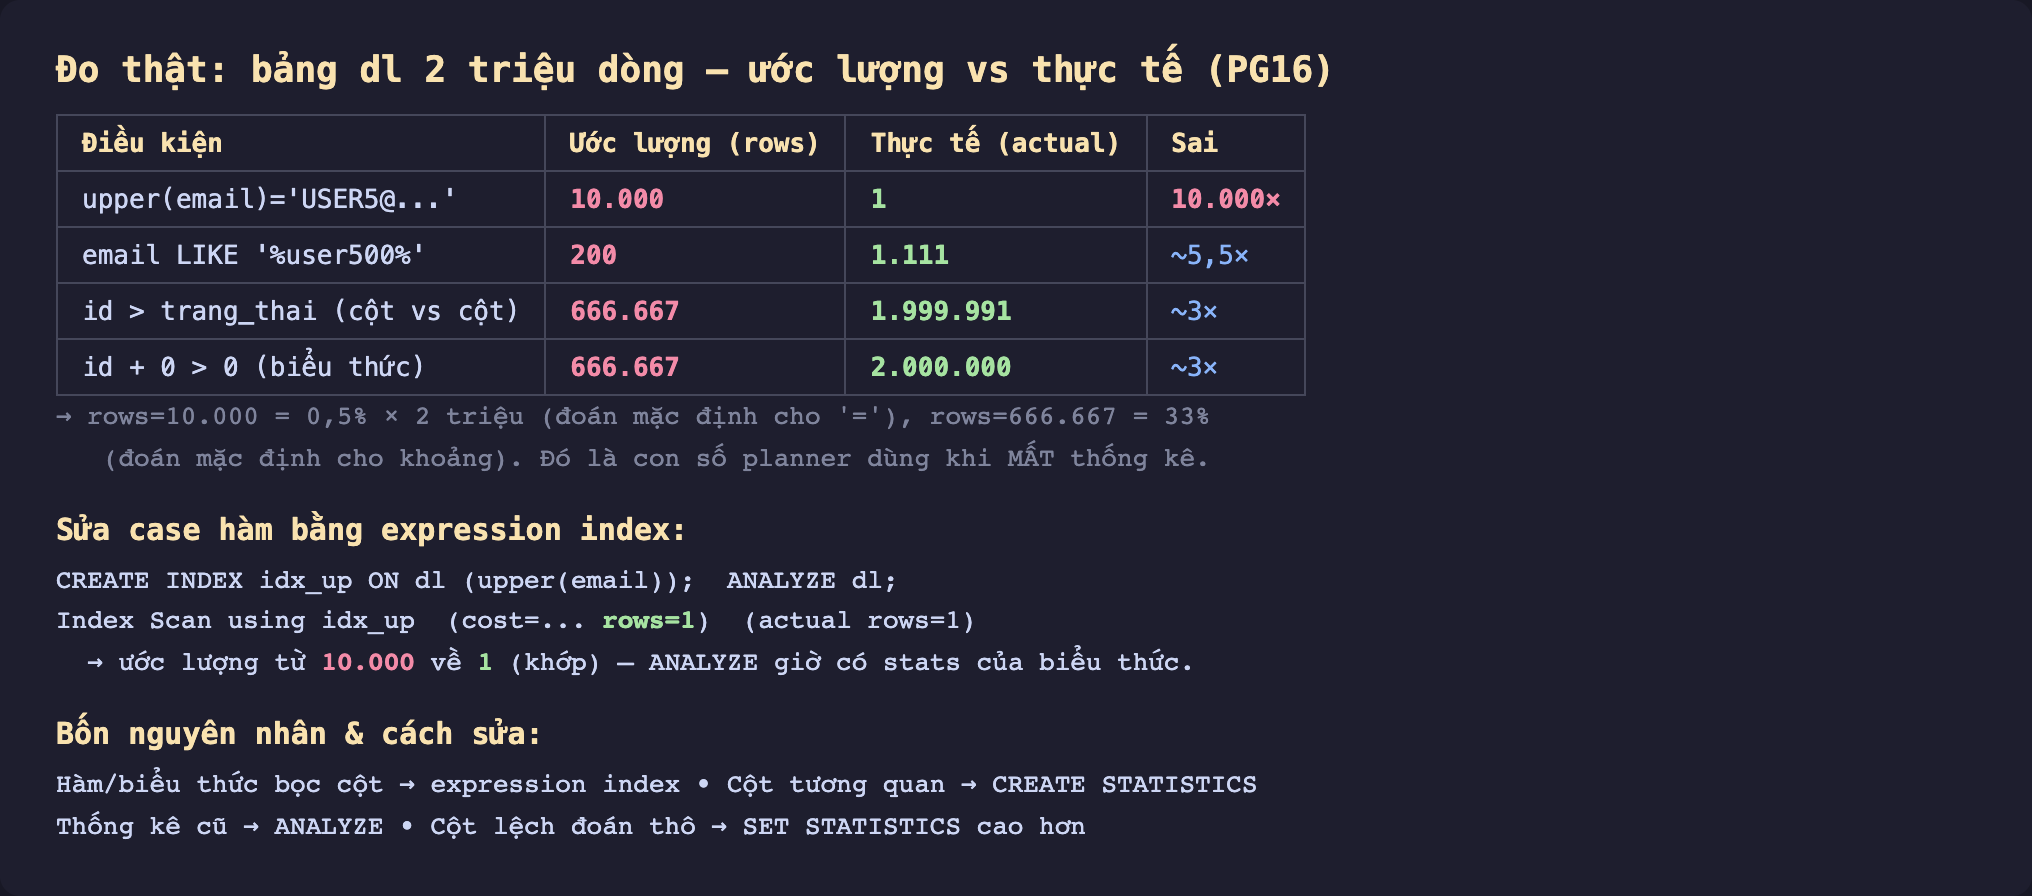
Hình 2: Bốn nguyên nhân ước lượng sai. upper(email)='...' ước lượng 10.000 (0,5% mặc định) nhưng thực tế 1 — sai 10.000 lần. id > trang_thai ước lượng 666.667 (33% mặc định) nhưng thực tế gần cả bảng. Expression index đưa ước lượng hàm về đúng.
Đọc từng dòng:
upper(email) = '...': ước lượng 10.000 (đúng 0,5% × 2 triệu — mặc định cho=), thực tế 1 dòng. Sai 10.000 lần. Vìemailbị bọc trongupper(), planner không dùng được thống kê của cộtemail.email LIKE '%user500%': ước lượng 200, thực tế 1.111. Wildcard ở đầu khiến planner không dùng được histogram (chỉ ước lượng đượcLIKE 'tiền_tố%').id > trang_thai: ước lượng 666.667 (33% mặc định cho khoảng), thực tế gần cả bảng (1.999.991). Planner không có thống kê chéo giữa hai cột.id + 0 > 0: ước lượng 666.667 (33% mặc định), thực tế cả 2 triệu. Planner không tính được giá trị biểu thứcid + 0.
Mẫu chung rất rõ: bất cứ khi nào điều kiện không phải cột = hằng hay cột > hằng đơn giản, planner rơi về 0,5% hoặc 33% — và những con số đó gần như luôn sai.
Sửa theo từng nguyên nhân
Mỗi nguyên nhân có cách chữa riêng:
Hàm/biểu thức bọc cột → expression index. Tạo index trên chính biểu thức, và ANALYZE sẽ thu thập thống kê cho biểu thức đó. Đo thật: sau CREATE INDEX idx_up ON dl (upper(email)), ước lượng upper(email)='...' từ 10.000 về 1 — khớp thực tế. (Đây là lợi ích ngoài việc tăng tốc mà bài expression index đã đo.)
CREATE INDEX idx_up ON dl (upper(email));
ANALYZE dl;   -- giờ planner ước lượng upper(email) chính xác
Cột tương quan → CREATE STATISTICS. Như bài extended statistics: khi hai cột phụ thuộc nhau và bị nhân xác suất sai.
Thống kê cũ → ANALYZE. Như bài về ANALYZE: sau nạp/xóa lớn.
Cột lệch bị đoán thô → SET STATISTICS cao hơn. Như bài default_statistics_target: giá trị tần suất trung bình rơi ngoài MCV.
Viết lại điều kiện khi có thể. Đôi khi cách rẻ nhất là bỏ hàm khỏi vế cột. WHERE email = lower('...') (hàm ở vế hằng) dùng được thống kê, khác hẳn WHERE lower(email) = '...' (hàm ở vế cột).
Đánh đổi và cách chẩn đoán
Luôn bắt đầu từ EXPLAIN ANALYZE. Cách duy nhất để biết planner ước lượng sai là so rows (ước lượng) với actual rows. Lệch một bậc trở lên (10 lần, 100 lần) là dấu hiệu rõ. Không có bước này, mọi việc tối ưu chỉ là đoán.
Không phải mọi ước lượng sai đều gây hại. Nếu truy vấn nhỏ và nhanh dù ước lượng lệch, đừng bận tâm. Chỉ đào sâu khi ước lượng sai dẫn tới kế hoạch tệ — Nested Loop lặp triệu lần, Seq Scan đáng lẽ Index Scan, HashAggregate tràn đĩa.
Expression index tốn chi phí ghi. Như mọi index, nó làm chậm INSERT/UPDATE và chiếm dung lượng. Chỉ tạo khi cả tốc độ và ước lượng đều cần.
Ba ý mang về
- Planner mất thống kê khi điều kiện không phải dạng
cột <toán tử> hằng— hàm bọc cột, LIKE tiền tố mở, cột-vs-cột, biểu thức — và rơi về selectivity mặc định cứng (0,5% cho=, 33% cho khoảng), thường sai hàng nghìn lần. - Chẩn đoán bằng cách so
rowsvớiactual rowstrongEXPLAIN ANALYZE: đo thật,upper(email)='...'ước lượng 10.000 nhưng thực tế 1 (sai 10.000 lần) vì hàm che mất thống kê cột. - Sửa theo nguyên nhân: hàm/biểu thức → expression index (đưa ước lượng về khớp), cột tương quan → CREATE STATISTICS, thống kê cũ → ANALYZE, cột lệch → SET STATISTICS, hoặc viết lại điều kiện bỏ hàm khỏi vế cột.
Phần sau ta chuyển sang một cơ chế tăng tốc khác hẳn — dùng nhiều CPU cùng lúc: Phần sau mổ xẻ parallel query, cách PostgreSQL chia một truy vấn cho nhiều worker cùng quét, và khi nào nó giúp.
