Máy chủ của bạn có 8 CPU, nhưng một truy vấn quét bảng lớn thường chỉ dùng một lõi. PostgreSQL có cách khai thác phần còn lại: parallel query — chia một truy vấn cho nhiều tiến trình worker cùng quét các phần khác nhau của bảng, rồi gom kết quả. Nghe đơn giản, nhưng nó không phải lúc nào cũng bật, và tăng tốc không tuyến tính như kỳ vọng. Bài này đo thật hiệu quả của nó trên bảng 5 triệu dòng.
Cơ chế: Gather và các worker
Khi planner quyết định chạy song song, kế hoạch xuất hiện một nút mới: Gather. Nút này thuộc về tiến trình chính (leader), nhiệm vụ là gom kết quả từ các worker. Bên dưới nó là Parallel Seq Scan — mỗi worker quét một phần của bảng.
SELECT count(*), avg(abalance) FROM pgbench_accounts WHERE abalance > -1000;
-- Gather
--   Workers Planned: 2
--   -> Parallel Seq Scan   (mỗi worker quét một phần, loops = số worker + 1)
Chi tiết đáng chú ý: loops ở nút Parallel Seq Scan bằng số worker + 1 — vì tiến trình chính cũng tham gia quét, không chỉ ngồi gom. Với 2 worker, loops=3.
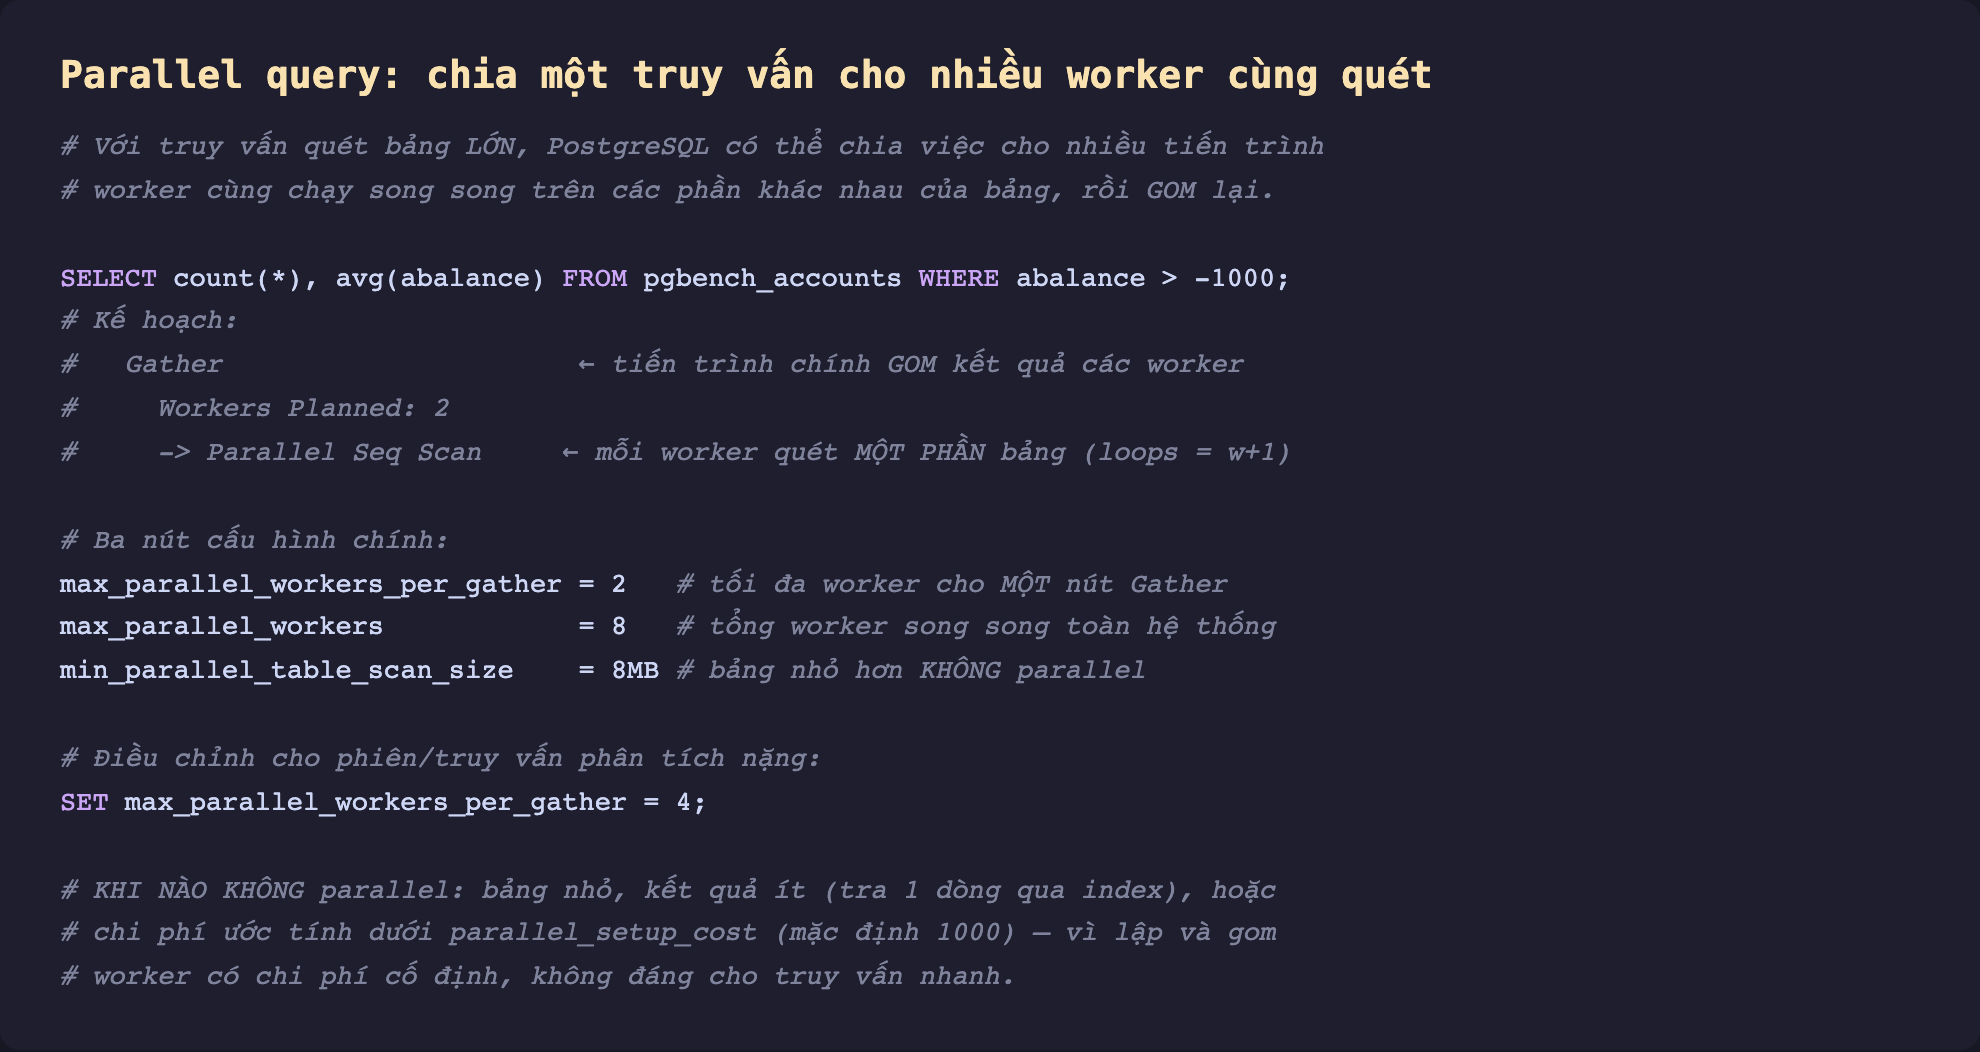
Hình 1: Parallel query dùng nút Gather (tiến trình chính gom) trên các Parallel Seq Scan (mỗi worker quét một phần). Ba nút cấu hình chính điều khiển số worker và ngưỡng kích hoạt.
Đo thật: nhanh gấp 3,5 lần, nhưng không tuyến tính
Chạy truy vấn quét + gộp trên pgbench_accounts (5 triệu dòng, 648 MB), thay đổi số worker:
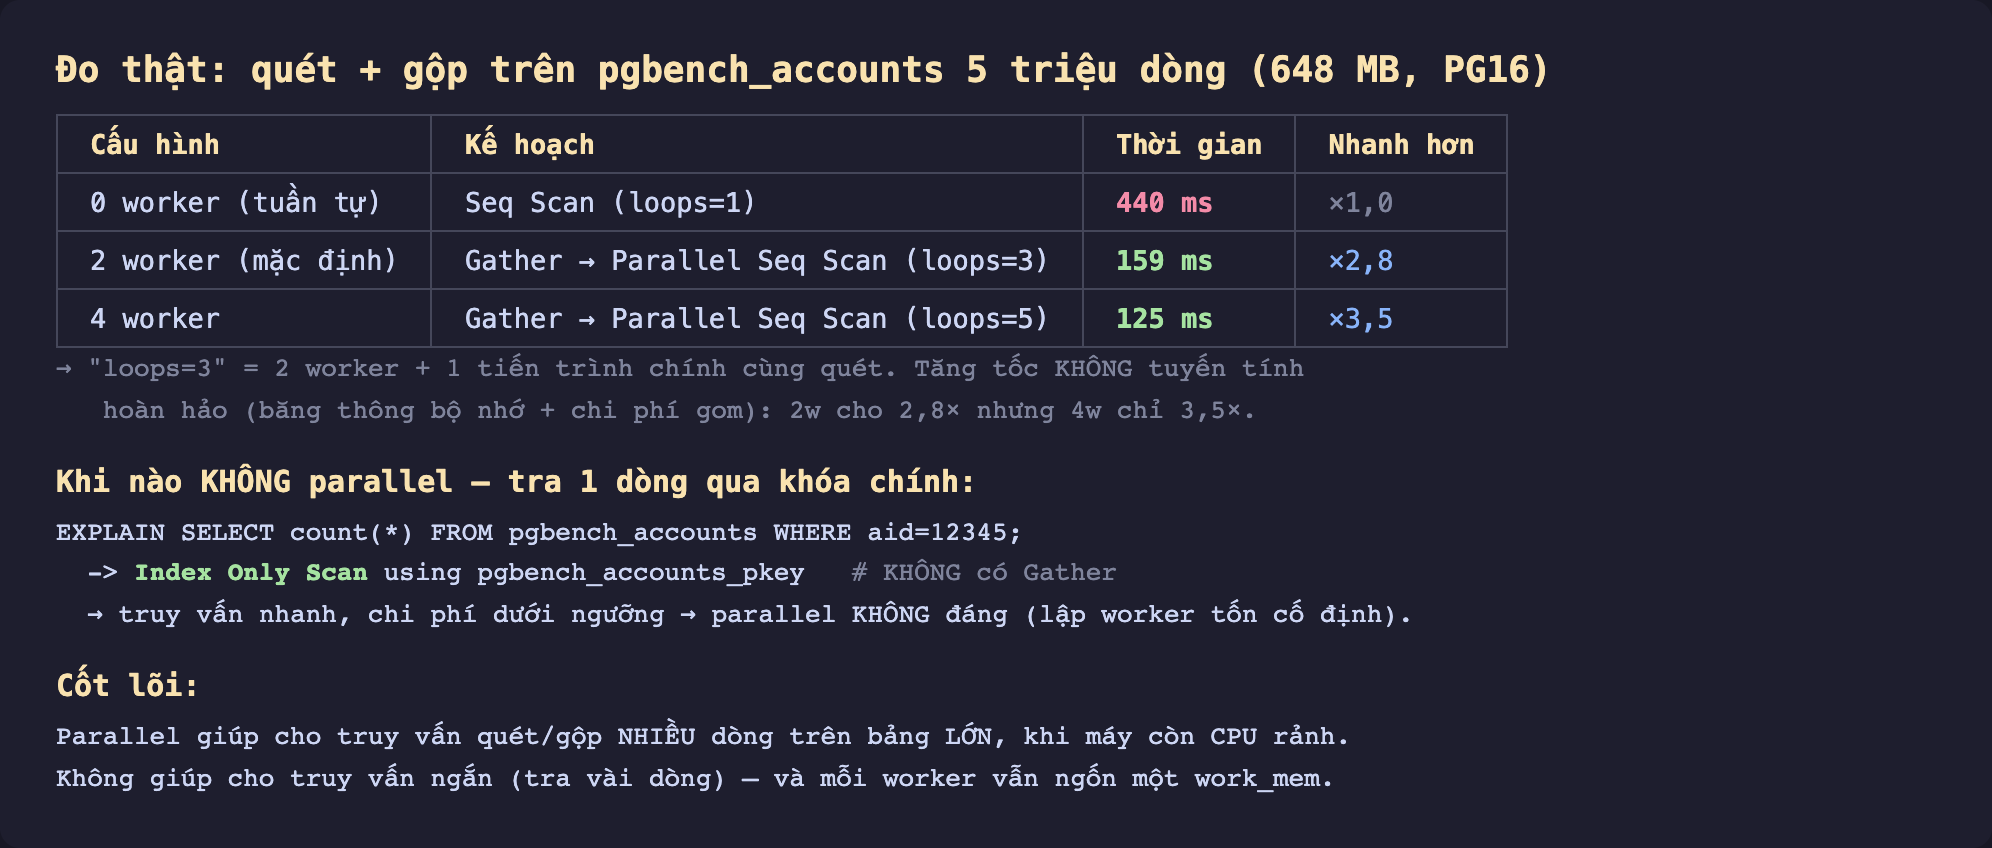
Hình 2: Quét 5 triệu dòng. 0 worker: 440 ms. 2 worker: 159 ms (~2,8×). 4 worker: 125 ms (~3,5×). Tăng tốc không tuyến tính hoàn hảo — 2 worker cho 2,8× nhưng 4 worker chỉ 3,5×.
Kết quả:
- Tuần tự (0 worker): 440 ms.
- 2 worker: 159 ms — nhanh ~2,8 lần (3 tiến trình cùng quét).
- 4 worker: 125 ms — nhanh ~3,5 lần (5 tiến trình cùng quét).
Chú ý: tăng tốc không tuyến tính. Gấp đôi worker từ 2 lên 4 chỉ cải thiện từ 2,8× lên 3,5×, không phải gấp đôi. Lý do: các worker chia sẻ băng thông bộ nhớ và đĩa (nút cổ chai vật lý), và tiến trình chính phải tốn công gom kết quả. Đây là quy luật chung của song song — lợi ích giảm dần khi thêm worker.
Khi nào PostgreSQL không parallel
Không phải truy vấn nào cũng chạy song song. Đo thật, tra một dòng qua khóa chính:
EXPLAIN SELECT count(*) FROM pgbench_accounts WHERE aid=12345;
-- Index Only Scan using pgbench_accounts_pkey   (KHÔNG có Gather)
Không có nút Gather — planner quyết định không parallel. Vì lập và gom worker có chi phí cố định (parallel_setup_cost, mặc định 1000), truy vấn nhanh (tra vài dòng qua index) không đáng trả chi phí đó. Parallel chỉ được xét khi chi phí ước tính đủ lớn và bảng vượt min_parallel_table_scan_size (mặc định 8 MB).
Ba nút cấu hình chính
max_parallel_workers_per_gather(mặc định 2): số worker tối đa cho một nút Gather. Tăng cho truy vấn phân tích nặng:SET max_parallel_workers_per_gather = 4.max_parallel_workers(mặc định 8): tổng số worker song song trên toàn hệ thống, chia sẻ giữa mọi truy vấn đang chạy.min_parallel_table_scan_size(mặc định 8 MB): bảng nhỏ hơn ngưỡng này không được parallel.
Đánh đổi cần cân nhắc
Mỗi worker là một tiến trình thật, ngốn tài nguyên. Chúng lấy từ max_worker_processes (mặc định 8) — nhóm dùng chung cho cả parallel query, logical replication, và extension. Đặt max_parallel_workers_per_gather quá cao trên hệ thống nhiều kết nối đồng thời có thể làm cạn nhóm worker.
Mỗi worker lại có work_mem riêng. Một Parallel Hash Join với work_mem = 64MB và 4 worker có thể dùng tới 5 × 64 = 320MB. Nhân đôi cạm bẫy work_mem từ các bài trước.
Parallel giúp thông lượng phân tích, không giúp OLTP. Với hệ thống nhiều truy vấn ngắn đồng thời (OLTP), CPU đã bận — parallel một truy vấn chỉ cướp lõi của truy vấn khác. Nó tỏa sáng cho truy vấn phân tích nặng chạy khi máy còn lõi rảnh (báo cáo, ETL, tổng hợp lớn).
Một số thao tác không parallel được. Ghi dữ liệu (INSERT/UPDATE/DELETE thường), hàm đánh dấu PARALLEL UNSAFE, và một số cấu trúc truy vấn chặn parallel. Kiểm bằng EXPLAIN xem có Gather không.
Ba ý mang về
- Parallel query chia truy vấn quét/gộp bảng lớn cho nhiều worker qua nút
GathertrênParallel Seq Scan— đo thật, quét 5 triệu dòng nhanh từ 440 ms xuống 159 ms (2 worker) và 125 ms (4 worker). - Tăng tốc không tuyến tính: 2 worker cho 2,8× nhưng 4 worker chỉ 3,5× vì các worker chia sẻ băng thông bộ nhớ/đĩa và tiến trình chính tốn công gom — thêm worker cho lợi ích giảm dần.
- Parallel chỉ bật cho truy vấn đủ lớn (vượt
min_parallel_table_scan_sizevà chi phí trênparallel_setup_cost), tốt cho phân tích khi còn CPU rảnh — nhưng mỗi worker ngốn một tiến trình và mộtwork_mem, nên cẩn thận trên hệ thống nhiều kết nối.
Phần sau ta xét một cơ chế tăng tốc gây tranh cãi — biên dịch truy vấn ngay lúc chạy: Phần sau mổ xẻ JIT, khi nào nó tăng tốc truy vấn phức tạp và khi nào nó chỉ thêm chi phí biên dịch vô ích.
