Bài trước ta thấy Nested Loop thành thảm họa khi cả hai bảng đều lớn. Vậy PostgreSQL nối don (3 triệu dòng) với khach (200 nghìn dòng) bằng cách nào? Câu trả lời là Hash Join — thuật toán mà planner tự chọn cho join lớn-lớn, đọc mỗi bảng đúng một lần và nhanh gấp 5 lần Nested Loop. Nhưng nó có một cái bẫy: nếu bảng băm không vừa bộ nhớ, nó tràn ra đĩa. Bài này đo cả hai mặt.
Hai pha: build và probe
Hash Join làm việc theo hai pha rõ ràng:
- Pha BUILD: quét bảng nhỏ hơn (ở đây là
khach), dựng một bảng băm trong RAM — ánh xạ từ khóa join (id) tới dòng. - Pha PROBE: quét bảng lớn (
don), với mỗi dòng tính hash củakhach_idrồi tra bảng băm để tìm dòng khớp tức thì.
Điểm cốt lõi: mỗi bảng chỉ đọc đúng một lần. Không có vòng lặp lồng nhau, không cần index trên cột join. Đây là lý do Hash Join thắng khi cả hai phía đều lớn.
SELECT count(*) FROM don d
JOIN khach k ON k.id = d.khach_id;   -- 3 triệu × 200 nghìn
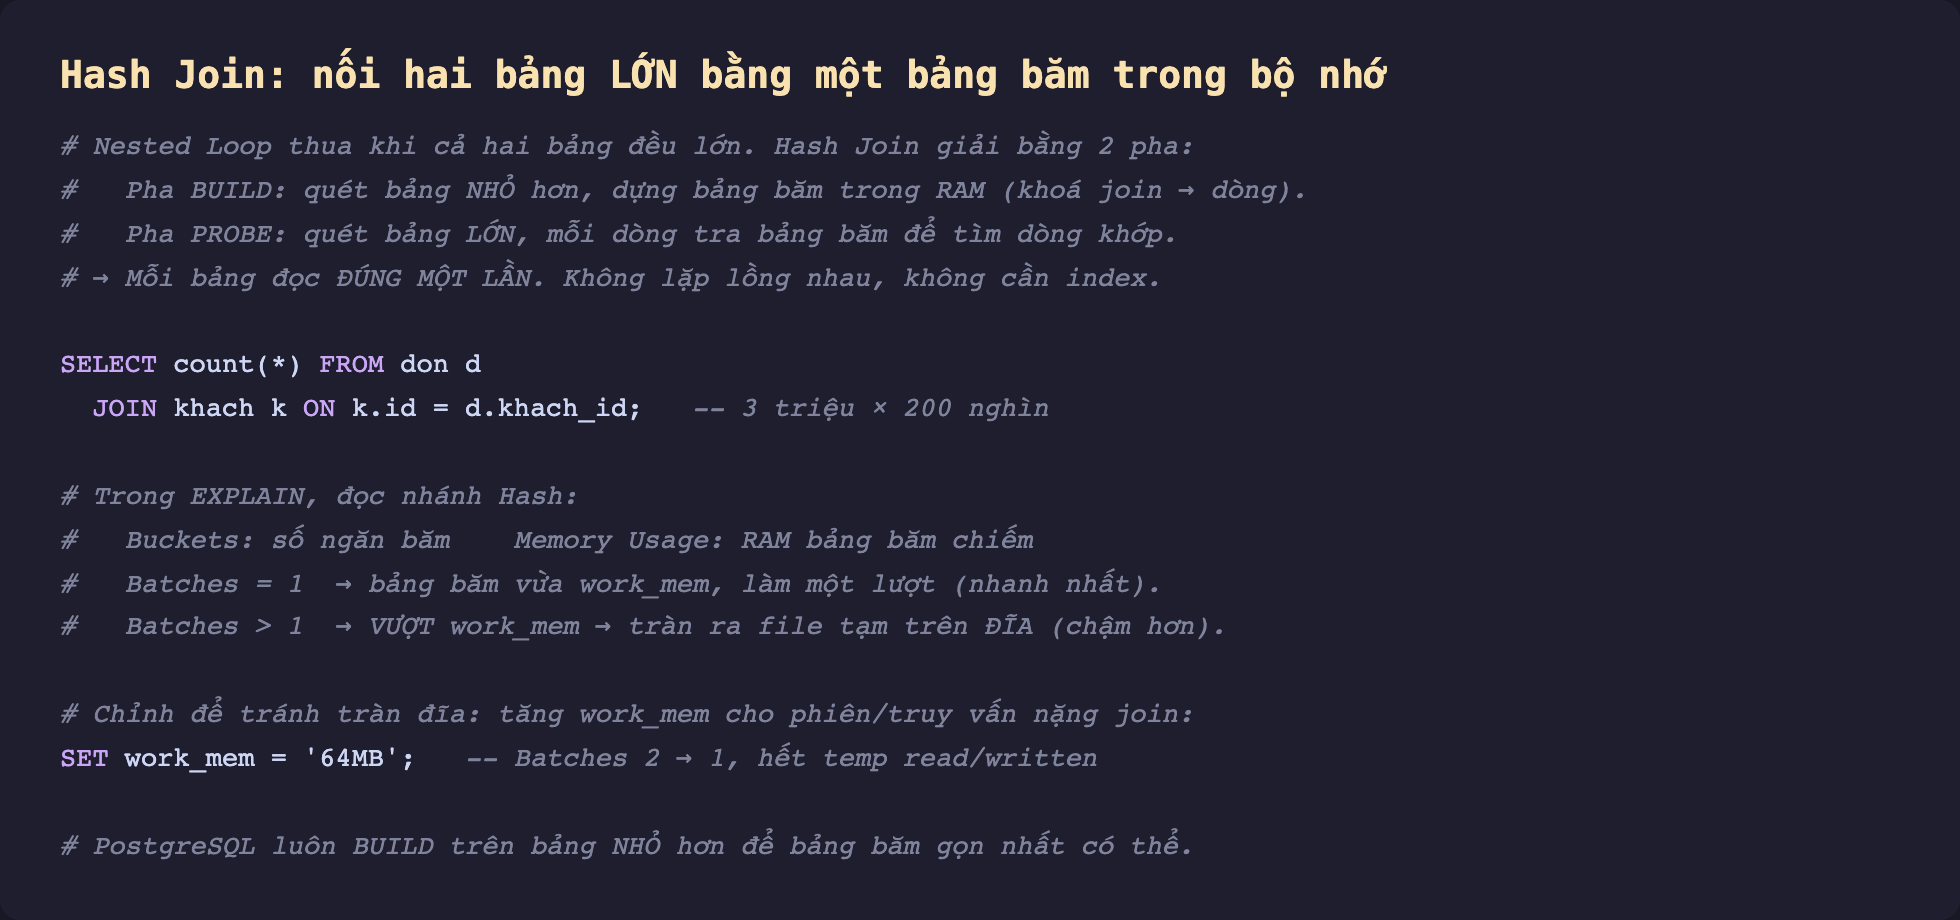
Hình 1: Hash Join hai pha — build bảng băm trên bảng nhỏ, probe bằng bảng lớn. Mỗi bảng đọc một lần; PostgreSQL luôn chọn bảng nhỏ hơn để build cho bảng băm gọn nhất.
Đo thật: Hash Join 442 ms vs Nested Loop 2.221 ms
Chạy join 3 triệu × 200 nghìn, planner tự chọn Hash Join:
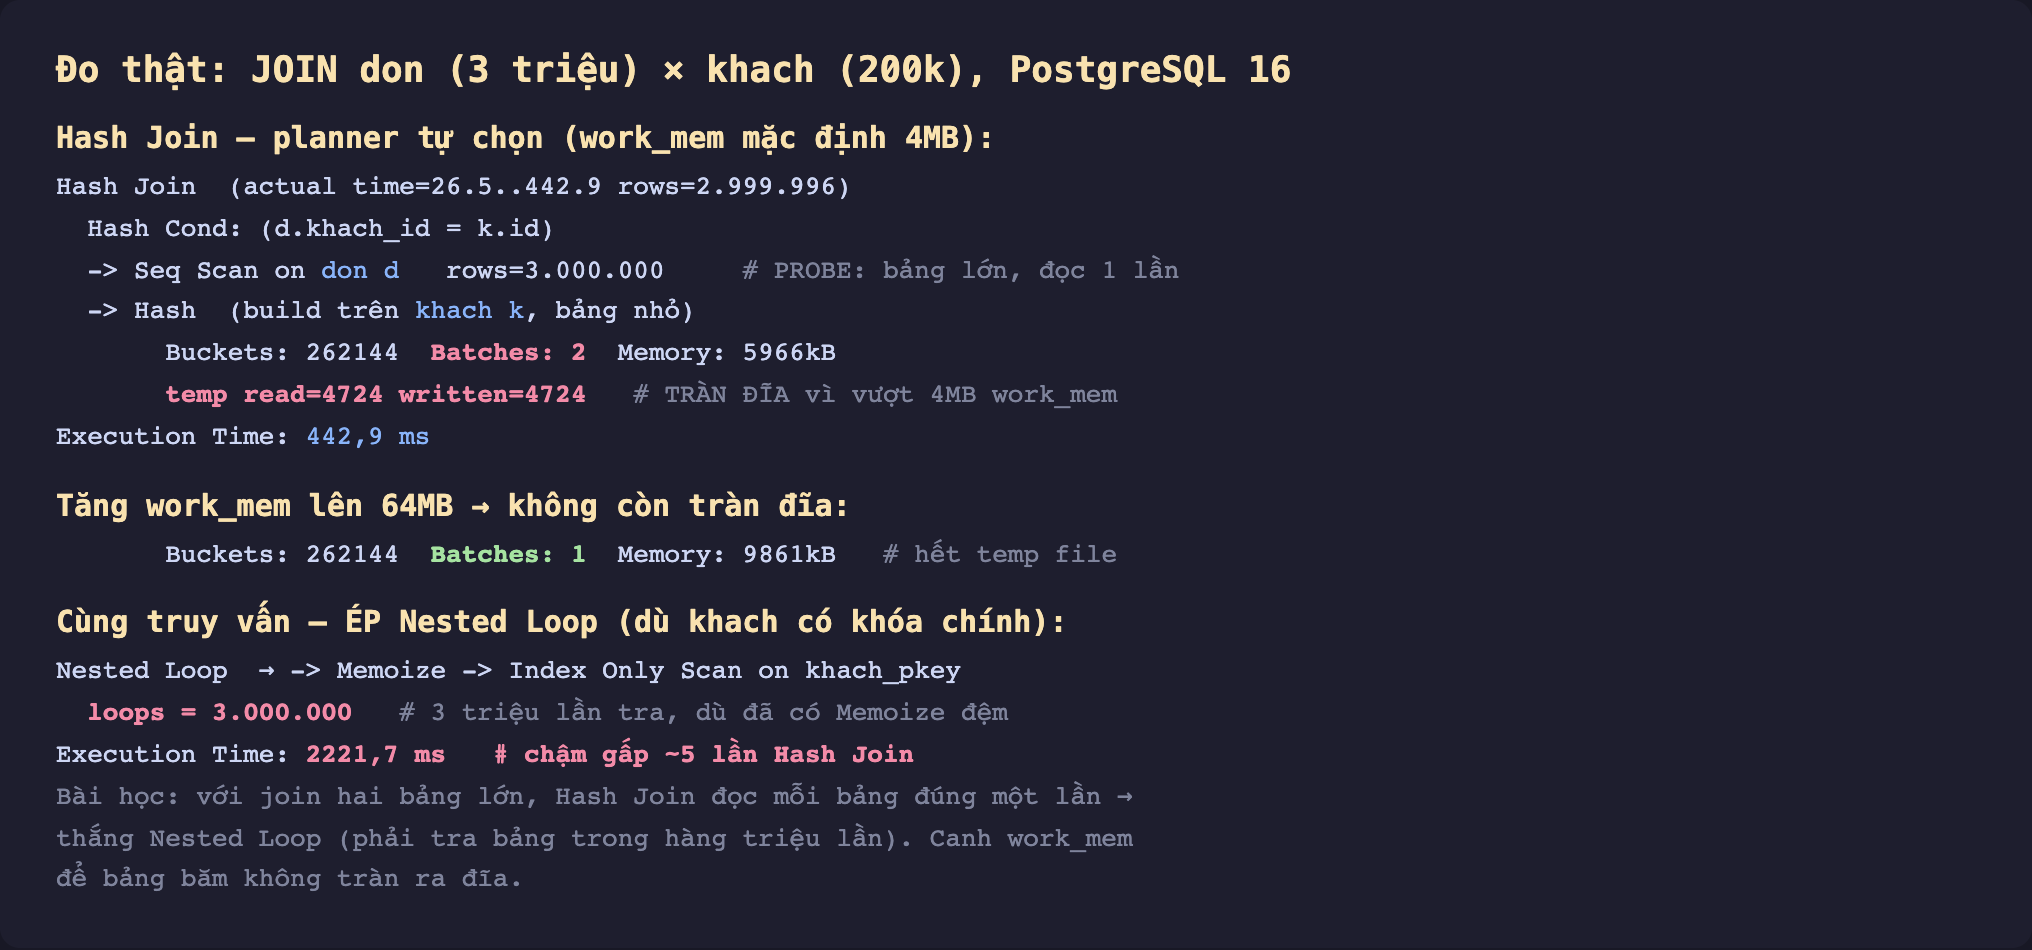
Hình 2: Hash Join 442,9 ms — build trên khach, probe bằng don. Batches: 2 cho thấy bảng băm tràn ra đĩa (temp read/written). Ép Nested Loop cùng truy vấn: 2.221,7 ms, chậm gấp 5 lần dù khach có khóa chính và có Memoize.
Đọc kế hoạch: nhánh Hash build trên khach (bảng nhỏ), nhánh Seq Scan on don là pha probe. Toàn bộ 3 triệu dòng join xong trong 442,9 ms.
So sánh với Nested Loop bị ép cho cùng truy vấn: 2.221,7 ms — chậm gấp 5 lần. Đáng chú ý: khach có khóa chính, và PostgreSQL còn dùng Memoize để đệm kết quả tra — vậy mà vẫn phải làm loops = 3.000.000 lần tra bảng băm khóa chính. Với join lớn-lớn, đọc một lần bằng hash luôn thắng tra triệu lần bằng vòng lặp.
Cái bẫy: Batches và tràn đĩa
Nhìn dòng Batches: 2 trong kế hoạch đầu — đó là dấu hiệu quan trọng. Bảng băm được chia thành nhiều batch khi nó không vừa work_mem (mặc định 4 MB). Ở đây Memory Usage: 5966kB vượt 4 MB, nên PostgreSQL phải chia đôi và ghi một phần ra file tạm trên đĩa — thấy rõ ở temp read=4724 written=4724. Đọc/ghi đĩa chậm hơn RAM nhiều lần.
Sửa bằng cách tăng work_mem cho phiên hoặc truy vấn nặng join:
SET work_mem = '64MB';
-- Batches: 1  Memory: 9861kB  → không còn temp file
Với work_mem đủ lớn, Batches về 1 — toàn bộ bảng băm nằm trong RAM, làm một lượt, không đụng đĩa. Đây là một trong những nút chỉnh hiệu quả nhất cho truy vấn phân tích nặng join và sort.
Đánh đổi cần cân nhắc
work_mem áp cho mỗi node, không phải mỗi truy vấn. Một truy vấn phức tạp có thể có nhiều Hash Join và Sort chạy song song, mỗi cái xin tới work_mem. Đặt work_mem = 256MB toàn cục rồi 100 kết nối cùng chạy truy vấn nhiều node có thể ngốn hàng chục GB RAM và làm sập máy chủ. Nguyên tắc an toàn: giữ work_mem toàn cục vừa phải, chỉ SET cao cho từng phiên/truy vấn nặng cụ thể.
Hash Join cần đủ RAM cho bảng nhỏ; nếu cả hai đều khổng lồ, cân nhắc Merge Join. Khi bảng "nhỏ" thực ra vẫn quá lớn so với RAM khả dụng, tràn đĩa nhiều batch làm Hash Join kém đi — đó là lúc Merge Join (nối hai luồng đã sắp) có thể thắng, chủ đề bài sau.
Hash Join chỉ dùng cho điều kiện bằng (=). Bảng băm tra theo giá trị chính xác, nên ON a.x = b.y được, nhưng ON a.x > b.y thì không — điều kiện range/bất đẳng thức buộc planner dùng Nested Loop hoặc Merge Join.
Ba ý mang về
- Hash Join nối hai bảng lớn bằng hai pha — build bảng băm trên bảng nhỏ, probe bằng bảng lớn — đọc mỗi bảng đúng một lần, nên thắng Nested Loop cho join lớn-lớn: đo thật 442,9 ms so với 2.221,7 ms (gấp 5 lần) dù bên kia có index và Memoize.
Batches > 1nghĩa là bảng băm tràn ra đĩa vì vượtwork_mem(thấy quatemp read/written); tăngwork_memđưaBatchesvề 1, giữ toàn bộ trong RAM và bỏ hẳn đĩa tạm.- Canh
work_memcẩn thận: nó áp cho mỗi node và nhân theo số kết nối — đặt cao toàn cục rất dễ hết RAM; chỉ nâng cho phiên/truy vấn nặng join, và nhớ Hash Join chỉ phục vụ điều kiện=.
Phần sau ta xét thuật toán join thứ ba: Phần sau mổ xẻ Merge Join — cách nó nối hai luồng đã sắp theo cùng khóa, khi nào nó thắng cả Hash Join lẫn Nested Loop.
