Xuyên suốt loạt bài này, một câu lặp đi lặp lại: "planner ước lượng để chọn plan". Ở bài JOIN, planner chọn thuật toán dựa trên số dòng nó đoán. Ở bài index, nó quyết định Seq Scan hay Index Scan cũng dựa trên đoán đó. Giờ ta mổ xẻ chính cơ chế đoán này — vì nó là nguyên nhân số một của hiện tượng đáng sợ nhất với DBA: "query đột nhiên chậm" dù code không đổi.
Điều mấu chốt: PostgreSQL planner không biết dữ liệu thật của bạn. Nó không quét bảng để đếm trước mỗi query (thế thì quá chậm). Thay vào đó, nó dựa vào thống kê — các mẫu về phân phối dữ liệu, thu bởi lệnh ANALYZE và lưu trong pg_statistic — để ước lượng "query này sẽ trả về bao nhiêu dòng?". Từ ước lượng đó, nó chọn plan. Khi thống kê chính xác, plan tốt. Khi thống kê cũ hoặc sai, planner ước lượng lệch và chọn plan tệ. Bài này (phần 11 loạt SQL sâu) đo thật hai kiểu đoán sai và cách sửa.
Cơ chế: planner đoán từ thống kê
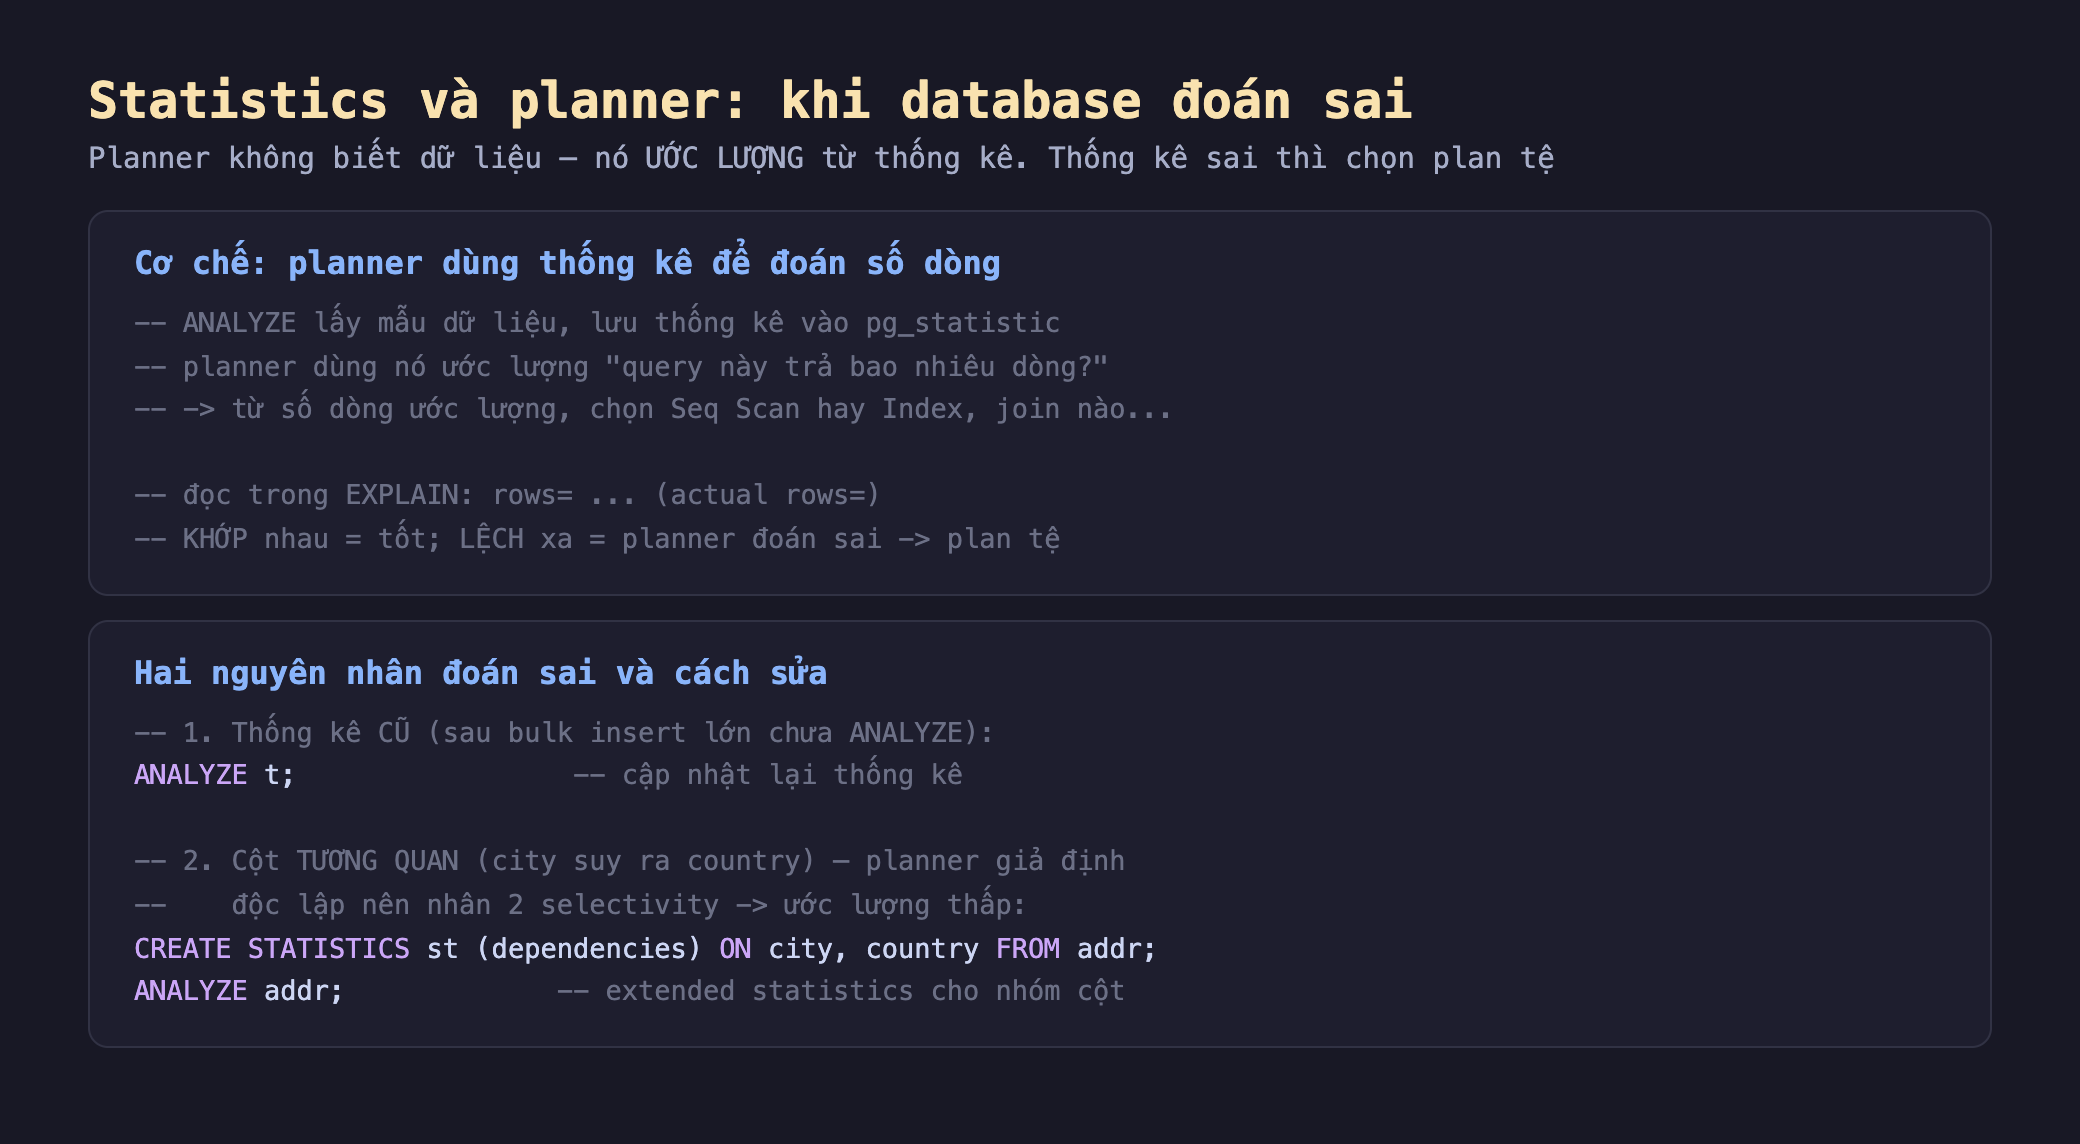
Hình 1: Planner dùng thống kê (thu bởi ANALYZE, lưu trong pg_statistic) để ước lượng số dòng, từ đó chọn plan. Đọc trong EXPLAIN: rows=<estimated> vs (actual rows=<thật>) — khớp là tốt, lệch xa là dấu hiệu đoán sai. Hai nguyên nhân: thống kê cũ (sửa bằng ANALYZE) và cột tương quan (sửa bằng CREATE STATISTICS).
Đo thật trong pg-lab
Mình dựng trong pg-lab (PostgreSQL 16) hai tình huống đoán sai kinh điển.
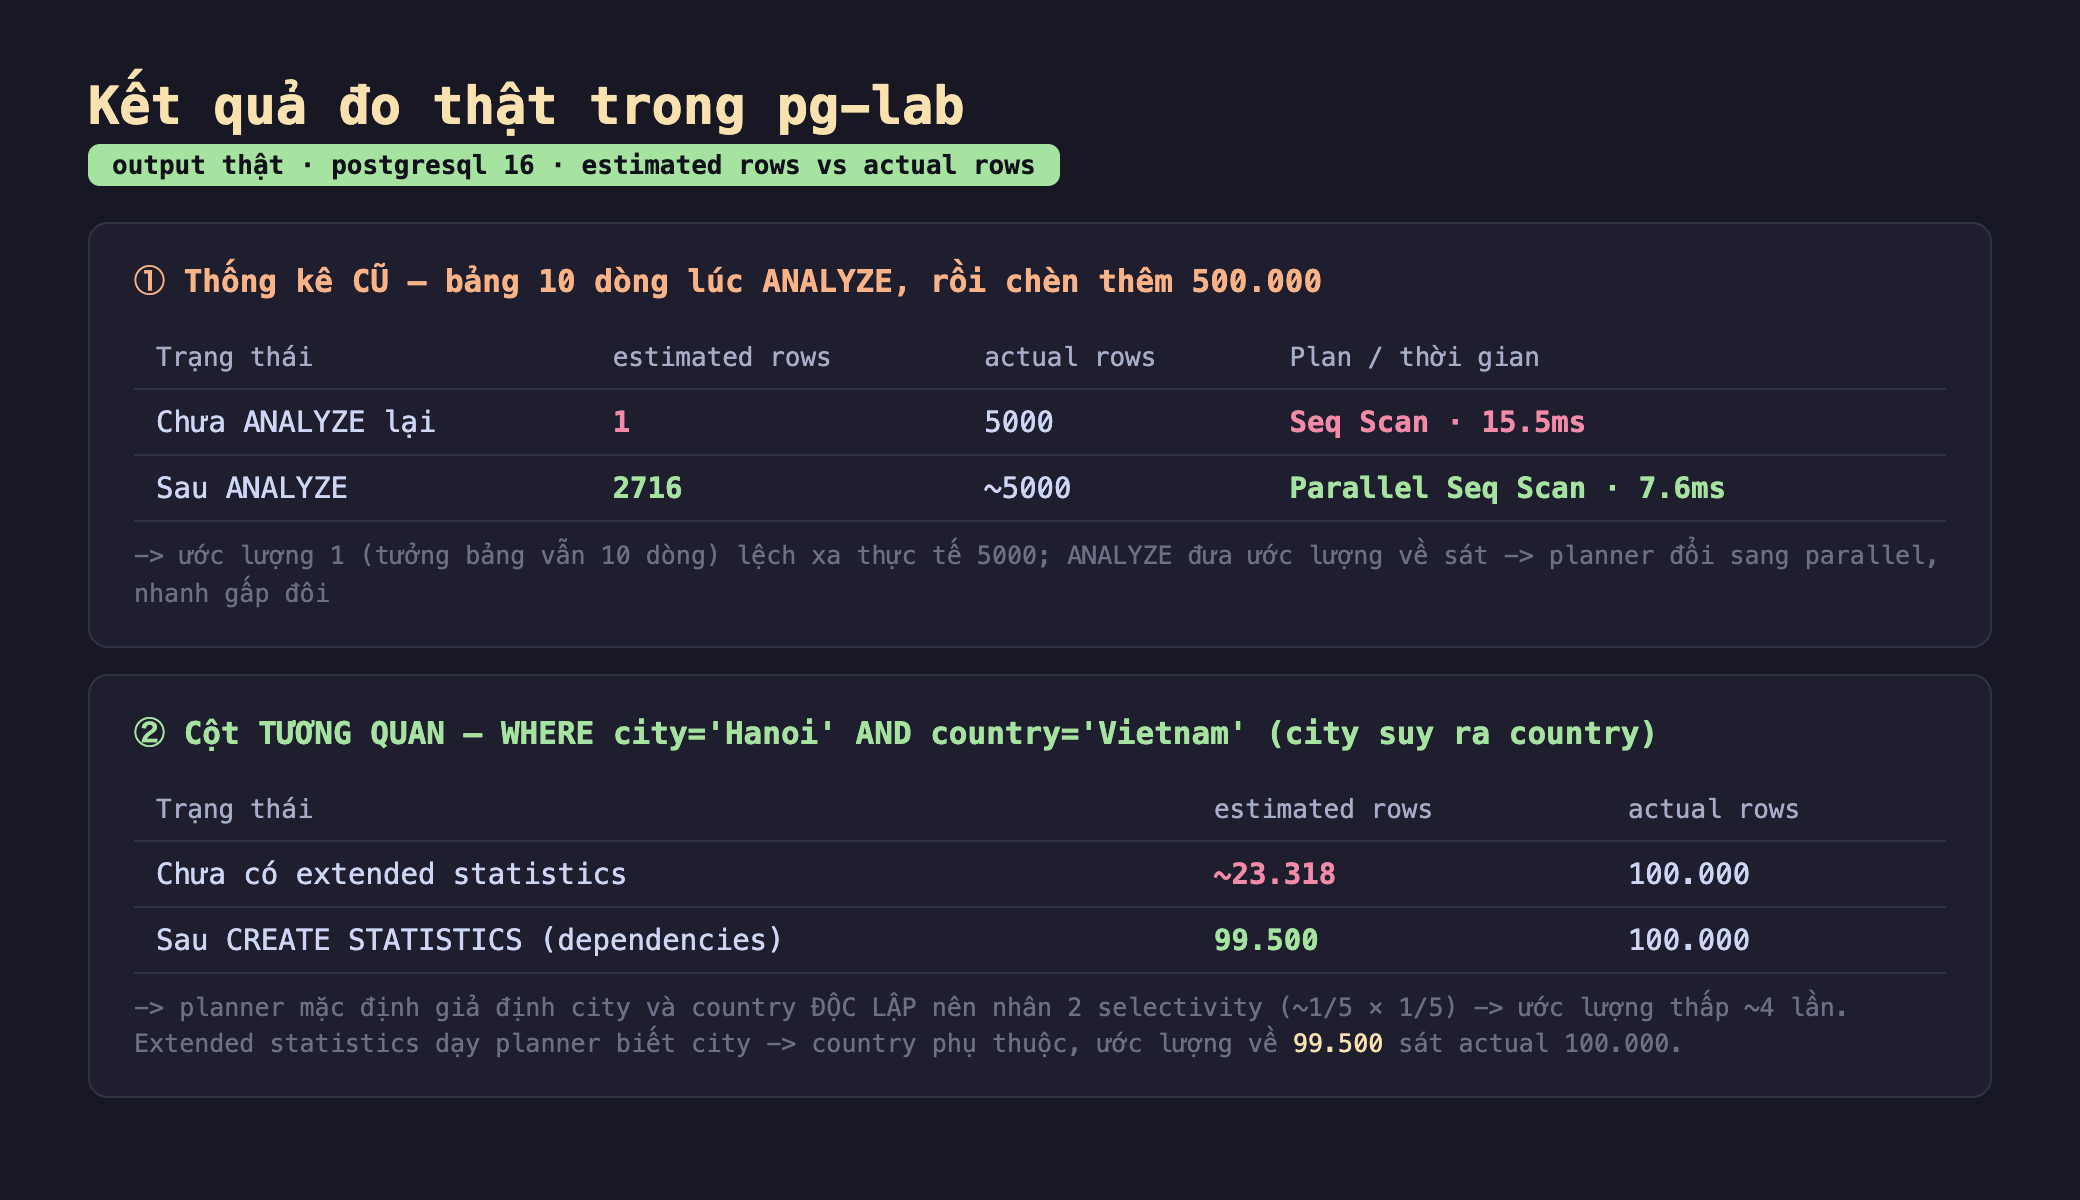
Hình 2: Kết quả thật — ① thống kê cũ: bảng có 500k dòng nhưng thống kê từ lúc 10 dòng → estimated 1 vs actual 5000 (Seq Scan, 15.5ms); sau ANALYZE → estimated 2716 vs actual ~5000 (Parallel Seq Scan, 7.6ms); ② cột tương quan: city='Hanoi' AND country='Vietnam' → estimated ~23.318 vs actual 100.000; sau CREATE STATISTICS → estimated 99.500 sát actual.
Hai kiểu đoán sai:
- Thống kê cũ: đoán 1, thực tế 5000. Mình ANALYZE bảng lúc nó chỉ có 10 dòng, rồi chèn thêm 500.000 dòng mà chưa ANALYZE lại. Planner vẫn tin thống kê cũ (bảng ~10 dòng) nên ước lượng query trả về 1 dòng — trong khi thực tế 5000. Vì tưởng chỉ 1 dòng, nó chọn Seq Scan đơn luồng (15.5ms). Sau
ANALYZE, ước lượng về 2716 (sát 5000), planner nhận ra dữ liệu lớn và chuyển sang Parallel Seq Scan — nhanh gấp đôi (7.6ms). Đây chính xác là kịch bản "sau khi import dữ liệu lớn, query bỗng chậm". - Cột tương quan: đoán thấp 4 lần. Bảng
addrcócityvàcountrytương quan hoàn hảo (Hanoi luôn ở Vietnam). QueryWHERE city='Hanoi' AND country='Vietnam': planner mặc định giả định hai cột độc lập, nên nhân hai selectivity (~1/5 × 1/5 = 1/25) → ước lượng ~23.318. Nhưng vì city đã suy ra country, thực tế là 1/5 = 100.000 dòng. Ước lượng thấp 4 lần. SauCREATE STATISTICS (dependencies) ON city, country, planner biết hai cột phụ thuộc và ước lượng về 99.500 — gần như chính xác.
Đánh đổi cần cân nhắc
Autovacuum chạy ANALYZE tự động, nhưng sau bulk insert lớn nên chạy tay ngay. Autovacuum (bài 7) cũng lo việc ANALYZE định kỳ khi dữ liệu thay đổi đủ nhiều — nên bình thường bạn không phải nghĩ tới. Nhưng nó chạy theo lịch nền, có độ trễ. Ngay sau một thao tác thay đổi lớn — import hàng loạt, xoá phần lớn bảng, migration — thống kê có thể cũ trong khoảng thời gian trước khi autovacuum kịp chạy, và query trong khoảng đó dùng plan tệ. Thói quen tốt: sau bulk operation lớn, chạy ANALYZE <bảng> tay ngay, đừng chờ autovacuum.
Thống kê là MẪU — tăng độ chi tiết cho cột lệch. ANALYZE không đọc toàn bộ bảng; nó lấy mẫu (mặc định ~300 × default_statistics_target dòng) và suy ra phân phối. Với cột có phân phối lệch mạnh hoặc rất nhiều giá trị khác nhau, mẫu mặc định (100) có thể không đủ để ước lượng đúng. Có thể tăng: ALTER TABLE t ALTER COLUMN c SET STATISTICS 1000; rồi ANALYZE — planner giữ nhiều "most common values" và histogram mịn hơn cho cột đó. Đánh đổi: thống kê chi tiết hơn tốn thời gian ANALYZE và bộ nhớ planner; chỉ tăng cho cột thực sự cần.
Extended statistics cho cột tương quan — nhưng phải chủ động tạo. Giả định độc lập của planner thường đúng, nhưng sai lầm khi các cột tương quan (thành phố ↔ quốc gia, sản phẩm ↔ danh mục, mã bưu chính ↔ tỉnh). PostgreSQL không tự phát hiện tương quan — bạn phải CREATE STATISTICS chỉ định nhóm cột. Có ba loại: dependencies (phụ thuộc hàm, như demo), ndistinct (số tổ hợp giá trị), mcv (giá trị tổ hợp phổ biến). Dấu hiệu cần dùng: EXPLAIN cho thấy estimate lệch xa actual trên một điều kiện nhiều cột. Đây là công cụ mạnh nhưng "opt-in" — phải biết mà dùng.
Ba ý mang về
- Planner đoán số dòng từ thống kê, đoán sai thì chọn plan tệ: đọc EXPLAIN so
rows=<estimated>với(actual rows=<thật>)— lệch xa là dấu hiệu; đo thật, thống kê cũ khiến planner ước lượng 1 trong khi thực tế 5000, chọn plan chậm (15.5ms),ANALYZEđưa về sát (2716) → plan nhanh gấp đôi (7.6ms). - Cột tương quan làm planner ước lượng thấp: planner mặc định giả định các cột độc lập nên nhân selectivity — với
city/countrytương quan, ước lượng ~23.318 vs thực tế 100.000 (thấp 4 lần);CREATE STATISTICS (dependencies)dạy planner biết phụ thuộc, ước lượng về 99.500 sát thực tế. - Giữ thống kê tươi và chủ động khi cần: autovacuum ANALYZE định kỳ nhưng chạy
ANALYZEtay ngay sau bulk insert lớn; tăngSET STATISTICScho cột lệch/nhiều giá trị; tạo extended statistics cho cột tương quan — estimate lệch xa actual trong EXPLAIN là tín hiệu rõ ràng cần một trong những cách này.
Nguồn
- PostgreSQL — Statistics Used by the Planner: https://www.postgresql.org/docs/current/planner-stats.html
- PostgreSQL — Extended Statistics (CREATE STATISTICS): https://www.postgresql.org/docs/current/sql-createstatistics.html
- PostgreSQL — How the Planner Uses Statistics: https://www.postgresql.org/docs/current/row-estimation-examples.html
Phần sau là bài tổng kết cả loạt: một cây quyết định và checklist để tối ưu query từ đầu tới cuối — đọc plan, chọn index, tránh các bẫy — kèm demo tối ưu một query chậm thật từ vài trăm mili-giây xuống dưới một mili-giây.
