Phân trang là thứ mọi ứng dụng đều có, và cách viết mặc định — LIMIT 20 OFFSET N — có vẻ hoàn hảo: đơn giản, nhảy tới trang nào cũng được. Nó hoạt động trơn tru suốt quá trình dev và cả những ngày đầu production. Rồi một ngày, người dùng (hoặc một con bot cào dữ liệu) đi tới trang thứ 50.000, và query bỗng mất cả trăm mili-giây. Vì sao trang xa lại chậm, trong khi trang gần thì nhanh?
Câu trả lời nằm ở cách OFFSET hoạt động: để bỏ qua N dòng đầu, database phải đọc qua và vứt bỏ đúng N dòng đó — nó không có cách nào "nhảy thẳng" tới dòng thứ N. Nghĩa là OFFSET càng lớn, càng chậm, tuyến tính theo số trang. Có một cách phân trang khác — keyset pagination (hay "seek method") — giữ tốc độ không đổi ở mọi trang. Bài này (phần 10 loạt SQL sâu) đo thật cả hai và cho thấy khác biệt kinh khủng ở trang xa.
Cơ chế: OFFSET quét-rồi-vứt, keyset nhảy-thẳng
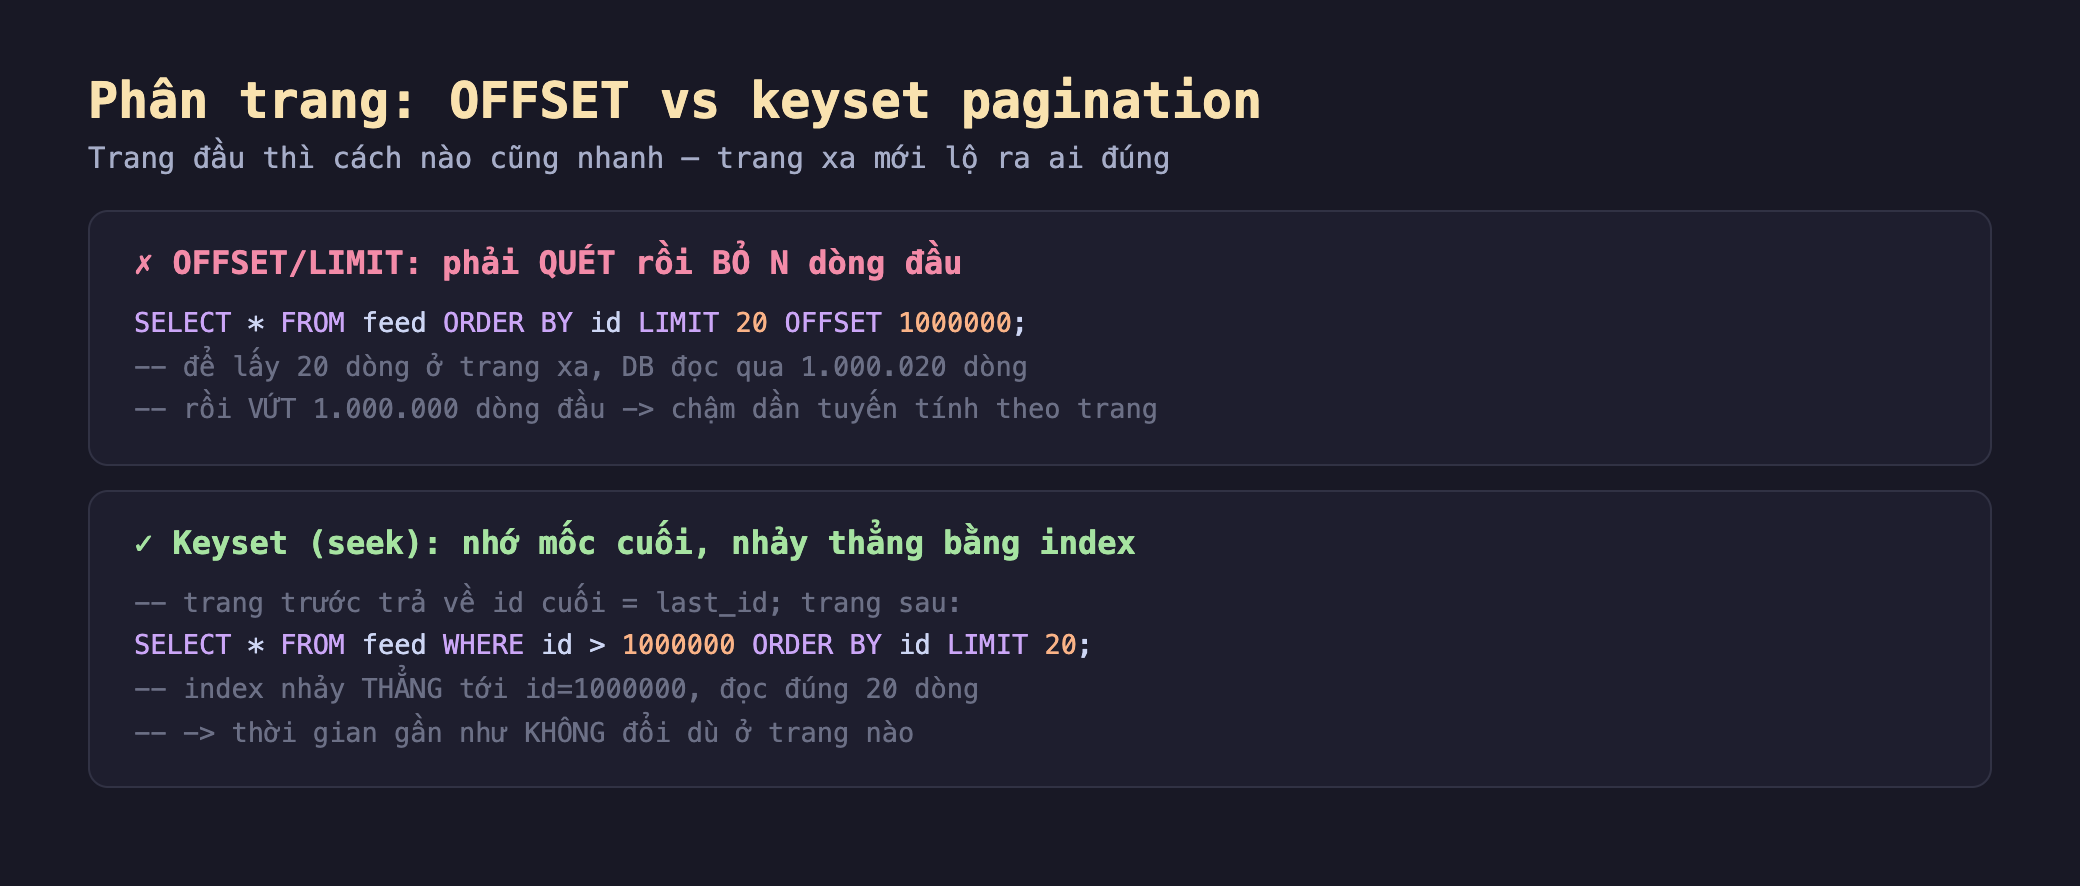
Hình 1: OFFSET/LIMIT phải quét qua và vứt bỏ N dòng đầu để tới trang thứ N — chậm dần tuyến tính. Keyset (seek): trang trước trả về id cuối cùng, trang sau dùng WHERE id > last_id ORDER BY id LIMIT 20 — index nhảy thẳng tới vị trí đó, đọc đúng 20 dòng.
Đo thật trong pg-lab
Mình tạo trong pg-lab (PostgreSQL 16) bảng feed 2 triệu dòng (khoá chính id), rồi đo thời gian lấy 20 dòng ở các vị trí trang khác nhau, bằng cả hai cách.
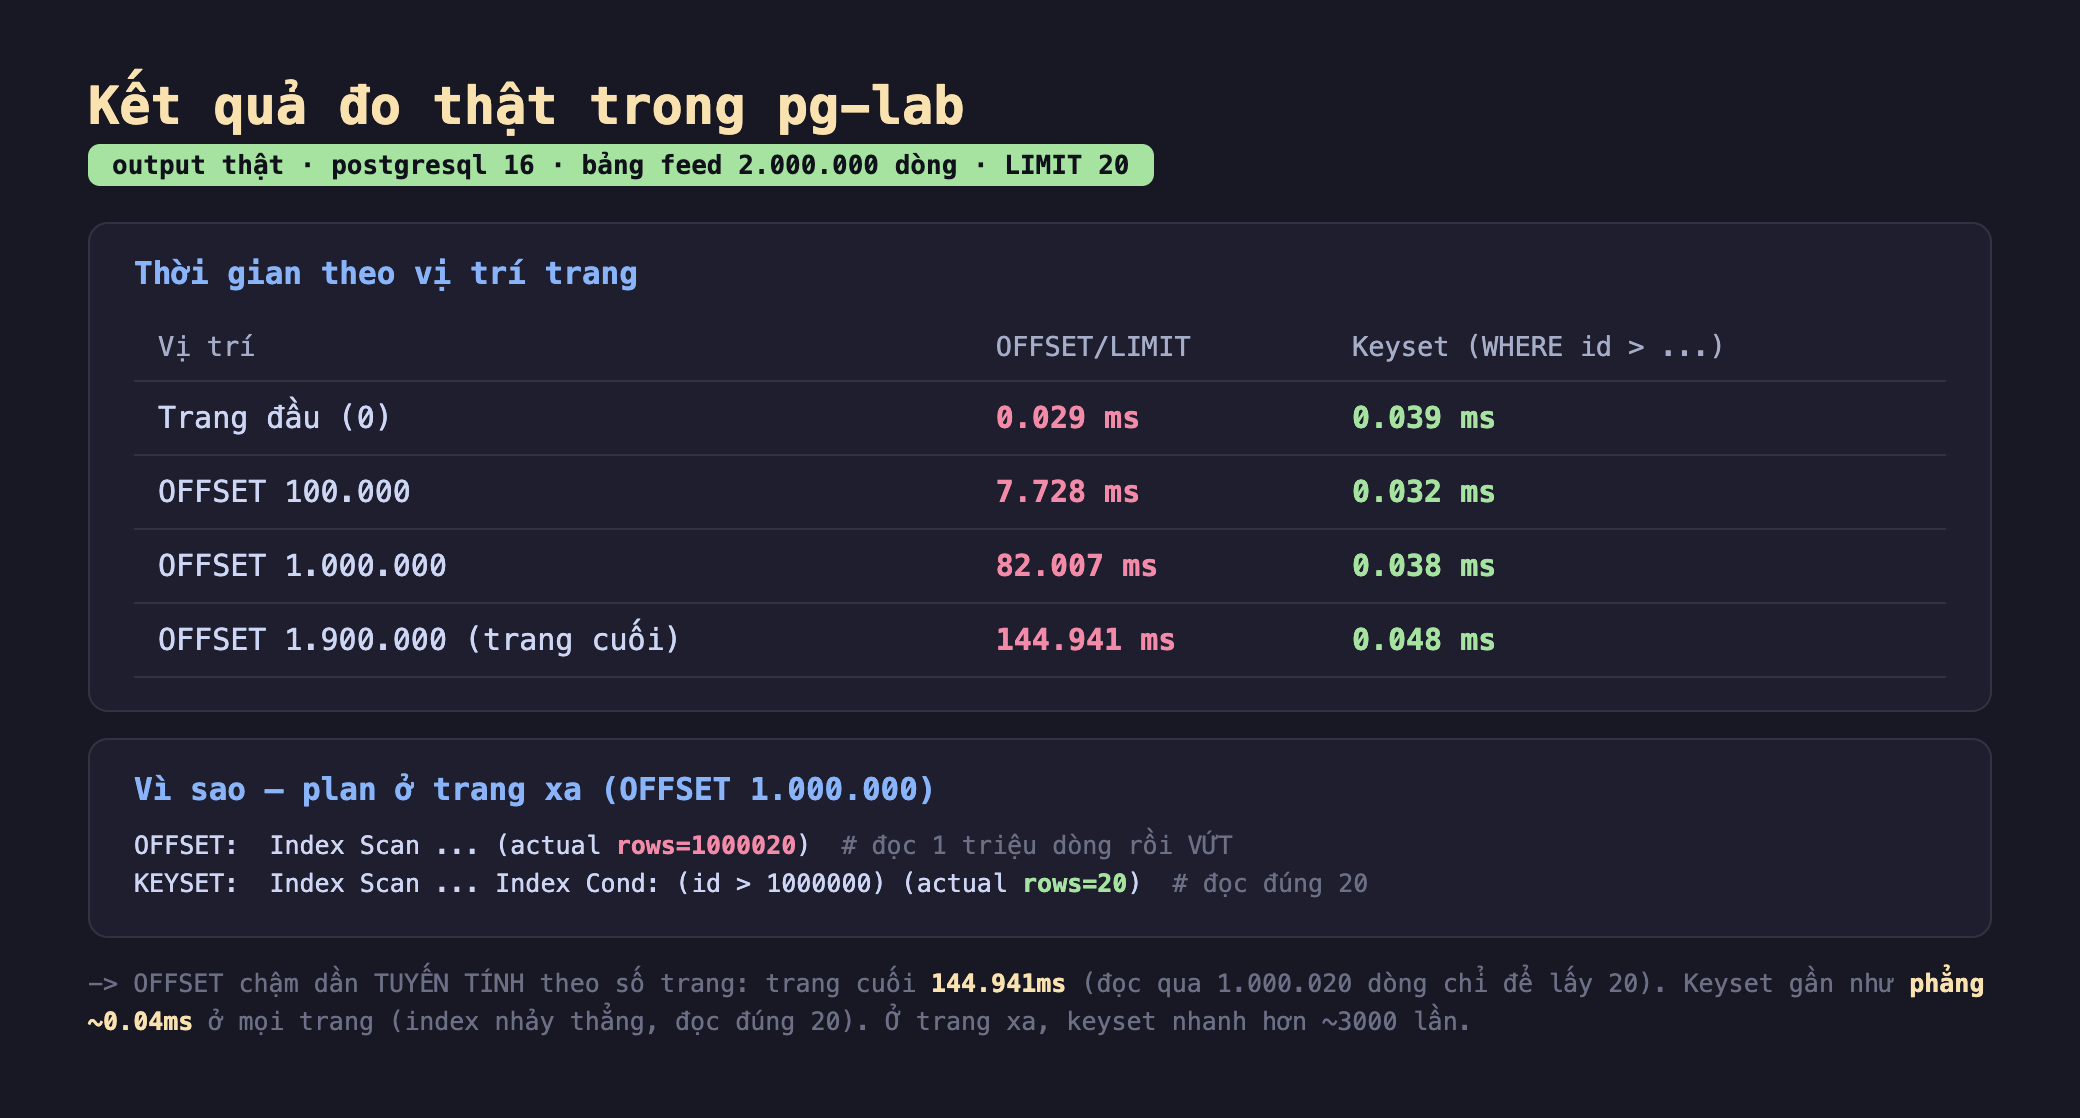
Hình 2: Kết quả thật — OFFSET chậm dần: trang đầu 0.029ms → OFFSET 100k 7.728ms → 1 triệu 82.007ms → trang cuối 144.941ms; keyset phẳng: 0.039 / 0.032 / 0.038 / 0.048ms. Plan trang xa: OFFSET đọc rows=1000020 (quét rồi vứt), keyset rows=20 (nhảy thẳng qua Index Cond: id > 1000000).
Con số kể câu chuyện rõ ràng:
- OFFSET chậm dần tuyến tính theo số trang. Trang đầu 0.029ms — nhanh. Nhưng OFFSET 100.000 đã 7.728ms, OFFSET 1 triệu là 82ms, và trang cuối (OFFSET 1.9 triệu) tới 144.941ms. Đường cong tuyến tính rõ rệt: OFFSET gấp đôi thì thời gian gấp đôi. Người dùng ở trang đầu thấy nhanh, người ở trang xa (và các bot cào) làm database gồng mình.
- Keyset giữ tốc độ phẳng. Ở mọi vị trí — trang đầu hay trang cuối — keyset đều ~0.03-0.05ms. Không đổi. Vì
WHERE id > last_idcho index nhảy thẳng tới vị trí cần, không quét gì trước đó. - Plan chứng minh nguyên nhân. Đây là bằng chứng đắt giá: ở trang xa, OFFSET có
actual rows=1000020— nó thực sự đọc hơn một triệu dòng qua index rồi vứt một triệu để trả về 20. Keyset cóactual rows=20vớiIndex Cond: (id > 1000000)— đọc đúng 20 dòng. Cùng kết quả 20 dòng, một cái đọc 1 triệu, một cái đọc 20. Ở trang xa keyset nhanh hơn ~3000 lần.
Đánh đổi cần cân nhắc
Keyset chỉ đi tiến/lùi tuần tự — không nhảy tới trang bất kỳ. Đây là hạn chế thật của keyset: vì nó dựa trên "dòng cuối của trang trước", bạn chỉ đi được trang kế tiếp (hoặc trang trước), không nhảy thẳng tới "trang 500" được — bạn không biết last_id của trang 499 mà chưa đi qua. Với UI kiểu "cuộn vô tận" (infinite scroll) hay "Xem thêm", keyset hoàn hảo. Với UI kiểu "nhảy tới trang số N" (đánh số trang 1,2,3...500), OFFSET vẫn cần — hoặc bạn thiết kế lại UX. Chọn cách phân trang theo cách người dùng điều hướng.
OFFSET có bug nhất quán khi dữ liệu thay đổi giữa các trang. Một vấn đề của OFFSET ít người để ý: nếu có dòng được chèn hoặc xoá giữa lúc người dùng xem trang 1 và trang 2, các dòng bị dịch chuyển — bạn có thể thấy một dòng hai lần (nó tụt xuống trang sau) hoặc bỏ sót một dòng (nó nhảy lên trang trước). Keyset không bị lỗi này: WHERE id > last_id luôn tiếp tục đúng chỗ dừng, bất kể có chèn/xoá. Với feed thời gian thực (dữ liệu liên tục thay đổi), keyset còn đúng đắn hơn chứ không chỉ nhanh hơn.
Keyset cần cột sắp xếp duy nhất — và phức tạp khi ORDER BY nhiều cột. Keyset hoạt động sạch khi sắp theo một cột duy nhất (như khoá chính). Nếu sắp theo cột có trùng (ví dụ created_at mà nhiều dòng cùng thời điểm), phải thêm cột phân định (tie-break) — thường là ORDER BY created_at, id và điều kiện keyset thành WHERE (created_at, id) > (:last_created, :last_id) (so sánh tuple). Điều này khả thi nhưng phức tạp hơn OFFSET, và càng rối khi ORDER BY nhiều cột với hướng khác nhau. Đây là cái giá của tốc độ keyset: logic con trỏ phức tạp hơn.
Ba ý mang về
- OFFSET chậm dần tuyến tính vì phải quét-rồi-vứt: đo thật, cùng lấy 20 dòng — trang đầu OFFSET 0.029ms nhưng trang cuối 144.941ms (plan cho thấy
rows=1000020: đọc 1 triệu dòng rồi vứt để lấy 20); OFFSET càng lớn càng chậm. - Keyset giữ tốc độ phẳng ở mọi trang: đo thật,
WHERE id > last_id ORDER BY id LIMIT 20cho index nhảy thẳng, đọc đúng 20 dòng (rows=20), ~0.04ms bất kể trang nào — ở trang xa nhanh hơn OFFSET ~3000 lần; và nhất quán khi dữ liệu chèn/xoá giữa các trang. - Chọn theo cách điều hướng và độ phức tạp: keyset chỉ đi tiến/lùi tuần tự (hợp infinite scroll, không nhảy tới trang N) và cần cột sắp xếp duy nhất (tie-break bằng id, so sánh tuple khi ORDER BY nhiều cột); OFFSET đơn giản + nhảy trang bất kỳ nhưng chậm ở trang xa và có bug nhất quán.
Nguồn
- Markus Winand — Use The Index, Luke: Paging Through Results (seek method): https://use-the-index-luke.com/no-offset
- PostgreSQL — LIMIT and OFFSET: https://www.postgresql.org/docs/current/queries-limit.html
- PostgreSQL — Row constructor comparison (tuple keyset): https://www.postgresql.org/docs/current/functions-comparisons.html#ROW-WISE-COMPARISON
Phần sau ta quay lại chủ đề đã nhắc nhiều lần: planner dựa vào thống kê để chọn plan — khi thống kê cũ hoặc lệch, nó ước lượng sai số dòng và chọn plan tệ; đo thật estimated rows vs actual rows lệch nhau và cách sửa.
