Mười một phần trước của loạt "SQL sâu" mỗi phần mổ xẻ một công cụ: đọc EXPLAIN ANALYZE, index B-tree và sargable, index tổ hợp, ba thuật toán JOIN, N+1, isolation level, MVCC/VACUUM, window function, CTE, phân trang, statistics. Nhưng khi đứng trước một query chậm thật lúc 3 giờ sáng, bạn không dùng từng cái rời rạc — bạn cần một quy trình để biết bắt đầu từ đâu và làm gì tiếp theo. Bài cuối này (phần 12) ghép tất cả thành một cây quyết định và một checklist, rồi chứng minh bằng cách tối ưu một query thật từ đầu tới cuối.
Điều quan trọng nhất về tối ưu query: nó không phải trò thử-sai. Nhiều người thấy query chậm thì thêm index bừa, viết lại linh tinh, hy vọng may mắn. Cách đúng có kỷ luật: luôn bắt đầu từ EXPLAIN ANALYZE để thấy database thực sự làm gì, rồi theo dấu vết đó tới đúng công cụ cần dùng. Bài này đo thật cả quy trình đó.
Cơ chế: cây quyết định và checklist
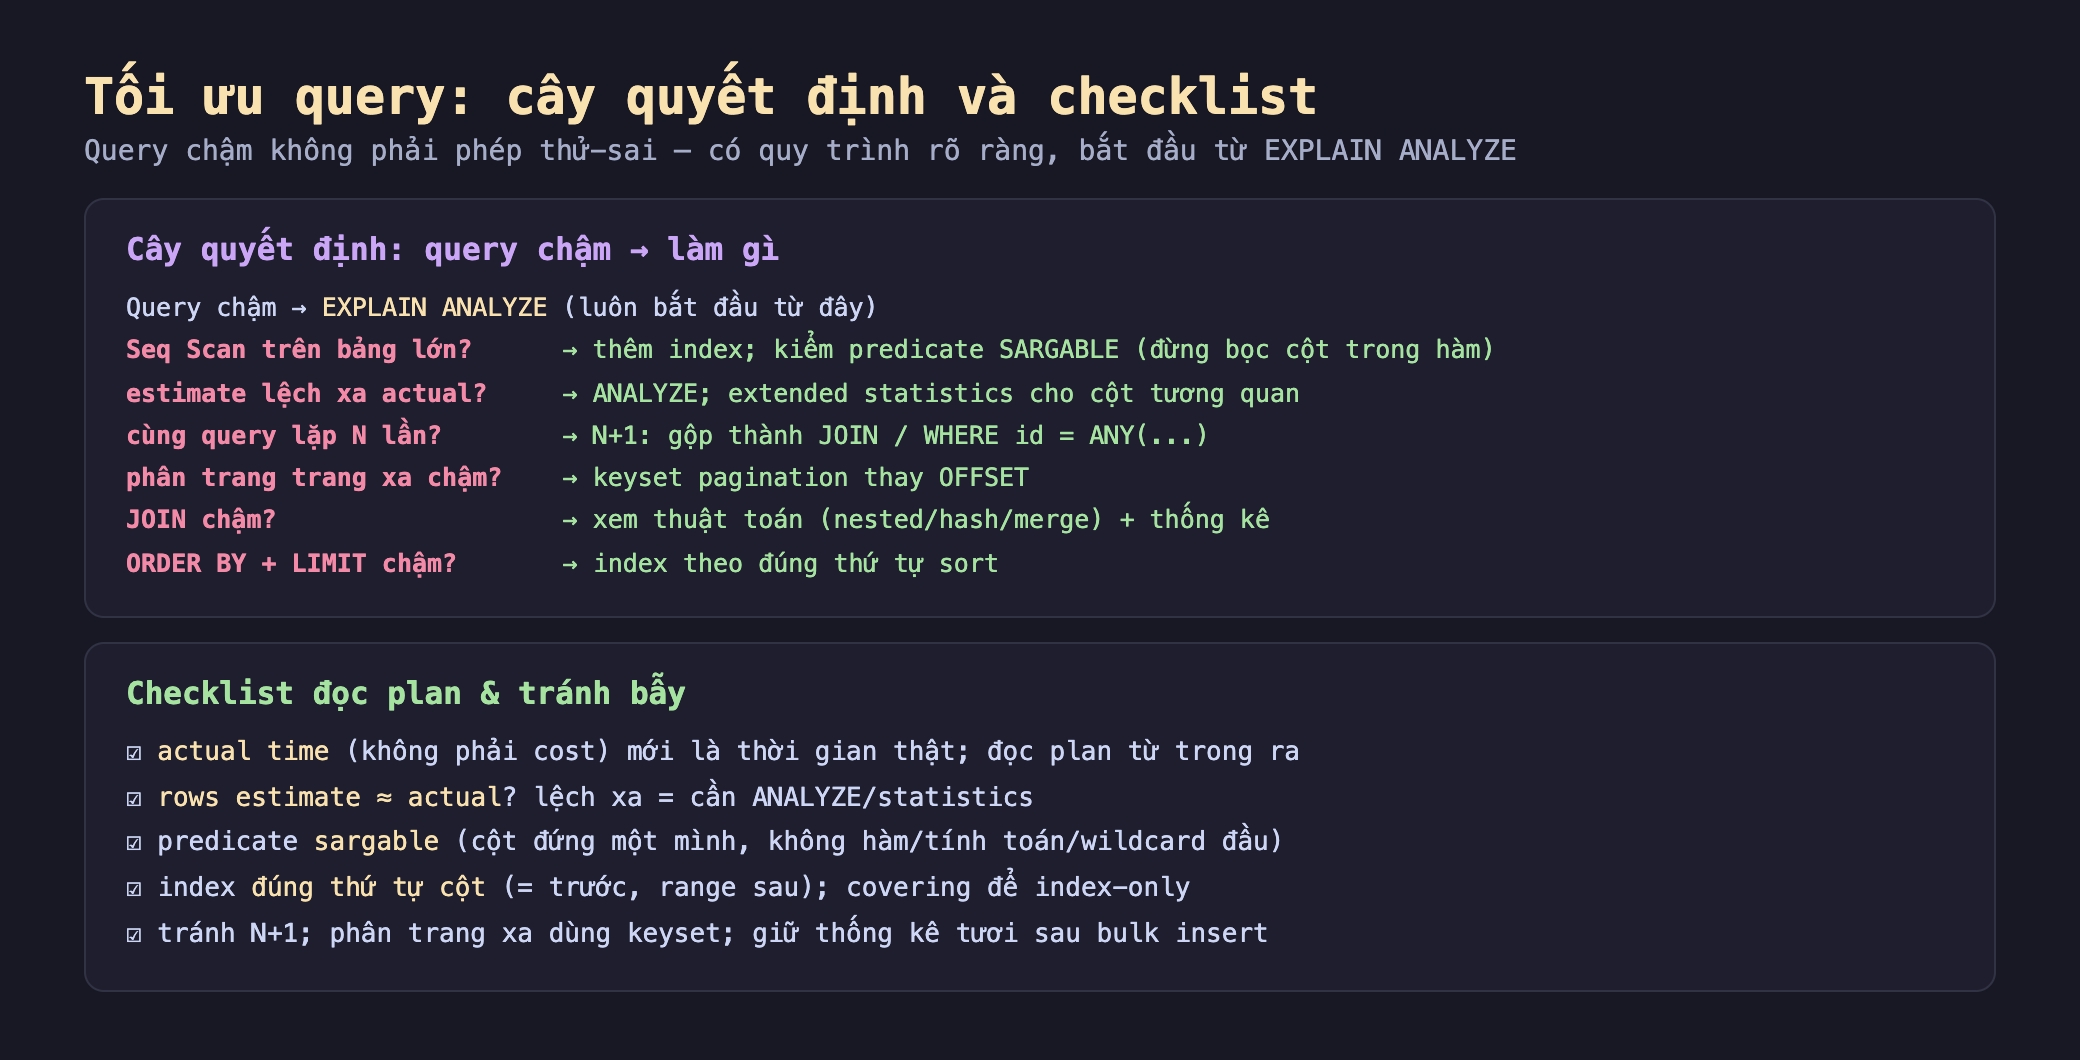
Hình 1: Cây quyết định — query chậm luôn bắt đầu từ EXPLAIN ANALYZE, rồi theo triệu chứng: Seq Scan bảng lớn → index + sargable; estimate lệch → ANALYZE/statistics; query lặp → gộp N+1; trang xa → keyset; JOIN chậm → thuật toán + thống kê. Kèm checklist đọc plan và tránh bẫy.
Đo thật: tối ưu một query từ 51ms xuống 3.7ms
Mình dựng trong pg-lab (PostgreSQL 16) một tình huống thật: orders2 2 triệu dòng JOIN users2, lọc theo status và ngày, sắp theo amount lấy top 10 — kiểu query "đơn hàng đã thanh toán trong ngày X, xem 10 đơn lớn nhất" rất phổ biến. Rồi tối ưu từng bước.
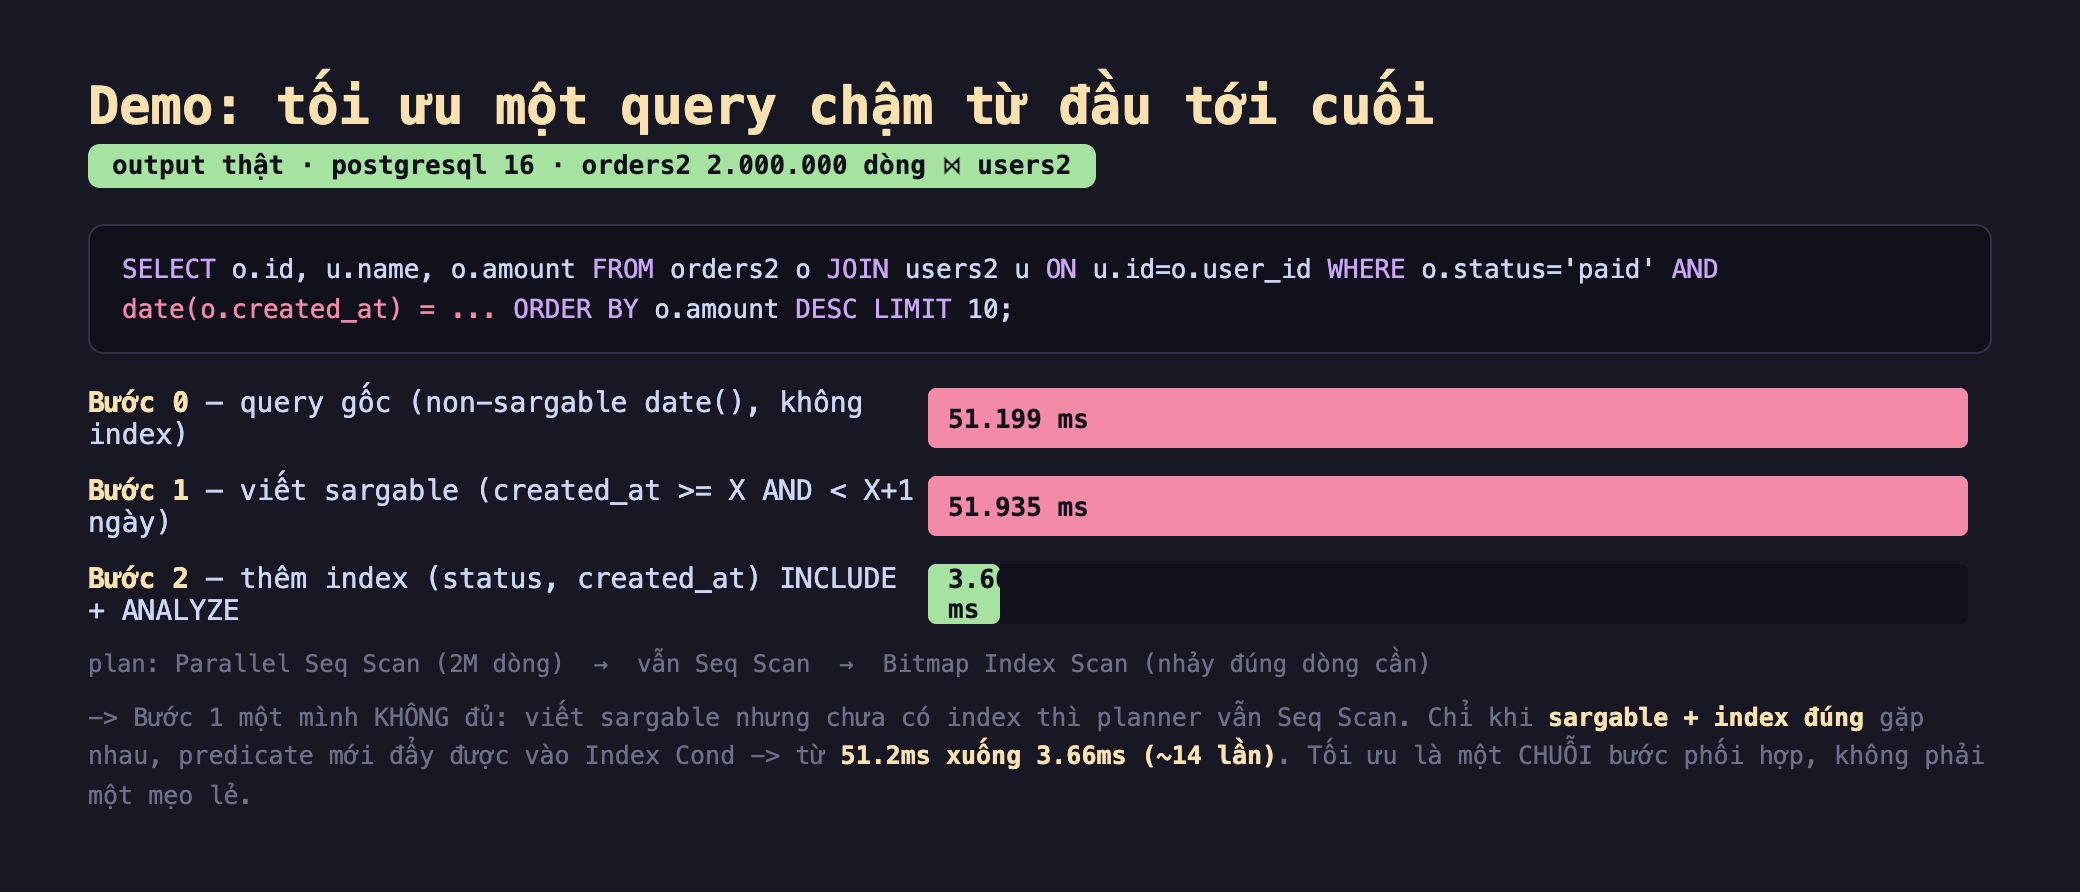
Hình 2: Kết quả thật — Bước 0 (query gốc, non-sargable date(), không index): 51.199ms (Parallel Seq Scan 2M dòng); Bước 1 (viết sargable): 51.935ms (vẫn Seq Scan); Bước 2 (sargable + index tổ hợp + ANALYZE): 3.66ms (Bitmap Index Scan) — nhanh ~14 lần.
Quy trình tối ưu, đo từng bước:
- Bước 0 — chẩn đoán. Query gốc mất 51.199ms.
EXPLAIN ANALYZEcho thấy Parallel Seq Scan trên 2 triệu dòng: nó quét cả bảng vì (a) không có index phù hợp, và (b) điều kiệndate(created_at) = ...là non-sargable (bọc cột trong hàm, như bài 2). Hai vấn đề rõ ràng để sửa. - Bước 1 — viết sargable, nhưng chưa đủ. Đổi
date(created_at) = Xthànhcreated_at >= X AND created_at < X + 1 ngày(sargable, không bọc cột). Kết quả: 51.935ms — gần như không đổi. Đây là bài học quan trọng và trung thực: viết sargable một mình không giúp gì nếu chưa có index. Predicate sargable chỉ có ý nghĩa khi có index để nó dùng; không có index thì dù viết kiểu gì cũng phải Seq Scan. - Bước 2 — sargable + index đúng, hai cái gặp nhau. Thêm index tổ hợp
(status, created_at)(đúng thứ tự: cột=trước, cột range sau — bài 3) vớiINCLUDE (user_id, amount), rồiANALYZE. Giờ predicate sargable đẩy được vàoIndex Cond, plan chuyển sang Bitmap Index Scan — 3.66ms, nhanh ~14 lần. Chỉ khi sargable và index đúng gặp nhau, phép tối ưu mới xảy ra.
Nói thẳng: kết quả cuối là 3.66ms, không phải "dưới 1ms" — vì sau khi lọc bằng index vẫn còn bước đọc heap và sort các đơn trong ngày theo amount. 14 lần đã là cải thiện lớn và thật; tối ưu tiếp cần cân nhắc chi phí/lợi ích (ví dụ index thêm cột amount để tránh sort). Điểm cốt lõi: tối ưu là một chuỗi bước phối hợp, không phải một mẹo lẻ.
Cả loạt SQL sâu dạy gì
Nhìn lại 12 phần, vài sợi chỉ xuyên suốt:
- Luôn bắt đầu từ EXPLAIN ANALYZE — đừng đoán. Mọi bài đều quay về công cụ này: nó cho biết database thực sự làm gì (Seq Scan hay Index, join nào, estimate có khớp actual không). Tối ưu mà không đọc plan là bắn trong bóng tối.
- Hiểu cơ chế quan trọng hơn học mẹo. Biết vì sao index không dùng được (non-sargable), vì sao OFFSET chậm (quét-rồi-vứt), vì sao planner chọn sai (thống kê cũ) — hiểu cơ chế thì tự suy ra cách sửa cho tình huống mới, thay vì thuộc lòng một danh sách mẹo.
- Các công cụ phối hợp, không rời rạc. Như demo cho thấy: sargable + index + ANALYZE phải đi cùng nhau. Index đúng thứ tự cột (bài 3) dựa trên hiểu sargable (bài 2); planner chọn join tốt (bài 4) dựa trên thống kê tươi (bài 11). Sức mạnh đến từ việc ghép đúng.
- Đo thật, và trung thực với con số. Xuyên suốt loạt bài, mọi số liệu đo thật trong container — kể cả khi kết quả khiêm tốn (3.66ms chứ không phải sub-1ms) hay đi ngược trực giác (LIKE 'x%' cần text_pattern_ops, sargable một mình không đủ). Database performance là lĩnh vực mà trực giác hay sai; hãy để EXPLAIN ANALYZE dẫn đường.
Ba ý mang về
- Tối ưu query là quy trình, luôn bắt đầu từ EXPLAIN ANALYZE: theo cây quyết định — Seq Scan bảng lớn → index + sargable; estimate lệch → ANALYZE/statistics; query lặp → gộp N+1; trang xa → keyset; JOIN chậm → thuật toán + thống kê; đọc
actual time(không phải cost) và so estimate với actual. - Các công cụ phải phối hợp, không dùng lẻ: đo thật, viết sargable một mình vẫn 51.9ms (chưa index nên vẫn Seq Scan), chỉ khi sargable + index đúng thứ tự + ANALYZE gặp nhau mới xuống 3.66ms (~14 lần) — predicate mới đẩy được vào Index Cond.
- Hiểu cơ chế và đo thật, đừng đoán: hiểu vì sao (non-sargable, quét-rồi-vứt, thống kê cũ) giúp tự suy ra cách sửa cho tình huống mới; và luôn đo thật, trung thực với con số — kết quả 3.66ms chứ không tô thành sub-1ms, vì database performance là nơi trực giác hay sai nhất.
Nguồn
- PostgreSQL — Performance Tips: https://www.postgresql.org/docs/current/performance-tips.html
- PostgreSQL — Using EXPLAIN: https://www.postgresql.org/docs/current/using-explain.html
- Use The Index, Luke — SQL Performance Explained: https://use-the-index-luke.com/
Cảm ơn bạn đã theo hết 12 phần của loạt "SQL sâu cho lập trình viên". Từ cách đọc EXPLAIN ANALYZE ở phần 1 tới quy trình tối ưu hoàn chỉnh ở bài này, hy vọng bạn đã có một bộ công cụ đo thật để nhìn xuyên qua lớp vỏ SQL — thấy database thực sự làm gì, và biết chính xác cần chạm vào đâu khi một query chậm.
