Đây là cái bẫy hiệu năng mà gần như mọi lập trình viên backend từng dính, thường mà không biết: N+1 query. Bạn viết một đoạn code trông hoàn toàn vô hại — lấy danh sách tác giả, rồi với mỗi tác giả lấy sách của họ. Trên ORM (Hibernate, Django ORM, ActiveRecord, GORM...) nó gọn gàng, đọc như tiếng Anh. Nhưng bên dưới, ORM lặng lẽ biến vòng lặp đó thành 1 query lấy danh sách + N query lấy chi tiết — với 100 tác giả là 101 lần đấm xuống database. Trên máy dev với vài bản ghi thì không ai để ý; lên production với dữ liệu thật, trang tải hàng giây.
Điều làm N+1 nguy hiểm là nó vô hình trong code — ORM giấu các query đằng sau việc truy cập thuộc tính (lazy loading). Bài này (phần 5 loạt SQL sâu) đo thật cái giá của N+1, và quan trọng là chỉ ra cái giá đó nằm ở đâu — không phải ở database (mỗi query rất nhanh), mà ở số lần round-trip cộng dồn.
Cơ chế: một vòng lặp, N+1 query
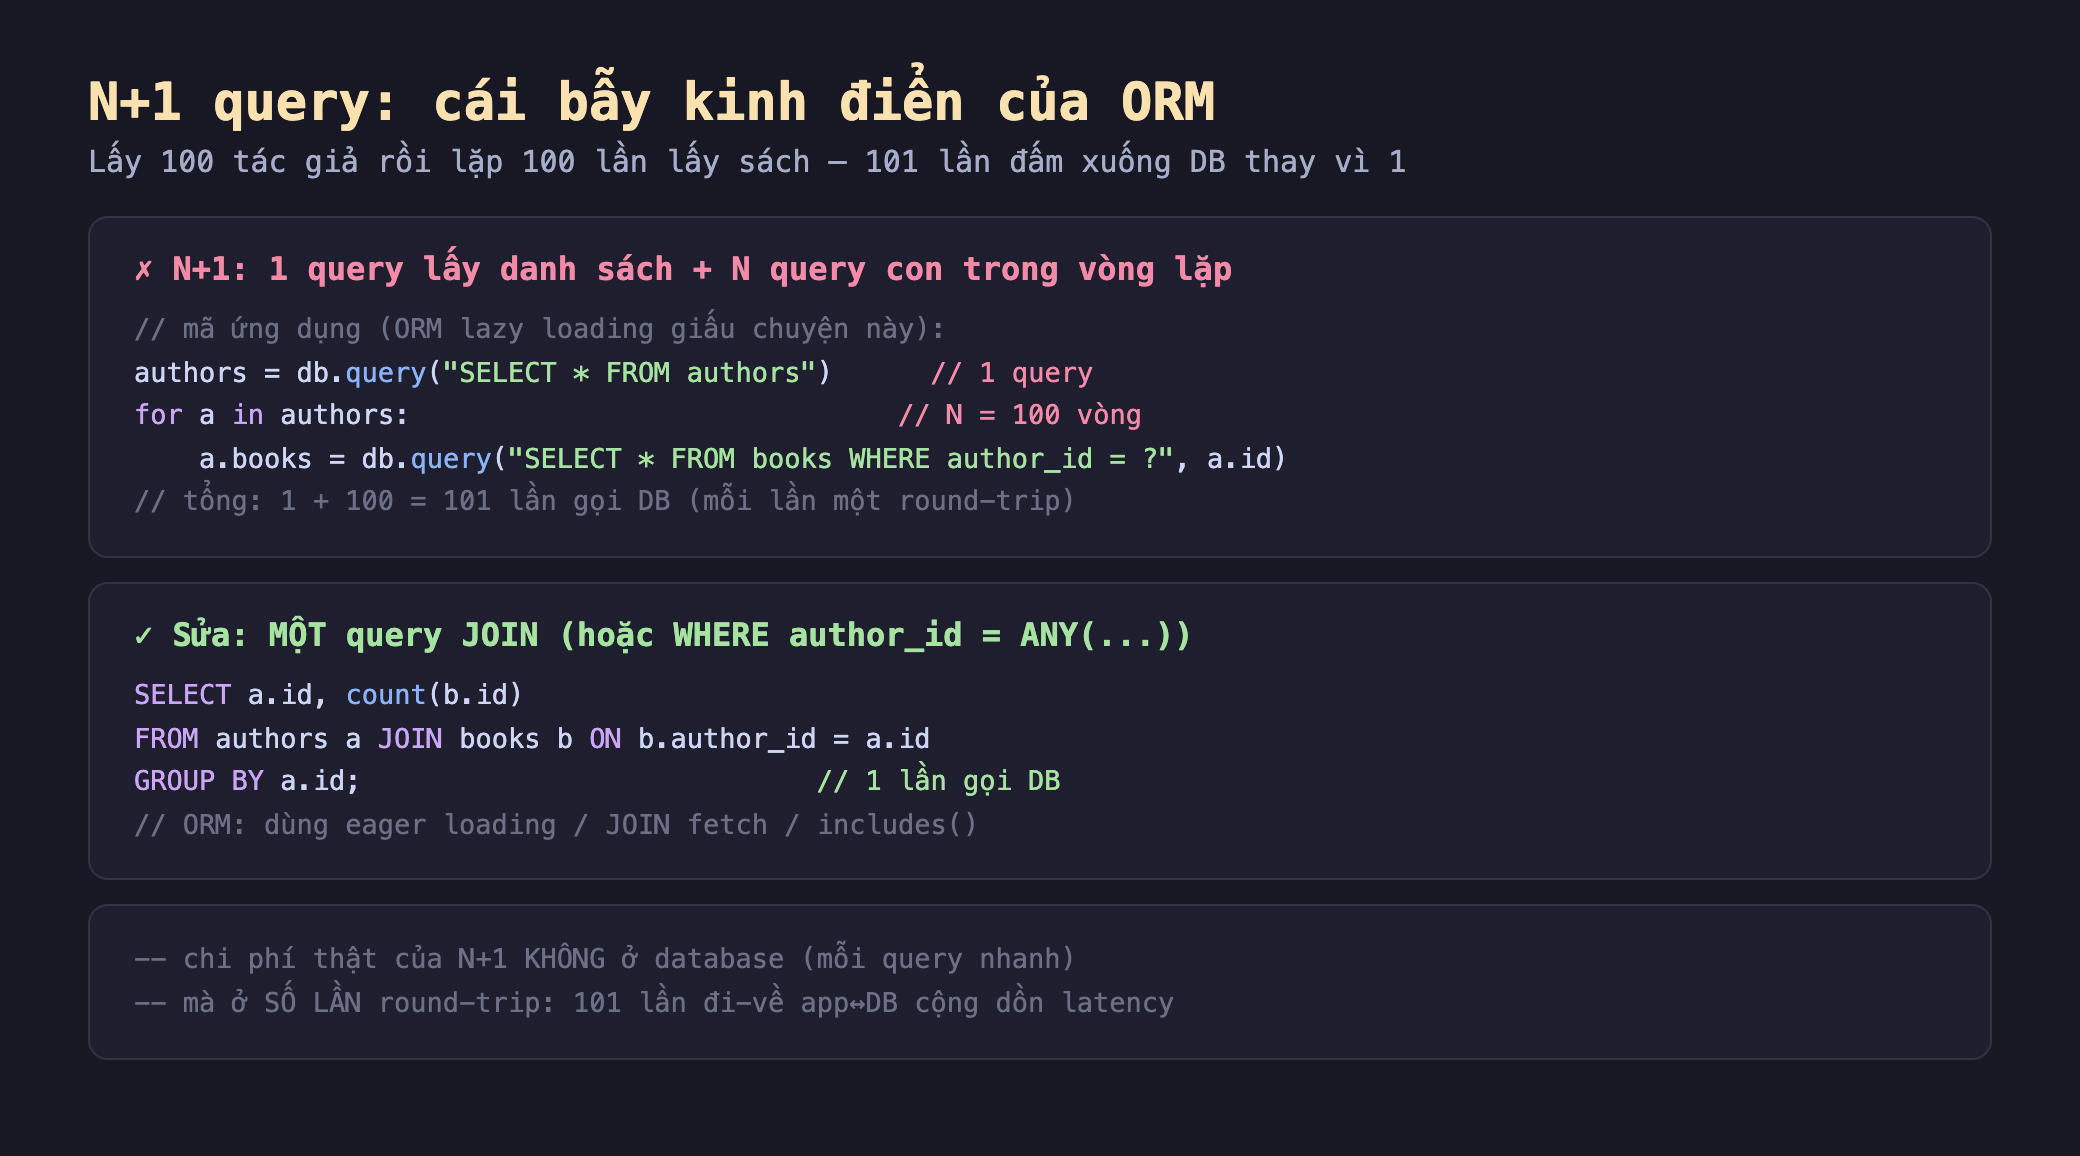
Hình 1: N+1 — mã ứng dụng lấy danh sách (1 query) rồi vòng lặp lấy chi tiết mỗi phần tử (N query), tổng 1+100=101 lần gọi DB, ORM giấu bằng lazy loading. Sửa bằng một query JOIN (hoặc WHERE author_id = ANY(...)). Chi phí thật nằm ở số lần round-trip cộng dồn, không ở database.
Đo thật trong pg-lab
Mình tạo trong pg-lab (PostgreSQL 16) authors (100) và books (50.000), rồi đo N+1 (101 query) so với một JOIN — từ hai góc độ để thấy chi phí thật nằm ở đâu.
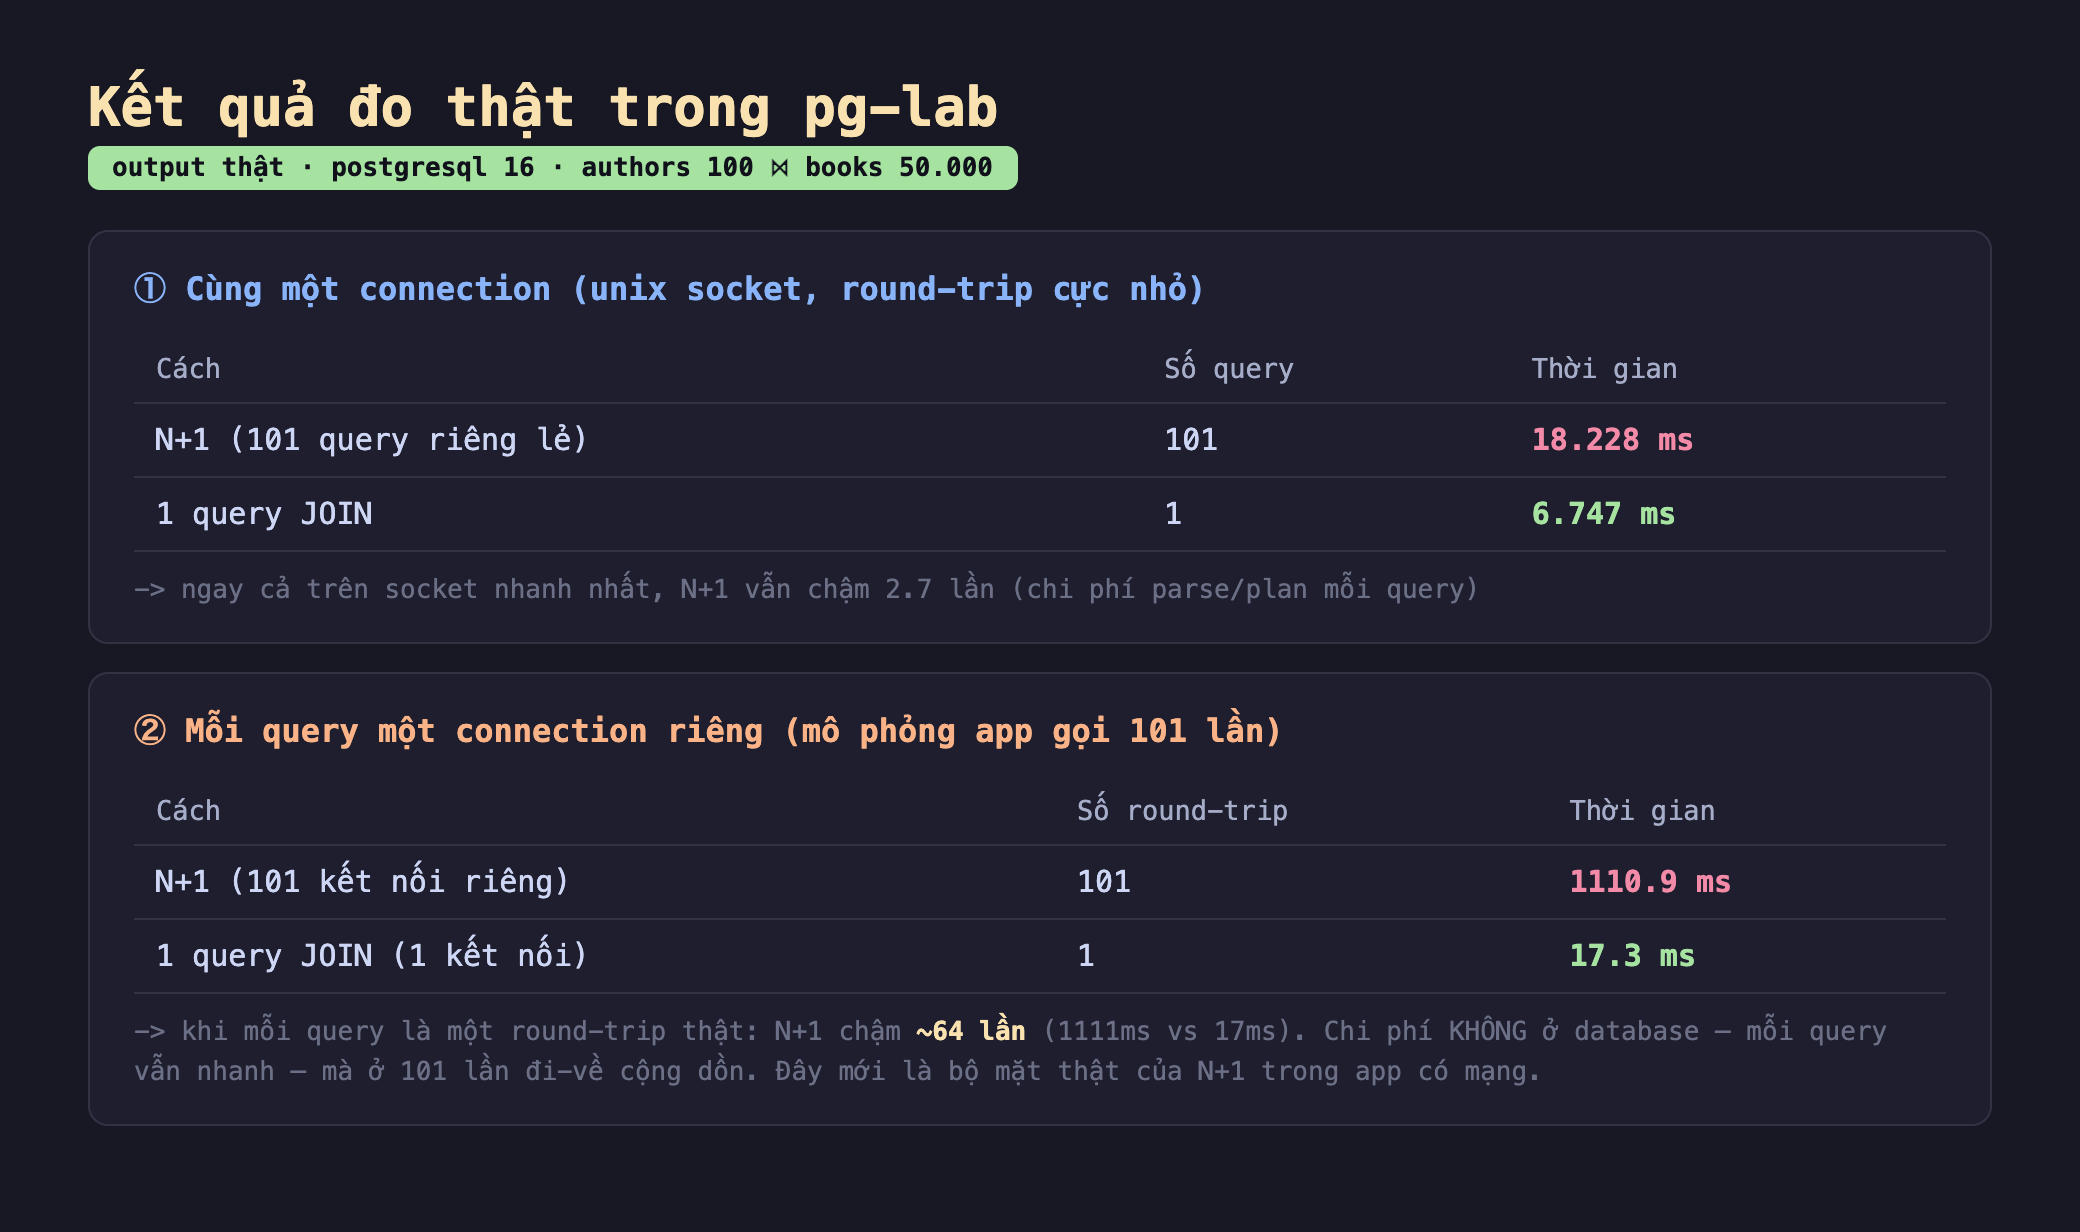
Hình 2: Kết quả thật — ① cùng một connection (socket): N+1 101 query 18.228ms vs 1 JOIN 6.747ms (chậm 2.7 lần, chi phí parse/plan); ② mỗi query một connection riêng (như app gọi qua mạng): N+1 1110.9ms vs 1 JOIN 17.3ms — chậm ~64 lần.
Hai phép đo lộ ra bản chất N+1:
- Ngay cả trên socket nhanh nhất, N+1 vẫn chậm. Chạy 101 query trong cùng một connection (unix socket, round-trip gần như bằng 0) vẫn mất 18.228ms so với 6.747ms của một JOIN — chậm 2.7 lần. Đây là chi phí cố định mỗi query: parse SQL, lập kế hoạch, gửi/nhận. Nhân với 101 thì cộng dồn đáng kể dù mỗi query đơn lẻ rất nhanh.
- Round-trip mới là kẻ giết người thật. Khi mỗi query là một kết nối riêng — mô phỏng đúng cách một ứng dụng gọi database qua mạng, mỗi lần một round-trip — N+1 mất 1110.9ms trong khi một JOIN chỉ 17.3ms. Chậm 64 lần. Con số nhảy vọt này chính là bộ mặt thật của N+1 trong hệ thống production, nơi app và DB cách nhau một quãng mạng có độ trễ.
- Chi phí KHÔNG ở database. Đây là điểm mấu chốt cần hiểu: mỗi query con (
SELECT ... WHERE author_id = k) tự nó rất nhanh — database làm việc chẳng bao nhiêu. Cái đắt là 101 lần đi-về giữa app và DB: mỗi lần một round-trip mạng, và 101 round-trip cộng lại thành cả giây. Đó là lý do sửa N+1 không phải là "tối ưu query" mà là "giảm số lần gọi".
Đánh đổi cần cân nhắc
ORM tiện nhưng giấu N+1 — phải chủ động bật eager loading. Sức mạnh của ORM (truy cập author.books như một thuộc tính) cũng chính là cái bẫy: nó lazy load — mỗi lần chạm thuộc tính là một query ngầm, và trong vòng lặp thành N+1 mà code nhìn hoàn toàn sạch sẽ. Cách chữa là chủ động dùng eager loading: JOIN FETCH (Hibernate/JPA), select_related/prefetch_related (Django), includes (Rails), Preload (GORM). Chúng bảo ORM "lấy hết một lần bằng JOIN hoặc IN" thay vì lặp. Quy tắc: bất cứ khi nào lặp qua một collection rồi truy cập quan hệ bên trong, nghi ngờ N+1.
Một query lớn thường thắng, nhưng JOIN cũng có giới hạn. Gộp N+1 thành một JOIN gần như luôn tốt khi có latency mạng. Nhưng đừng gộp mù quáng: một JOIN nhiều bảng one-to-many có thể sinh tích Descartes (mỗi tác giả có 50 sách × 10 review = 500 dòng trùng lặp tác giả), tải về dữ liệu thừa. Với trường hợp đó, đôi khi hai query (một cho sách, một cho review, gộp bằng WHERE id = ANY(...)) lại ít dữ liệu hơn một JOIN ba tầng. Nguyên tắc: giảm round-trip là mục tiêu, nhưng cân với lượng dữ liệu chuyển về — "2 query" vẫn tốt hơn nhiều so với "N+1", và đôi khi tốt hơn "1 JOIN khổng lồ".
Phải phát hiện được N+1 mới sửa được. Vì N+1 vô hình trong code, cần công cụ để lộ nó ra: bật log query của database (hay của ORM) và đếm — thấy cùng một mẫu query lặp N lần là dấu hiệu rõ ràng; dùng APM/tracing (như loạt Observability trước) để thấy một request sinh hàng trăm query; hoặc thư viện chuyên phát hiện N+1 (Bullet cho Rails, nplusone cho Python). Không đo thì N+1 nằm im cho tới khi dữ liệu lớn lên và trang bỗng chậm — lúc đó khó lần ra vì code trông vô tội.
Ba ý mang về
- N+1 biến một vòng lặp thành 101 query: đo thật, lấy 100 tác giả rồi lặp lấy sách = 1+100 query; ORM giấu chuyện này sau lazy loading nên code trông sạch nhưng lặng lẽ đấm xuống DB 101 lần.
- Chi phí nằm ở round-trip, không ở database: đo thật, cùng connection N+1 chậm 2.7 lần (18.2ms vs 6.7ms — chi phí parse/plan), nhưng khi mỗi query là round-trip thật thì N+1 chậm 64 lần (1110.9ms vs 17.3ms) — mỗi query con vẫn nhanh, cái đắt là 101 lần đi-về cộng dồn.
- Sửa bằng gộp query + chủ động phát hiện: dùng JOIN hoặc
WHERE id = ANY(...), bật eager loading trong ORM (JOIN FETCH/prefetch_related/includes/Preload); cân với tích Descartes (đôi khi 2 query tốt hơn 1 JOIN khổng lồ); và bật log query/APM để phát hiện N+1 vốn vô hình trong code.
Nguồn
- PostgreSQL — = ANY / IN (gộp nhiều id một query): https://www.postgresql.org/docs/current/functions-comparisons.html
- Django — select_related & prefetch_related: https://docs.djangoproject.com/en/stable/ref/models/querysets/#select-related
- Hibernate — Fetching strategies (N+1 & JOIN FETCH): https://docs.jboss.org/hibernate/orm/current/userguide/html_single/Hibernate_User_Guide.html#fetching
Phần sau ta bước sang transaction: bốn mức cô lập (isolation level) của PostgreSQL — READ COMMITTED, REPEATABLE READ, SERIALIZABLE — và tái hiện thật các hiện tượng bất thường (non-repeatable read, phantom) để thấy mỗi mức bảo vệ tới đâu.
