Khi chỉ có một người dùng database, mọi thứ đơn giản. Nhưng production có hàng nghìn transaction chạy đồng thời, đọc và ghi cùng những dòng dữ liệu, và lúc đó nảy sinh các hiện tượng bất thường (anomaly) mà nếu không hiểu, bạn sẽ có những bug cực kỳ khó tái hiện: số dư sai, đơn hàng trùng, ràng buộc nghiệp vụ bị phá vỡ mà không rõ vì sao. Isolation level (mức cô lập) là cách bạn nói với database "tôi chấp nhận thấy bao nhiêu ảnh hưởng từ các transaction khác".
SQL chuẩn định nghĩa bốn mức, PostgreSQL cài ba (READ COMMITTED, REPEATABLE READ, SERIALIZABLE — READ UNCOMMITTED của PG hành xử như READ COMMITTED). Mỗi mức chống được một số anomaly và để lọt số khác. Vấn đề là các anomaly này trừu tượng khi đọc lý thuyết — nên bài này (phần 6 loạt SQL sâu) tái hiện thật chúng bằng hai transaction chạy đồng thời, để thấy tận mắt mức nào chống được gì.
Cơ chế: anomaly và các mức cô lập
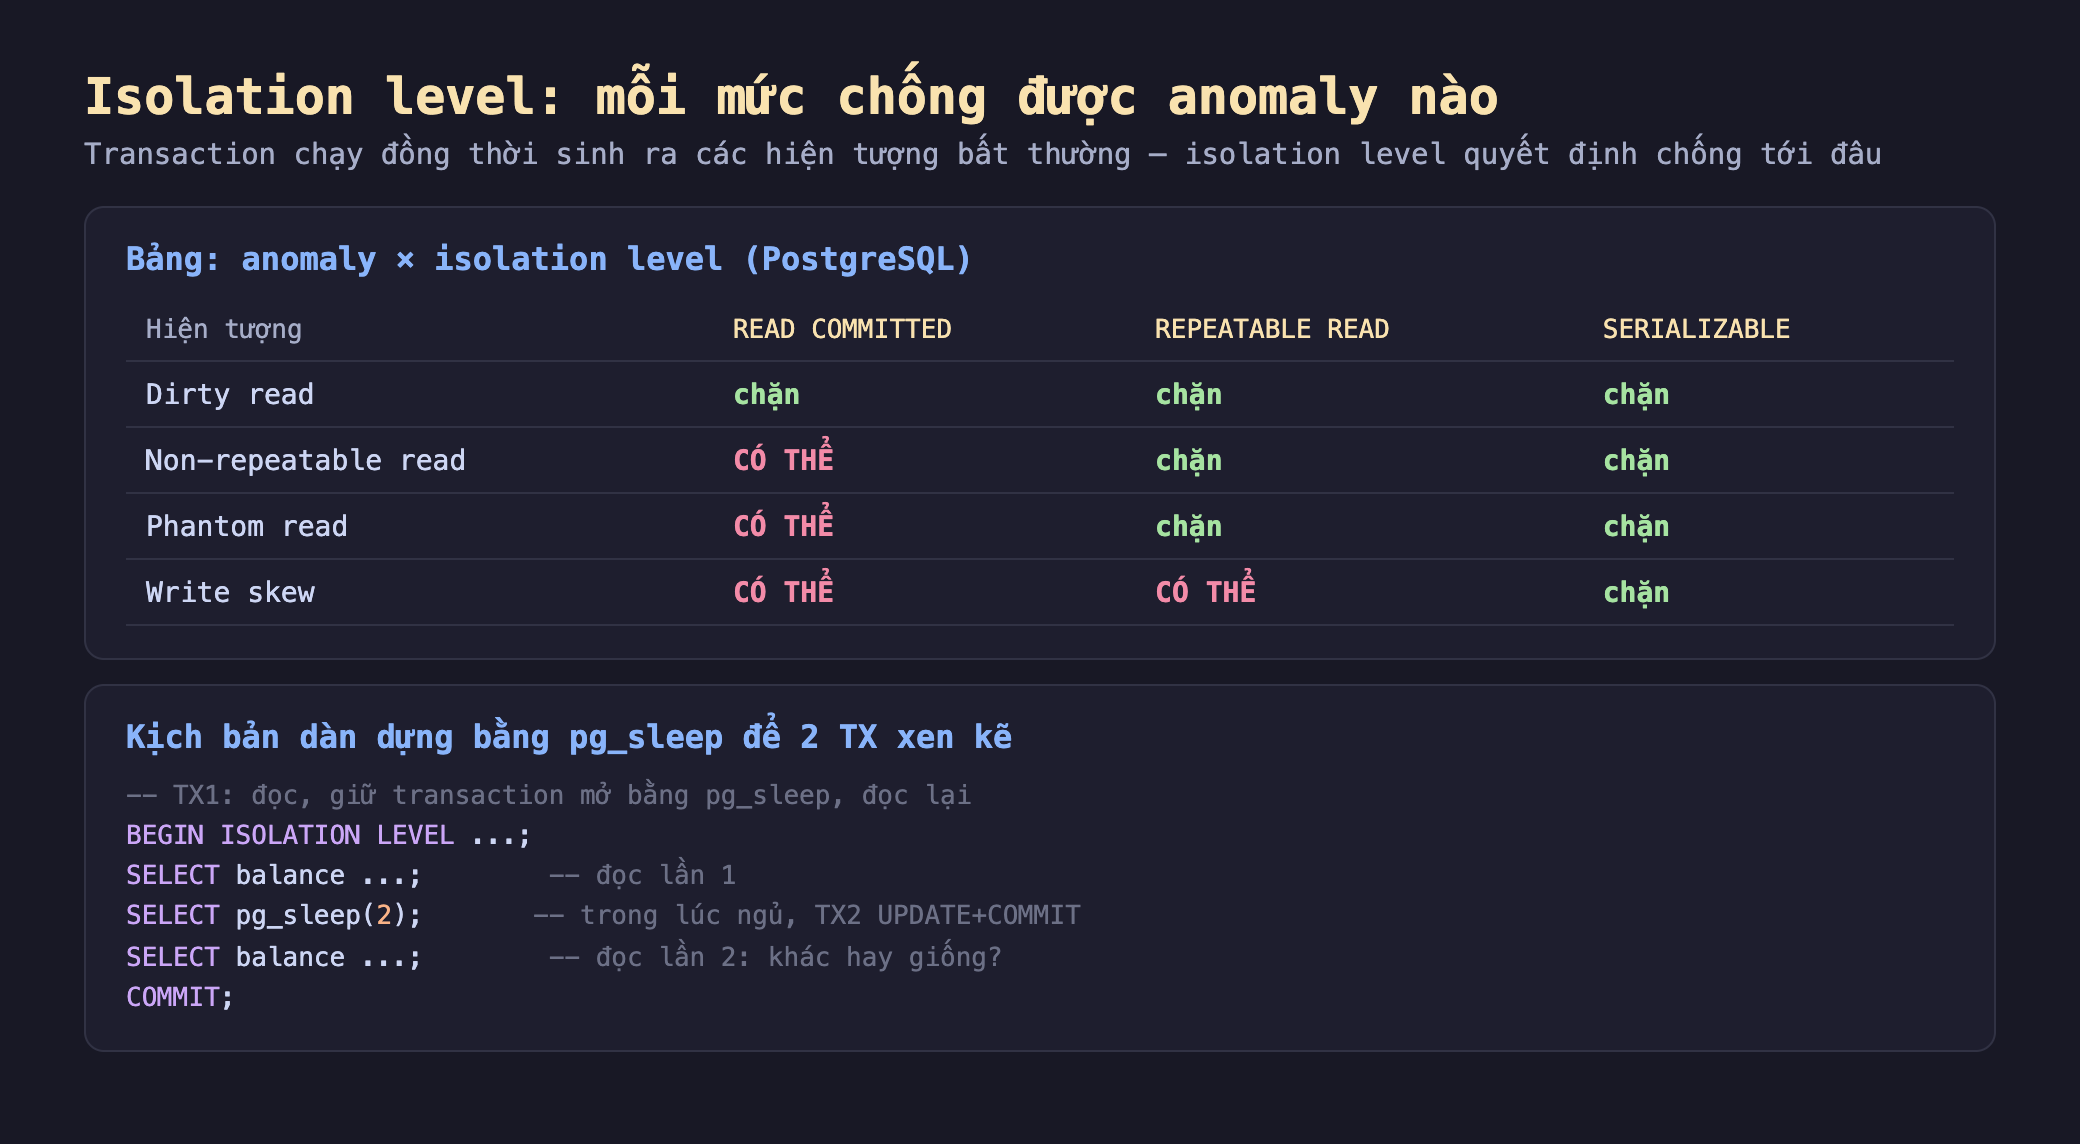
Hình 1: Bảng anomaly × isolation level của PostgreSQL — READ COMMITTED để lọt non-repeatable read, phantom, write skew; REPEATABLE READ chặn hai cái đầu; chỉ SERIALIZABLE chặn cả write skew. Kịch bản tái hiện dùng pg_sleep giữ TX1 mở trong lúc TX2 chạy để hai transaction xen kẽ.
Mẹo tái hiện: để hai transaction xen kẽ nhau một cách xác định, mình cho TX1 đọc một lần, rồi SELECT pg_sleep(2) để giữ transaction mở trong 2 giây — trong khoảng đó khởi động TX2 làm việc của nó và commit, rồi TX1 đọc lại. Cách này dàn dựng chính xác thứ tự xảy ra.
Đo thật trong pg-lab
Mình chạy trong pg-lab (PostgreSQL 16) hai kịch bản với hai session psql đồng thời.
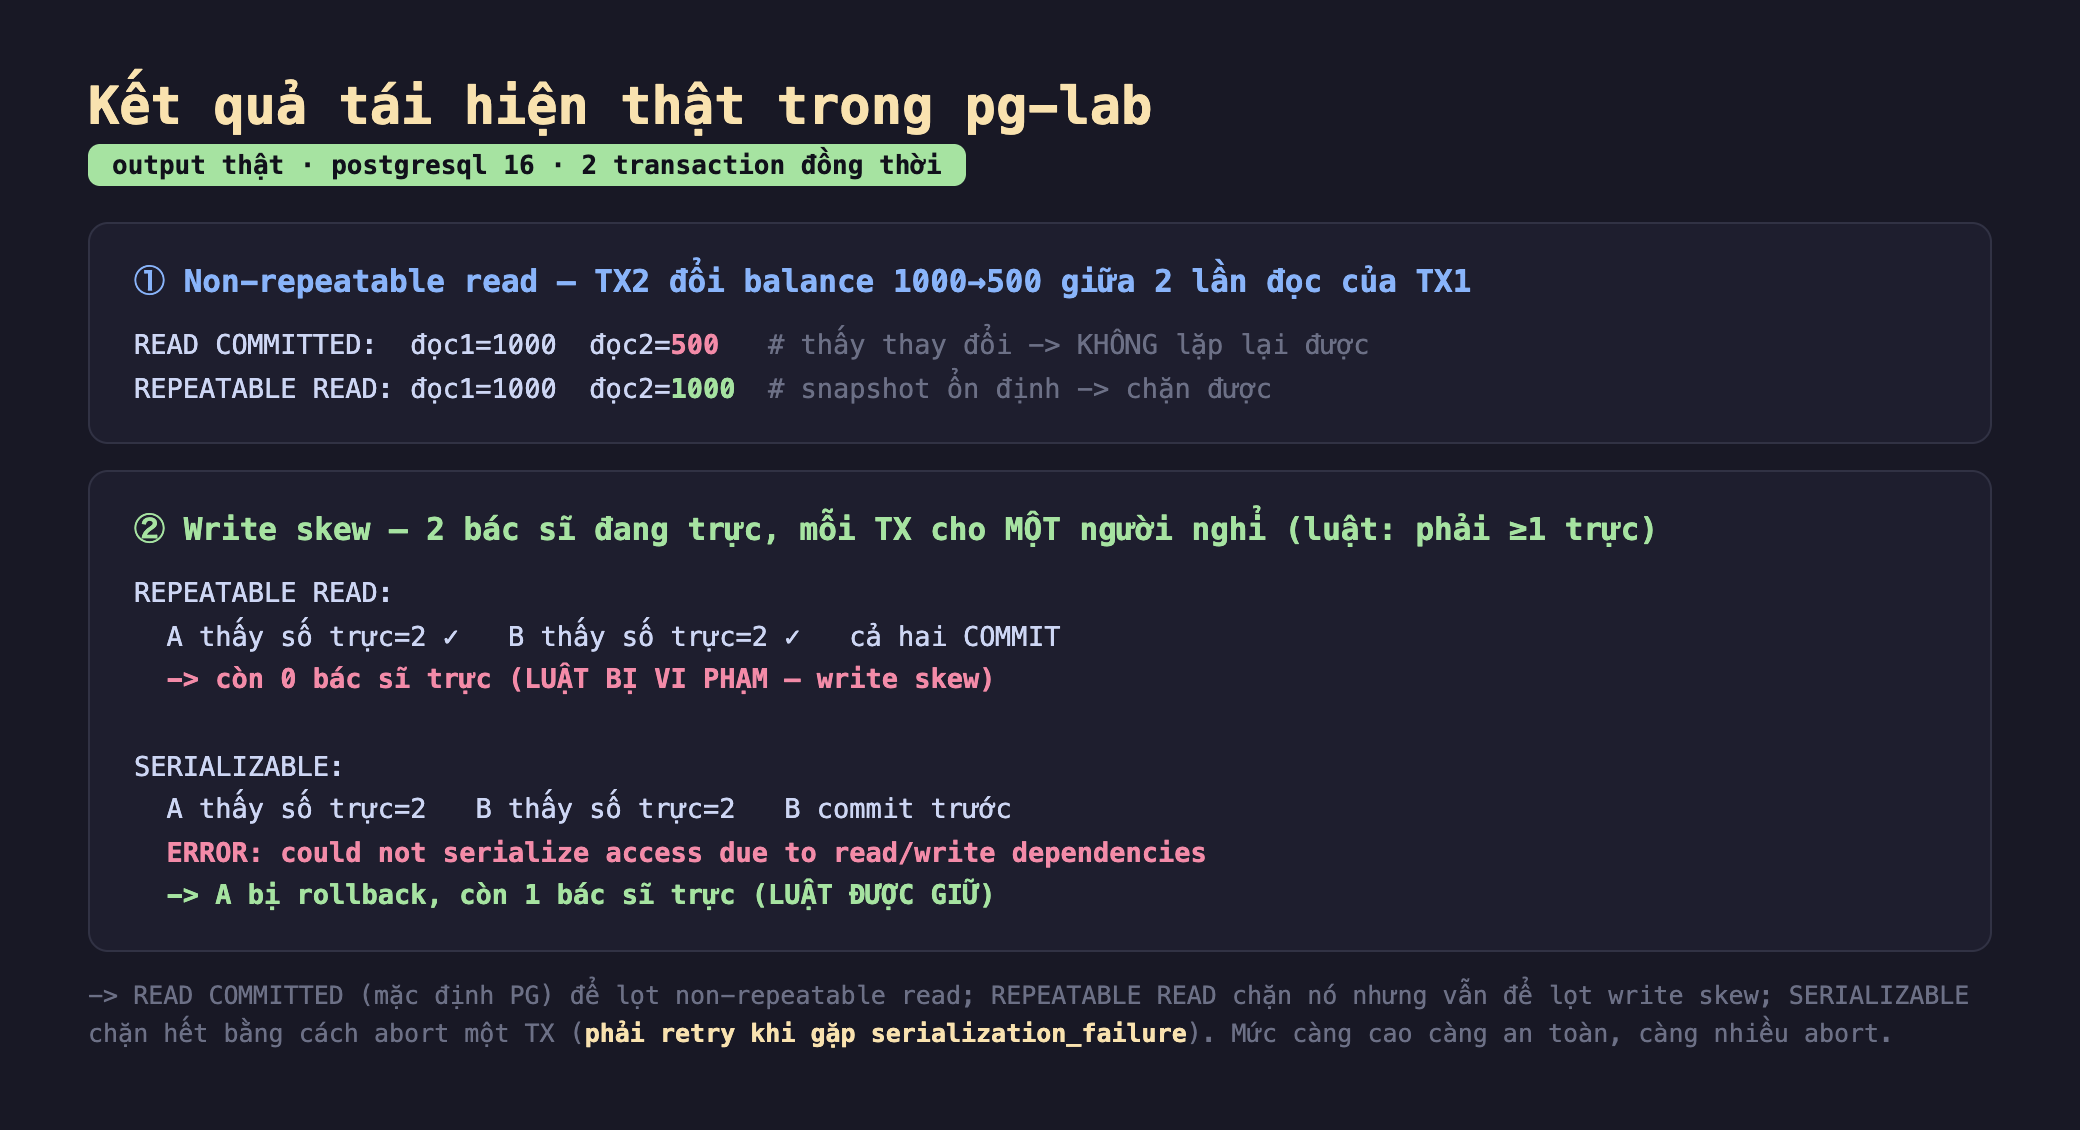
Hình 2: Kết quả tái hiện thật — ① non-repeatable read: READ COMMITTED cho đọc1=1000, đọc2=500 (thấy thay đổi), REPEATABLE READ cho đọc2=1000 (snapshot ổn định); ② write skew: REPEATABLE READ cho cả hai commit → 0 bác sĩ trực (vi phạm), SERIALIZABLE báo serialization_failure và abort A → 1 bác sĩ trực (giữ luật).
Hai kịch bản, hai bài học rõ ràng:
- Non-repeatable read: READ COMMITTED thấy thay đổi giữa chừng. Ở READ COMMITTED (mặc định của PostgreSQL), mỗi câu lệnh nhìn một snapshot mới nhất. Nên TX1 đọc
balance=1000, TX2 sửa thành 500 và commit, TX1 đọc lại thấy500— cùng một transaction, hai lần đọc khác nhau. Với REPEATABLE READ, TX1 dùng một snapshot cố định cho cả transaction, nên đọc lại vẫn1000dù TX2 đã commit. Đây là khác biệt cốt lõi: READ COMMITTED nhất quán ở mức câu lệnh, REPEATABLE READ nhất quán ở mức transaction. - Write skew: cái bẫy mà REPEATABLE READ không chống được. Đây là ca tinh vi hơn. Luật: "luôn phải có ≥1 bác sĩ trực". Hai bác sĩ đang trực. TX-A đọc "có 2 người trực" (ổn, mình nghỉ được) rồi cho bác sĩ 1 nghỉ. TX-B đọc "có 2 người trực" (ổn) rồi cho bác sĩ 2 nghỉ. Hai TX ghi hai dòng khác nhau nên không xung đột ghi trực tiếp — ở REPEATABLE READ cả hai commit, kết quả 0 bác sĩ trực, luật bị phá. Mỗi TX đều "đúng" theo snapshot của nó, nhưng kết hợp lại thì sai.
- SERIALIZABLE bắt được write skew bằng cách abort. Ở SERIALIZABLE, PostgreSQL theo dõi các phụ thuộc đọc-ghi giữa các transaction (Serializable Snapshot Isolation). Nó phát hiện A và B tạo thành một chu trình nguy hiểm và abort một trong hai với lỗi
could not serialize access due to read/write dependencies. Kết quả: A bị rollback, còn 1 bác sĩ trực — luật được giữ. Cái giá: A phải thử lại.
Đánh đổi cần cân nhắc
Mức càng cao càng an toàn nhưng càng nhiều abort — phải retry. SERIALIZABLE cho bạn sự đảm bảo mạnh nhất (transaction chạy như thể tuần tự), nhưng đổi lại nó abort các transaction xung đột với serialization_failure. Nghĩa là mọi transaction ở SERIALIZABLE bắt buộc phải có vòng lặp retry — bắt lỗi serialization và chạy lại. Bỏ qua retry là ứng dụng thỉnh thoảng "lỗi ngẫu nhiên" dưới tải cao. Đây là chi phí thật của mức cô lập cao: không chỉ chậm hơn, mà đòi hỏi code khác đi.
READ COMMITTED đủ cho phần lớn, chọn mức theo nhu cầu. Đừng mặc định nhảy lên SERIALIZABLE "cho chắc". READ COMMITTED (mặc định PG) đủ cho đa số ứng dụng CRUD thông thường — và nó nhanh, ít abort. Nâng lên REPEATABLE READ khi cần báo cáo nhất quán (nhiều câu SELECT trong một transaction phải thấy cùng một ảnh chụp dữ liệu, không bị đổi giữa chừng). Chỉ dùng SERIALIZABLE cho các ràng buộc nghiệp vụ phức tạp mà write skew có thể phá (như ví dụ bác sĩ trực, đặt chỗ trùng, giới hạn số dư) — và khi đó chấp nhận chi phí retry.
Có cách chống write skew mà không cần SERIALIZABLE — khoá tường minh. Nếu chỉ vài chỗ cần chống write skew, thay vì nâng cả transaction lên SERIALIZABLE, bạn có thể dùng khoá tường minh: SELECT ... FOR UPDATE (khoá dòng đọc để TX khác chờ) hoặc khoá ở mức phù hợp. Điều này biến "đọc rồi ghi" thành tuần tự cho đúng những dòng liên quan, chống được write skew mà không đổi isolation level toàn transaction. Đánh đổi: FOR UPDATE gây chờ (blocking) thay vì abort — chọn tuỳ bạn muốn "chờ" hay "thử lại".
Ba ý mang về
- Non-repeatable read: READ COMMITTED nhất quán mức câu lệnh, REPEATABLE READ mức transaction: tái hiện thật, ở READ COMMITTED cùng transaction đọc balance ra
1000rồi500(thấy commit của TX khác); REPEATABLE READ giữ snapshot cố định nên đọc lại vẫn1000. - Write skew là bẫy mà REPEATABLE READ không chống được: tái hiện thật, hai TX cùng đọc "2 bác sĩ trực" rồi mỗi TX cho một người nghỉ (ghi hai dòng khác nhau, không xung đột trực tiếp) → REPEATABLE READ cho cả hai commit → 0 người trực (luật bị phá); chỉ SERIALIZABLE bắt được, abort A với
serialization_failure→ 1 người trực. - Chọn mức theo nhu cầu, mức cao đòi retry: READ COMMITTED (mặc định) đủ cho đa số; REPEATABLE READ cho báo cáo nhất quán; SERIALIZABLE cho ràng buộc phức tạp nhưng bắt buộc có vòng retry khi gặp
serialization_failure; hoặc dùngSELECT ... FOR UPDATEchống write skew cục bộ mà không nâng cả transaction.
Nguồn
- PostgreSQL — Transaction Isolation: https://www.postgresql.org/docs/current/transaction-iso.html
- PostgreSQL — Explicit Locking (FOR UPDATE): https://www.postgresql.org/docs/current/explicit-locking.html
- Martin Kleppmann — Designing Data-Intensive Applications (Ch.7: Weak Isolation & write skew): https://dataintensive.net/
Phần sau ta mở nắp cơ chế đằng sau các snapshot này: MVCC — cách PostgreSQL giữ nhiều phiên bản của một dòng, vì sao UPDATE sinh "dead tuple" làm bảng phình (bloat), và VACUUM thu hồi chúng thế nào.
