JOIN là một từ khoá, nhưng bên dưới nó PostgreSQL có ba cách hoàn toàn khác nhau để thực thi việc nối hai bảng: nested loop, hash join, và merge join. Không có cái nào "tốt nhất" — mỗi cái thắng trong một tình huống, và planner phải ước lượng để chọn. Khi planner chọn đúng, JOIN nhanh; khi nó chọn sai (thường vì thống kê cũ), cùng một query có thể chậm gấp nhiều lần.
Hiểu ba thuật toán này quan trọng vì hai lý do. Thứ nhất, để đọc plan: khi thấy "Hash Join" hay "Nested Loop" trong EXPLAIN, bạn biết database đang làm gì. Thứ hai, để chẩn đoán: khi một query JOIN bỗng chậm, thường là vì planner chuyển từ thuật toán tốt sang thuật toán tệ cho dữ liệu hiện tại. Bài này (phần 4 loạt SQL sâu) đo thật cả ba trên cùng một cặp bảng, bằng cách ép planner dùng từng kiểu.
Cơ chế: ba cách nối bảng
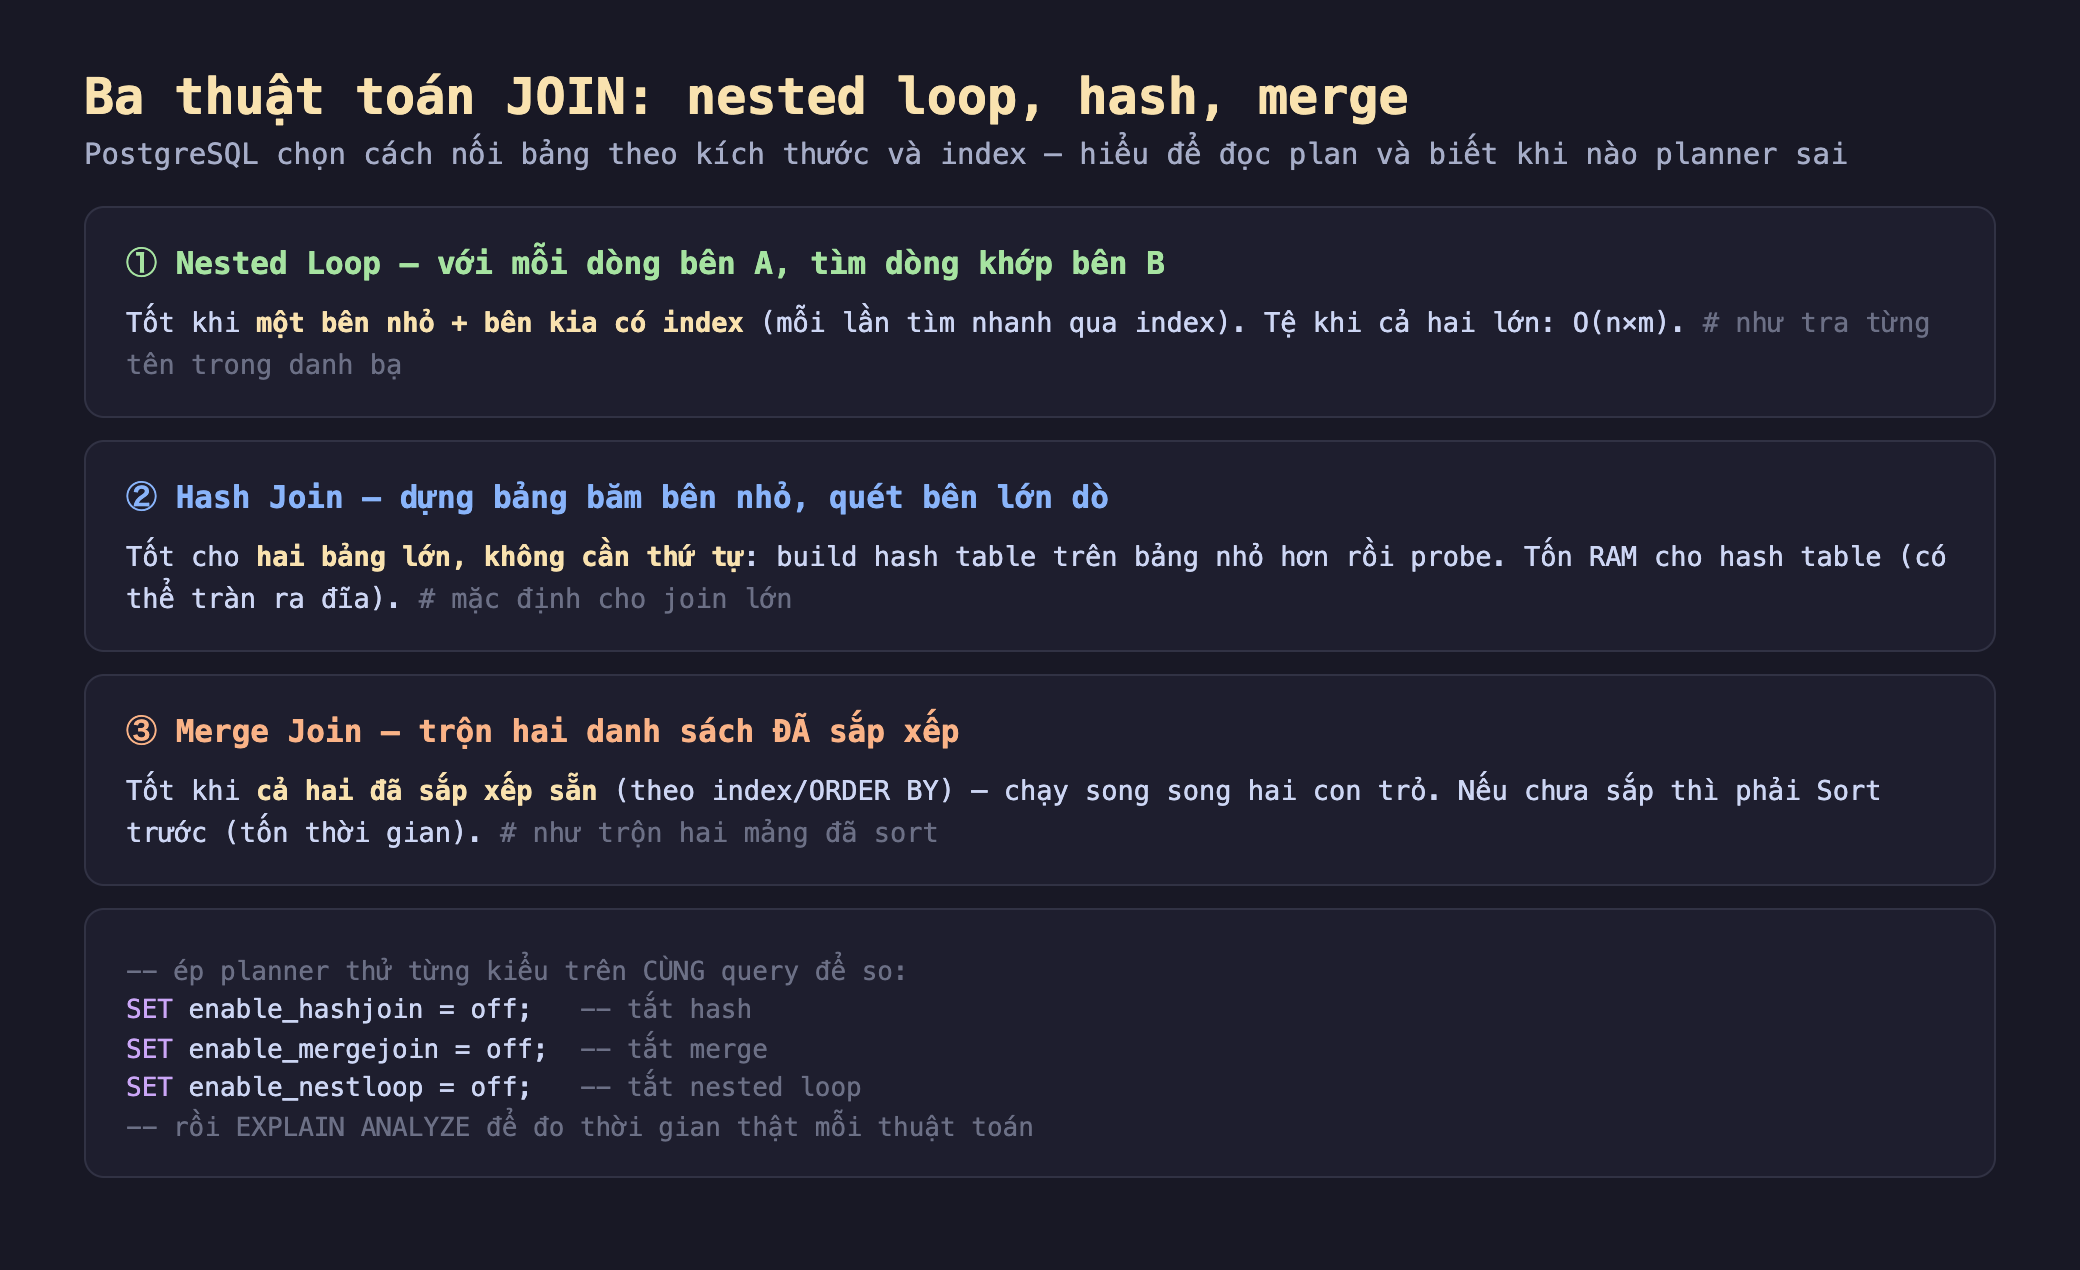
Hình 1: Nested Loop — với mỗi dòng bên A, tìm dòng khớp bên B (tốt khi một bên nhỏ + bên kia có index). Hash Join — dựng bảng băm trên bảng nhỏ, quét bảng lớn dò (tốt cho hai bảng lớn, tốn RAM). Merge Join — trộn hai danh sách đã sắp xếp (tốt khi cả hai sẵn sort, nếu chưa phải Sort trước). Dùng SET enable_*join=off để ép planner thử từng kiểu.
Đo thật trong pg-lab
Mình tạo trong pg-lab (PostgreSQL 16) customers (1000 dòng) và orders (2 triệu dòng, index trên customer_id), rồi đo hai tình huống: lọc một khách hàng, và nối toàn bộ.
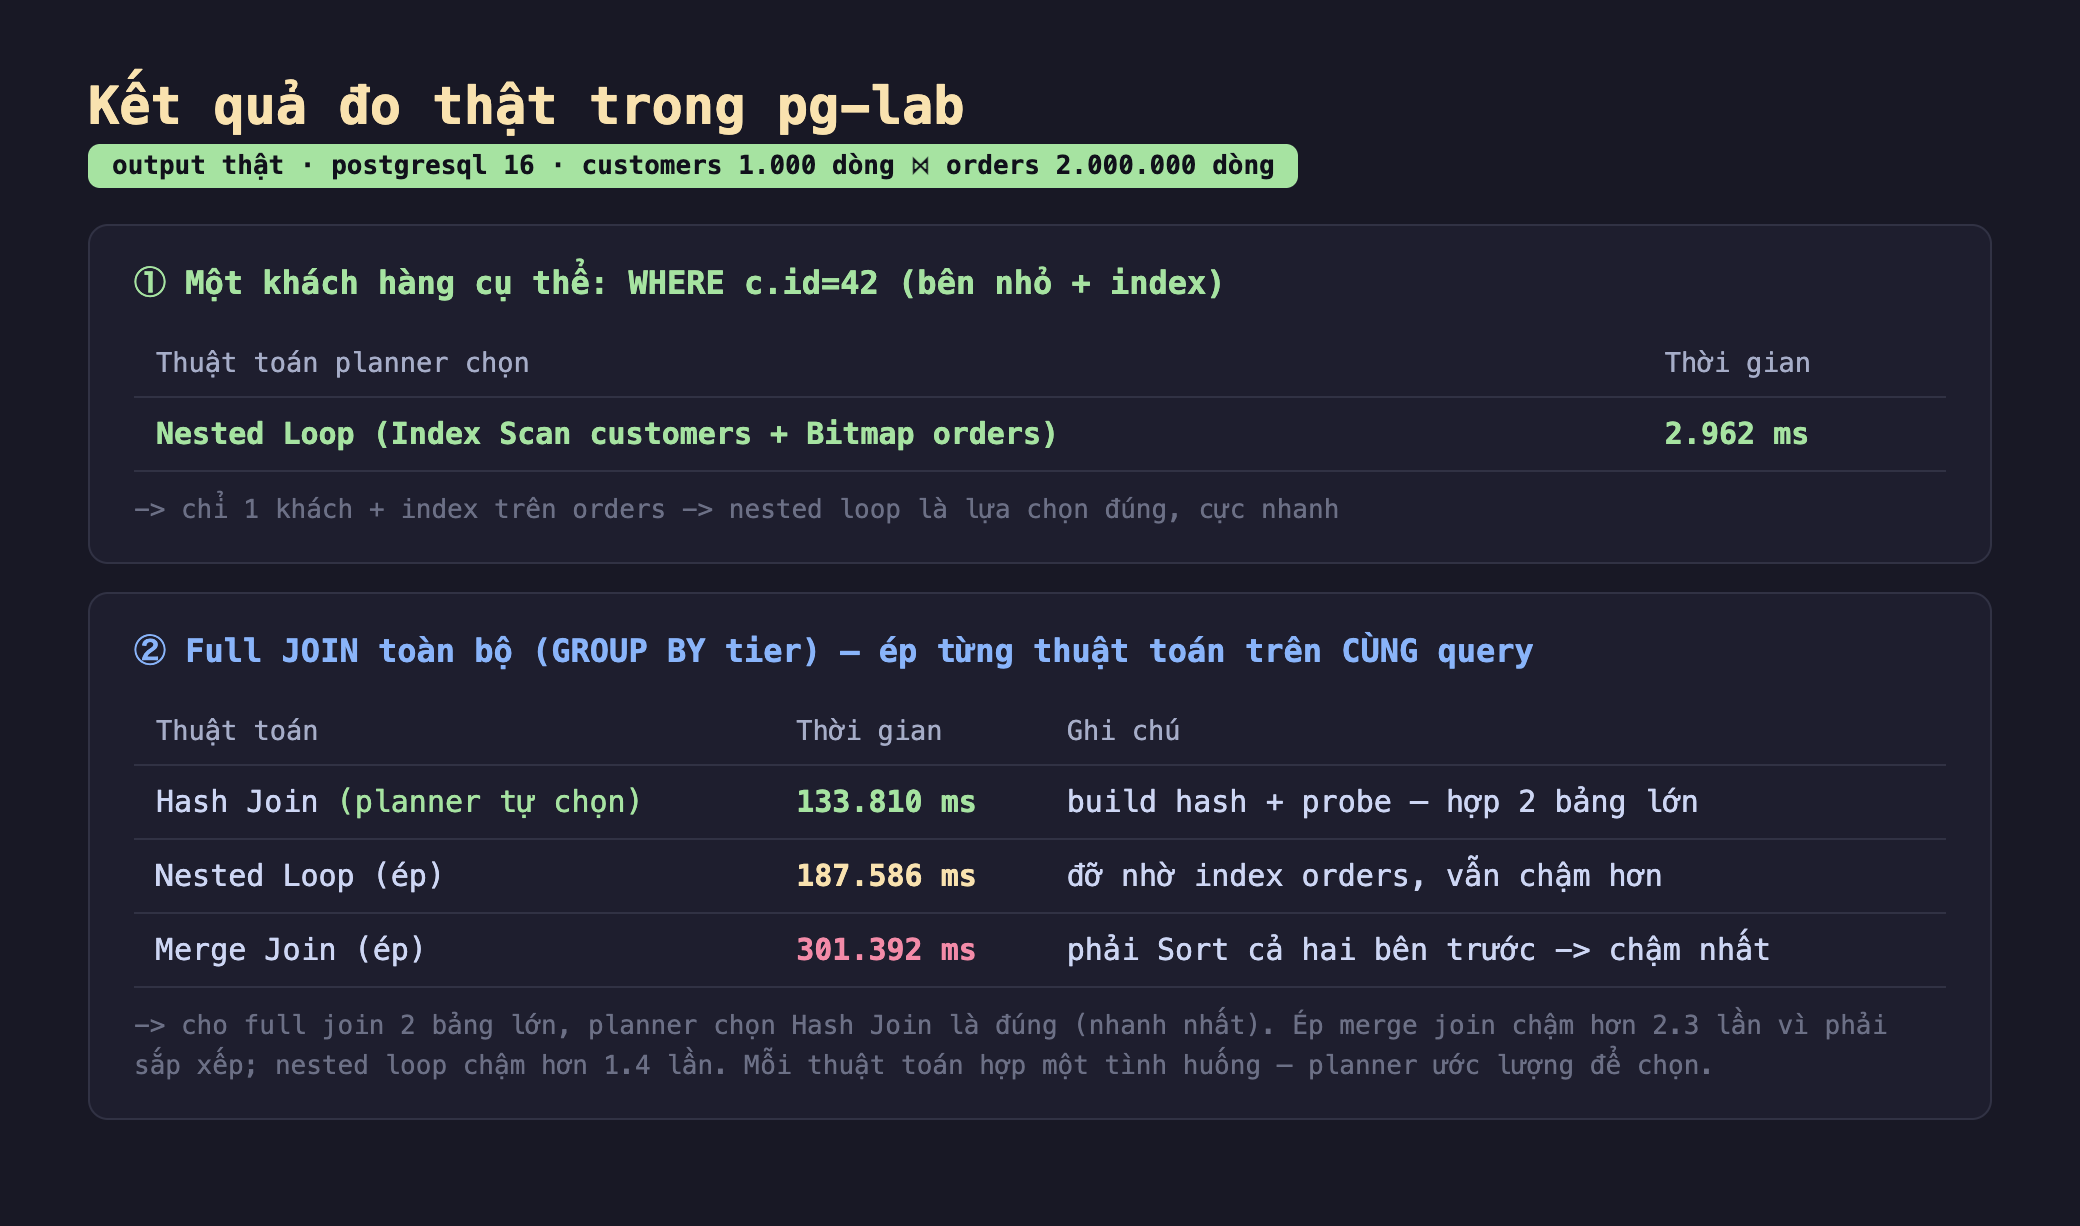
Hình 2: Kết quả thật — ① lọc một khách hàng (WHERE c.id=42): planner chọn Nested Loop, chỉ 2.962ms; ② nối toàn bộ (GROUP BY tier), ép từng thuật toán: Hash Join (planner tự chọn) 133.810ms nhanh nhất, Nested Loop ép 187.586ms, Merge Join ép 301.392ms (phải sắp xếp cả hai bên).
Kết quả cho thấy vì sao "tuỳ tình huống":
- Nested Loop thắng khi một bên nhỏ + index. Với
WHERE c.id=42, chỉ có 1 khách hàng, vàorderscó index trêncustomer_id. Nested Loop lấy 1 dòng customer rồi dùng index tìm các order của nó — chỉ 2.962ms. Đây là lựa chọn hoàn hảo: không cần dựng hash table hay sắp xếp gì, chỉ một lần tra index. - Hash Join thắng khi nối hai bảng lớn. Với query nối toàn bộ 2 triệu order với 1000 customer rồi GROUP BY, planner chọn Hash Join: dựng bảng băm trên
customers(nhỏ), rồi quét một lượtorders(lớn) dò vào hash — 133.810ms. Không cần index, không cần sắp xếp, chỉ một lần quét mỗi bảng. - Ép sai thuật toán thì chậm. Trên cùng query full join, ép Nested Loop mất 187.586ms (chậm 1.4 lần — dù có index orders vẫn phải lặp 2 triệu lần), và ép Merge Join mất 301.392ms (chậm 2.3 lần — vì hai bảng chưa sắp xếp theo khoá join, phải Sort cả hai trước khi trộn). Điều này chứng minh planner chọn Hash Join là đúng cho tình huống này.
Đánh đổi cần cân nhắc
Mỗi thuật toán có "địa hình" riêng — không có cái vô địch. Nested Loop: O(n×m) nếu không index, nhưng O(n×log m) khi bên trong có index — nên tuyệt cho "một ít dòng bên ngoài, index bên trong" (như lấy order của một khách). Hash Join: chỉ quét mỗi bảng một lần (tốt cho bảng lớn), nhưng cần RAM cho hash table — nếu bảng quá lớn vượt work_mem, hash tràn ra đĩa và chậm đi. Merge Join: rẻ nếu dữ liệu đã sắp sẵn (ví dụ cả hai đọc theo cùng một index), nhưng phải trả giá Sort nếu chưa. Chọn đúng phụ thuộc kích thước, index, và thứ tự sẵn có.
Planner chọn dựa trên ước lượng — thống kê sai thì chọn sai. Planner không biết trước dữ liệu; nó ước lượng số dòng mỗi bên dựa trên thống kê (từ ANALYZE). Nếu thống kê cũ hoặc lệch, nó ước lượng sai số dòng và có thể chọn nhầm thuật toán — ví dụ tưởng một bên nhỏ nên chọn Nested Loop, nhưng thực tế bên đó lớn, thành O(n×m) thảm hoạ. Đây là nguyên nhân phổ biến của "query đột nhiên chậm": dữ liệu đổi, thống kê chưa cập nhật, planner chọn sai. Cách phòng là giữ thống kê tươi (chủ đề phần 11).
SET enable_*join=off là để chẩn đoán, không phải để sửa production. Các lệnh SET enable_hashjoin=off... rất hữu ích để thử nghiệm — ép planner dùng từng thuật toán rồi so, như demo này, để hiểu vì sao planner chọn thế. Nhưng đừng để chúng trong code production như một cách "sửa" query chậm: chúng tắt cả một loại thuật toán cho mọi query trong session, và khi dữ liệu đổi, lựa chọn ép cứng đó có thể trở thành lựa chọn tệ. Nếu planner chọn sai thật, cách sửa đúng là sửa gốc (cập nhật thống kê, thêm index, viết lại query), không phải tắt thuật toán.
Ba ý mang về
- Ba thuật toán JOIN, mỗi cái hợp một tình huống: đo thật, Nested Loop thắng khi một bên nhỏ + index (lọc 1 khách: 2.962ms); Hash Join thắng khi nối hai bảng lớn (133.810ms, planner tự chọn); Merge Join hợp khi dữ liệu đã sắp sẵn.
- Ép sai thuật toán chứng minh planner chọn đúng: trên cùng full join, ép Nested Loop 187.586ms (chậm 1.4 lần), ép Merge Join 301.392ms (chậm 2.3 lần vì phải Sort cả hai bên) — Hash Join của planner là nhanh nhất.
- Planner chọn theo ước lượng, giữ thống kê tươi: planner dựa vào thống kê để đoán số dòng và chọn thuật toán; thống kê cũ → đoán sai → chọn nhầm → chậm (nguyên nhân phổ biến của "query đột nhiên chậm");
SET enable_*join=offchỉ để chẩn đoán, sửa gốc bằng cập nhật thống kê/index/viết lại query.
Nguồn
- PostgreSQL — Planner / Optimizer & join methods: https://www.postgresql.org/docs/current/planner-optimizer.html
- PostgreSQL — EXPLAIN (đọc join nodes): https://www.postgresql.org/docs/current/using-explain.html
- Use The Index, Luke — Nested Loops / Hash Join / Sort-Merge: https://use-the-index-luke.com/sql/join
Phần sau ta mổ xẻ cái bẫy kinh điển nhất mà ORM gây ra: N+1 query — thay vì một JOIN, ứng dụng bắn hàng trăm query con, đo thật tổng thời gian chênh lệch và cách gộp lại.
