Phần trước bàn về index một cột. Nhưng query thật thường lọc theo nhiều điều kiện: "lấy sự kiện của user X trong 30 ngày qua". Câu trả lời là index tổ hợp (composite index) — một index trên nhiều cột. Vấn đề là index tổ hợp có một luật mà nếu không nắm, bạn sẽ tạo index rồi ngạc nhiên vì sao query này dùng được mà query kia thì không: quy tắc leftmost prefix (tiền tố trái nhất).
Có một ẩn dụ giúp nhớ: index tổ hợp (user_id, created_at) giống một cuốn danh bạ sắp xếp theo (họ, rồi tên). Bạn tra nhanh "tất cả người họ Nguyễn" (dùng cột đầu), tra nhanh "Nguyễn Văn A" (dùng cả hai). Nhưng tra "tất cả người tên An" mà không biết họ? Vô ích — phải lật cả quyển, vì danh bạ không sắp theo tên. Bài này (phần 3 loạt SQL sâu) đo thật quy tắc đó, tầm quan trọng của thứ tự cột, và một kỹ thuật mạnh: covering index cho phép trả lời query mà không chạm vào bảng.
Cơ chế: leftmost prefix và covering index
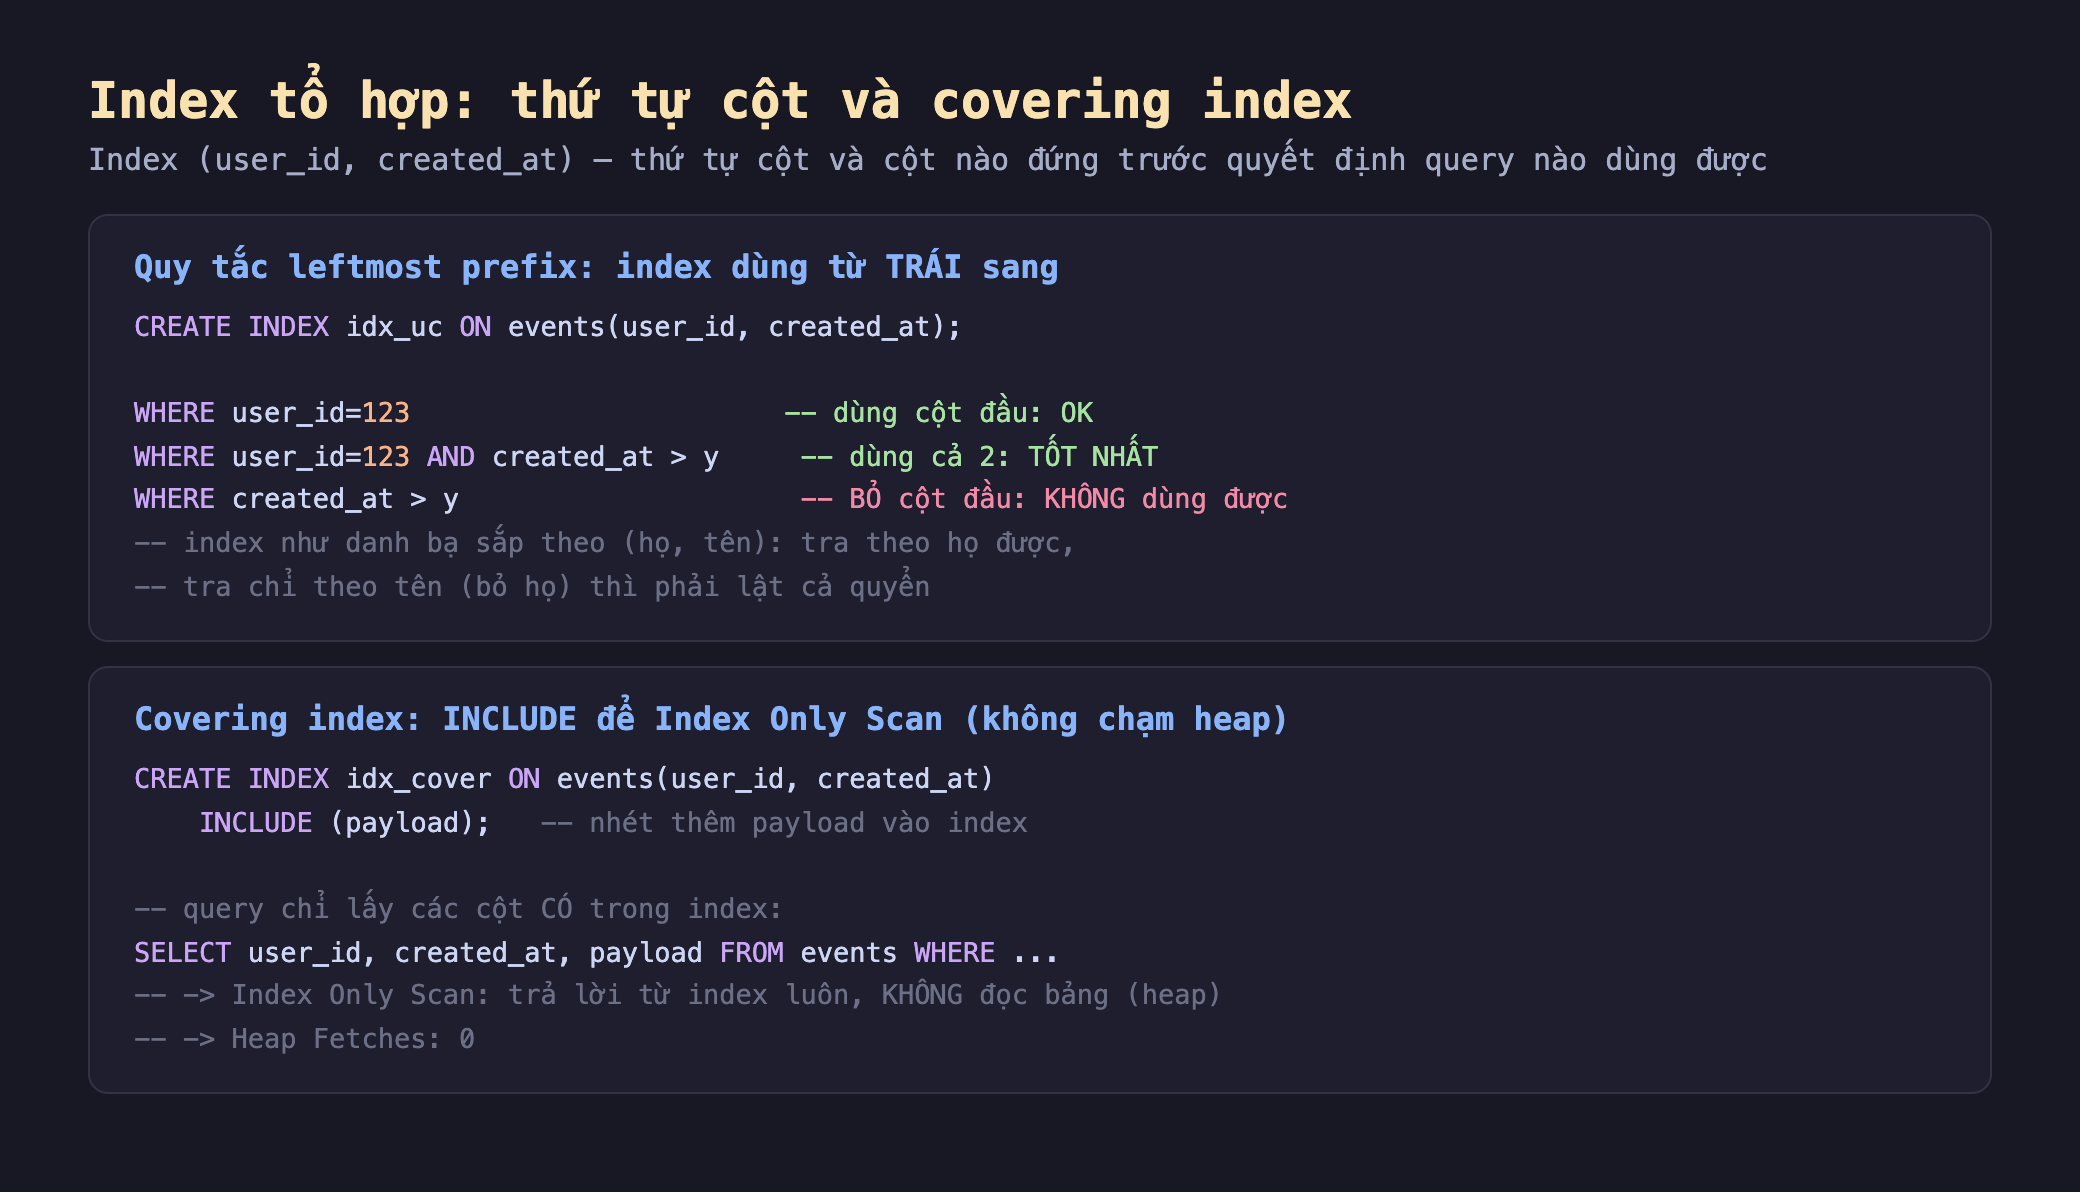
Hình 1: Quy tắc leftmost prefix — index (user_id, created_at) dùng được khi query lọc từ cột trái nhất: user_id một mình OK, user_id AND created_at tốt nhất, nhưng created_at một mình (bỏ cột đầu) thì không. Covering index INCLUDE (payload) nhét thêm cột vào index để Index Only Scan trả lời trọn query mà không đọc bảng (Heap Fetches: 0).
Đo thật trong pg-lab
Mình tạo trong pg-lab (PostgreSQL 16) bảng demo_events 2 triệu dòng với index tổ hợp (user_id, created_at), rồi chạy các query khác nhau.
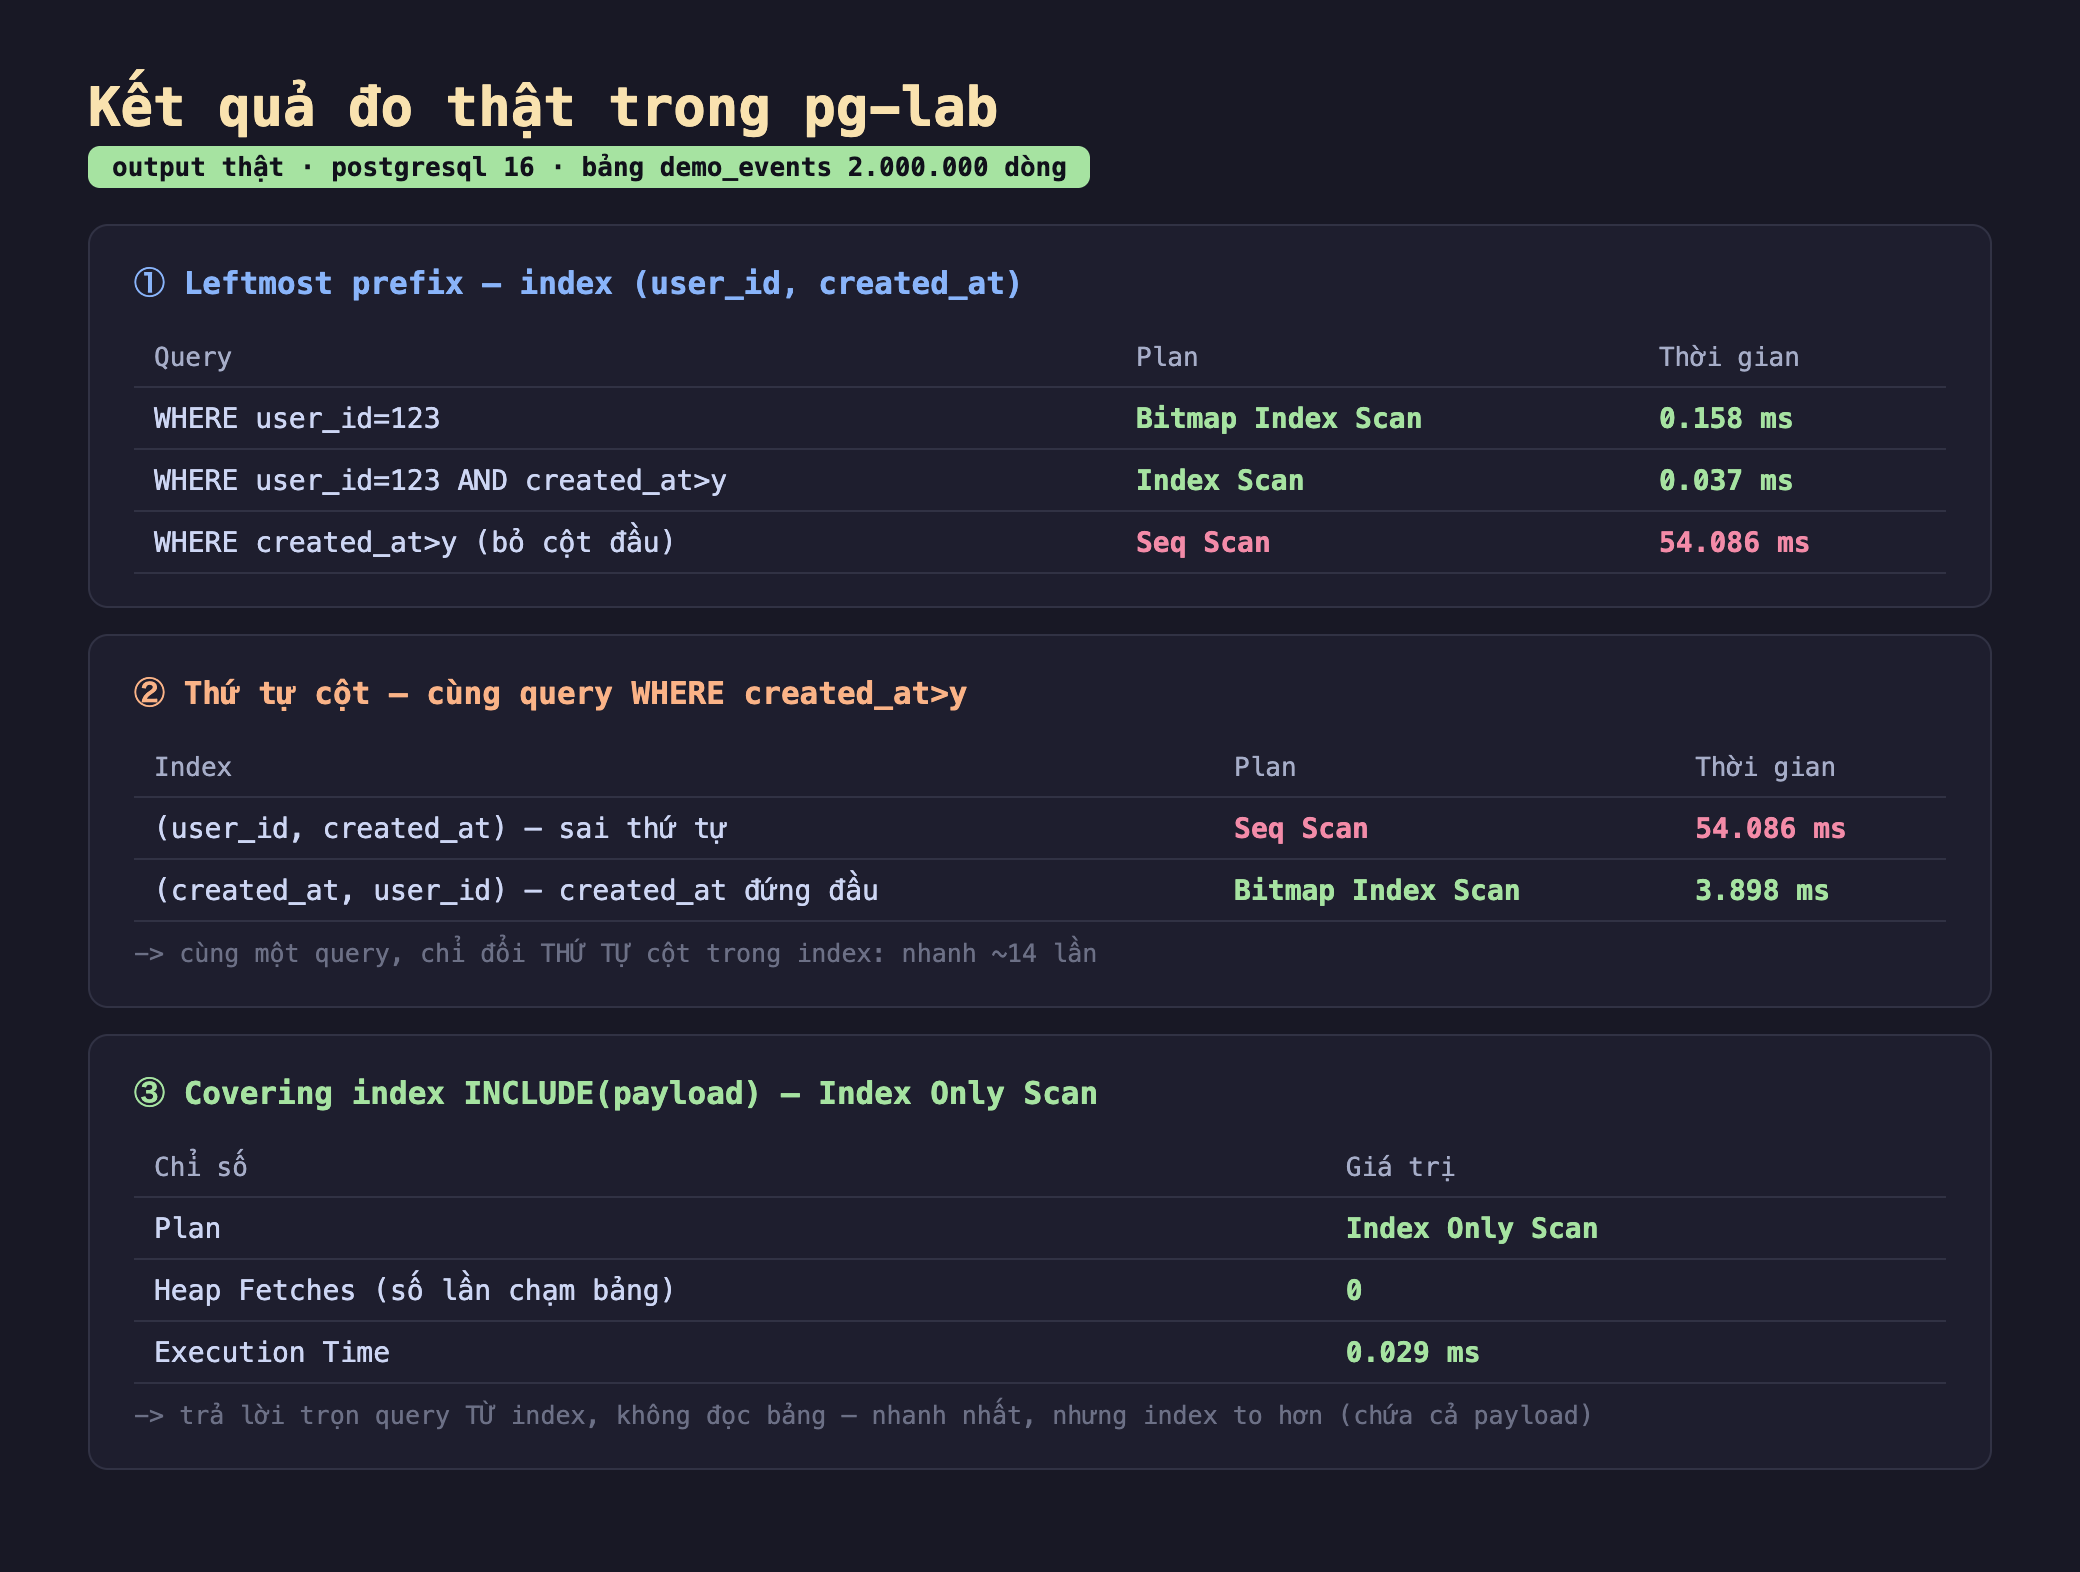
Hình 2: Kết quả thật — ① leftmost: user_id (0.037–0.158ms, dùng index) nhưng created_at một mình (Seq Scan 54.086ms); ② thứ tự cột: cùng query created_at>y là 54ms với index sai thứ tự nhưng 3.898ms khi created_at đứng đầu; ③ covering INCLUDE(payload): Index Only Scan, Heap Fetches: 0, 0.029ms.
Ba tầng bài học:
- Leftmost prefix: cột đầu là chìa khoá. Index
(user_id, created_at)phục vụ tốtWHERE user_id=123(0.158ms) vàWHERE user_id=123 AND created_at>y(0.037ms). NhưngWHERE created_at>ymột mình — bỏ qua cột đầuuser_id— thì index vô dụng, Seq Scan 54ms. Vì index sắp theouser_idtrước, muốn tìm theocreated_atmà không biếtuser_idthì phải quét hết. Đây là lý do thứ tự cột không phải chuyện tuỳ tiện. - Đổi thứ tự cột, cùng query nhanh 14 lần. Với query
WHERE created_at>y, index(user_id, created_at)bó tay (54ms) nhưng index(created_at, user_id)— đưacreated_atlên đầu — cho Bitmap Index Scan 3.898ms. Cùng một query, cùng dữ liệu, chỉ khác thứ tự cột trong index. Bài học: đặt cột nào đứng đầu phụ thuộc query bạn thực sự chạy. - Covering index: trả lời không cần đọc bảng. Bình thường Index Scan tìm được vị trí dòng rồi vẫn phải đọc bảng (heap) để lấy các cột khác. Nhưng nếu index chứa đủ mọi cột query cần (dùng
INCLUDE (payload)), PostgreSQL làm Index Only Scan — trả lời hoàn toàn từ index, Heap Fetches: 0 (không chạm bảng lần nào), chỉ 0.029ms. Đây là mức tối ưu cao nhất cho query đọc.
Đánh đổi cần cân nhắc
Thứ tự cột theo pattern query: cột lọc bằng (=) đứng trước, cột range (>, <) đứng sau. Quy tắc thực dụng: đặt các cột dùng với = lên đầu, cột dùng với range (>, <, BETWEEN) ở cuối. Vì sau một điều kiện range, index không còn "sắp thứ tự" hữu ích cho các cột tiếp theo. Với query "user X trong khoảng thời gian", (user_id, created_at) là đúng: user_id = lọc chính xác trước, rồi created_at range quét một dải liên tục. Đảo lại thành (created_at, user_id) thì kém cho query đó. Chọn thứ tự dựa trên query thật, không phải cảm tính.
Một index tổ hợp thay được nhiều index đơn — nhưng chỉ cho prefix. Index (a, b, c) phục vụ được WHERE a, WHERE a AND b, WHERE a AND b AND c — tức là bạn không cần tạo riêng index (a) và (a,b). Nhưng nó không thay được index (b) hay (c) đứng một mình. Đây là cách gộp index thông minh: một index tổ hợp đặt đúng thứ tự thường phủ nhiều query hơn vài index đơn rời rạc, mà tốn ít chi phí ghi hơn.
Covering index tốn dung lượng và Index Only Scan cần VACUUM. Hai cái giá của covering index: thứ nhất, INCLUDE (payload) làm index to hơn (nó chứa thêm bản sao của payload), tốn đĩa và làm ghi chậm hơn — chỉ dùng khi query đó quan trọng và chạy thường xuyên. Thứ hai, Index Only Scan chỉ thực sự "only" (Heap Fetches=0) khi visibility map cho biết các trang đều "toàn dòng còn sống" — mà visibility map được cập nhật bởi VACUUM. Nếu bảng vừa có nhiều thay đổi và chưa VACUUM, Index Only Scan vẫn phải chạm heap để kiểm tra dòng còn sống không, mất phần lớn lợi ích. (Mình đã chạy VACUUM trước khi đo, nên Heap Fetches=0 — chủ đề MVCC/VACUUM ở phần 7.)
Ba ý mang về
- Leftmost prefix: index tổ hợp dùng từ cột trái nhất: đo thật, index
(user_id, created_at)phục vụuser_id(0.037ms) nhưng bó tay vớicreated_atmột mình (Seq Scan 54ms) — như danh bạ sắp theo (họ, tên), tra theo tên mà bỏ họ thì phải lật cả quyển. - Thứ tự cột quyết định, chọn theo query thật: cùng query
created_at>ylà 54ms với(user_id, created_at)nhưng 3.898ms với(created_at, user_id)— nhanh 14 lần chỉ nhờ đổi thứ tự; quy tắc: cột lọc=đứng trước, cột range đứng sau. - Covering index cho Index Only Scan không chạm bảng: đo thật,
INCLUDE(payload)cho Heap Fetches=0, 0.029ms — trả lời trọn query từ index; đổi lại index to hơn (tốn đĩa + ghi chậm) và cần VACUUM cập nhật visibility map thì Index Only Scan mới thật sự không chạm heap.
Nguồn
- PostgreSQL — Multicolumn Indexes: https://www.postgresql.org/docs/current/indexes-multicolumn.html
- PostgreSQL — Index-Only Scans and Covering Indexes: https://www.postgresql.org/docs/current/indexes-index-only-scans.html
- Use The Index, Luke — The Where Clause (concatenated indexes): https://use-the-index-luke.com/sql/where-clause/the-equals-operator/concatenated-keys
Phần sau ta bàn về JOIN: ba thuật toán PostgreSQL dùng để nối bảng — nested loop, hash join, merge join — và vì sao planner chọn cái này thay cái kia tuỳ kích thước bảng, đo thật thời gian mỗi kiểu.
