Phần trước ta thấy index biến một query từ 10.764ms xuống 0.116ms. Nên phản xạ tự nhiên là "chậm thì thêm index". Nhưng có một sự thật gây ức chế mà nhiều người gặp: tạo index rồi mà query vẫn chậm, EXPLAIN vẫn báo Seq Scan. Index nằm đó, tốn dung lượng, làm chậm mọi INSERT — nhưng query không thèm dùng nó. Vì sao?
Câu trả lời nằm ở một khái niệm gọi là sargable (Search ARGument ABLE — "có thể dùng làm đối số tìm kiếm"). Một predicate chỉ dùng được index B-tree khi nó so sánh trực tiếp trên cột — WHERE cot = x, WHERE cot > x. Ngay khi bạn động vào cột — bọc nó trong một hàm, cộng trừ nó, đặt wildcard ở đầu chuỗi — index trở nên vô dụng và PostgreSQL buộc phải quét cả bảng. Bài này (phần 2 loạt SQL sâu) đo thật các trường hợp đó, vì biết viết query sargable là kỹ năng quan trọng hơn nhiều so với việc chỉ biết CREATE INDEX.
Cơ chế: động vào cột là index chết
B-tree lưu các giá trị của cột theo thứ tự đã sắp xếp. Nó tìm nhanh được email = 'x' vì nó biết vị trí của 'x' trong cây. Nhưng nếu bạn hỏi lower(email) = 'x', index không có sẵn giá trị lower(email) — nó chỉ có email gốc. Nên PostgreSQL phải đọc từng dòng, tự tính lower(email), rồi so sánh: đó là Seq Scan.
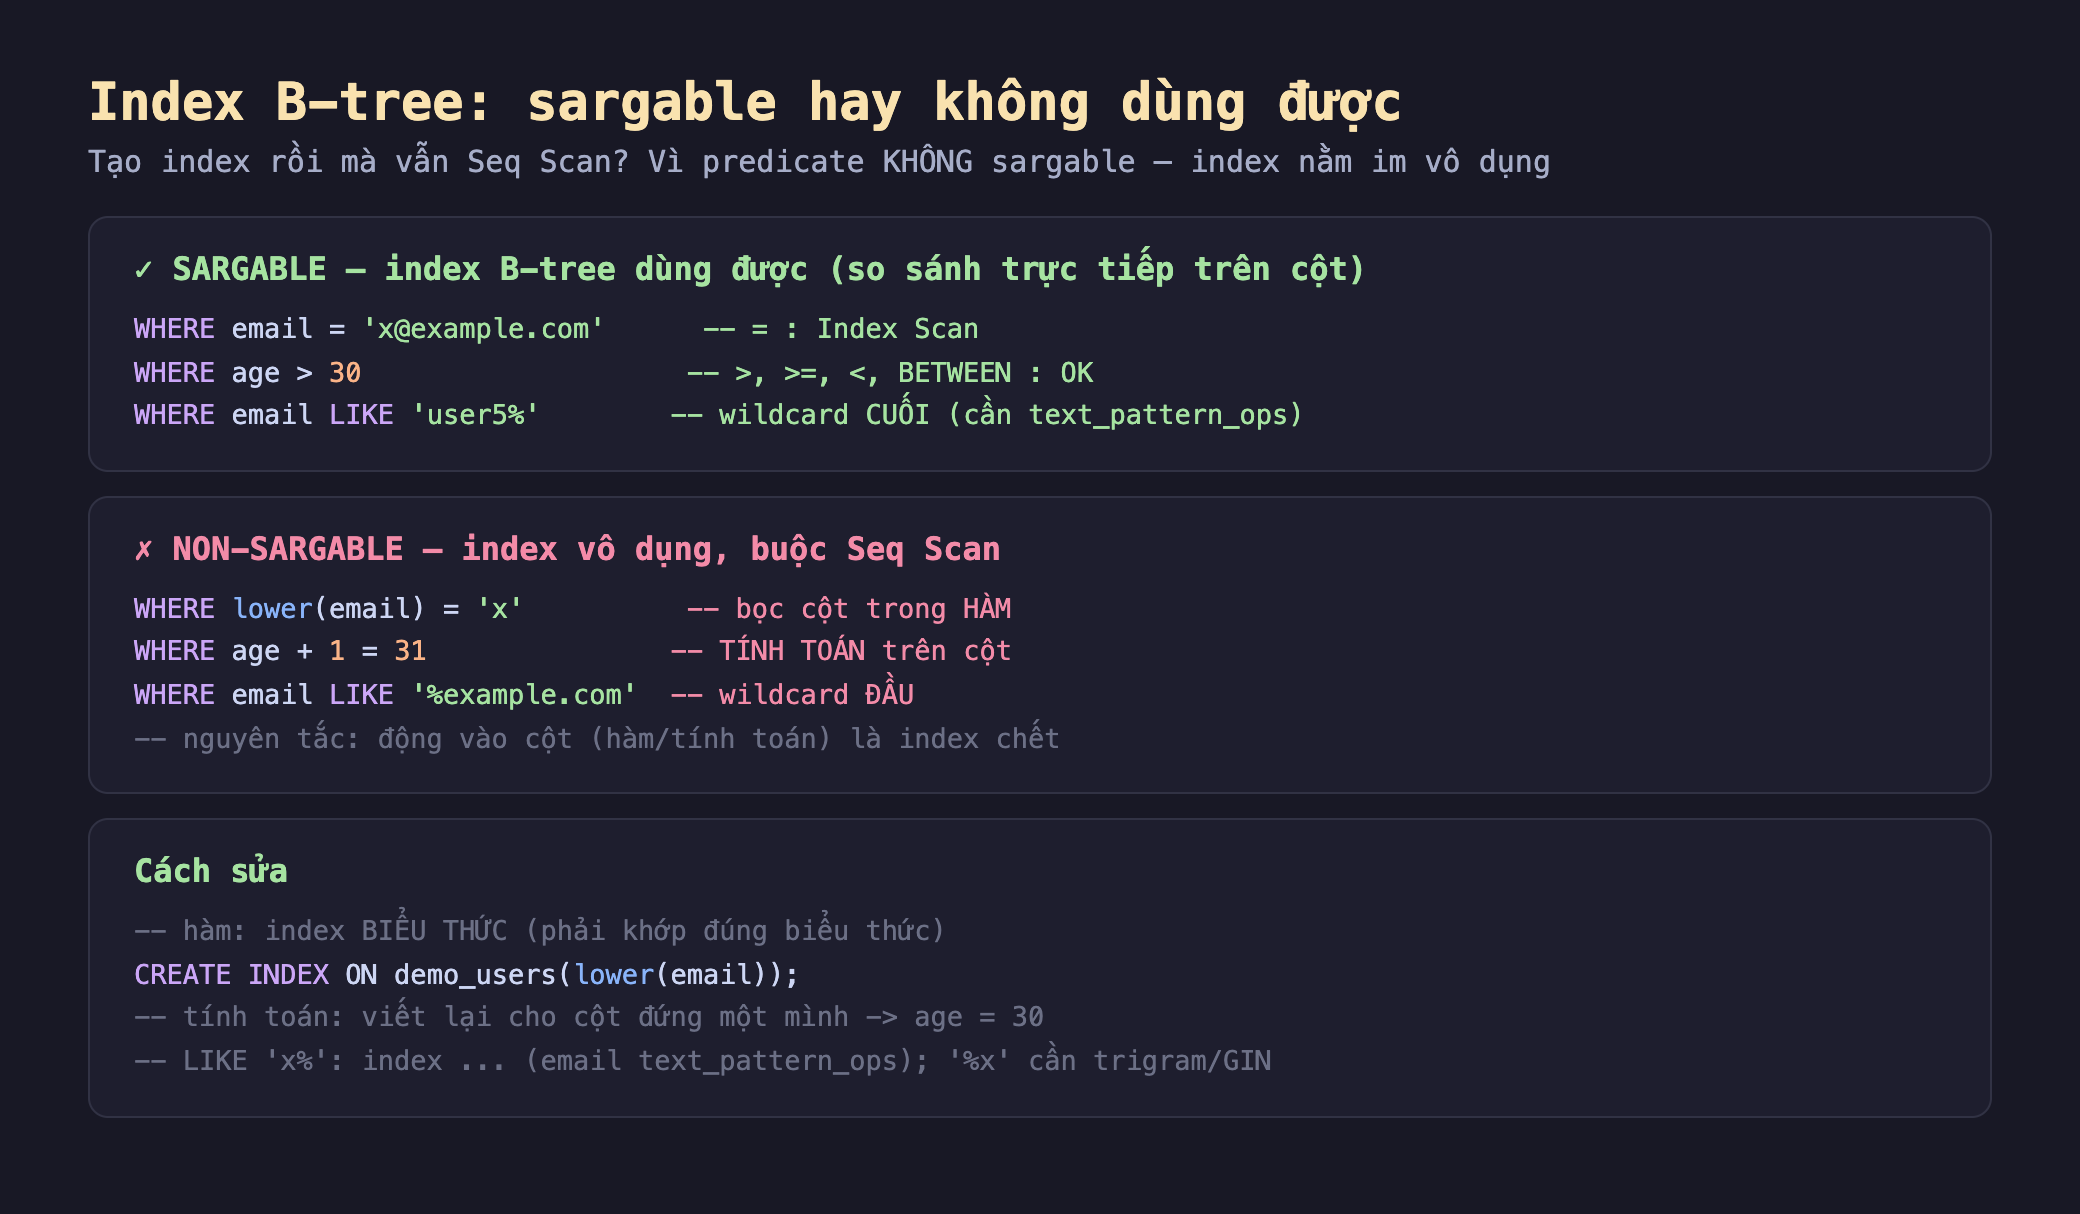
Hình 1: Sargable (dùng được index) — so sánh trực tiếp trên cột: email = x, age > 30, LIKE 'user5%'. Non-sargable (index vô dụng) — động vào cột: lower(email) = x, age + 1 = 31, LIKE '%example.com'. Cách sửa: index biểu thức cho hàm, viết lại cho cột đứng một mình, text_pattern_ops cho LIKE prefix.
Đo thật trong pg-lab
Mình tạo trong pg-lab (PostgreSQL 16) bảng demo_users 1 triệu dòng với index B-tree trên email và age, rồi chạy các query cùng ý định nhưng viết khác nhau.
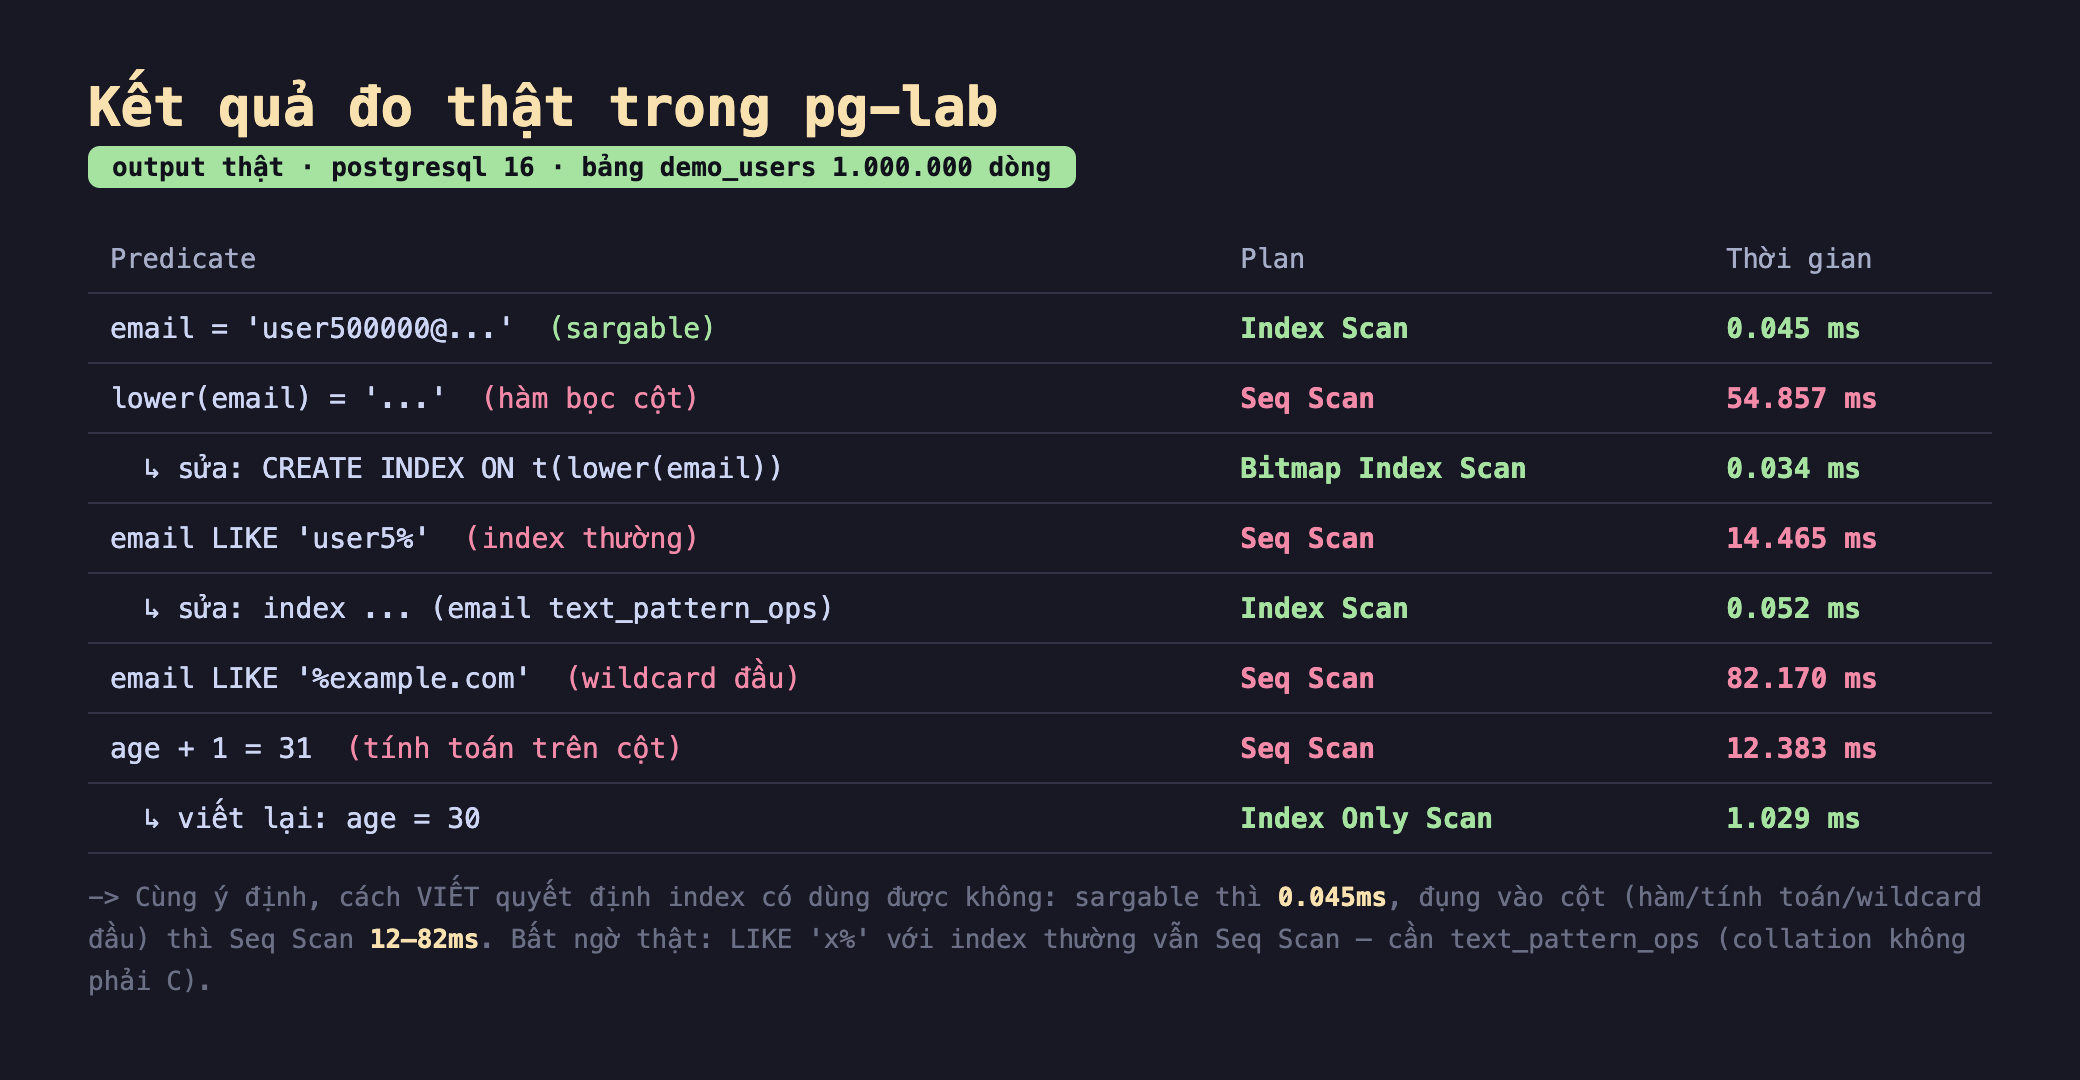
Hình 2: Kết quả thật — email = x (sargable): Index Scan 0.045ms; lower(email) = x: Seq Scan 54.857ms → sửa bằng index biểu thức: 0.034ms; LIKE 'user5%' với index thường: Seq Scan 14.465ms → text_pattern_ops: 0.052ms; LIKE '%example.com': Seq Scan 82.170ms; age+1=31: Seq Scan 12.383ms → viết lại age=30: Index Only Scan 1.029ms.
Đọc bảng kết quả rút ra ba bài học:
- Cùng ý định, cách viết quyết định tất cả.
email = xvàlower(email) = xtìm gần như cùng thứ, nhưng một cái 0.045ms (Index Scan) còn một cái 54.857ms (Seq Scan) — chênh hơn 1000 lần. Tương tựage + 1 = 31(12.383ms) vàage = 30(1.029ms) cho cùng kết quả nhưng cái sau nhanh 12 lần vì để cộtageđứng một mình. Chuyển phép tính sang vế phải (viếtage = 30thay vìage + 1 = 31) là mẹo đơn giản mà hiệu quả. - Bất ngờ thật:
LIKE 'x%'với index thường vẫn Seq Scan. Mình đã nghĩ wildcard cuối thì dùng được index, nhưng đo ra Seq Scan (14.465ms). Lý do: index B-tree mặc định dùng collation của database (không phải collationC), và nó không hỗ trợ so khớp tiền tốLIKE. Phải tạo index vớitext_pattern_ops— một "operator class" riêng cho so khớp mẫu — thìLIKE 'user5%'mới thành Index Scan (0.052ms). Đây là cái bẫy tinh vi rất hay gặp. - Wildcard đầu thì chịu.
LIKE '%example.com'(wildcard ở đầu) là Seq Scan 82.170ms và không index B-tree nào cứu được — vì B-tree sắp theo tiền tố, không biết bắt đầu tìm từ đâu khi phần đầu là ẩn số. Trường hợp này cần index kiểu khác (trigram/GIN, chủ đề riêng).
Đánh đổi cần cân nhắc
Index biểu thức sửa được hàm, nhưng phải khớp đúng biểu thức. Với lower(email) = x, giải pháp là CREATE INDEX ON demo_users(lower(email)) — index lưu sẵn giá trị đã tính, nên query dùng được (0.034ms). Nhưng có điều kiện: biểu thức trong query phải khớp chính xác biểu thức trong index. Index trên lower(email) không giúp cho upper(email) hay lower(trim(email)). Đây là công cụ mạnh nhưng phải đúng cặp.
Mỗi index không miễn phí — nó đánh đổi đọc lấy ghi. Dễ quên khi đang tối ưu SELECT: mỗi index bạn thêm phải được cập nhật ở mỗi INSERT/UPDATE/DELETE, làm các thao tác ghi chậm hơn và tốn thêm dung lượng đĩa. Một bảng ghi nhiều mà có chục index sẽ chậm đáng kể khi ghi. Vì vậy đừng tạo index bừa "cho chắc" — chỉ tạo index cho các query thực sự chạy thường xuyên và thực sự cần, rồi đo bằng EXPLAIN ANALYZE để xác nhận nó được dùng.
Viết query sargable ngay từ đầu rẻ hơn thêm index để chữa. Nhiều trường hợp non-sargable không cần index đặc biệt — chỉ cần viết lại query cho sargable: chuyển phép tính sang vế phải (age = 30), tránh bọc cột trong hàm khi không cần, đưa điều kiện về so sánh trực tiếp. Đây là thói quen nên có: trước khi thêm một index biểu thức phức tạp, hỏi xem có viết lại được predicate cho cột đứng một mình không. Index chỉ nên dùng khi bản thân dữ liệu cần một cách truy cập mới, không phải để vá một câu query viết vụng.
Ba ý mang về
- Sargable quyết định index có dùng được không: đo thật,
email = x(Index Scan, 0.045ms) vslower(email) = x(Seq Scan, 54.857ms) — chênh hơn 1000 lần cho cùng ý định; động vào cột (hàm, tính toán, wildcard đầu) là index chết, buộc quét cả bảng. - Viết lại query thường rẻ hơn thêm index:
age + 1 = 31(12ms) viết lại thànhage = 30(1ms, Index Only Scan) — chuyển phép tính sang vế phải để cột đứng một mình; index biểu thức (ON t(lower(email))) sửa được hàm nhưng phải khớp đúng biểu thức. - Cái bẫy LIKE và cái giá của index:
LIKE 'x%'với index thường vẫn Seq Scan (14ms) — cầntext_pattern_ops(0.052ms) vì collation không phải C;LIKE '%x'(wildcard đầu) thì B-tree bó tay (cần trigram/GIN); và mỗi index làm INSERT/UPDATE chậm hơn + tốn đĩa, nên chỉ tạo cho query thực sự cần.
Nguồn
- PostgreSQL — Indexes and ORDER BY / operator classes: https://www.postgresql.org/docs/current/indexes-ordering.html
- PostgreSQL — Indexes on Expressions: https://www.postgresql.org/docs/current/indexes-expressional.html
- PostgreSQL — Operator Classes (text_pattern_ops): https://www.postgresql.org/docs/current/indexes-opclass.html
Phần sau ta bàn về index tổ hợp nhiều cột: thứ tự cột trong index quan trọng thế nào (quy tắc leftmost prefix), và covering index cho phép "index-only scan" — trả lời query mà không cần chạm vào bảng.
