Query của bạn chạy chậm. Bạn nghi ngờ, đoán mò, thêm vài index bừa, đôi khi may mắn đôi khi không. Nhưng có một công cụ biến việc đoán mò thành chẩn đoán chính xác: EXPLAIN ANALYZE. Nó là ống nghe của bác sĩ database — cho biết PostgreSQL thực sự làm gì để trả lời query: quét cả bảng hay dùng index, join kiểu nào, mỗi bước tốn bao lâu, đọc bao nhiêu dữ liệu. Không đọc được plan thì mọi nỗ lực tối ưu SQL đều là đoán mò.
Vấn đề là output của EXPLAIN ANALYZE dày đặc con số, và nhiều người nhìn vào thấy rối rồi bỏ qua — hoặc tệ hơn, đọc nhầm các con số (nhầm cost là mili-giây là lỗi kinh điển). Bài này (phần 1 loạt SQL sâu) mở đầu bằng việc học đọc plan cho đúng, qua một demo thật trên bảng 1 triệu dòng: thấy tận mắt khác biệt giữa quét cả bảng và dùng index, và hiểu từng con số nghĩa là gì.
Cơ chế: EXPLAIN, ANALYZE, và cách đọc
Có hai mức. EXPLAIN (một mình) chỉ cho planner ước lượng — nó không chạy query, chỉ dự đoán sẽ làm gì và tốn bao nhiêu. EXPLAIN ANALYZE thì chạy thật query và đo thời gian thực tế. Thêm BUFFERS cho biết đọc bao nhiêu block dữ liệu (từ cache hay từ đĩa).
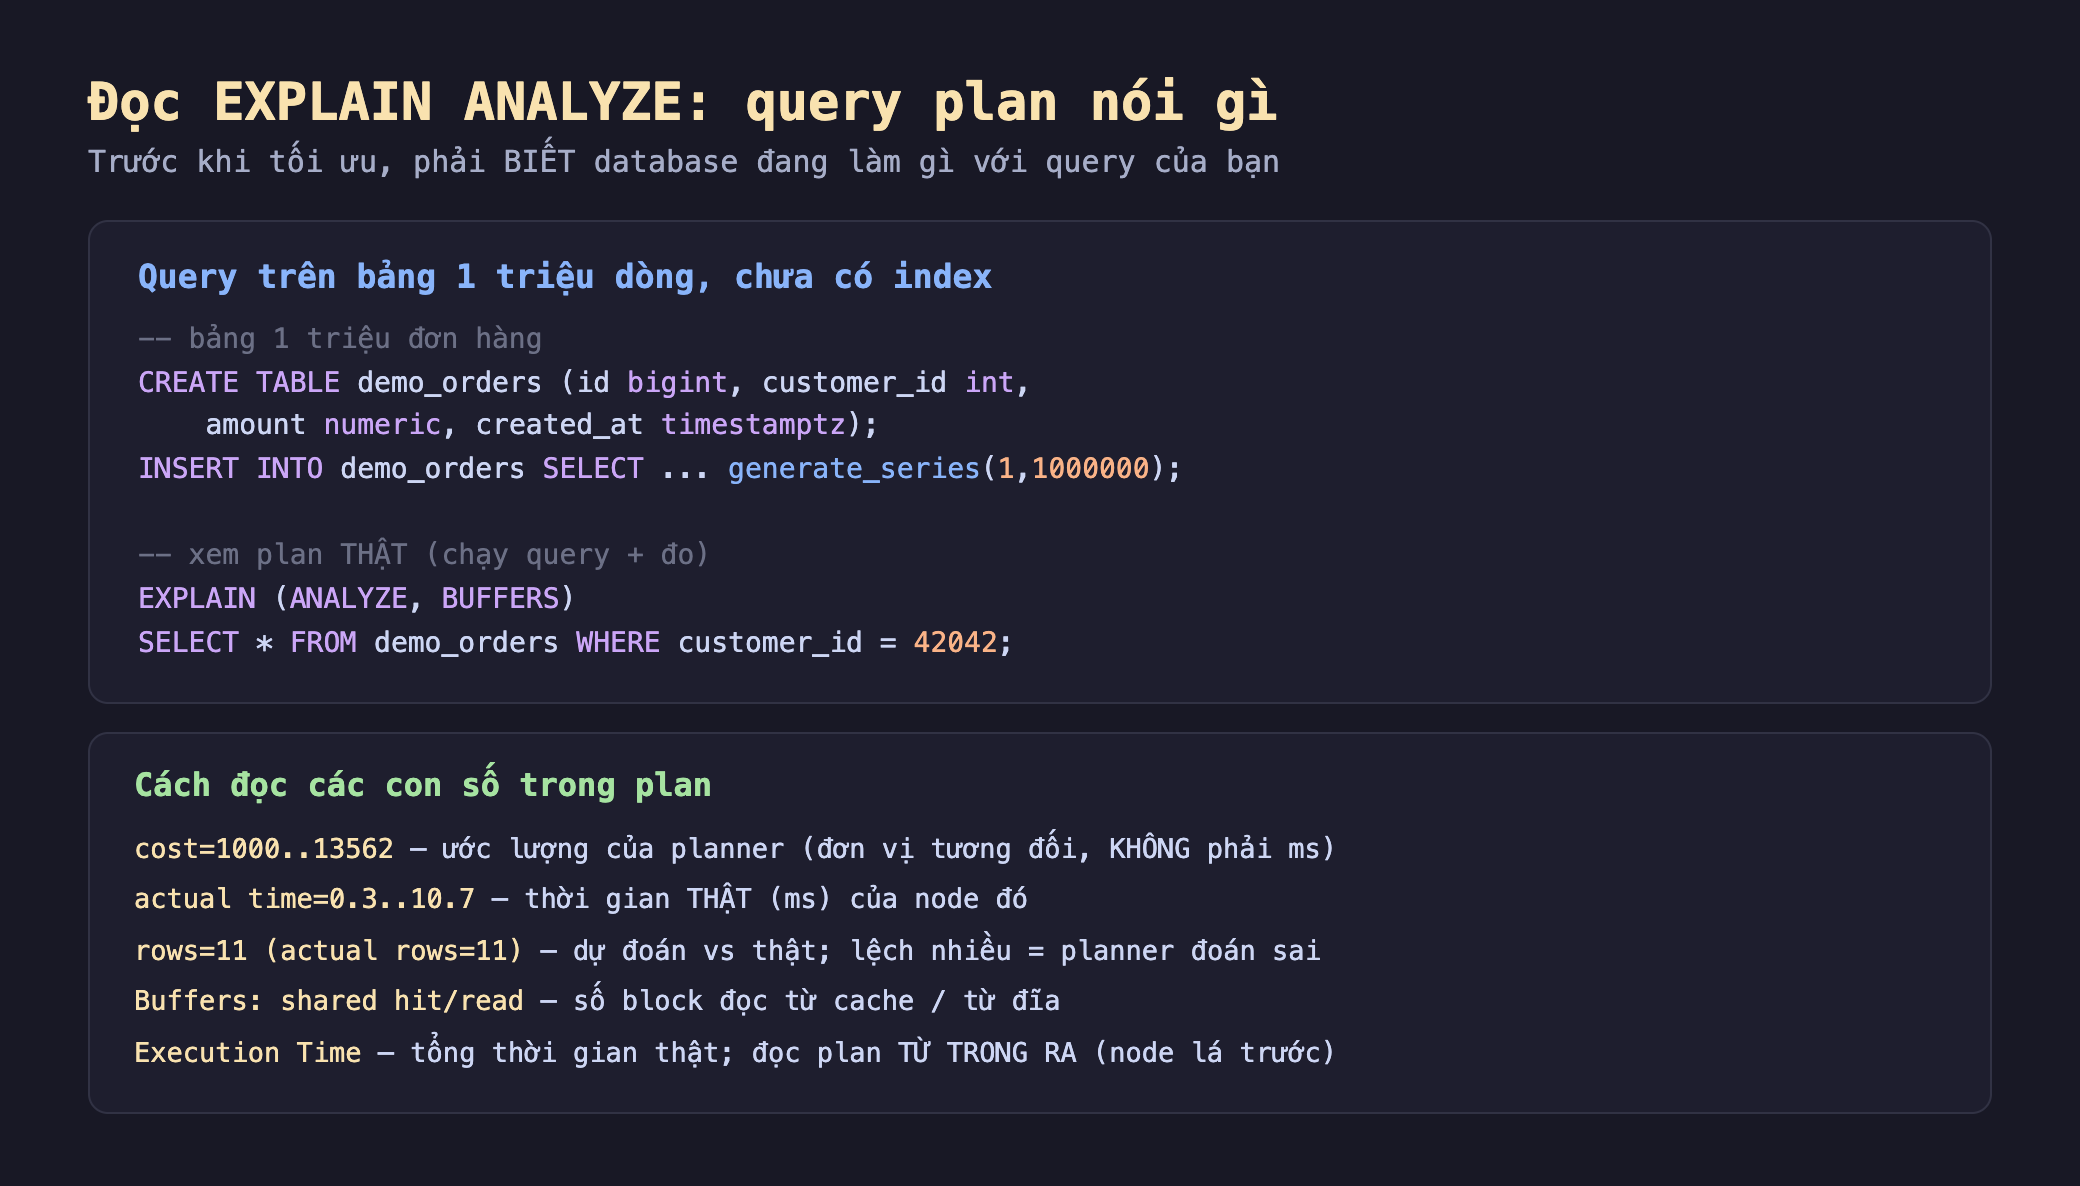
Hình 1: Tạo bảng 1 triệu dòng rồi chạy EXPLAIN (ANALYZE, BUFFERS). Cách đọc: cost là ước lượng tương đối của planner (không phải ms), actual time mới là thời gian thật, rows dự đoán vs actual rows lệch nhau lộ khi planner đoán sai, Buffers là số block đọc; và luôn đọc plan từ trong ra ngoài (node lá chạy trước).
Đo thật trong pg-lab
Mình tạo trong pg-lab (PostgreSQL 16) bảng demo_orders 1 triệu dòng, rồi chạy cùng một query WHERE customer_id = 42042 — trước và sau khi thêm index.
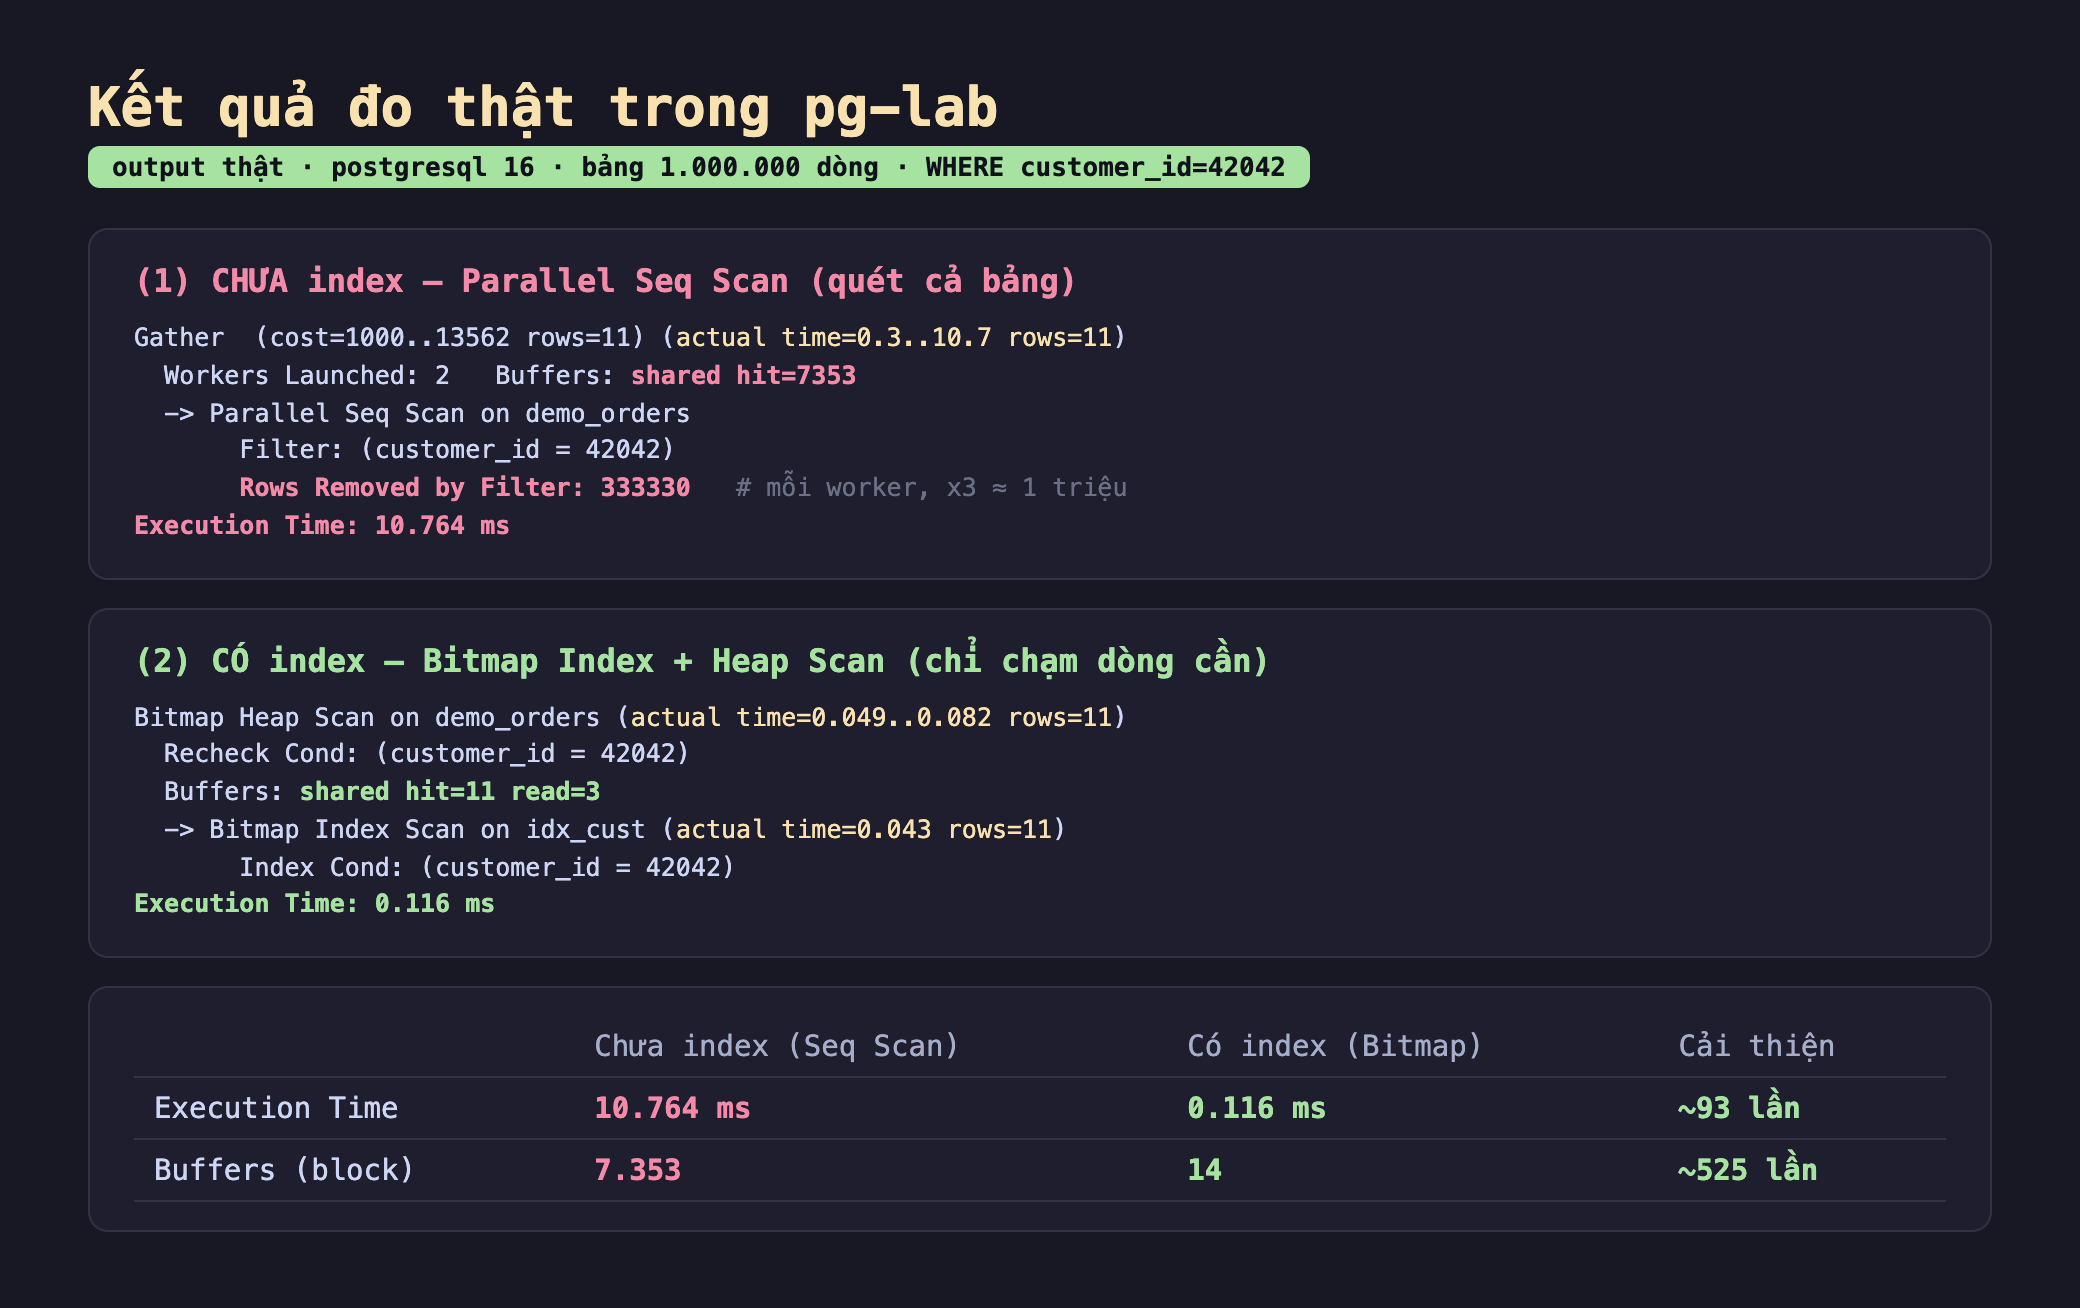
Hình 2: Kết quả thật — chưa index: Parallel Seq Scan quét cả bảng, 7353 block, Rows Removed by Filter: 333330 mỗi worker (≈1 triệu dòng bị loại), Execution Time 10.764ms; có index: Bitmap Index Scan chỉ chạm 14 block, Execution Time 0.116ms — nhanh ~93 lần, đọc ít hơn ~525 lần.
Đọc plan này ra được nhiều điều:
- Chưa index = quét cả bảng.
Seq Scan(Sequential Scan) nghĩa là PostgreSQL đọc tuần tự toàn bộ 1 triệu dòng rồi lọc —Rows Removed by Filter: 333330× 3 worker ≈ 1 triệu dòng bị vứt bỏ chỉ để tìm 11 dòng khớp. Nó đọc 7353 block, mất 10.764ms. (PostgreSQL còn chạy song song 2 worker để đỡ chậm, nhưng vẫn là quét cả bảng.) - Có index = chỉ chạm dòng cần. Sau
CREATE INDEX, plan đổi thànhBitmap Index Scan→Bitmap Heap Scan: index cho biết chính xác dòng nào khớp, chỉ đọc 14 block (11 hit + 3 read) thay vì 7353. Execution Time xuống 0.116ms — nhanh 93 lần, đọc dữ liệu ít hơn 525 lần. Đây là lý do index quan trọng, và plan cho ta thấy nó tận mắt. - rows dự đoán khớp actual. Ở cả hai plan,
rows=11(dự đoán) khớpactual rows=11(thật) — vì mình đã chạyANALYZEđể cập nhật thống kê. Khi hai số này lệch xa nhau, đó là dấu hiệu planner đoán sai và có thể chọn plan tệ (chủ đề phần 11).
Một chi tiết đáng nói thật: plan có index là Bitmap Index Scan chứ không phải Index Scan thuần. PostgreSQL chọn bitmap khi cần lấy nhiều dòng rải rác — nó gom vị trí từ index vào một bitmap rồi đọc heap theo thứ tự block, hiệu quả hơn cho trường hợp này. Chi tiết các loại scan sẽ bàn kỹ ở phần index.
Đánh đổi cần cân nhắc
cost KHÔNG phải mili-giây — đừng nhầm. Đây là lỗi đọc plan phổ biến nhất. cost=1000.00..13562.43 là đơn vị chi phí tương đối mà planner dùng để so sánh các plan với nhau (dựa trên số trang đọc, số dòng xử lý, với các hằng số như seq_page_cost). Nó không phải thời gian. Số đứng trước (1000.00) là "startup cost" (chi phí tới khi trả dòng đầu), số sau (13562.43) là "total cost". Muốn biết thời gian thật, nhìn actual time và Execution Time (đơn vị ms). Planner dùng cost để chọn plan; bạn dùng actual time để đánh giá plan.
EXPLAIN ANALYZE chạy thật — cẩn thận với lệnh ghi. Vì ANALYZE thực thi query, chạy EXPLAIN ANALYZE trên một UPDATE/DELETE/INSERT sẽ thật sự thay đổi dữ liệu. Muốn xem plan của lệnh ghi mà không đổi dữ liệu, bọc trong transaction rồi rollback: BEGIN; EXPLAIN ANALYZE UPDATE ...; ROLLBACK;. Với SELECT thì vô hại. Đây là bẫy dễ vấp khi điều tra trên production.
Đọc plan từ trong ra ngoài, và đo trên dữ liệu giống thật. Plan là một cây: node thụt lề sâu nhất (node lá) chạy trước, kết quả chảy ngược lên node cha. Đọc từ trong ra để hiểu luồng thực thi. Và quan trọng: plan phụ thuộc kích thước và phân phối dữ liệu thật. Một query trên bảng 100 dòng lúc dev có thể dùng Seq Scan (nhanh vì bảng nhỏ), nhưng cùng query trên bảng 1 triệu dòng ở production lại cần index. Luôn đo EXPLAIN ANALYZE trên dữ liệu có quy mô giống production, không phải bảng rỗng lúc dev — nếu không, plan bạn thấy không phải plan sẽ chạy thật.
Ba ý mang về
- EXPLAIN ANALYZE cho biết database thực sự làm gì: đo thật, cùng query trên 1 triệu dòng — chưa index chạy Seq Scan quét cả bảng (7353 block, 10.764ms, loại bỏ ~1 triệu dòng), có index chạy Bitmap Index Scan chỉ chạm 14 block (0.116ms) — nhanh 93 lần; plan cho thấy tận mắt vì sao.
- Đọc đúng các con số:
costlà đơn vị tương đối của planner không phải ms (dùng để chọn plan),actual time/Execution Timemới là thời gian thật;rowsdự đoán vs actual lệch nhau lộ planner đoán sai;Bufferscho biết đọc bao nhiêu block; đọc cây plan từ trong ra ngoài. - Dùng đúng cách, đo đúng bối cảnh:
EXPLAINchỉ ước lượng,EXPLAIN ANALYZEchạy thật (bọc lệnh ghi trong transaction rollback để không đổi dữ liệu); và luôn đo trên dữ liệu quy mô giống production vì plan phụ thuộc kích thước/phân phối dữ liệu thật.
Nguồn
- PostgreSQL — Using EXPLAIN: https://www.postgresql.org/docs/current/using-explain.html
- PostgreSQL — EXPLAIN command reference: https://www.postgresql.org/docs/current/sql-explain.html
- Depesz — explain.depesz.com (công cụ đọc plan trực quan): https://explain.depesz.com/
Phần sau ta đào sâu vào index B-tree: chính xác khi nào PostgreSQL dùng được index và khi nào không (bọc cột trong hàm, LIKE '%x', ép kiểu) — những cái bẫy khiến index bạn tạo nằm im vô dụng.
