Có một triết lý vận hành mà các hệ thống lớn học được qua đau thương: một tính năng hỏng không nên làm hỏng cả sản phẩm. Trang chủ Amazon gọi tới hàng trăm service — gợi ý sản phẩm, đánh giá, tồn kho, quảng cáo. Nếu service gợi ý chết, câu hỏi không phải "làm sao cứu nó ngay" mà là "trang chủ có nên chết theo không?". Câu trả lời hiển nhiên là không: thà hiện gợi ý cũ (hoặc bỏ hẳn khối gợi ý) còn hơn để cả trang trắng. Đó là graceful degradation — suy giảm có kiểm soát: khi một phụ thuộc chết hẳn, trả về một phản hồi kém hơn nhưng vẫn dùng được thay vì một lỗi 500 cụt lủn.
Đây là mẫu chốt lại toàn bộ tinh thần của loạt bài này. Các phần trước (retry, circuit breaker, timeout, bulkhead) đều nhằm ngăn lỗi lan hoặc giảm xác suất lỗi. Nhưng có lúc phụ thuộc thực sự chết và không cách nào lấy được dữ liệu tươi. Lúc đó, câu hỏi cuối cùng là: ta trả gì cho người dùng? Bài này (phần 11 loạt Hệ thống chịu tải) đo thật sự khác biệt giữa "chết cứng" và "suy giảm mềm".
Cơ chế: một lớp fallback có thứ bậc
Ý tưởng là bọc lời gọi tới phụ thuộc bằng một chuỗi phương án dự phòng, xếp từ tốt nhất tới tệ nhất-nhưng-vẫn-chấp-nhận-được:
- Fresh — lấy được dữ liệu tươi từ downstream (đường hạnh phúc).
- Stale — downstream lỗi, nhưng ta còn bản sao cũ trong cache (từ lần lấy được gần nhất). Trả nó, kèm nhãn "dữ liệu cũ", miễn là chưa quá tuổi tối đa.
- Default — không có cả cache cũ, trả một giá trị mặc định tối thiểu (danh sách rỗng, cấu hình an toàn) để trang vẫn dựng được.
Điểm mấu chốt là fallback phải rẻ và độc lập với cái đang chết — đọc cache trong RAM, không phải gọi một service khác cũng có thể sập theo. Và mỗi phản hồi suy giảm phải tự khai trạng thái của nó (fresh/stale/default), để cả người dùng lẫn hệ thống giám sát đều biết đang ở chế độ nào.
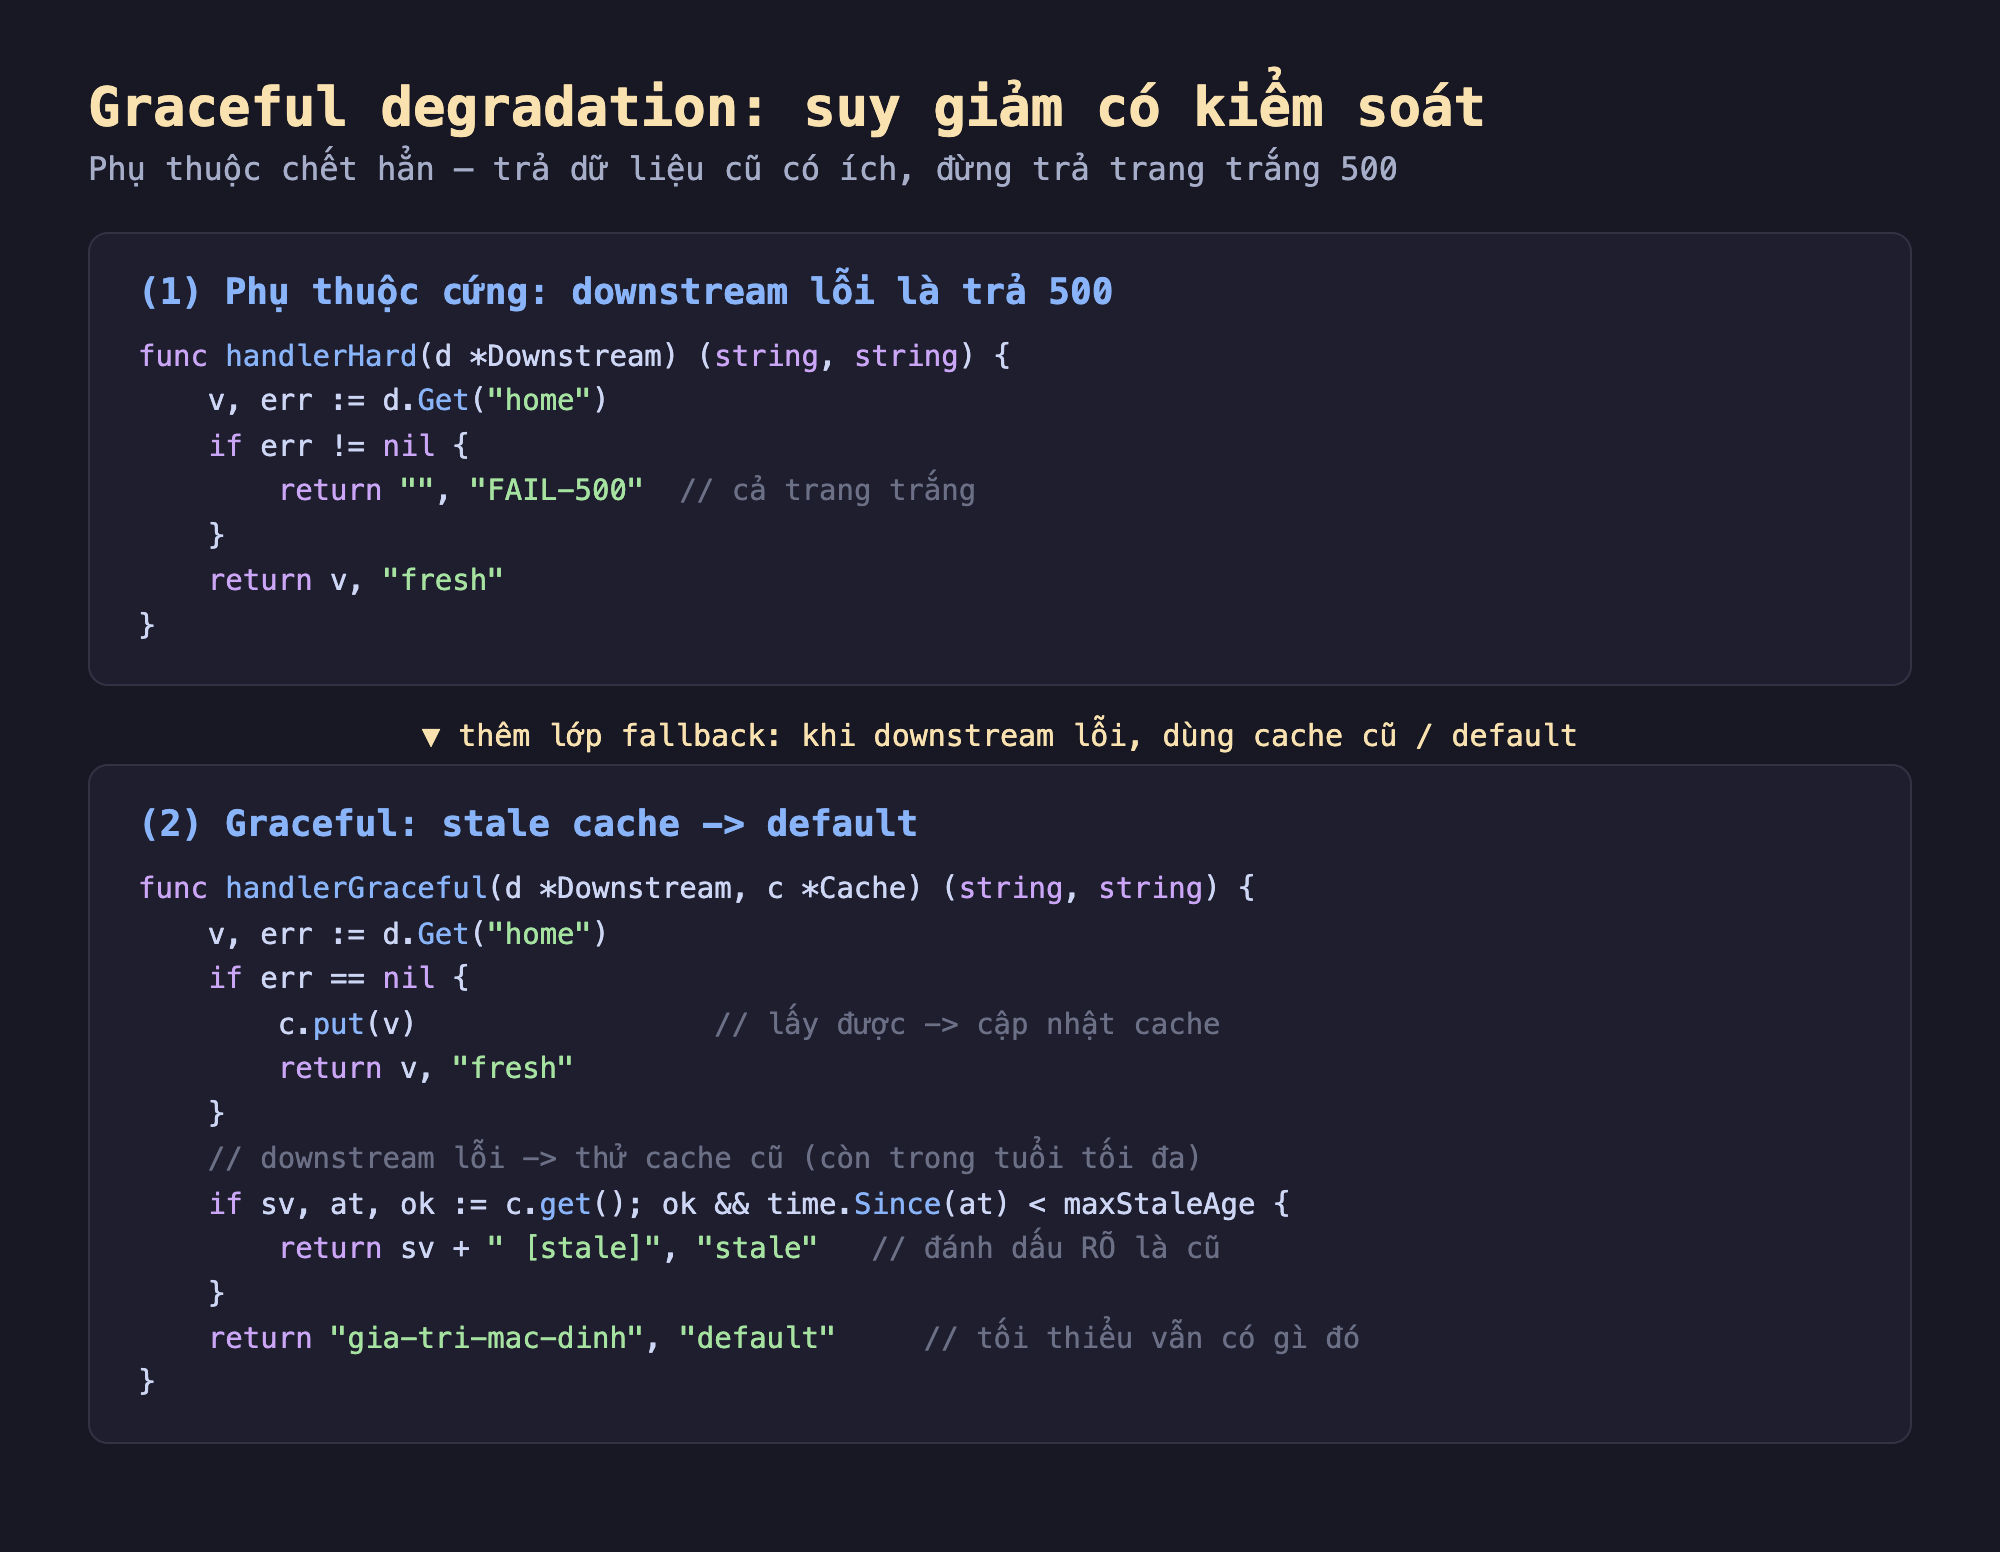
Hình 1: handlerHard phụ thuộc cứng — downstream lỗi là trả FAIL-500. handlerGraceful bọc lời gọi bằng chuỗi fallback: lấy được thì trả fresh và cập nhật cache; downstream lỗi thì trả stale từ cache cũ (nếu còn trong tuổi tối đa) với nhãn rõ ràng, hết cách thì trả default.
Bản cài tối giản của handler có fallback:
const maxStaleAge = 5 * time.Second // quá tuổi này thì không dùng cache cũ nữa

func handlerGraceful(d *Downstream, c *Cache) (string, string) {
	v, err := d.Get("home")
	if err == nil {
		c.put(v) // lấy được -> cập nhật cache
		return v, "fresh"
	}
	// downstream lỗi -> thử stale cache
	if sv, at, ok := c.get(); ok && time.Since(at) < maxStaleAge {
		return sv + " [stale]", "stale" // đánh dấu RÕ là cũ
	}
	return "gia-tri-mac-dinh", "default" // tối thiểu vẫn có gì đó
}
Đo thật trong go-lab
Mình mô phỏng trong go-lab (golang 1.23) một downstream khỏe trong 50 request đầu rồi chết hẳn (mọi lời gọi sau đều trả lỗi), và cho 200 request đi qua handler theo hai kiểu — phụ thuộc cứng và có fallback — rồi đếm mỗi request kết thúc ở trạng thái nào.
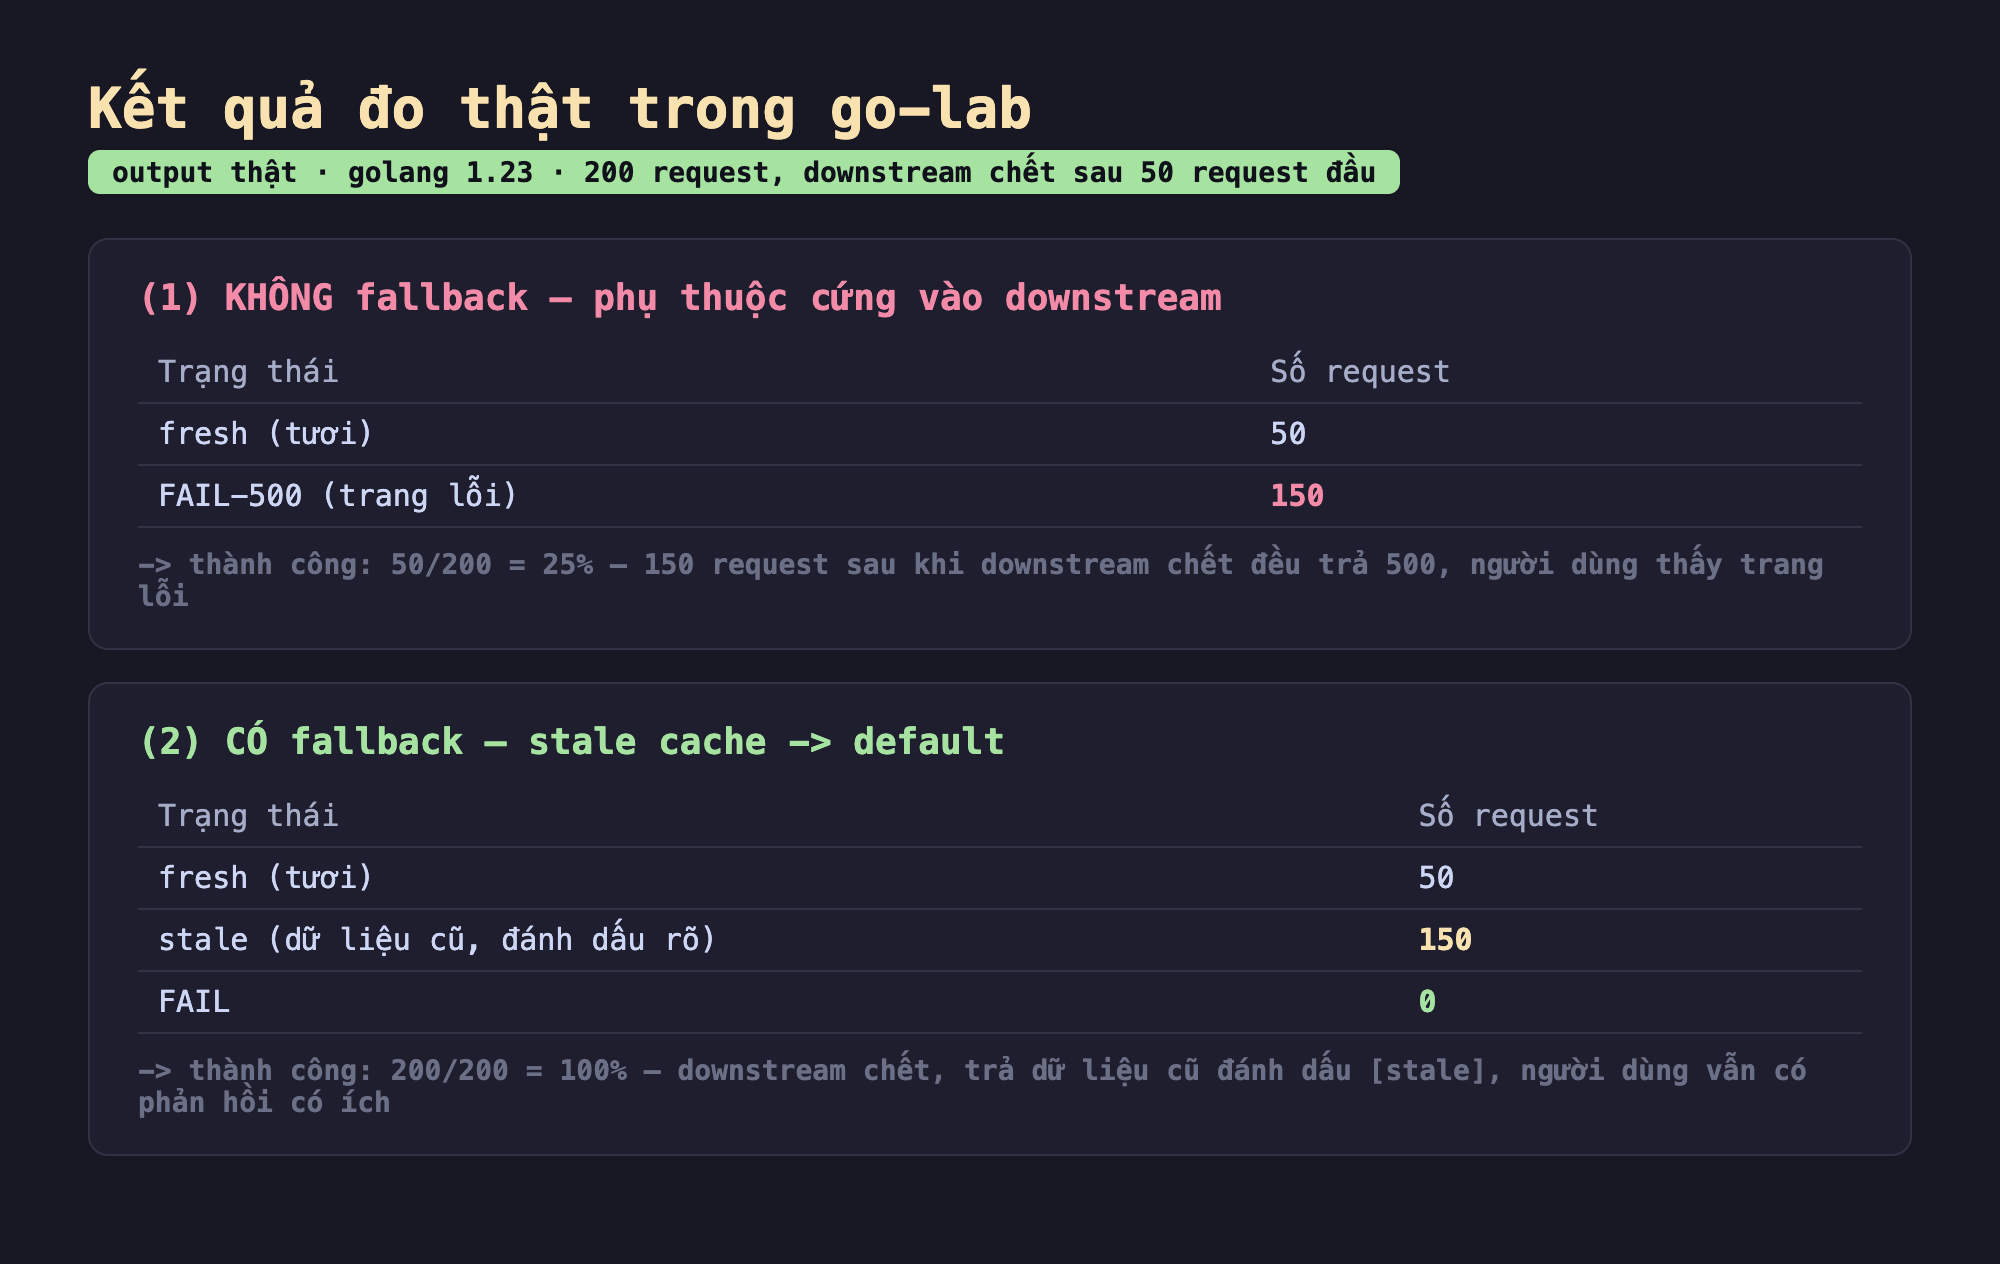
Hình 2: Kết quả thật — không fallback: chỉ 50/200 (25%) thành công, 150 request trả 500 sau khi downstream chết; có fallback: 200/200 (100%) thành công, 150 request được phục vụ bằng dữ liệu cũ đánh dấu [stale], 0 lỗi.
Con số nói rõ khác biệt:
- Phụ thuộc cứng: 25% thành công. 50 request đầu (lúc downstream còn sống) trả
fresh. Nhưng ngay khi downstream chết ở request 51, 150 request còn lại đều trảFAIL-500— người dùng thấy trang lỗi. Sức khỏe của handler bằng đúng sức khỏe của phụ thuộc yếu nhất nó gọi. - Có fallback: 100% thành công. Cũng 50 request đầu trả
freshvà cập nhật cache trong lúc còn lấy được. Khi downstream chết, 150 request sau rơi vào nhánh fallback: cache vẫn còn bản cũ (trong tuổi 5 giây), nên chúng trảstale— dữ liệu cũ, đánh dấu rõ ràng, nhưng vẫn là một phản hồi có ích. Không một request nào thất bại.
Điều quan trọng cần đọc đúng: fallback không làm downstream sống lại, và dữ liệu stale đúng là cũ — nó có thể lỗi thời. Nhưng với rất nhiều trang (bảng giá cập nhật vài phút một lần, danh sách bài viết, cấu hình), một giá trị cũ vài giây/phút vẫn tốt hơn vô hạn lần so với một trang trắng. Đó là bản chất của "suy giảm": chấp nhận chất lượng thấp hơn để giữ tính khả dụng.
Đánh đổi cần cân nhắc
Dữ liệu cũ có thể sai — phải có tuổi tối đa và đánh dấu rõ. stale không miễn phí: nếu giá sản phẩm vừa đổi mà bạn phục vụ giá cũ, khách có thể thấy sai. Vì vậy hai kỷ luật bắt buộc: (1) tuổi tối đa (maxStaleAge) — quá hạn thì thà trả default hoặc lỗi còn hơn phục vụ dữ liệu quá cũ nguy hiểm; (2) đánh dấu rõ cho client (header X-Data-Freshness: stale, hoặc nhãn UI "cập nhật lần cuối lúc...") để phía sau biết đây không phải số liệu thời gian thực. Có những dữ liệu không bao giờ được phép cũ (số dư tài khoản, tồn kho lúc thanh toán) — với chúng, fallback đúng là báo lỗi thành thật, không phải đoán.
Degrade phải nhìn thấy được, kẻo nó che mất sự cố. Đây là cạm bẫy nguy hiểm nhất của graceful degradation: nó quá tốt trong việc giấu lỗi. Nếu downstream chết mà mọi request vẫn trả 200 (nhờ stale), thì dashboard "tỉ lệ lỗi" vẫn xanh — và không ai biết downstream đã chết hàng giờ, cho tới khi cache hết hạn và mọi thứ sập cùng lúc. Bắt buộc phải đo riêng tỉ lệ fresh/stale/default và cảnh báo khi tỉ lệ stale tăng vọt. Trong demo, chính con số stale=150 là tín hiệu sự cố — đừng để nó chìm trong "200 OK".
Phân biệt fail-open và fail-closed — bảo mật không được fail-open. Graceful degradation ở đây là fail-open: khi nghi ngờ, vẫn phục vụ (mở cửa). Điều này đúng cho nội dung hiển thị, nhưng sai chết người cho các quyết định bảo mật. Nếu service kiểm tra quyền chết, fallback tuyệt đối không được "cứ cho qua" — nó phải fail-closed (từ chối). Quy tắc: fail-open cho thứ làm giàu trải nghiệm (gợi ý, đánh giá, quảng cáo), fail-closed cho thứ bảo vệ (xác thực, phân quyền, giới hạn chi tiêu). Chọn nhầm hướng biến một cơ chế chịu lỗi thành một lỗ hổng.
Và như đã thấy xuyên suốt loạt bài: graceful degradation ghép tự nhiên với circuit breaker (phần 2). Circuit breaker cho biết khi nào nên chuyển sang fallback (sau khi thấy downstream hỏng liên tục thì mở mạch, đi thẳng nhánh stale thay vì cứ thử downstream đã chết), giúp fallback nhanh và không lãng phí.
Ba ý mang về
- Phụ thuộc cứng khiến handler chết theo downstream: đo thật, khi downstream chết, handler không fallback chỉ đạt 25% thành công (50/200), 150 request trả 500 — sức khỏe của bạn bằng đúng phụ thuộc yếu nhất bạn gọi.
- Fallback có thứ bậc giữ tính khả dụng: đo thật, thêm stale cache → default, tỉ lệ thành công lên 100% (150 request phục vụ bằng dữ liệu cũ đánh dấu
[stale], 0 lỗi) — một phản hồi cũ có ích thắng xa một trang trắng, miễn là fallback rẻ và độc lập với cái đang chết. - Suy giảm phải có kiểm soát và nhìn thấy được: dữ liệu cũ cần tuổi tối đa và đánh dấu rõ; tỉ lệ stale/default phải được đo và cảnh báo kẻo degrade che mất sự cố; và fail-open cho nội dung nhưng fail-closed cho bảo mật — cùng circuit breaker quyết định khi nào chuyển sang fallback.
Nguồn
- Google SRE Book — Graceful degradation & handling overload: https://sre.google/sre-book/handling-overload/
- Microsoft — Fallback / Graceful degradation guidance: https://learn.microsoft.com/en-us/azure/well-architected/reliability/self-preservation
- Martin Fowler — CircuitBreaker (fallback khi mở mạch): https://martinfowler.com/bliki/CircuitBreaker.html
Phần sau là bài tổng kết cả loạt: một cây quyết định giúp bạn chọn đúng mẫu chịu tải cho từng tình huống — khi nào retry, khi nào circuit breaker, khi nào bulkhead, khi nào degrade — và cách ghép chúng thành một hệ thống thực sự bền.
