Mười một phần trước của loạt "Hệ thống chịu tải" mỗi phần giải một vấn đề riêng: rate limiting chặn tải thừa, circuit breaker ngắt phụ thuộc hỏng, retry vượt lỗi tạm, timeout giải phóng tài nguyên, backpressure và load shedding giữ hệ thống khi quá tải, worker pool kiểm soát song song, singleflight và cache gộp tải trùng, idempotency làm retry an toàn, bulkhead cô lập lỗi, graceful degradation suy giảm mềm. Từng mẫu đều đã đo thật. Nhưng người kỹ sư đứng trước một hệ thống thật không hỏi "mẫu circuit breaker hoạt động thế nào" — họ hỏi "hệ thống của tôi đang gặp vấn đề này, dùng mẫu nào, và ghép chúng ra sao". Bài cuối này (phần 12) trả lời đúng câu đó: một cây quyết định, một thứ tự ghép, và một demo thật chứng minh cả bộ hợp lực.
Cây quyết định: gặp vấn đề gì, dùng mẫu nào
Đừng học 11 mẫu như 11 mục rời rạc. Hãy gom chúng theo câu hỏi bạn đang gặp:
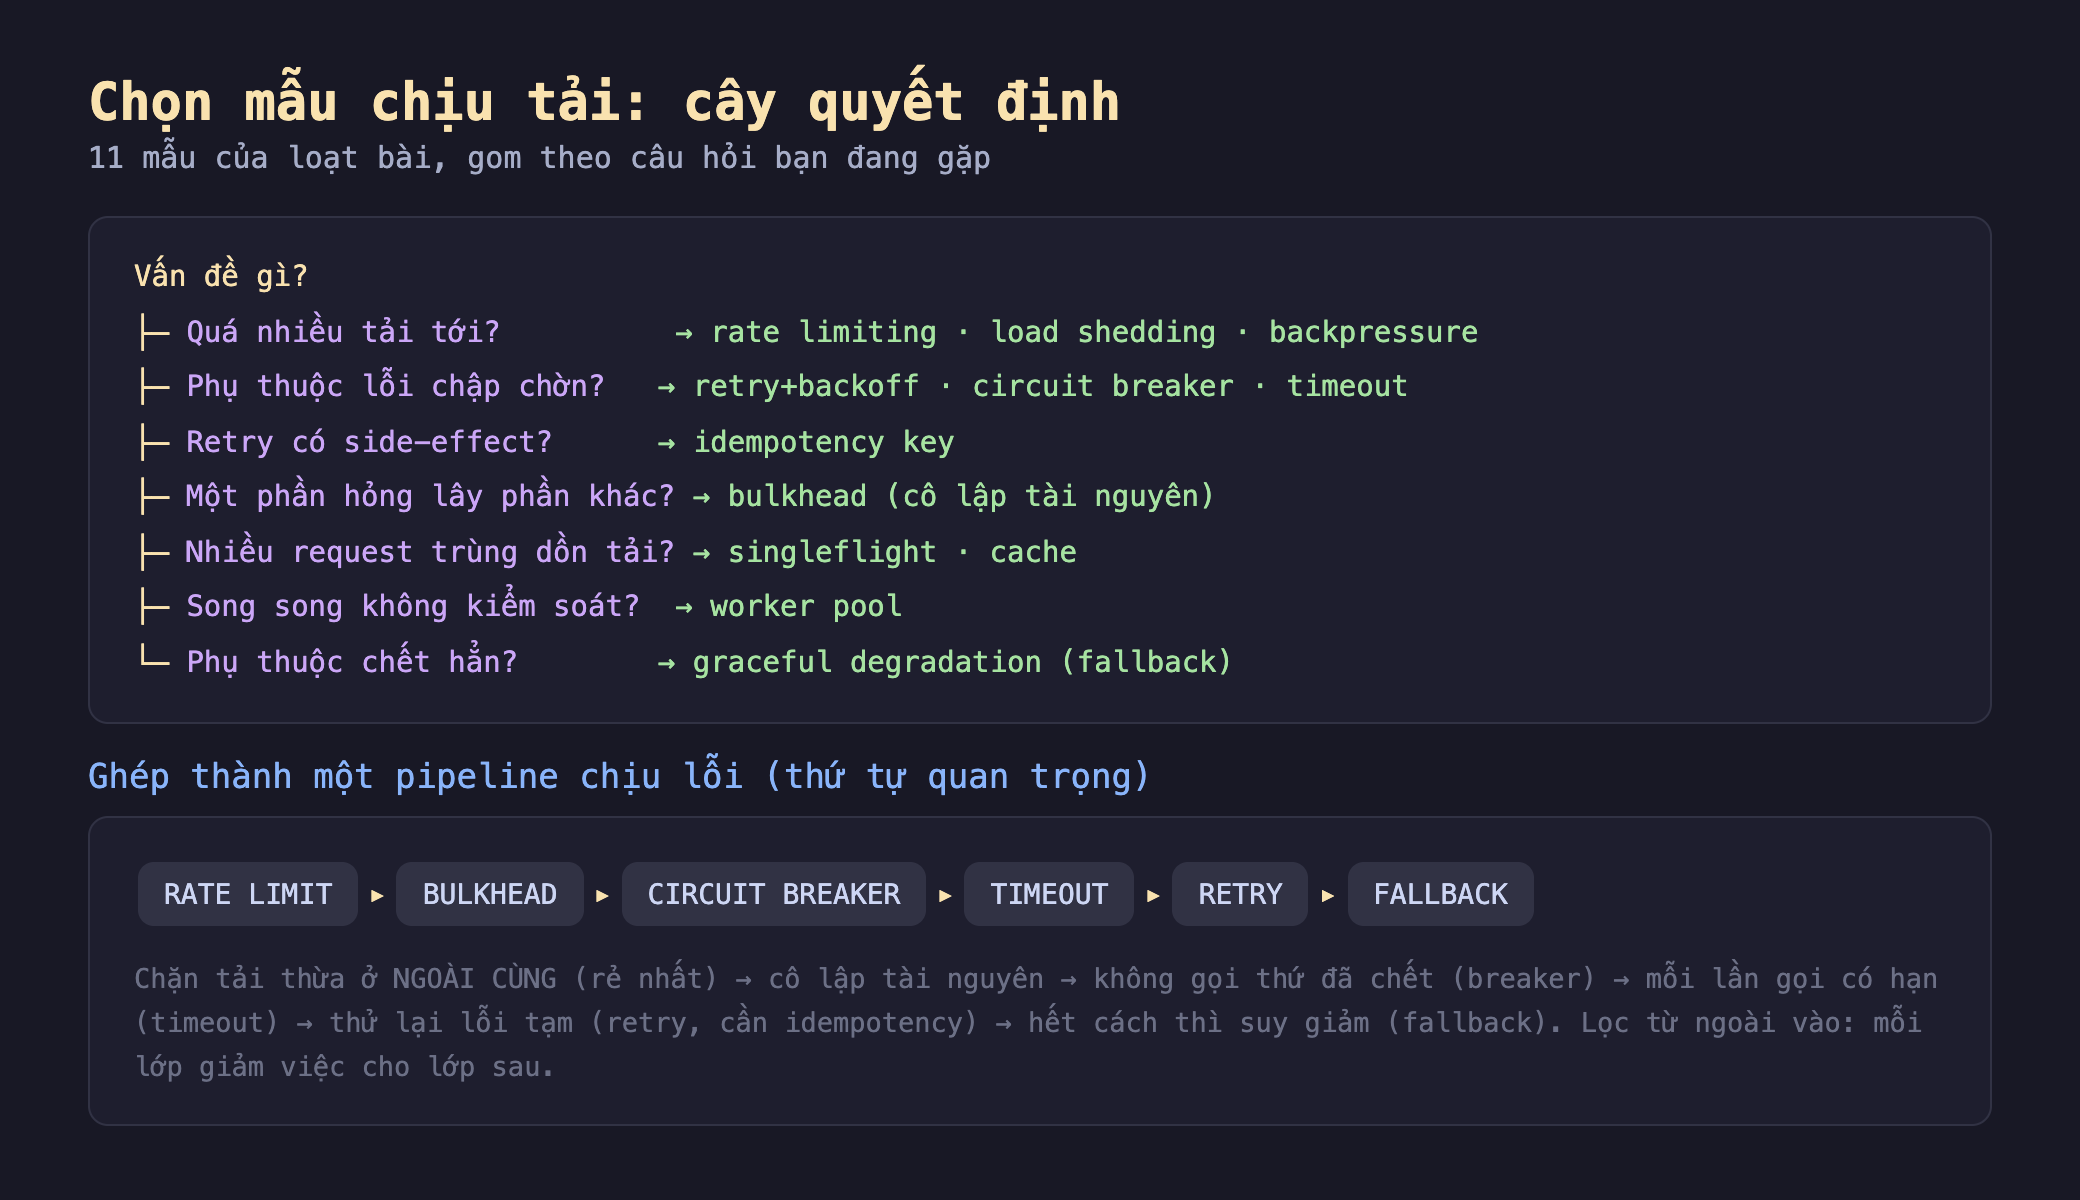
Hình 1: Cây quyết định gom 11 mẫu theo vấn đề — quá tải, phụ thuộc lỗi, retry có side-effect, lỗi lây lan, tải trùng, song song không kiểm soát, phụ thuộc chết hẳn — và thứ tự ghép chúng thành một pipeline: rate limit → bulkhead → circuit breaker → timeout → retry → fallback.
Điểm cần nhớ: các mẫu này không thay thế nhau, chúng bổ sung nhau. Circuit breaker không thay được retry (một cái ngắt khi hỏng lâu, một cái vượt lỗi thoáng qua); bulkhead không thay được timeout (một cái cô lập, một cái đặt hạn). Câu hỏi đúng gần như luôn là "dùng những mẫu nào", không phải "dùng mẫu nào".
Thứ tự ghép: lọc từ ngoài vào
Khi ghép nhiều mẫu quanh một lời gọi, thứ tự quyết định hiệu quả. Nguyên tắc là lọc từ ngoài vào — mỗi lớp giảm việc cho lớp sau, và lớp rẻ nhất đứng ngoài cùng:
- Rate limit (ngoài cùng): từ chối tải thừa ngay khi vào, trước khi tốn bất kỳ tài nguyên nào. Rẻ nhất, nên đứng đầu.
- Bulkhead: cấp một quota tài nguyên cô lập cho luồng này, để nó không hút cạn phần khác.
- Circuit breaker: nếu phụ thuộc đang hỏng (mạch mở), đi thẳng sang fallback — không phí công gọi thứ đã chết.
- Timeout: nếu quyết định gọi thật, đặt hạn để một lời gọi treo không giữ tài nguyên mãi.
- Retry (cần idempotency): lời gọi lỗi tạm thời thì thử lại — nhưng chỉ khi thao tác an toàn với việc lặp.
- Fallback (trong cùng): hết mọi cách trên thì trả một phản hồi suy giảm có ích thay vì lỗi.
Thứ tự này không tùy tiện: đặt retry trước circuit breaker chẳng hạn, bạn sẽ retry cả khi phụ thuộc đã chết hẳn — đúng thứ breaker sinh ra để tránh.
Demo thật: pipeline giữ hệ thống sống
Mình dựng trong go-lab (golang 1.23) một pipeline ghép bulkhead + circuit breaker + timeout + fallback quanh một downstream ốm yếu: 50% lời gọi thành công (40ms), 40% trả lỗi, 10% treo 500ms. Tung 500 request qua 40 worker đồng thời, so sánh gọi thẳng (raw) với đi qua pipeline.
func pipeline(sem *Sem, br *Breaker, c *Cache, ct *counters, r *rand.Rand) {
	fallback := func() { // trả stale cache, không được thì fail
		if v, ok := c.get(); ok { _ = v; atomic.AddInt64(&ct.stale, 1) } else { atomic.AddInt64(&ct.fail, 1) }
	}
	if !sem.acquire(30 * time.Millisecond) { fallback(); return } // BULKHEAD đầy -> fallback
	defer sem.release()
	if !br.allow() { fallback(); return } // BREAKER mở -> fast-fail sang fallback

	ctx, cancel := context.WithTimeout(context.Background(), 120*time.Millisecond) // TIMEOUT
	defer cancel()
	v, err := downstream(ctx, r)
	br.onResult(err == nil)
	if err == nil { c.put(v); atomic.AddInt64(&ct.fresh, 1); return }
	fallback() // lỗi/timeout -> FALLBACK
}
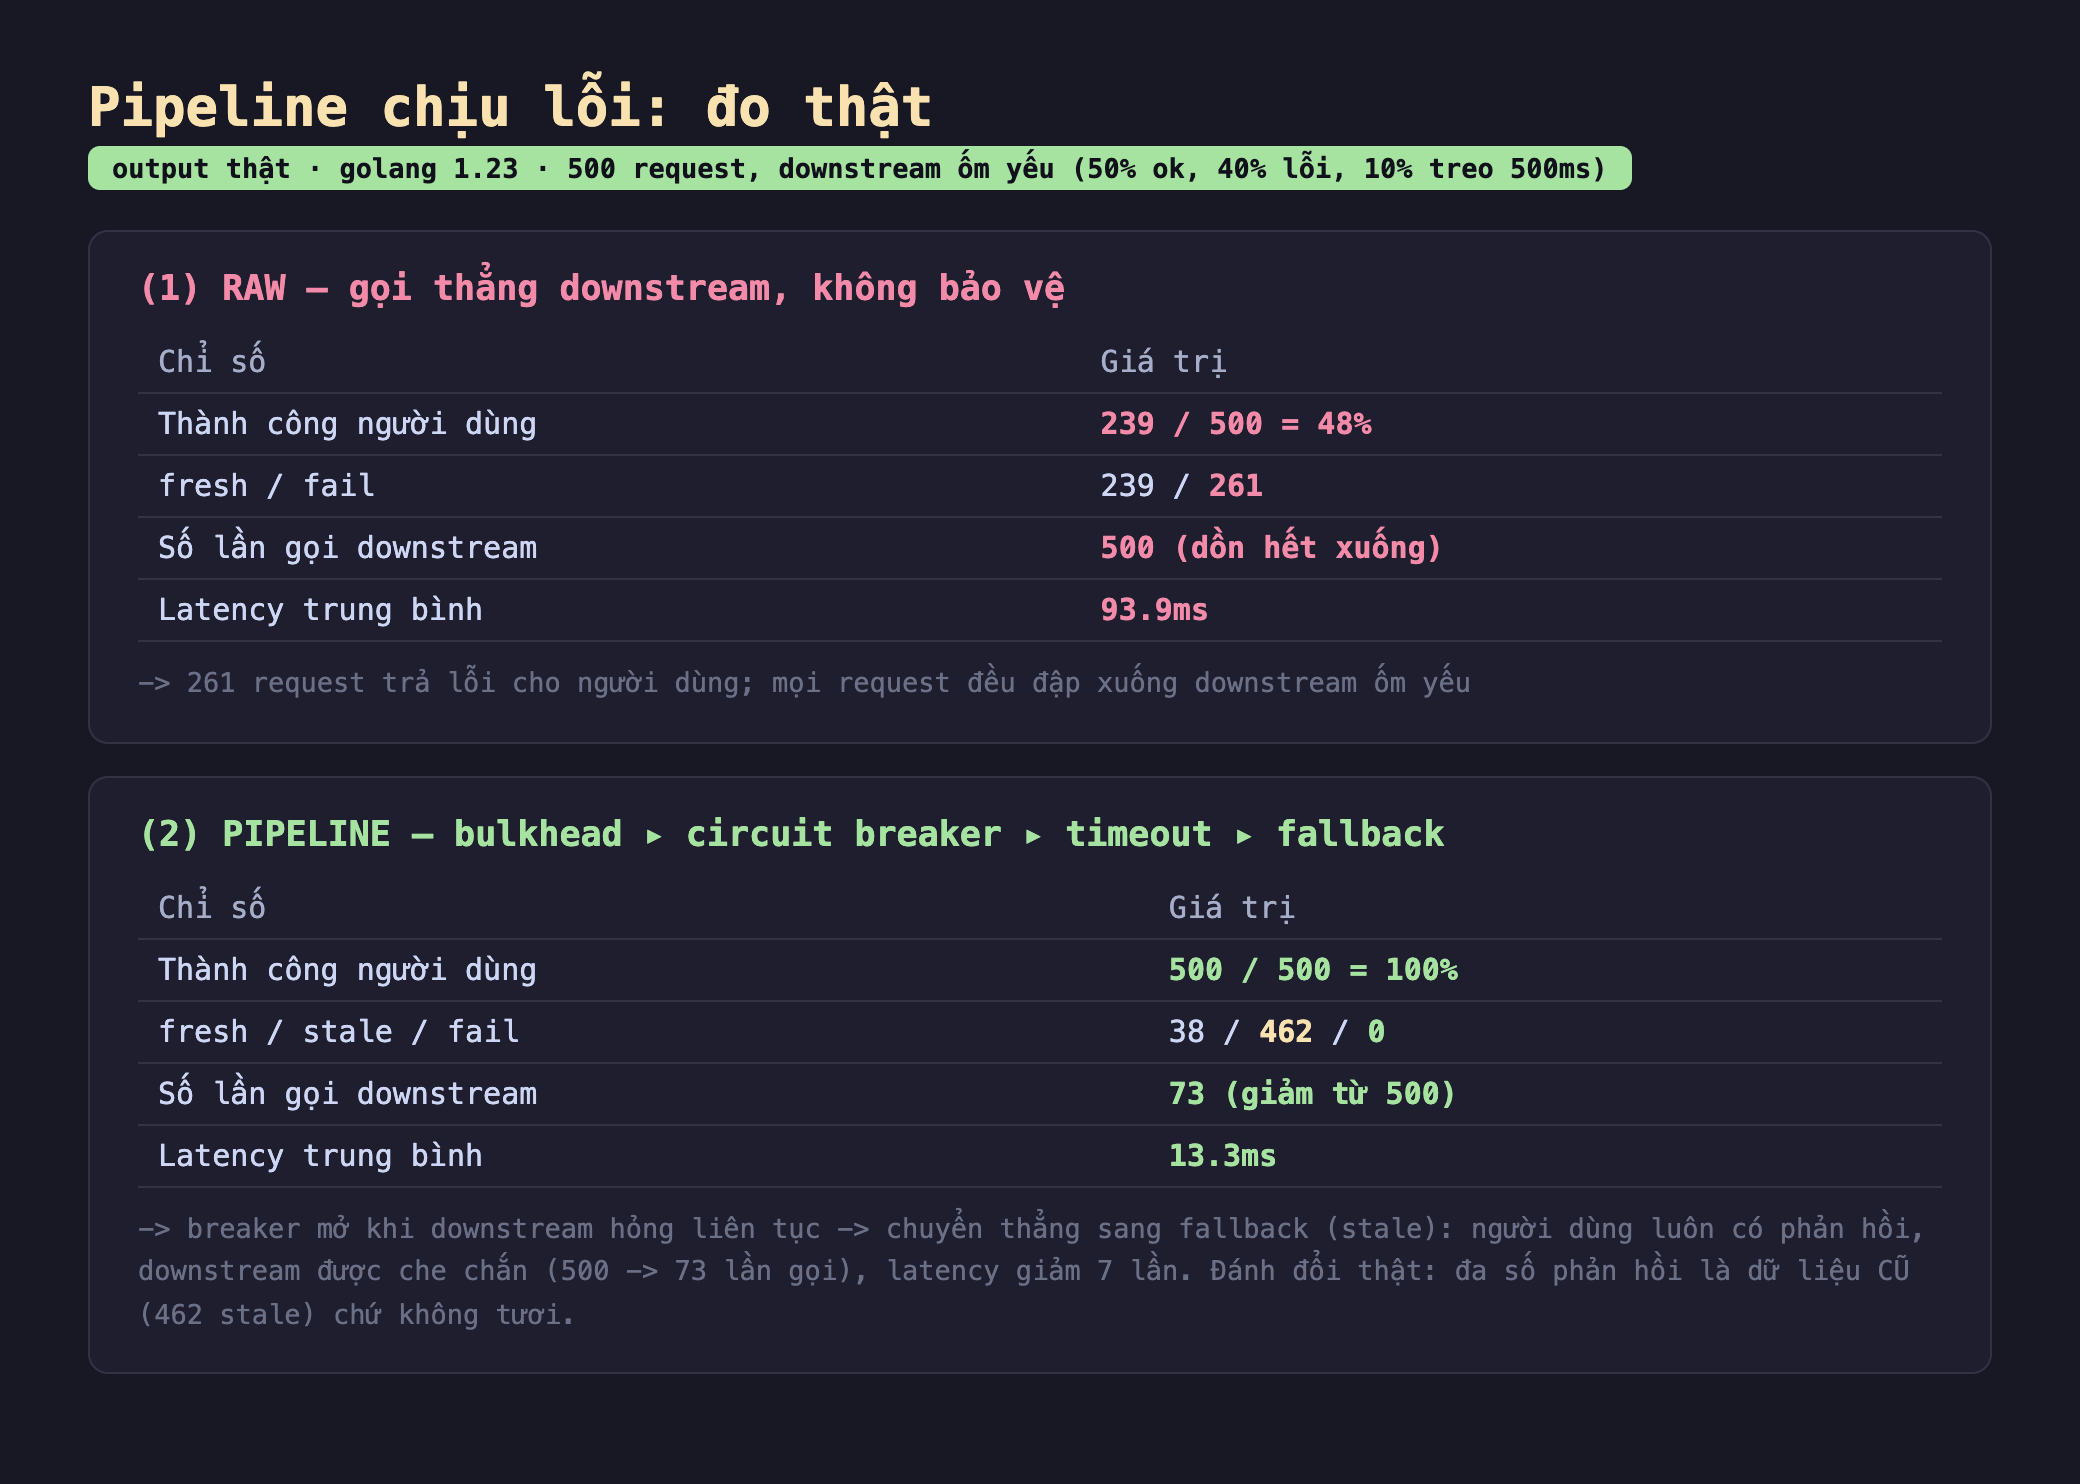
Hình 2: Kết quả thật — RAW: 48% thành công người dùng (239 fresh, 261 fail), 500 lần gọi downstream, latency 93.9ms. PIPELINE: 100% thành công (38 fresh + 462 stale, 0 fail), chỉ 73 lần gọi downstream, latency 13.3ms.
Ba điều pipeline làm được, đo bằng số thật:
- Thành công người dùng: 48% → 100%. Gọi thẳng, người dùng nhận đúng những gì downstream cho — nghĩa là 261/500 request thấy lỗi. Qua pipeline, mỗi lỗi/timeout được fallback đỡ bằng dữ liệu cũ, nên không một người dùng nào thấy lỗi.
- Tải xuống downstream: 500 → 73 lần gọi. Đây là tác dụng của circuit breaker: khi thấy downstream hỏng liên tục, nó mở mạch và chuyển thẳng request sang fallback, không gọi xuống nữa. Downstream ốm yếu được che chắn, có cơ hội hồi phục thay vì bị đập tiếp.
- Latency: 93.9ms → 13.3ms (giảm ~7 lần). Timeout cắt các cú treo 500ms xuống còn tối đa 120ms; và quan trọng hơn, khi breaker mở, phần lớn request trả fallback trong ~0ms thay vì chờ downstream.
Và đây là chỗ phải nói thật, không tô hồng: fresh tụt từ 239 xuống chỉ 38. Vì breaker mở khá mạnh tay với một downstream hỏng tới 50%, đa số request (462) được phục vụ bằng dữ liệu cũ (stale), không phải dữ liệu tươi. Pipeline đổi độ tươi lấy tính khả dụng và tốc độ. Đó là đánh đổi đúng khi downstream đang ốm — thà cho người dùng dữ liệu cũ vài giây trong tích tắc còn hơn bắt họ chờ rồi nhận lỗi — nhưng nó là một đánh đổi, không phải bữa trưa miễn phí. Nếu dữ liệu tuyệt đối không được cũ (số dư, tồn kho lúc thanh toán), bạn phải chỉnh ngưỡng breaker hoặc chấp nhận fail thành thật thay vì stale.
Cả loạt sê-ri dạy gì
Nhìn lại 12 phần, có vài sợi chỉ xuyên suốt đáng rút ra:
- Không mẫu nào miễn phí — mỗi cái là một đánh đổi. Rate limit từ chối cả request thật lúc cao điểm; retry khuếch đại tải; bulkhead lãng phí tài nguyên nhàn rỗi; cache/stale phục vụ dữ liệu cũ; load shedding bỏ rơi một phần người dùng để cứu số còn lại. Chịu tải không phải là "thêm mẫu để hết lỗi", mà là chọn đánh đổi nào chấp nhận được cho từng luồng.
- Đo thật, đừng tin trực giác. Xuyên suốt loạt bài, nhiều kết quả đi ngược cảm tính: MessagePack chỉ nhỏ hơn JSON 1.08 lần, worker pool đo peak 7 thay vì 10 vì channel drain quá nhanh, singleflight không giảm latency mà chỉ giảm tải nguồn, hit rate LRU 0% với truy cập tuần tự. Con số thật luôn dạy điều mà sơ đồ đẹp che mất.
- Các mẫu là một hệ, không phải danh sách. Idempotency làm retry an toàn; circuit breaker quyết định khi nào graceful degradation ra tay; timeout khiến bulkhead thực sự nhả tài nguyên; backpressure và load shedding là hai mặt của cùng một bài toán quá tải. Sức mạnh thật đến từ việc ghép đúng, như demo pipeline cho thấy.
- Mục tiêu cuối là trải nghiệm người dùng, không phải "0 lỗi". Một hệ thống chịu tải tốt không phải là hệ thống không bao giờ hỏng — điều đó bất khả thi. Nó là hệ thống mà khi thành phần hỏng, người dùng ít bị ảnh hưởng nhất có thể: chậm một chút thay vì trắng trang, dữ liệu cũ thay vì lỗi, một tính năng tắt thay vì cả sản phẩm sập.
Ba ý mang về
- Chọn mẫu theo vấn đề, dùng nhiều mẫu cùng lúc: quá tải → rate limit/load shedding/backpressure; phụ thuộc lỗi → retry/circuit breaker/timeout; lỗi lây lan → bulkhead; chết hẳn → graceful degradation; retry có side-effect → idempotency; tải trùng → singleflight/cache. Chúng bổ sung chứ không thay thế nhau.
- Ghép theo thứ tự lọc từ ngoài vào: rate limit → bulkhead → circuit breaker → timeout → retry → fallback, mỗi lớp rẻ hơn đứng ngoài và giảm việc cho lớp sau — đo thật, pipeline ghép 4 mẫu nâng thành công người dùng từ 48% lên 100%, giảm tải downstream từ 500 xuống 73 lần gọi, cắt latency từ 93.9ms xuống 13.3ms.
- Mọi mẫu là một đánh đổi, hãy đo và chọn có ý thức: chính pipeline đó đổi độ tươi lấy tính khả dụng (462/500 phản hồi là dữ liệu cũ) — đúng khi downstream ốm, nhưng sai với dữ liệu không được phép cũ. Chịu tải là nghệ thuật chọn đánh đổi chấp nhận được, không phải phép màu xóa lỗi.
Nguồn
- Michael Nygard — Release It! (tập hợp các mẫu Stability): https://pragprog.com/titles/mnee2/release-it-second-edition/
- Google SRE Book — Addressing Cascading Failures: https://sre.google/sre-book/addressing-cascading-failures/
- Microsoft — Resiliency and reliability patterns: https://learn.microsoft.com/en-us/azure/architecture/patterns/category/resiliency
Cảm ơn bạn đã theo hết 12 phần của loạt "Hệ thống chịu tải". Từ token bucket ở phần 1 tới pipeline ghép mẫu ở phần cuối này, hy vọng bạn đã có một bộ công cụ đo thật để xây những hệ thống không chỉ chạy được, mà còn sống sót khi mọi thứ bắt đầu hỏng — điều chắc chắn sẽ xảy ra.
