Tên "bulkhead" mượn từ đóng tàu: thân tàu được chia thành nhiều khoang kín nước, để nếu một khoang thủng, nước không tràn sang khoang khác và tàu không chìm. Trong hệ thống phần mềm, bulkhead là cùng một ý tưởng: chia tài nguyên (luồng, kết nối, slot xử lý) thành các ngăn cô lập, để khi một phần hỏng, nó không hút cạn tài nguyên của những phần còn khỏe.
Vấn đề nó giải quyết rất phổ biến và rất dễ bị bỏ sót. Hình dung một service có nhiều endpoint dùng chung một pool goroutine (hoặc connection pool, hoặc thread pool). Một endpoint gọi tới một API bên thứ ba, và API đó bỗng treo — không trả lời, không timeout nhanh. Các request tới endpoint đó xếp hàng, mỗi cái giữ một slot trong pool chung và chờ mãi. Chẳng mấy chốc toàn bộ pool bị lấp bởi các request đang treo. Giờ thì mọi endpoint khác — kể cả cái chỉ trả về một giá trị trong RAM trong 1ms — cũng không xin nổi một slot và bắt đầu chết đói. Một phụ thuộc chậm ở một góc đã kéo sập cả service. Bài này (phần 10 loạt Hệ thống chịu tải) đo thật hiện tượng đó và cách bulkhead chặn nó.
Cơ chế: mỗi nhóm một quota tài nguyên riêng
Công cụ nền tảng là semaphore — một bộ đếm giới hạn số việc được chạy đồng thời. Trong Go, cách gọn nhất là một buffered channel: sức chứa của channel chính là số slot. Muốn chạy thì acquire (đẩy một phần tử vào channel); xong thì release (lấy ra). Khi channel đầy, acquire phải chờ — và ta cho nó một timeout để request không chờ vô hạn:
type Sem struct{ ch chan struct{} }

func (s *Sem) acquire(timeout time.Duration) bool {
	select {
	case s.ch <- struct{}{}:
		return true
	case <-time.After(timeout):
		return false // hết chỗ trong hạn -> bị chặn
	}
}
func (s *Sem) release() { <-s.ch }
Điểm mấu chốt của bulkhead không nằm ở bản thân semaphore, mà ở việc dùng bao nhiêu semaphore. Nếu mọi loại request chia nhau một semaphore, đó là pool dùng chung — và nó dễ bị một nhóm chiếm hết. Nếu mỗi nhóm có semaphore riêng, một nhóm chỉ có thể lấp đầy quota của chính nó; các nhóm khác vẫn còn nguyên slot của mình.
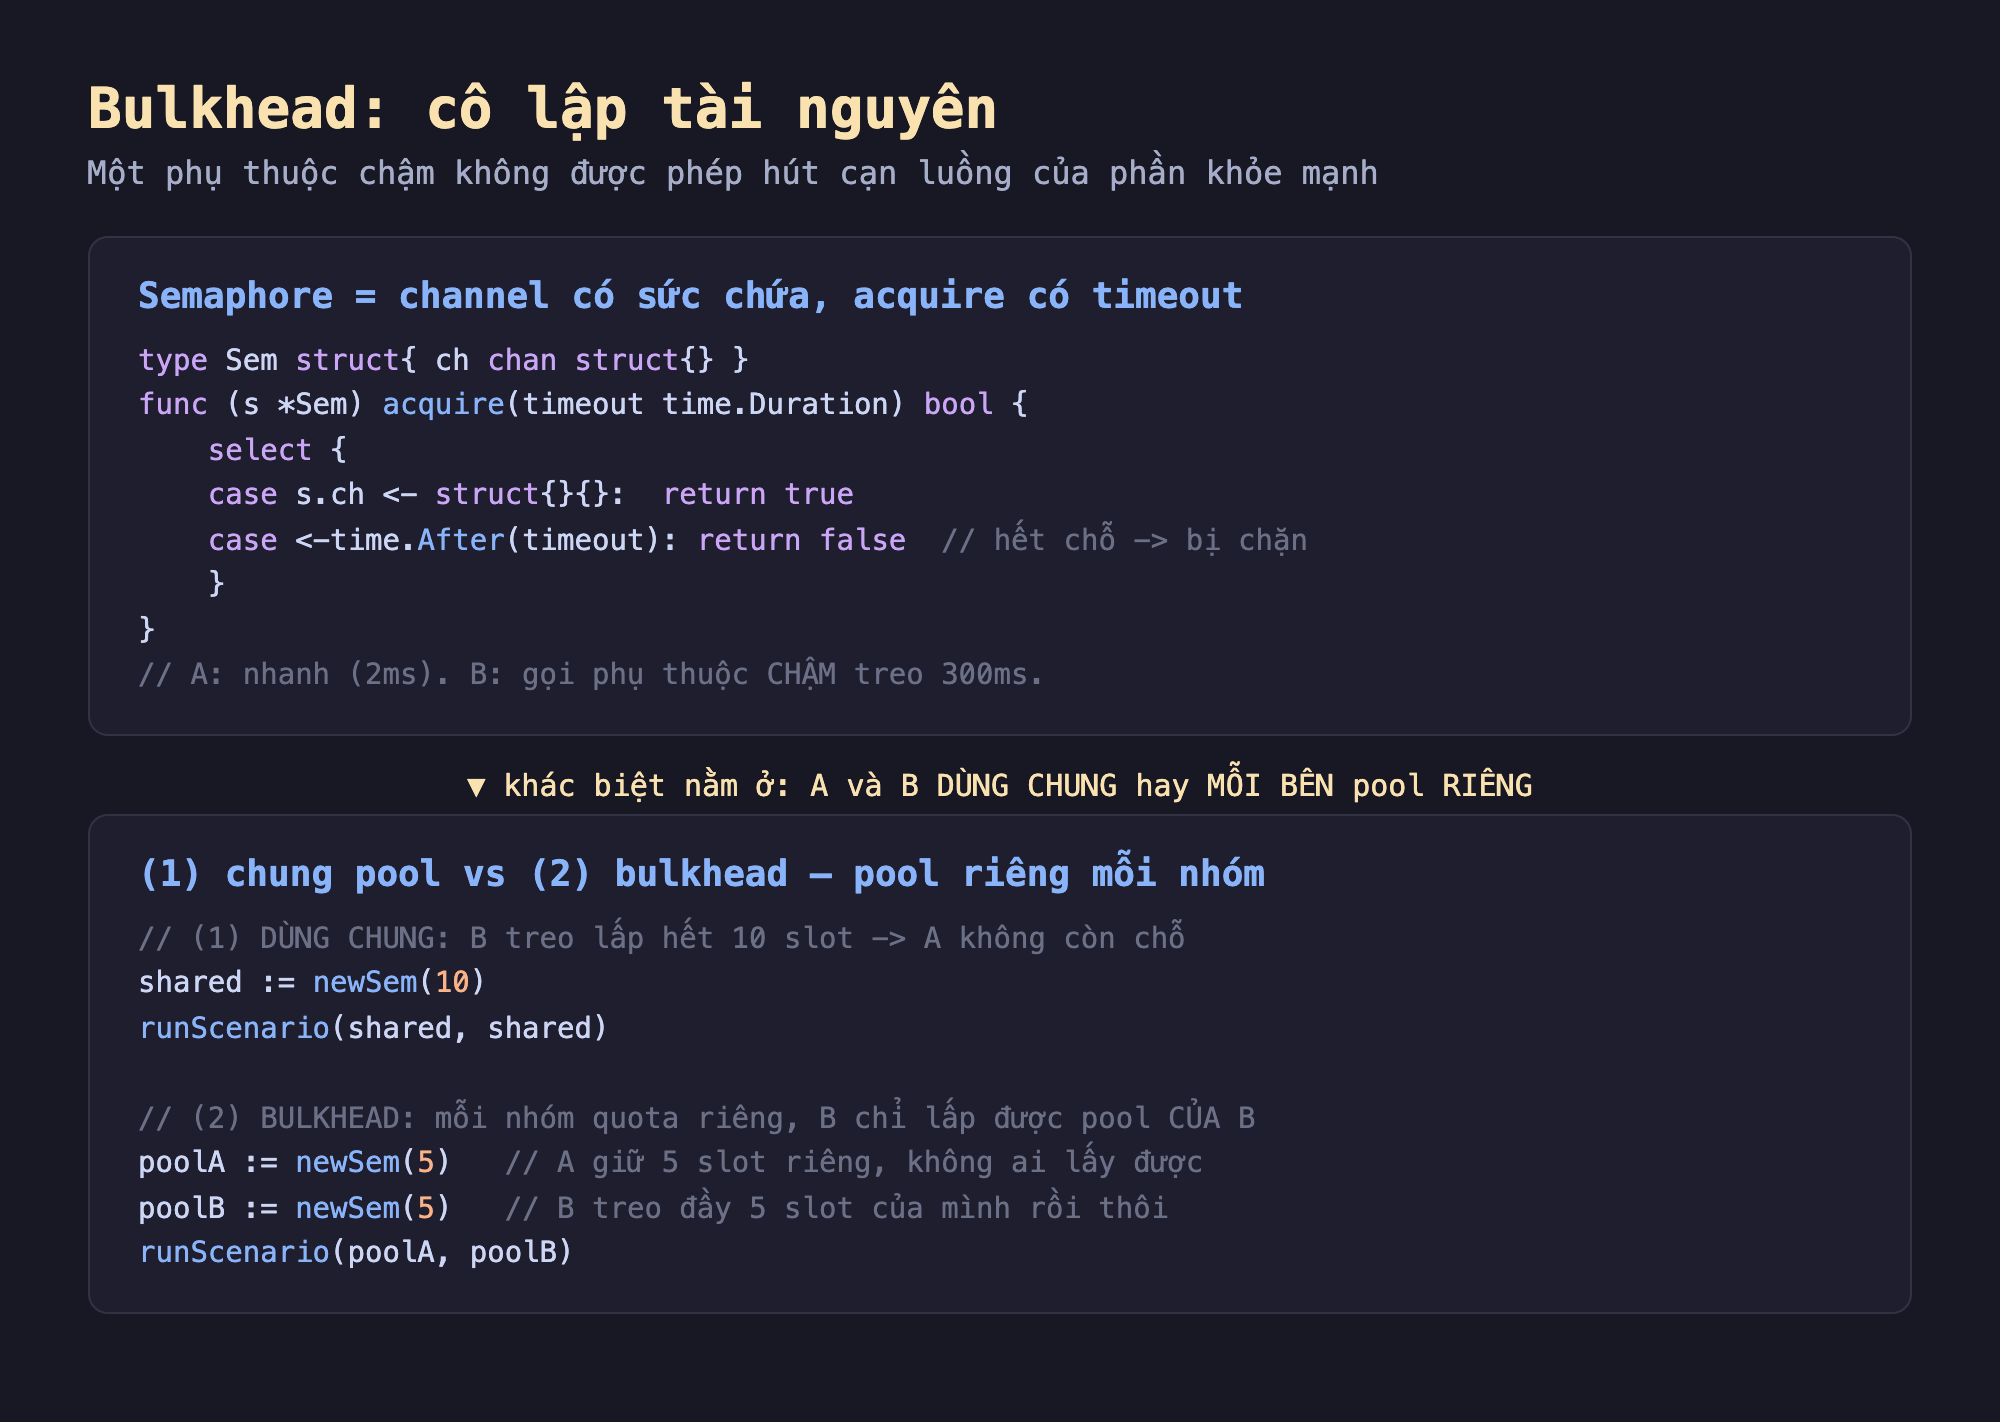
Hình 1: Sem là semaphore dựng từ buffered channel, acquire có timeout để không chờ vô hạn. Khác biệt nằm ở cấu trúc: pool dùng chung (runScenario(shared, shared)) cho A và B chia nhau một pool; bulkhead (poolA, poolB riêng) cho mỗi nhóm quota riêng.
Đo thật trong go-lab
Mình mô phỏng trong go-lab (golang 1.23): hai loại request — A nhanh (2ms, ví dụ đọc cache), B chậm (300ms, gọi một phụ thuộc đang treo). Tung 50 request B (đủ để lấp pool) và 200 request A, đo mỗi nhóm bao nhiêu thành công, bao nhiêu bị chặn (không xin được slot trong 50ms), và latency trung bình của A. Chạy hai lần: pool dùng chung sức chứa 10, và bulkhead với A/B mỗi bên 5 slot.
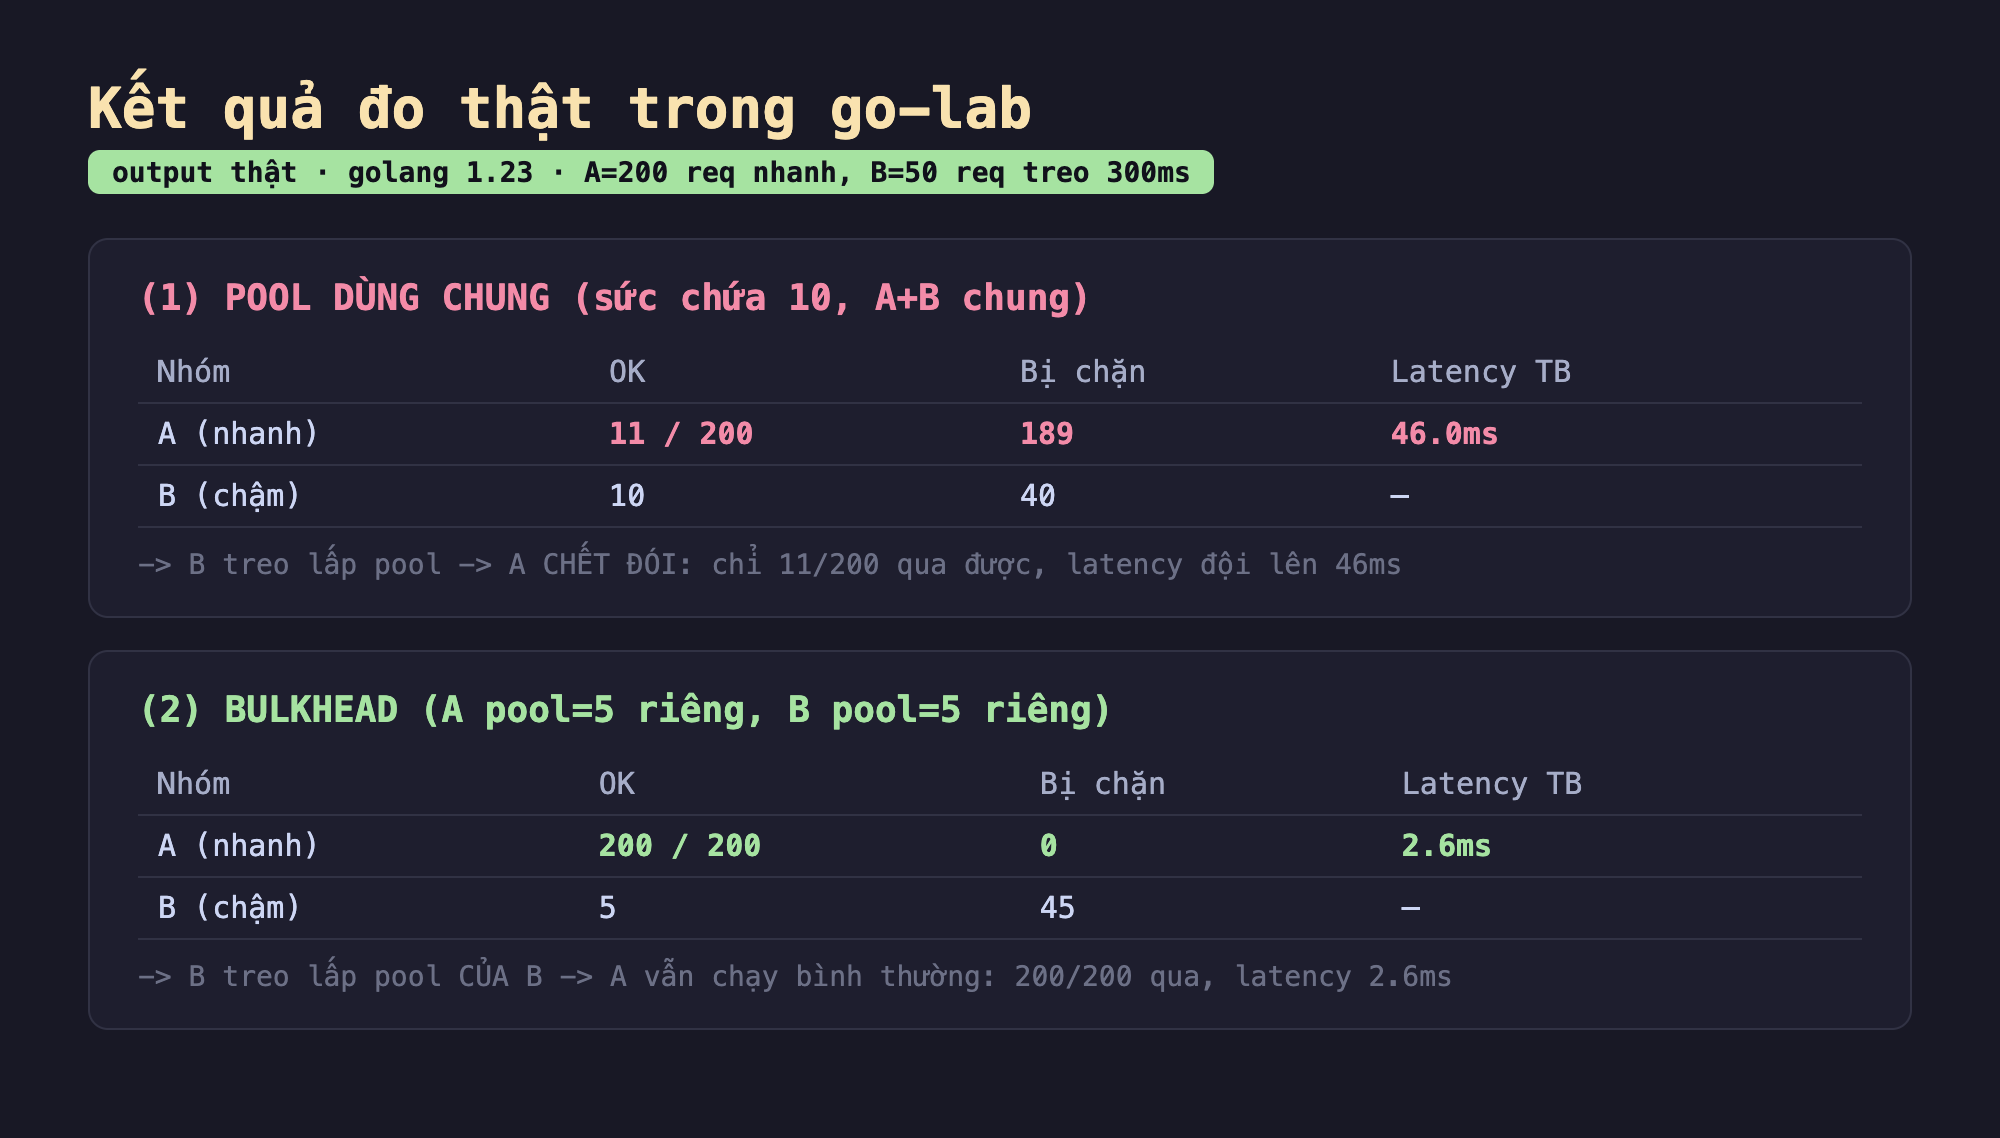
Hình 2: Kết quả thật — pool dùng chung: A chỉ 11/200 thành công, 189 bị chặn, latency 46ms (chết đói vì B treo); bulkhead: A trở lại 200/200, 0 bị chặn, latency 2.6ms.
Con số kể toàn bộ câu chuyện:
- Pool dùng chung — A chết đói. 50 request B treo (mỗi cái giữ slot 300ms) nhanh chóng lấp đầy 10 slot của pool chung. Khi 200 request A tới, chúng phải tranh slot với B đang treo và hầu hết thua: chỉ 11/200 thành công, 189 bị chặn. Tệ hơn, những request A may mắn qua được cũng phải chờ để giành slot — latency trung bình đội lên 46ms cho một thao tác đáng lẽ mất 2ms. Một endpoint nhanh, lành mạnh, bị một phụ thuộc chẳng liên quan làm cho gần như bất khả dụng.
- Bulkhead — A miễn nhiễm. Cho A và B mỗi bên một pool 5 slot riêng. Giờ 50 request B chỉ lấp được 5 slot của B (5 chạy, 45 bị chặn) — và quan trọng là chúng không đụng tới pool của A. Kết quả: A trở lại 200/200 thành công, 0 bị chặn, latency 2.6ms — gần như không phân biệt được với lúc không có sự cố. B vẫn hỏng (đó là bản chất: phụ thuộc của nó đang treo), nhưng thiệt hại được giữ trong khoang của B.
Đây chính là tinh thần "khoang kín nước": bulkhead không sửa được B (không gì sửa được một phụ thuộc đang treo ngoài việc chờ hoặc ngắt), nhưng nó ngăn thiệt hại lan ra. A đáng lẽ chết chung với B, giờ sống khỏe.
Đánh đổi cần cân nhắc
Chia quota cứng lãng phí tài nguyên khi tải lệch. Đây là cái giá thật của bulkhead, và demo cho thấy rõ: ở pool dùng chung, B chạy được 10 request; ở bulkhead B chỉ chạy được 5 (vì quota của nó bị giới hạn còn 5). Nếu lúc nào đó A rảnh mà B đang cần nhiều slot, B không mượn được slot nhàn rỗi của A — các khoang cô lập nghĩa là tài nguyên không được gộp chung linh hoạt. Bạn đánh đổi hiệu suất sử dụng tối đa lấy sự cô lập lỗi. Chọn kích thước mỗi ngăn là bài toán thật: quá nhỏ thì chặn oan lúc tải cao bình thường, quá lớn thì mất tác dụng cô lập.
Bulkhead nằm ở nhiều tầng, không chỉ goroutine. Demo dùng semaphore cho slot xử lý, nhưng nguyên tắc áp cho mọi tài nguyên chia sẻ: connection pool riêng cho mỗi database/service downstream (để một DB chậm không chiếm hết kết nối của DB khác), thread pool riêng (mô hình Hystrix kinh điển của Netflix), thậm chí tách hẳn tiến trình/máy cho các nhóm chức năng quan trọng khác nhau. Câu hỏi luôn là: "tài nguyên nào đang bị chia sẻ, và nếu một nhóm chiếm hết thì ai chết theo?".
Bulkhead hợp lực với timeout và circuit breaker, không thay thế chúng. Bulkhead giới hạn bao nhiêu request B được phép treo cùng lúc, nhưng bản thân nó không làm B ngừng treo. Ghép ba lớp: timeout (phần 4) để mỗi request B tự bỏ cuộc sau một hạn thay vì treo mãi giữ slot; circuit breaker (phần 2) để sau khi thấy B hỏng liên tục thì ngắt hẳn, không thử nữa; và bulkhead để trong lúc B còn đang hỏng, thiệt hại không tràn sang A. Ba mẫu này là bộ ba kinh điển của khả năng chịu lỗi — dùng lẻ mỗi cái đều có lỗ hổng.
Ba ý mang về
- Tài nguyên dùng chung là đường lây lan sự cố: đo thật, khi request chậm B treo lấp pool chung, request nhanh A chẳng liên quan gì cũng chết đói — chỉ 11/200 thành công và latency đội từ 2ms lên 46ms. Một phụ thuộc hỏng ở một góc kéo sập cả service.
- Bulkhead cô lập bằng quota riêng cho mỗi nhóm: đo thật, tách A và B thành hai pool riêng, A trở lại 200/200 thành công, latency 2.6ms dù B vẫn treo — thiệt hại được giữ trong "khoang" của B, đúng tinh thần khoang kín nước.
- Cái giá là hiệu suất sử dụng, và bulkhead cần đồng đội: quota cứng khiến tài nguyên nhàn rỗi của nhóm này không cho nhóm kia mượn (B chỉ chạy 5 thay vì 10); chọn kích thước ngăn là đánh đổi thật; và bulkhead phải đi cùng timeout + circuit breaker để vừa chặn lan, vừa khiến phụ thuộc hỏng thực sự nhả tài nguyên.
Nguồn
- Michael Nygard — Release It! (mẫu Bulkhead): https://pragprog.com/titles/mnee2/release-it-second-edition/
- Netflix Tech Blog — Hystrix: bulkhead qua thread pool cô lập: https://github.com/Netflix/Hystrix/wiki/How-it-Works#isolation
- Microsoft — Bulkhead pattern: https://learn.microsoft.com/en-us/azure/architecture/patterns/bulkhead
Phần sau ta bàn về graceful degradation: khi một phụ thuộc chết hẳn, làm sao trả về một phản hồi suy giảm có ích (dữ liệu cũ, giá trị mặc định, tính năng rút gọn) thay vì để cả trang trắng.
