Đây là bài mà mọi lập trình viên Việt nên đọc trước khi viết regex xử lý tiếng Việt — vì đây là nơi bug ẩn nấp âm thầm nhất. Bạn viết \w+ để "lấy các từ", test với "hello world" thấy ổn, rồi chạy trên "Xin chào các bạn" và... một nửa chữ biến mất mà không có lỗi nào. Hoặc bạn so sánh hai chuỗi "café" nhìn giống hệt nhau trên màn hình mà regex báo không khớp. Gốc rễ là ba tầng khái niệm Unicode mà regex chạm phải: \w hiểu Unicode hay không, byte khác ký tự, và cùng một chữ có nhiều cách mã hóa. Bài này (phần 9 loạt Regex) đo thật cả ba trên cả python lẫn Go — hai engine hành xử khác nhau, và biết sự khác đó cứu bạn khỏi nhiều giờ gỡ lỗi.
Ba tầng cạm bẫy
\wUnicode hay ASCII? Tùy engine. Pythonremặc định\whiểu Unicode (bắt cả chữ có dấu). Goregexpthì\wchỉ là ASCII[0-9A-Za-z_]. Còn[a-zA-Z]ở cả hai đều chỉ ASCII. Nên cùng một mẫu cho kết quả khác nhau giữa hai ngôn ngữ.- Byte vs rune (codepoint). Trong UTF-8, một chữ có dấu chiếm nhiều byte:
'à'= 2 byte,'ệ'= 3 byte. Regex tốt khớp theo ký tự (rune/codepoint), không theo byte — nhưng nếu bạn chạy regex trên dữ liệu byte thô, kết quả sẽ vỡ. - NFC vs NFD. Chữ
'à'có thể được mã hóa thành một codepoint (U+00E0, "chữ dựng sẵn") hoặc hai codepoint ('a'U+0061 + dấu huyền tổ hợp U+0300). Hai cách nhìn giống hệt nhau trên màn hình nhưng là chuỗi khác nhau — và regex khớp chúng khác nhau.
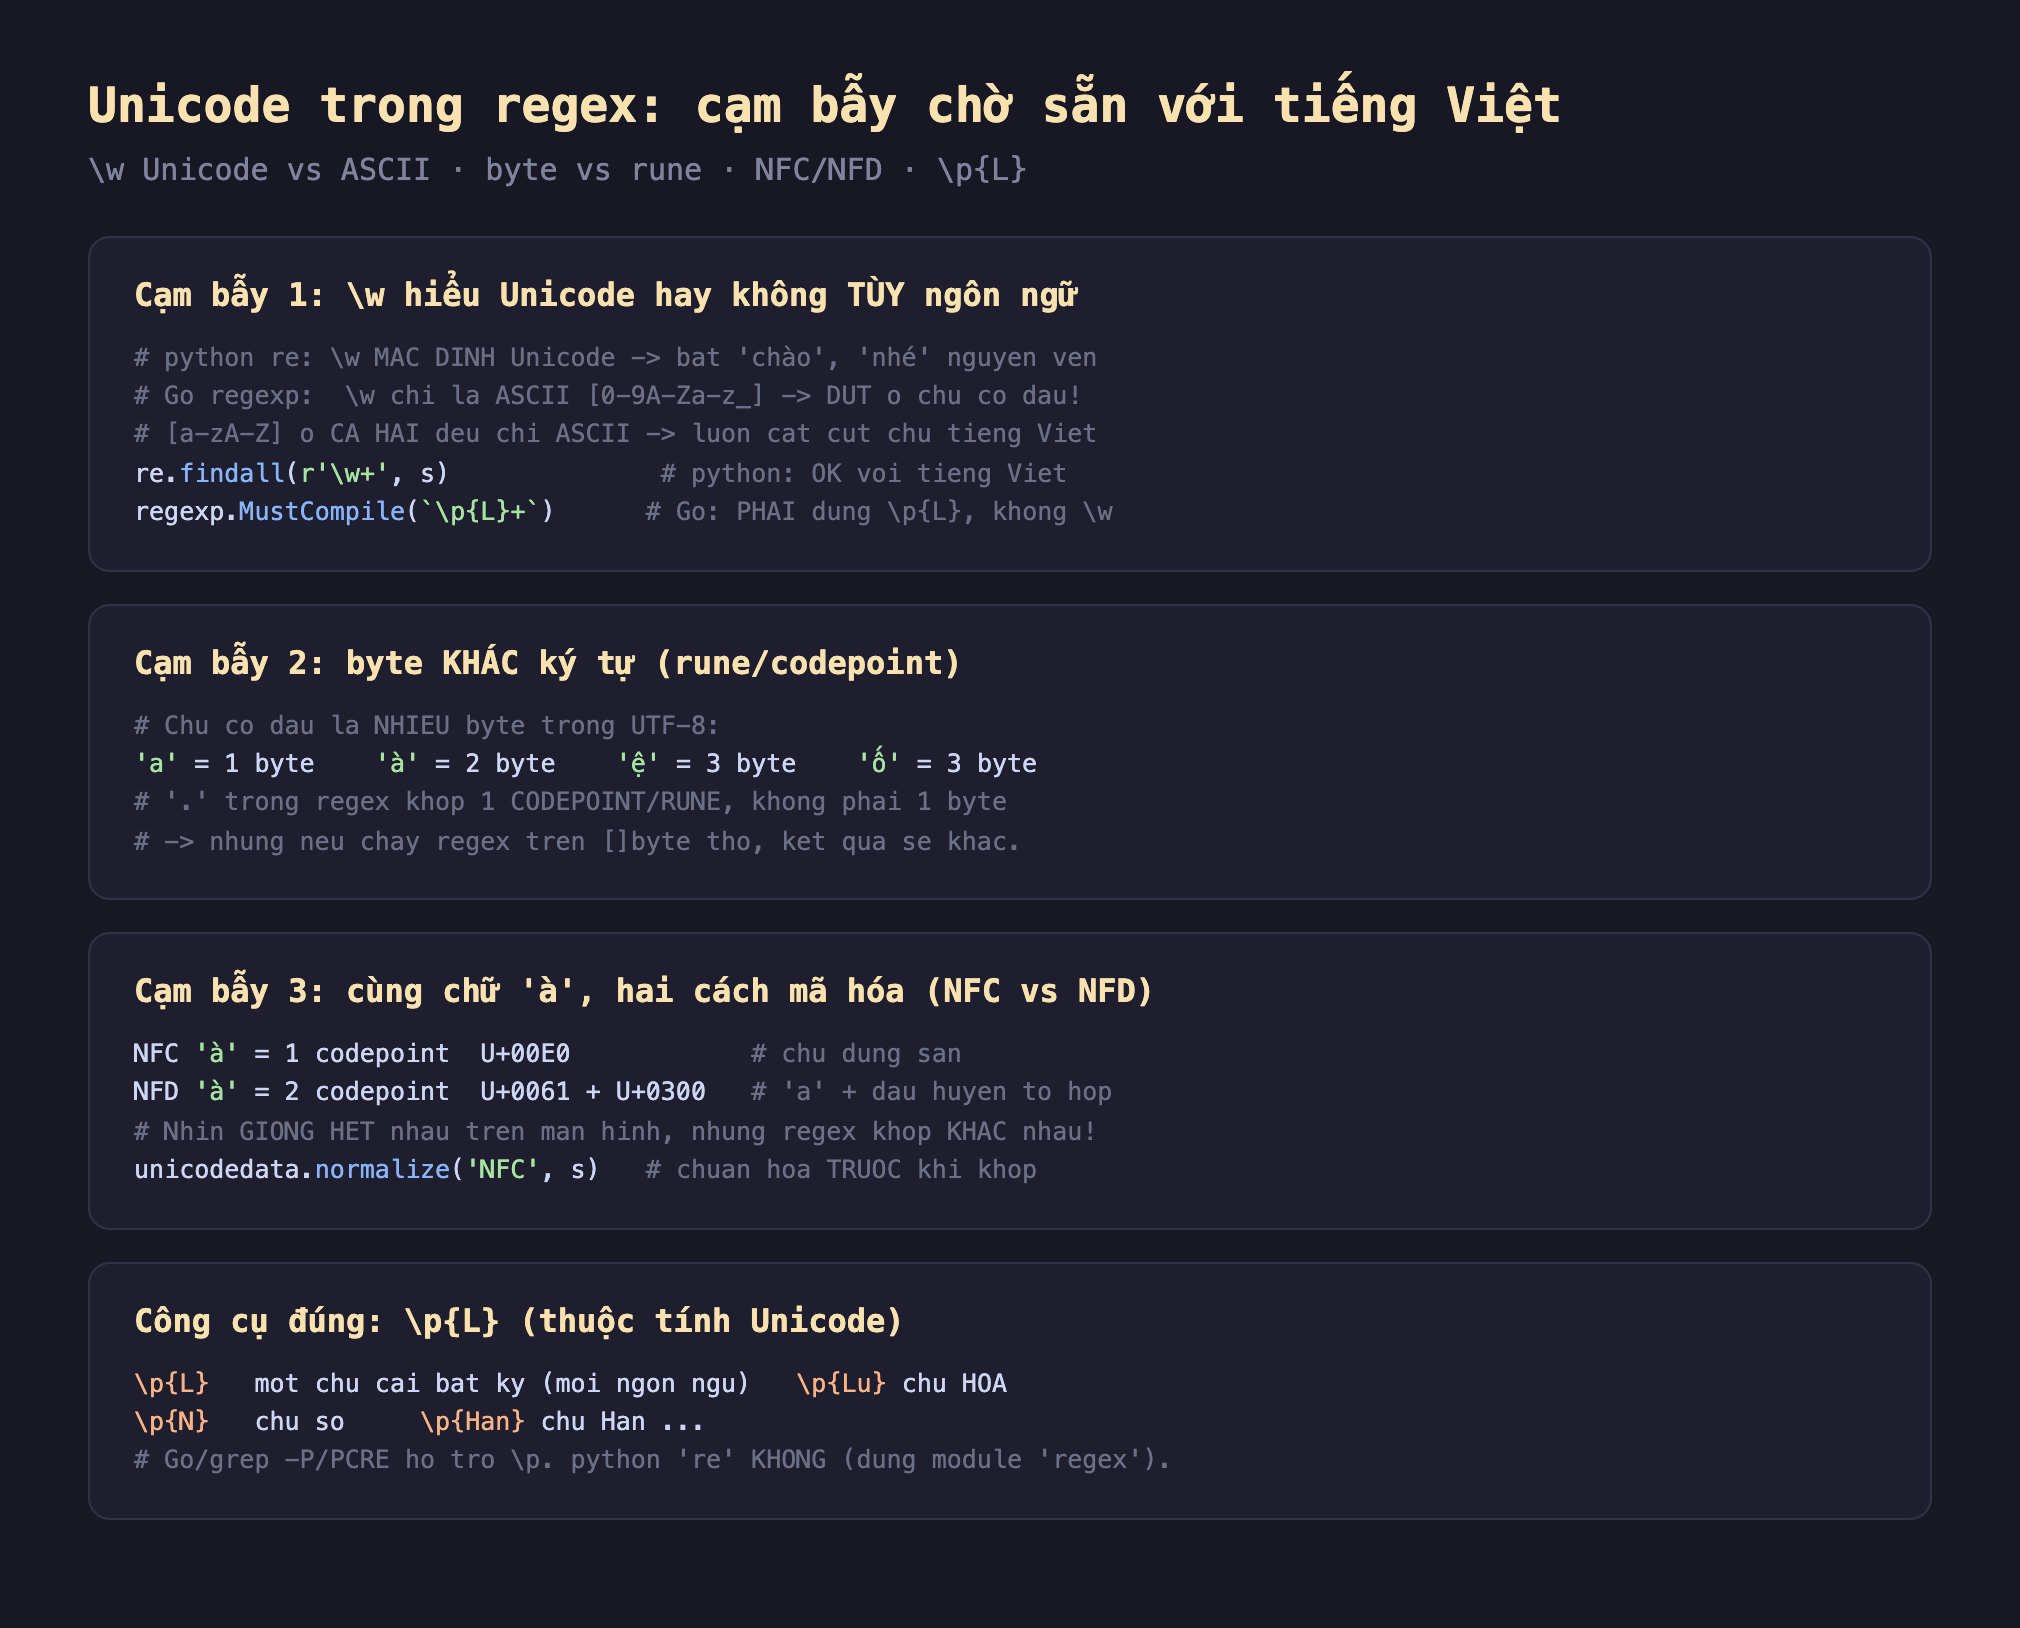
Hình 1: Ba cạm bẫy Unicode của regex — \w hiểu Unicode (python) hay chỉ ASCII (Go); byte khác rune ('à'=2 byte); NFC (1 codepoint) khác NFD (2 codepoint) dù nhìn giống nhau; công cụ đúng là \p{L} (thuộc tính Unicode).
Đo thật: ba engine, ba cách hành xử
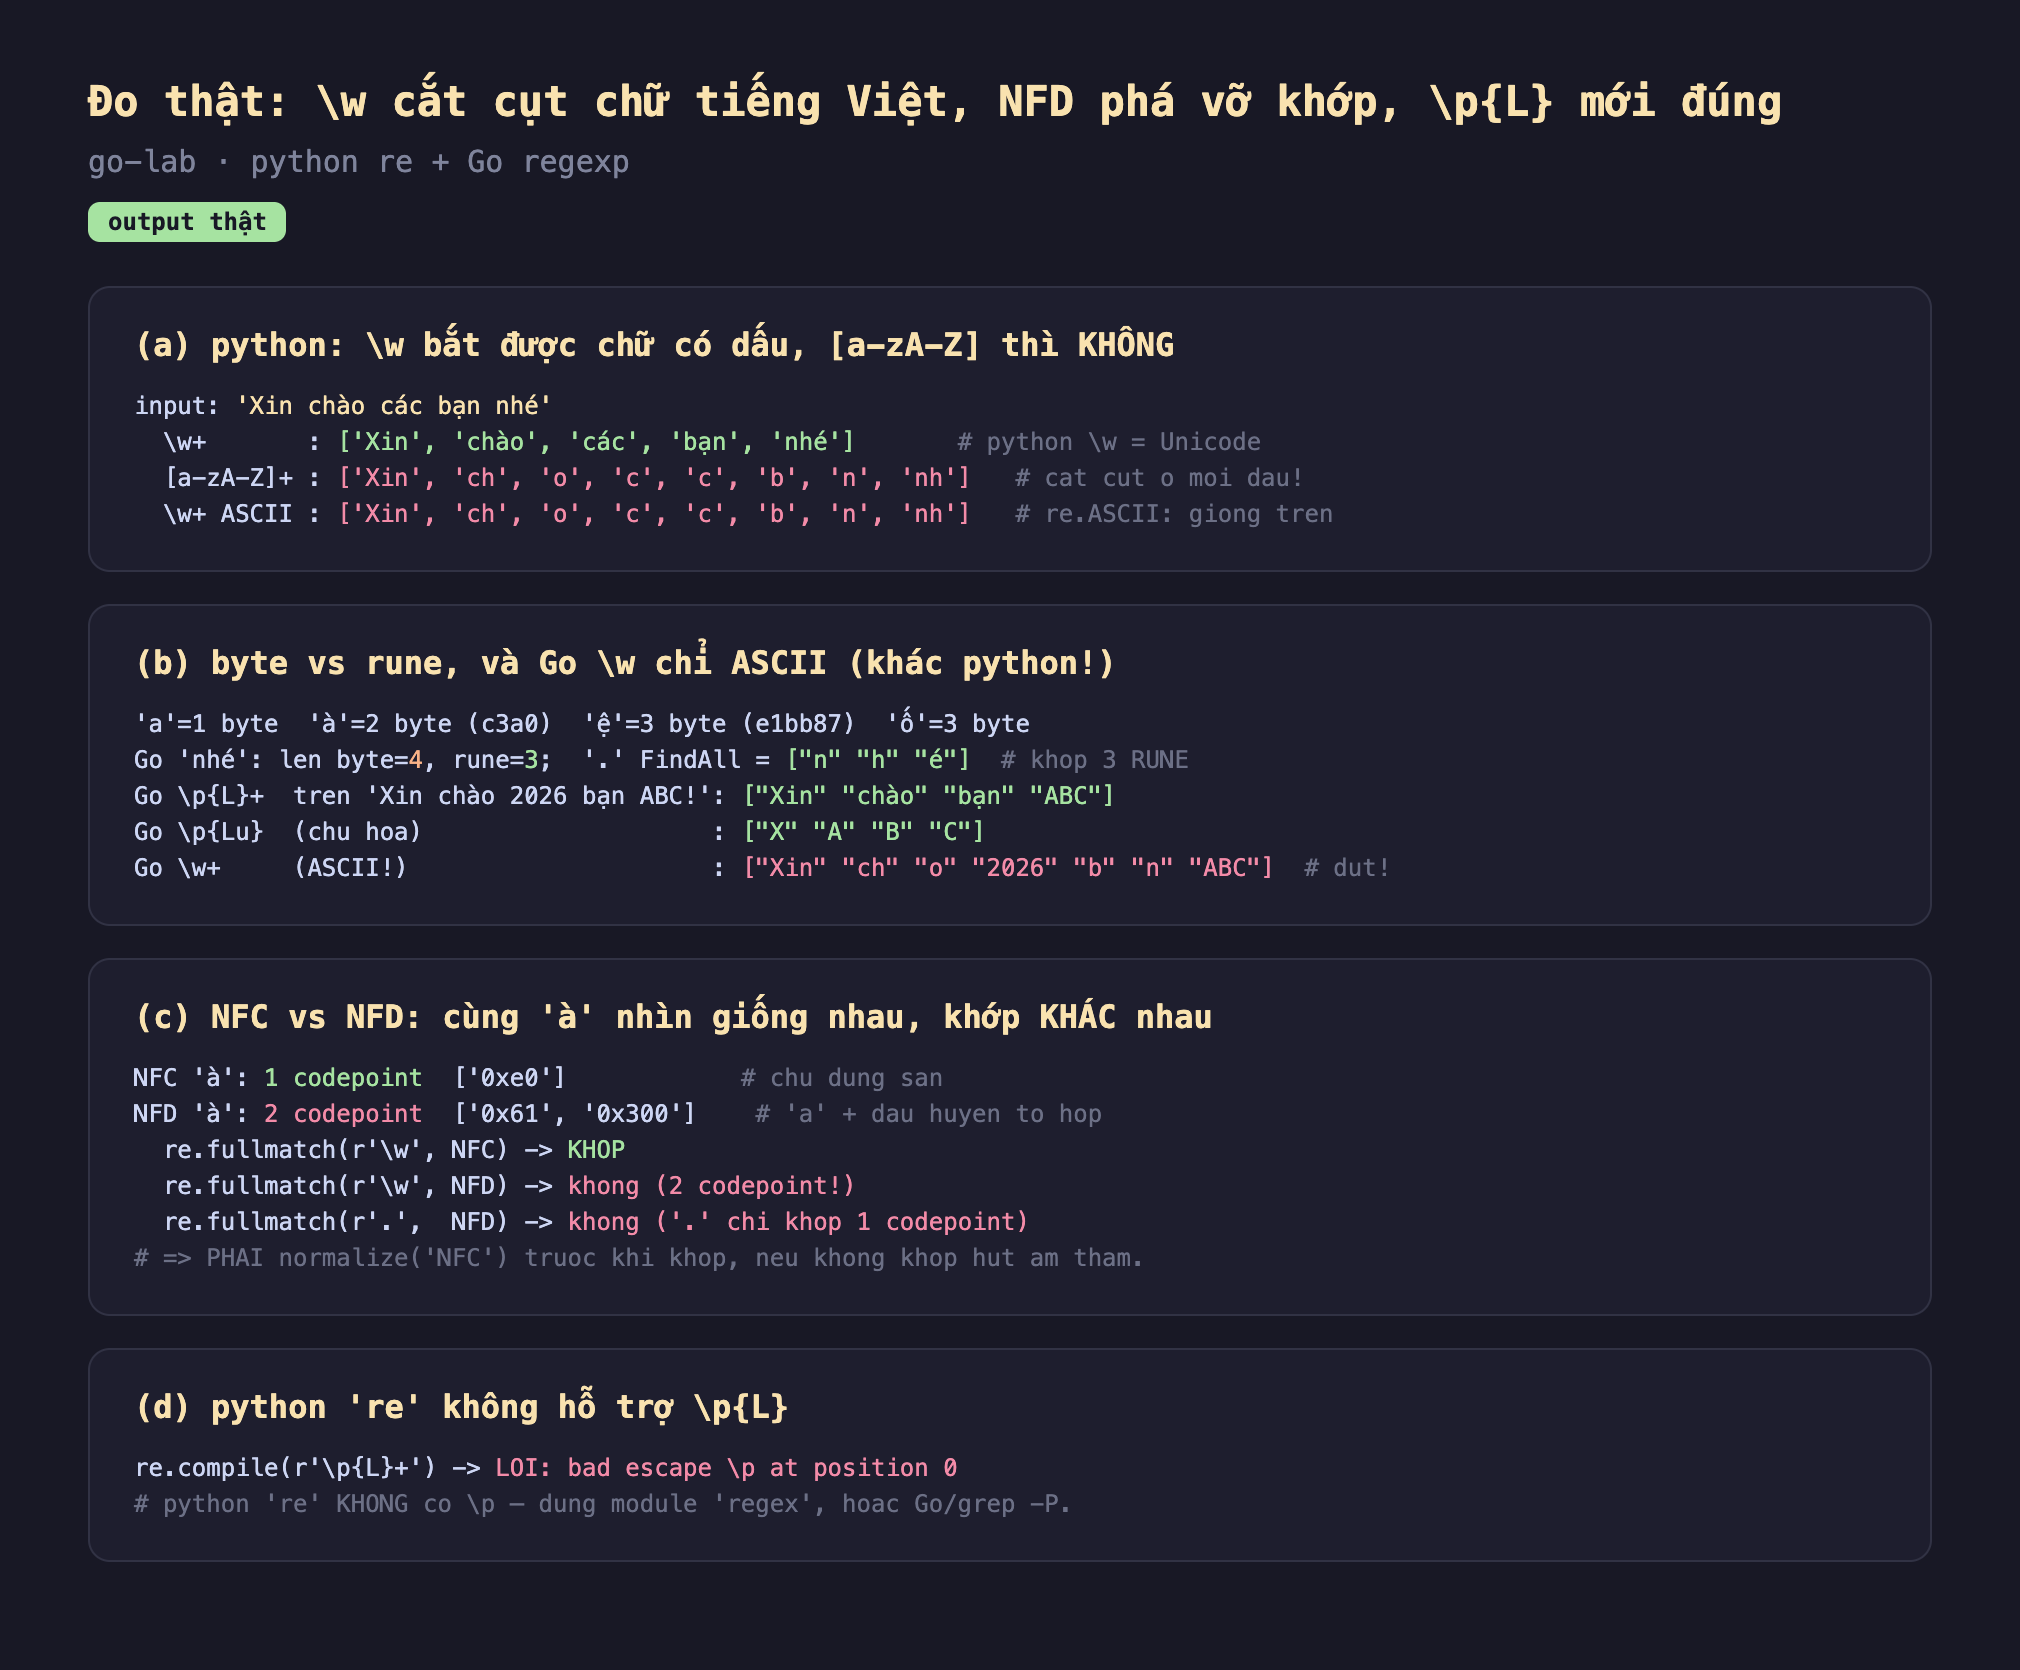
Hình 2: Chạy thật — (a) python \w+ bắt ['Xin','chào','các','bạn','nhé'] nhưng [a-zA-Z]+ cắt thành ['Xin','ch','o',...]; (b) 'à'=2 byte, Go 'nhé'=4 byte/3 rune, . khớp 3 rune, Go \w chỉ ASCII nên phải dùng \p{L}; (c) NFC 'à'=1 codepoint khớp \w, NFD 'à'=2 codepoint không khớp; (d) python re báo lỗi với \p{L}.
- (a) python
\wbắt chữ có dấu,[a-zA-Z]thì không: trên"Xin chào các bạn nhé",\w+cho đúng năm từ nguyên vẹn vì python coi\wlà Unicode. Nhưng[a-zA-Z]+(và\wvới cờre.ASCII) cắt vụn thành['Xin','ch','o','c','c','b','n','nh']— mỗi chữ có dấu là một điểm đứt. Nếu bạn dùng[a-zA-Z]để tách từ tiếng Việt, dữ liệu của bạn đang bị băm nhỏ âm thầm. - (b) byte vs rune, và Go khác python:
'à'=2 byte,'ệ'=3 byte. Trong Go,"nhé"dài 4 byte nhưng 3 rune, và.khớp đúng 3 rune["n","h","é"]— regex Go làm việc theo rune. Nhưng cú sốc: Go\wchỉ ASCII, nên\w+trên"Xin chào 2026 bạn ABC!"cắt vụn["Xin","ch","o","2026","b","n","ABC"]. Muốn bắt chữ Unicode trong Go phải dùng\p{L}+→["Xin","chào","bạn","ABC"](đúng), và\p{Lu}lấy chữ hoa["X","A","B","C"]. - (c) NFC vs NFD — bug âm thầm nhất:
'à'chuẩn NFC là 1 codepoint (0xe0), khớp\w. Nhưng cùng chữ đó ở dạng NFD là 2 codepoint (0x61+0x300), nênre.fullmatch(r'\w', nfd)không khớp (nó là hai ký tự!), vàre.fullmatch(r'.', nfd)cũng không khớp vì.chỉ ăn một codepoint. Dữ liệu từ macOS (hay dán từ một số nguồn) thường ở NFD, nên regex viết cho NFC sẽ khớp hụt mà không báo lỗi. Cách chữa:unicodedata.normalize('NFC', s)trước khi khớp. - (d) python
rekhông có\p{L}:re.compile(r'\p{L}+')báo lỗibad escape \p. Module chuẩnrecủa Python không hỗ trợ thuộc tính Unicode; muốn dùng\p{...}phải cài moduleregex(bên thứ ba), hoặc dùng Go/grep -P/PCRE.
Đánh đổi cần cân nhắc
Chuẩn hóa Unicode nên làm ở biên, không rải khắp regex. Thay vì nhét normalize vào từng chỗ khớp, hãy chuẩn hóa dữ liệu về một dạng (thường NFC) ngay khi nhận vào hệ thống (đọc file, nhận request). Khi mọi chuỗi trong hệ thống đã đồng nhất NFC, regex của bạn không phải lo NFC/NFD nữa. Đây là nguyên tắc "chuẩn hóa ở biên" — rẻ hơn và ít lỗi hơn là vá từng chỗ.
\p{L} mạnh nhưng chậm hơn và không phải engine nào cũng có. Thuộc tính Unicode \p{...} phải tra bảng Unicode lớn, nên thường chậm hơn lớp ASCII đơn giản. Với dữ liệu chắc chắn chỉ ASCII, [a-z] nhanh hơn \p{L}. Và như đã đo, python re không có \p — nên nếu cần tính di động cao, cân nhắc engine (Go, PCRE, .NET có; python re không). Đừng cho là \p{L} luôn dùng được.
"Một ký tự người dùng thấy" có thể là nhiều codepoint (grapheme cluster). Còn một tầng sâu hơn NFC/NFD: một số ký tự hiển thị (như emoji có modifier, hay một số chữ ghép) là nhiều codepoint hợp thành một "grapheme cluster". . khớp một codepoint, không phải một grapheme — nên . có thể khớp "nửa" một ký tự hiển thị. Regex thuần không xử lý grapheme cluster; nếu cần đếm/cắt theo đúng ký tự người dùng thấy, dùng thư viện grapheme (như \X trong PCRE, hoặc thư viện chuyên dụng).
Ba ý mang về
\whiểu Unicode tùy engine — kiểm trước khi tin: đo thật python\w+bắt['Xin','chào','các','bạn','nhé']nhưng Go\w+(chỉ ASCII) và[a-zA-Z]+cắt vụn chữ có dấu; trong Go phải dùng\p{L}để bắt chữ Unicode.- Byte khác rune, và cùng chữ có nhiều mã hóa: đo thật
'à'=2 byte,.khớp 1 rune (không 1 byte); NFC'à'=1 codepoint khớp\w, NFD'à'=2 codepoint không khớp — dữ liệu NFD làm regex khớp hụt âm thầm, phảinormalize('NFC')trước. - Dùng
\p{L}và chuẩn hóa ở biên:\p{L}/\p{Lu}là công cụ đúng cho chữ Unicode (Go/PCRE có, pythonrebáo lỗibad escape \p— dùng moduleregex); chuẩn hóa Unicode ngay khi nhận dữ liệu để regex không phải lo NFC/NFD, và nhớ grapheme cluster là tầng sâu hơn.không xử lý.
Nguồn
- Go docs — regexp/syntax (Unicode character classes,
\p): https://pkg.go.dev/regexp/syntax - Python docs — unicodedata (normalize NFC/NFD): https://docs.python.org/3/library/unicodedata.html
- Unicode — UAX #15: Normalization Forms: https://unicode.org/reports/tr15/
Phần sau ta chuyển từ khớp sang biến đổi: nhóm bắt, nhóm đặt tên, và thay thế — cách trích từng phần rồi dựng lại chuỗi mới bằng \1/$1 trong sub, và vì sao nhóm không bắt (?:...) lại quan trọng cho hiệu năng.
