Phần 7 cho thấy RE2 từ chối một nhóm tính năng để giữ tuyến tính. Bài này mổ xẻ nhóm quan trọng nhất trong đó: lookaround — gồm lookahead ((?=...), (?!...)) và lookbehind ((?<=...), (?<!...)). Đây là những công cụ khiến regex mạnh đến mức làm được cả việc mà thoạt nhìn tưởng phải viết code: chèn dấu phẩy phân nhóm nghìn, kiểm tra độ mạnh mật khẩu bằng một dòng, trích số tiền mà bỏ ký hiệu $. Bí quyết là chúng zero-width — giống anchor ở phần 3, chúng khẳng định một điều kiện về ngữ cảnh quanh vị trí hiện tại mà không lấy ký tự nào vào kết quả. Bài này (phần 8 loạt Regex) đo thật cả bốn dạng, và hiểu vì sao sức mạnh đó đánh đổi bằng đảm bảo tuyến tính.
Bốn dạng, đều zero-width
Lookaround "nhìn" quanh vị trí con trỏ để kiểm tra một điều kiện, rồi không di chuyển con trỏ:
(?=...)lookahead dương: ngay sau vị trí này phải khớp....(?!...)lookahead âm: ngay sau vị trí này không được khớp....(?<=...)lookbehind dương: ngay trước vị trí này phải khớp....(?<!...)lookbehind âm: ngay trước vị trí này không được khớp....
Vì zero-width, phần khớp trong lookaround không nằm trong kết quả match — đúng như tên gọi "nhìn" chứ không "ăn". Nhớ lại phần 7: chính vì lookaround (và backreference) mà RE2/Go từ chối; các ví dụ dưới đây chỉ chạy trên engine backtracking như python re.
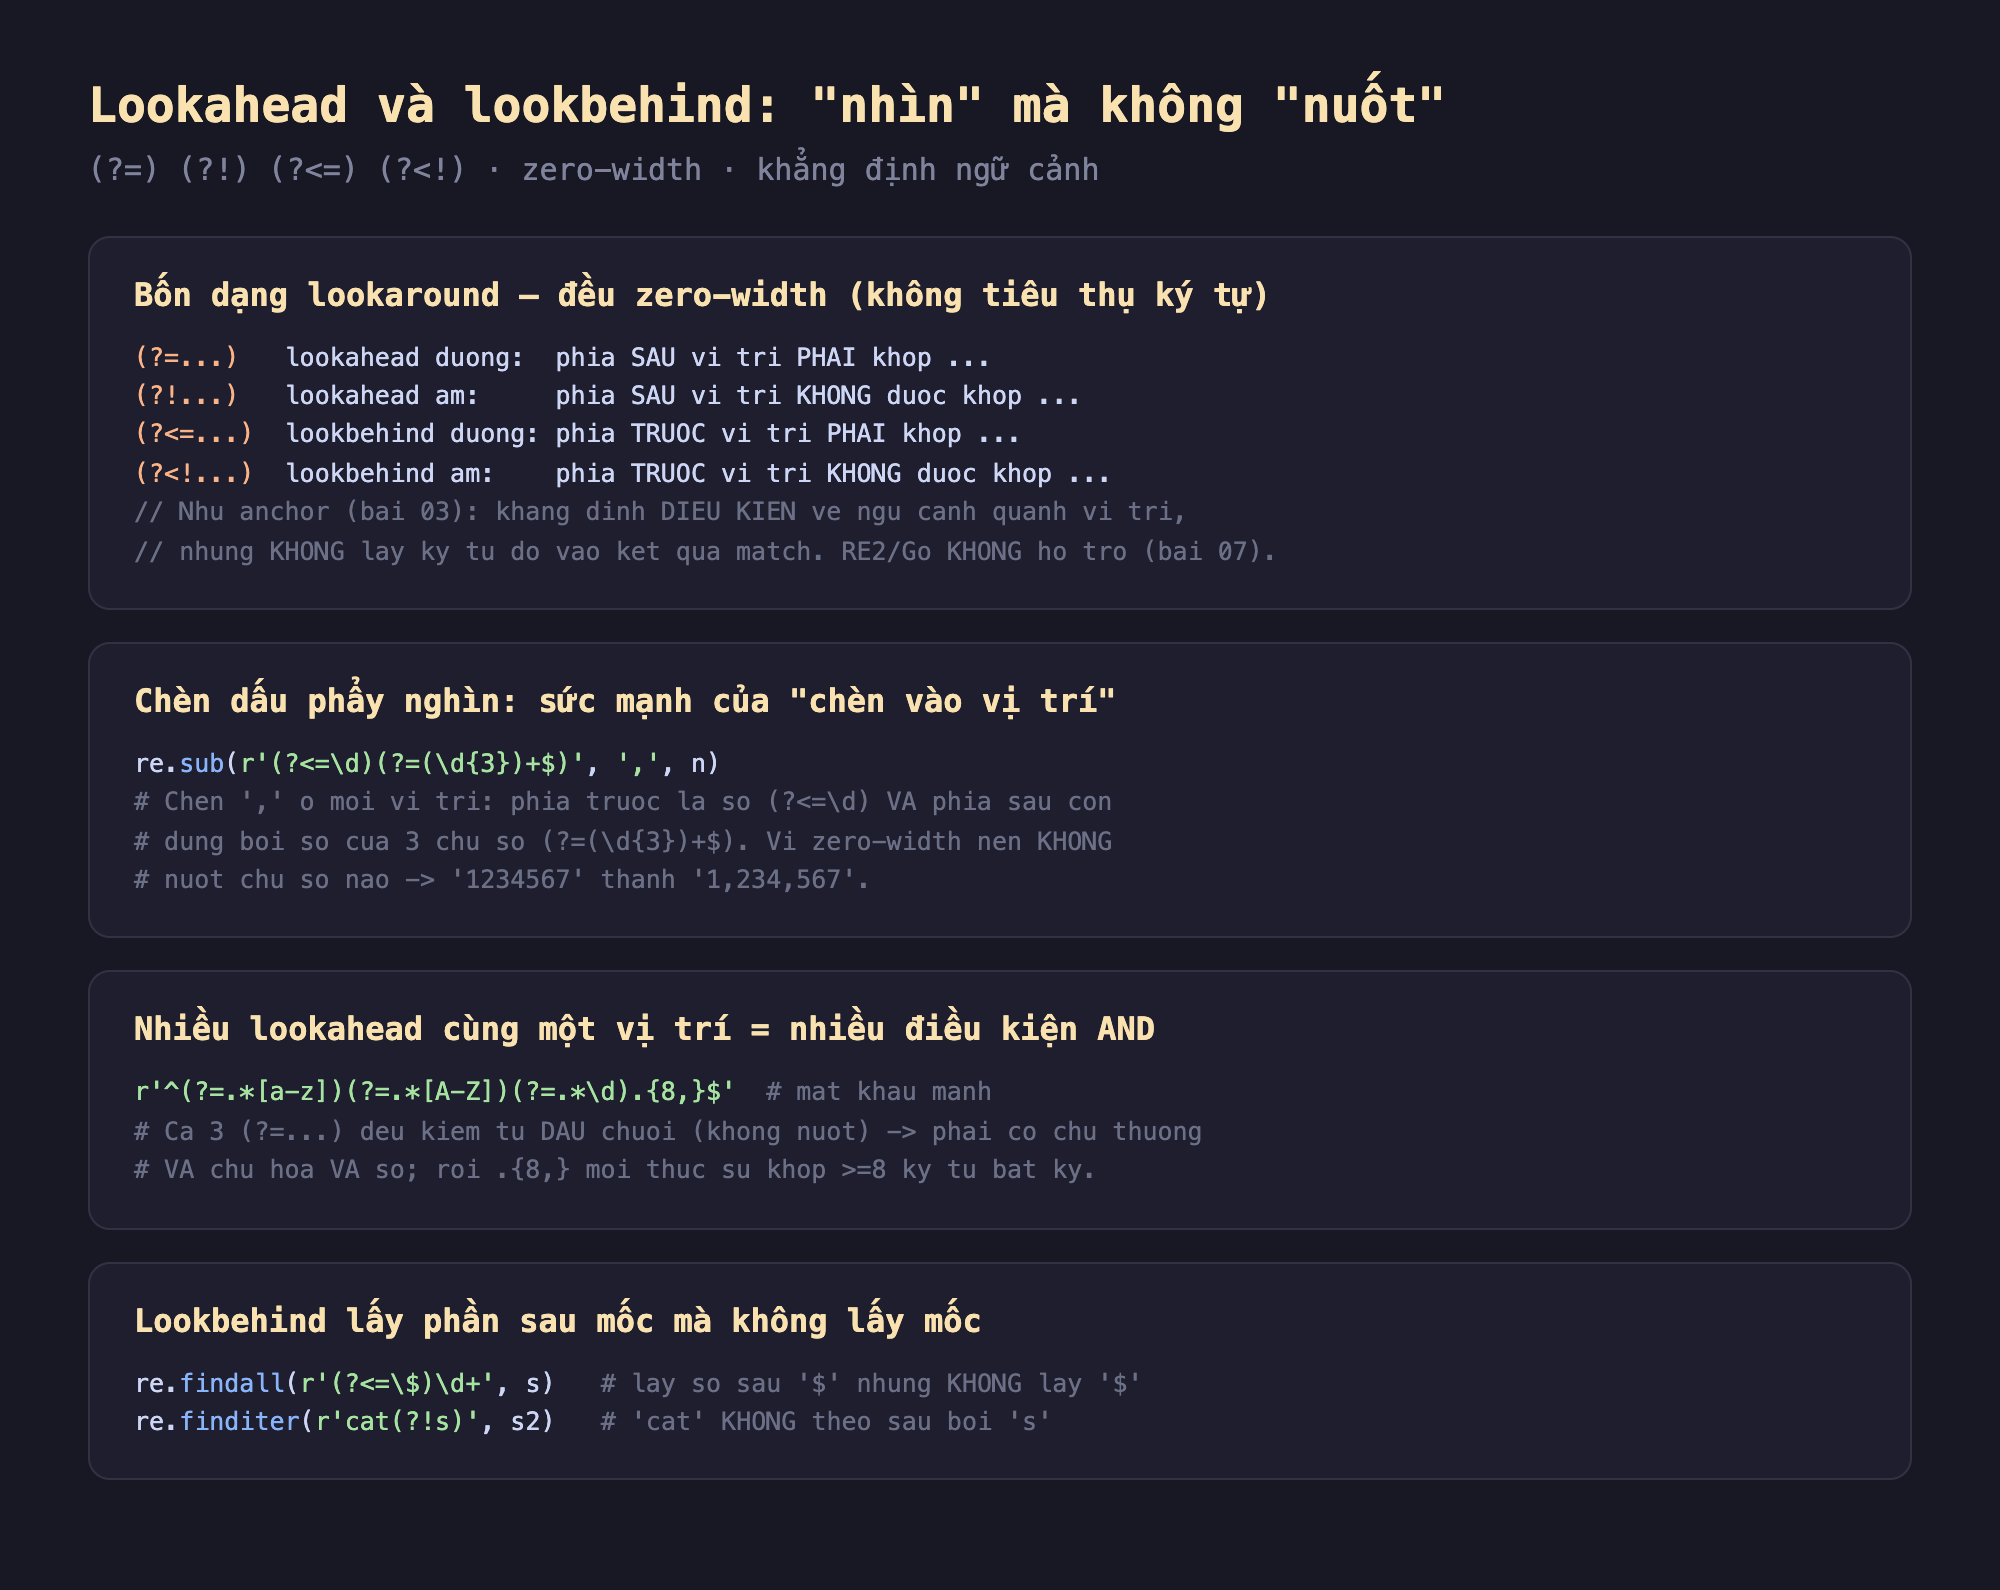
Hình 1: Bốn dạng lookaround ((?=), (?!), (?<=), (?<!)) đều zero-width — khẳng định điều kiện về ngữ cảnh quanh vị trí mà không lấy ký tự vào kết quả; dùng để chèn phẩy nghìn, kiểm nhiều điều kiện cùng vị trí, lấy phần sau một mốc mà bỏ mốc.
Đo thật: bốn ứng dụng kinh điển
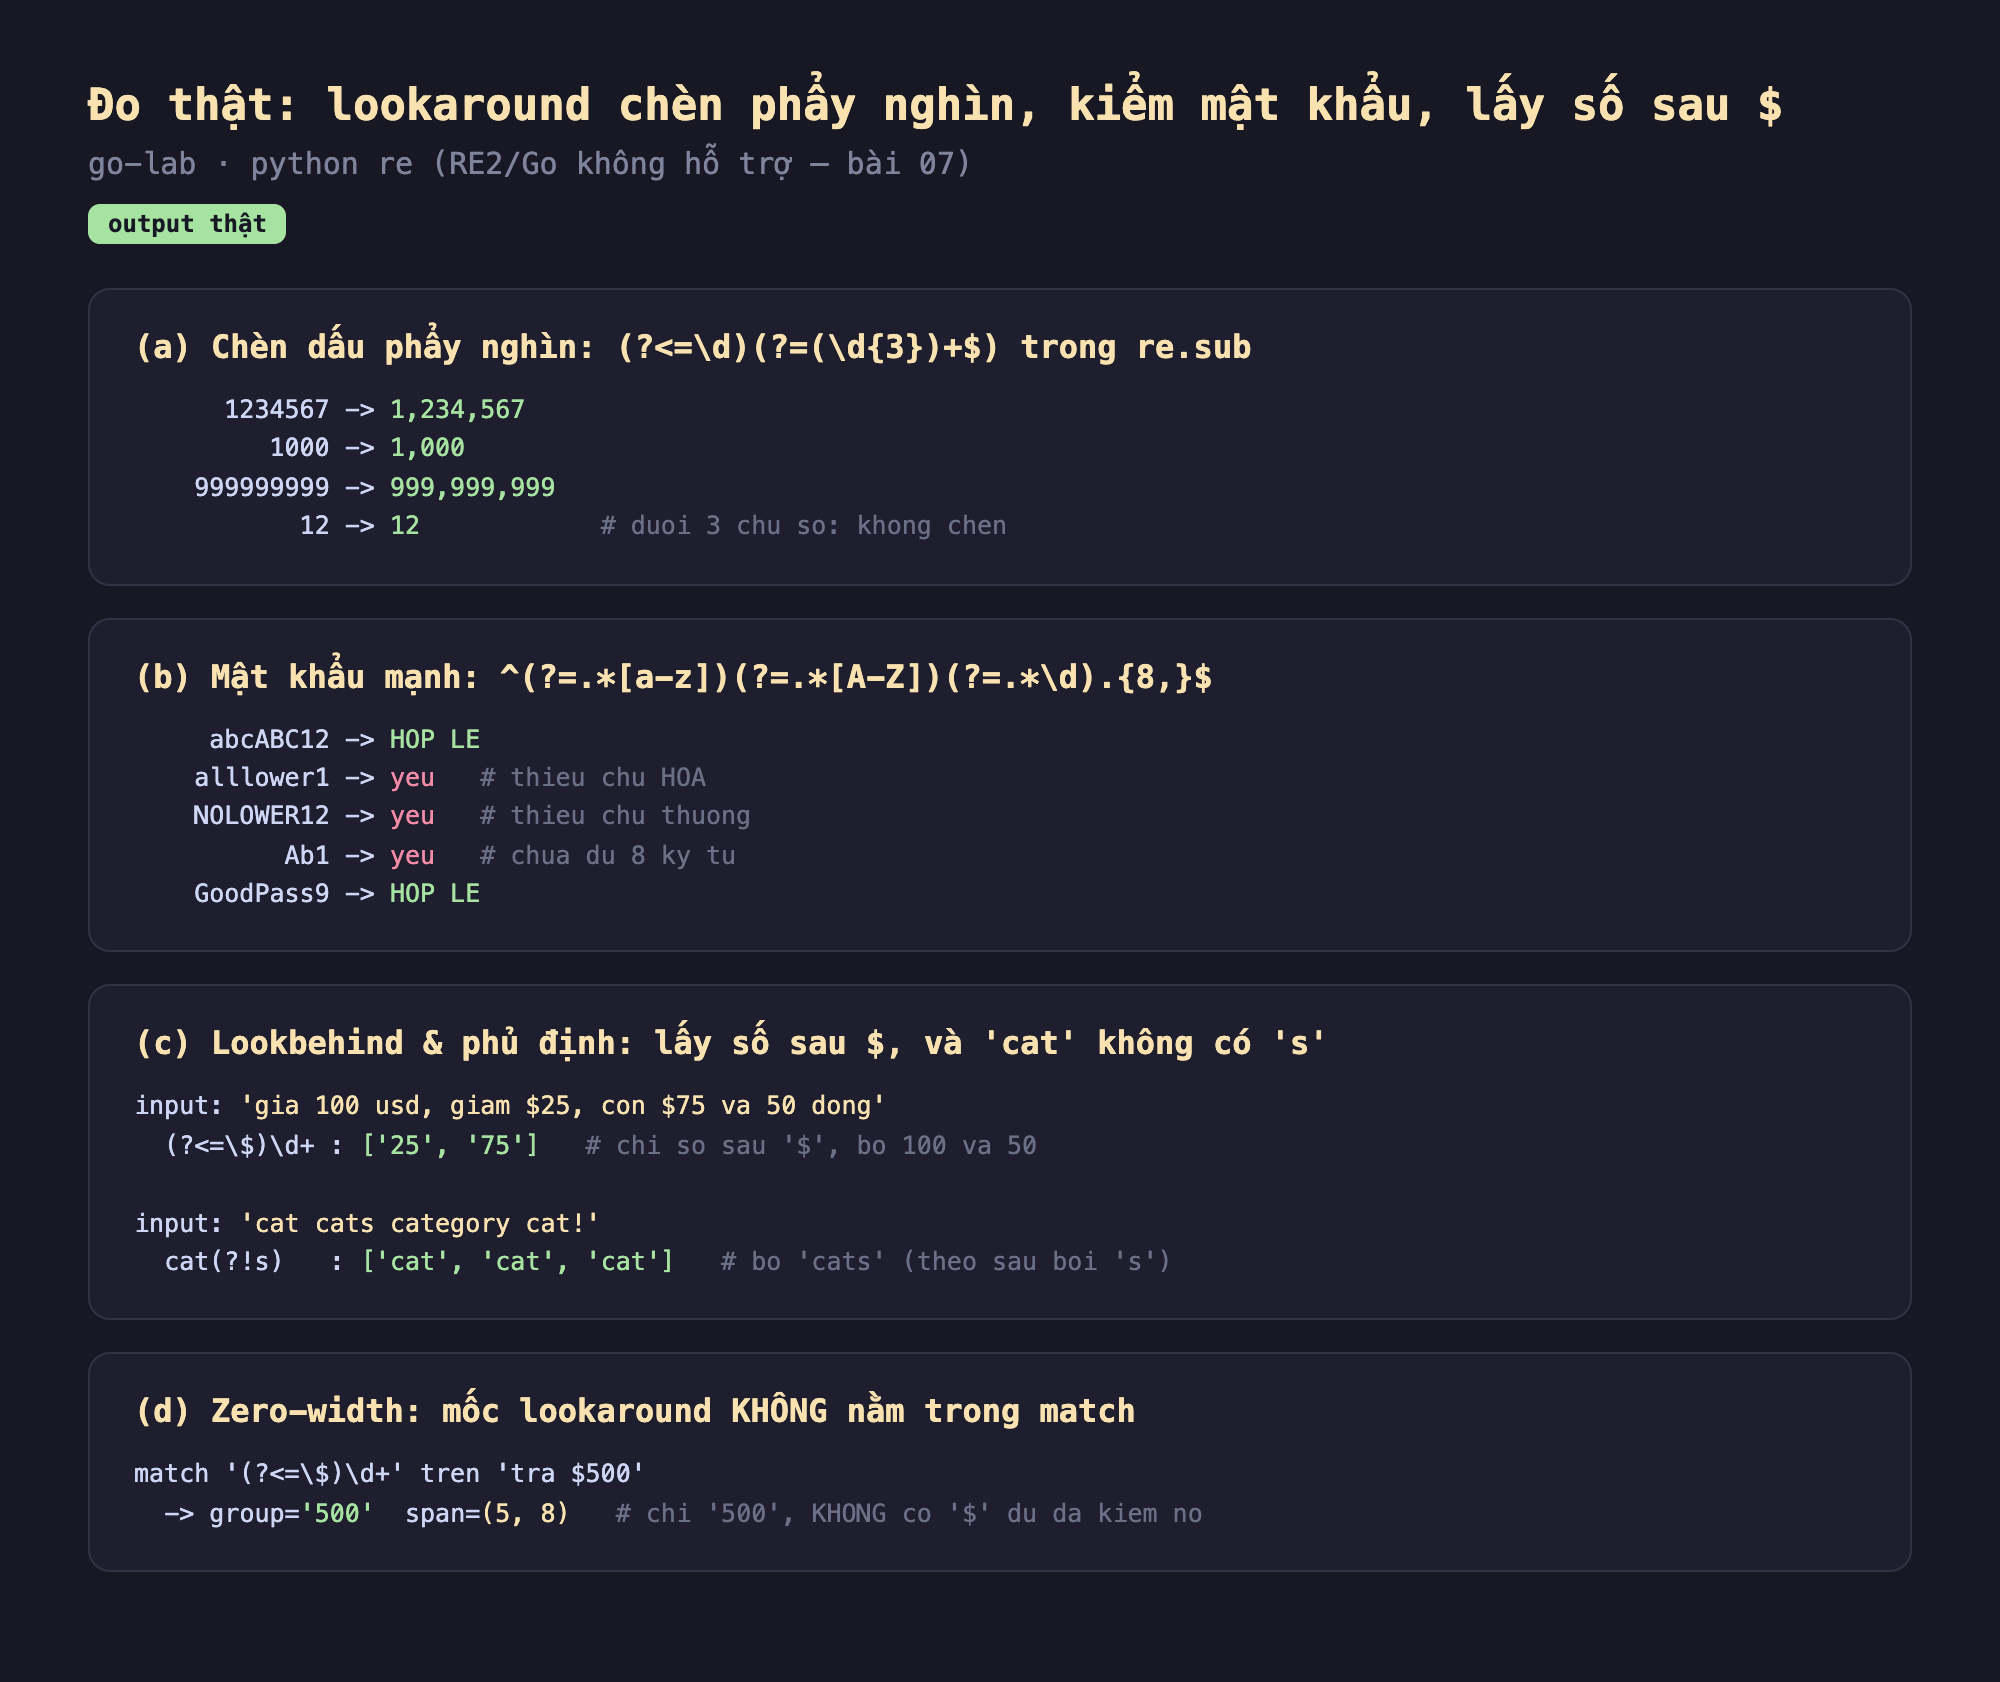
Hình 2: Chạy thật — (a) chèn phẩy nghìn: 1234567→1,234,567, 12→12 (không đủ 3 số); (b) mật khẩu mạnh: abcABC12 HỢP LỆ, alllower1/NOLOWER12/Ab1 yếu; (c) (?<=\$)\d+ cho ['25','75'] (bỏ 100, 50), cat(?!s) cho ['cat','cat','cat'] (bỏ cats); (d) match (?<=\$)\d+ trên tra $500 cho group='500' span=(5,8) — không gồm $.
- (a) Chèn phẩy nghìn — sức mạnh "chèn vào vị trí":
re.sub(r'(?<=\d)(?=(\d{3})+$)', ',', n)chèn dấu,ở mỗi vị trí mà phía trước là một chữ số ((?<=\d)) và phía sau còn đúng bội số của 3 chữ số tới cuối ((?=(\d{3})+$)). Vì lookaround zero-width nên không nuốt chữ số nào —1234567thành1,234,567,1000thành1,000, còn12giữ nguyên (không đủ 3 số). Không có lookaround thì việc này phải làm bằng code. - (b) Mật khẩu mạnh — nhiều điều kiện AND cùng vị trí:
^(?=.*[a-z])(?=.*[A-Z])(?=.*\d).{8,}$. Ba lookahead đều đứng ở đầu chuỗi và đều zero-width, nên chúng chồng lên nhau như ba điều kiện AND: phải có chữ thường, VÀ chữ hoa, VÀ chữ số; rồi.{8,}$mới thực sự khớp ≥8 ký tự. Kết quả đo:abcABC12vàGoodPass9hợp lệ;alllower1(thiếu hoa),NOLOWER12(thiếu thường),Ab1(chưa đủ 8) đều yếu. - (c) Lookbehind và phủ định:
(?<=\$)\d+lấy['25','75']— chỉ số sau dấu$, bỏ qua100và50không có$. Còncat(?!s)(lookahead âm) cho['cat','cat','cat']— khớpcat,category,cat!nhưng bỏcatsvì nó theo sau bởis. - (d) Zero-width, đo bằng span: match
(?<=\$)\d+trêntra $500chogroup='500'vớispan=(5,8)— chỉ ba ký tự500, không gồm$dù mẫu đã kiểm tra sự có mặt của nó. Đây là bằng chứng rõ nhất cho tính "nhìn mà không nuốt".
Đánh đổi cần cân nhắc
Lookaround làm mẫu ngắn nhưng khó đọc — cân với việc tách ra code. Một mẫu như ^(?=.*[a-z])(?=.*[A-Z])(?=.*\d).{8,}$ gọn, nhưng người đọc sau bạn phải giải mã từng lookahead. Với logic kiểm tra phức tạp (mật khẩu nhiều luật), đôi khi ba dòng code rõ ràng (kiểm từng điều kiện riêng) dễ bảo trì hơn một regex "thông minh". Dùng lookaround khi nó thực sự gọn hơn và vẫn đọc được, không phải để khoe.
Lookbehind có giới hạn độ dài ở nhiều engine. Python (module re cũ) yêu cầu lookbehind độ dài cố định — (?<=\d{3}) được nhưng (?<=\d+) thì báo lỗi, vì engine cần biết lùi lại bao nhiêu ký tự. Module regex mới (bên thứ ba) và .NET cho lookbehind độ dài thay đổi, còn JavaScript mới hỗ trợ gần đây. Đừng cho là lookbehind luôn dùng được mọi mẫu — kiểm tra engine của bạn.
Lookaround = mất RE2 = mất đảm bảo ReDoS. Đây là đánh đổi lớn nhất, nối thẳng phần 6-7: dùng lookaround nghĩa là bạn phải dùng engine backtracking, tức là mất lá chắn tuyến tính. Nếu regex chạy trên đầu vào không tin cậy, hãy cân nhắc: điều kiện lookaround này có đáng đánh đổi rủi ro ReDoS không? Thường có cách viết lại không cần lookaround (ví dụ chèn phẩy nghìn bằng code định dạng số có sẵn), an toàn hơn nhiều.
Ba ý mang về
- Lookaround khẳng định ngữ cảnh mà không nuốt ký tự (zero-width): đo thật match
(?<=\$)\d+trên$500chospan=(5,8)chỉ gồm500, không có$— bốn dạng(?=),(?!),(?<=),(?<!)nhìn trước/lùi để kiểm điều kiện quanh vị trí. - Sức mạnh: chèn vào vị trí và AND nhiều điều kiện: đo thật
(?<=\d)(?=(\d{3})+$)chèn phẩy nghìn1234567→1,234,567, và ba lookahead cùng vị trí kiểm mật khẩu mạnh trong một mẫu;(?<=\$)\d+lấy số sau$,cat(?!s)bỏcats. - Cái giá là mất RE2 và đảm bảo tuyến tính: lookaround buộc dùng engine backtracking (RE2/Go từ chối — phần 7), mở lại rủi ro ReDoS; lookbehind còn giới hạn độ dài ở nhiều engine — cân nhắc viết lại bằng code khi chạy trên đầu vào không tin cậy.
Nguồn
- Python docs — re (lookahead, lookbehind assertions): https://docs.python.org/3/library/re.html
- MDN — Lookahead / lookbehind assertions: https://developer.mozilla.org/en-US/docs/Web/JavaScript/Guide/Regular_expressions/Assertions
- Jeffrey Friedl — Mastering Regular Expressions (lookaround): https://www.oreilly.com/library/view/mastering-regular-expressions/0596528124/
Phần sau ta đối mặt vấn đề mà lập trình viên Việt gặp thường xuyên: Unicode trong regex — vì sao . có thể khớp nửa ký tự, \w và chữ có dấu, byte vs rune, và cách khớp tiếng Việt cho đúng.
