Tới giờ cả loạt bài chủ yếu bàn về tìm — regex khớp hay không, khớp ở đâu. Nhưng sức mạnh thực tế lớn nhất của regex trong công việc hằng ngày là biến đổi: trích một phần dữ liệu ra rồi dựng lại thành định dạng khác. Đổi 2026-09-22 thành 22/09/2026, tách họ và tên rồi đảo thứ tự, lấy tên miền từ URL — tất cả dựa trên hai cơ chế: nhóm bắt (capture group) để cắt chuỗi thành từng phần, và thay thế (substitution) để dán các phần đó lại theo ý mình. Bài này (phần 10 loạt Regex) đo thật cả hai bằng python re và sed, và làm rõ một điểm hay nhầm: \1 trong mẫu và \1 trong chuỗi thay thế là hai thứ khác nhau.
Nhóm bắt: cắt chuỗi thành từng phần
Đặt một phần mẫu trong ngoặc (...) là bắt (capture) đoạn khớp được vào một nhóm đánh số 1, 2, 3... theo thứ tự dấu ( mở. Sau khi khớp, bạn lấy từng nhóm ra bằng group(n) hoặc cả tuple bằng groups(). Có ba biến thể quan trọng:
- Nhóm bắt
(...): đánh số tự động, đọc bằnggroup(1). - Nhóm đặt tên
(?P<ten>...)(Python; các engine khác dùng(?<ten>...)): đọc bằnggroup('ten')hoặcgroupdict()— rõ nghĩa hơn số, và không vỡ khi bạn chèn nhóm mới vào giữa. - Nhóm không bắt
(?:...): chỉ gom để áp quantifier hoặc|, không tạo nhóm và không được đánh số.
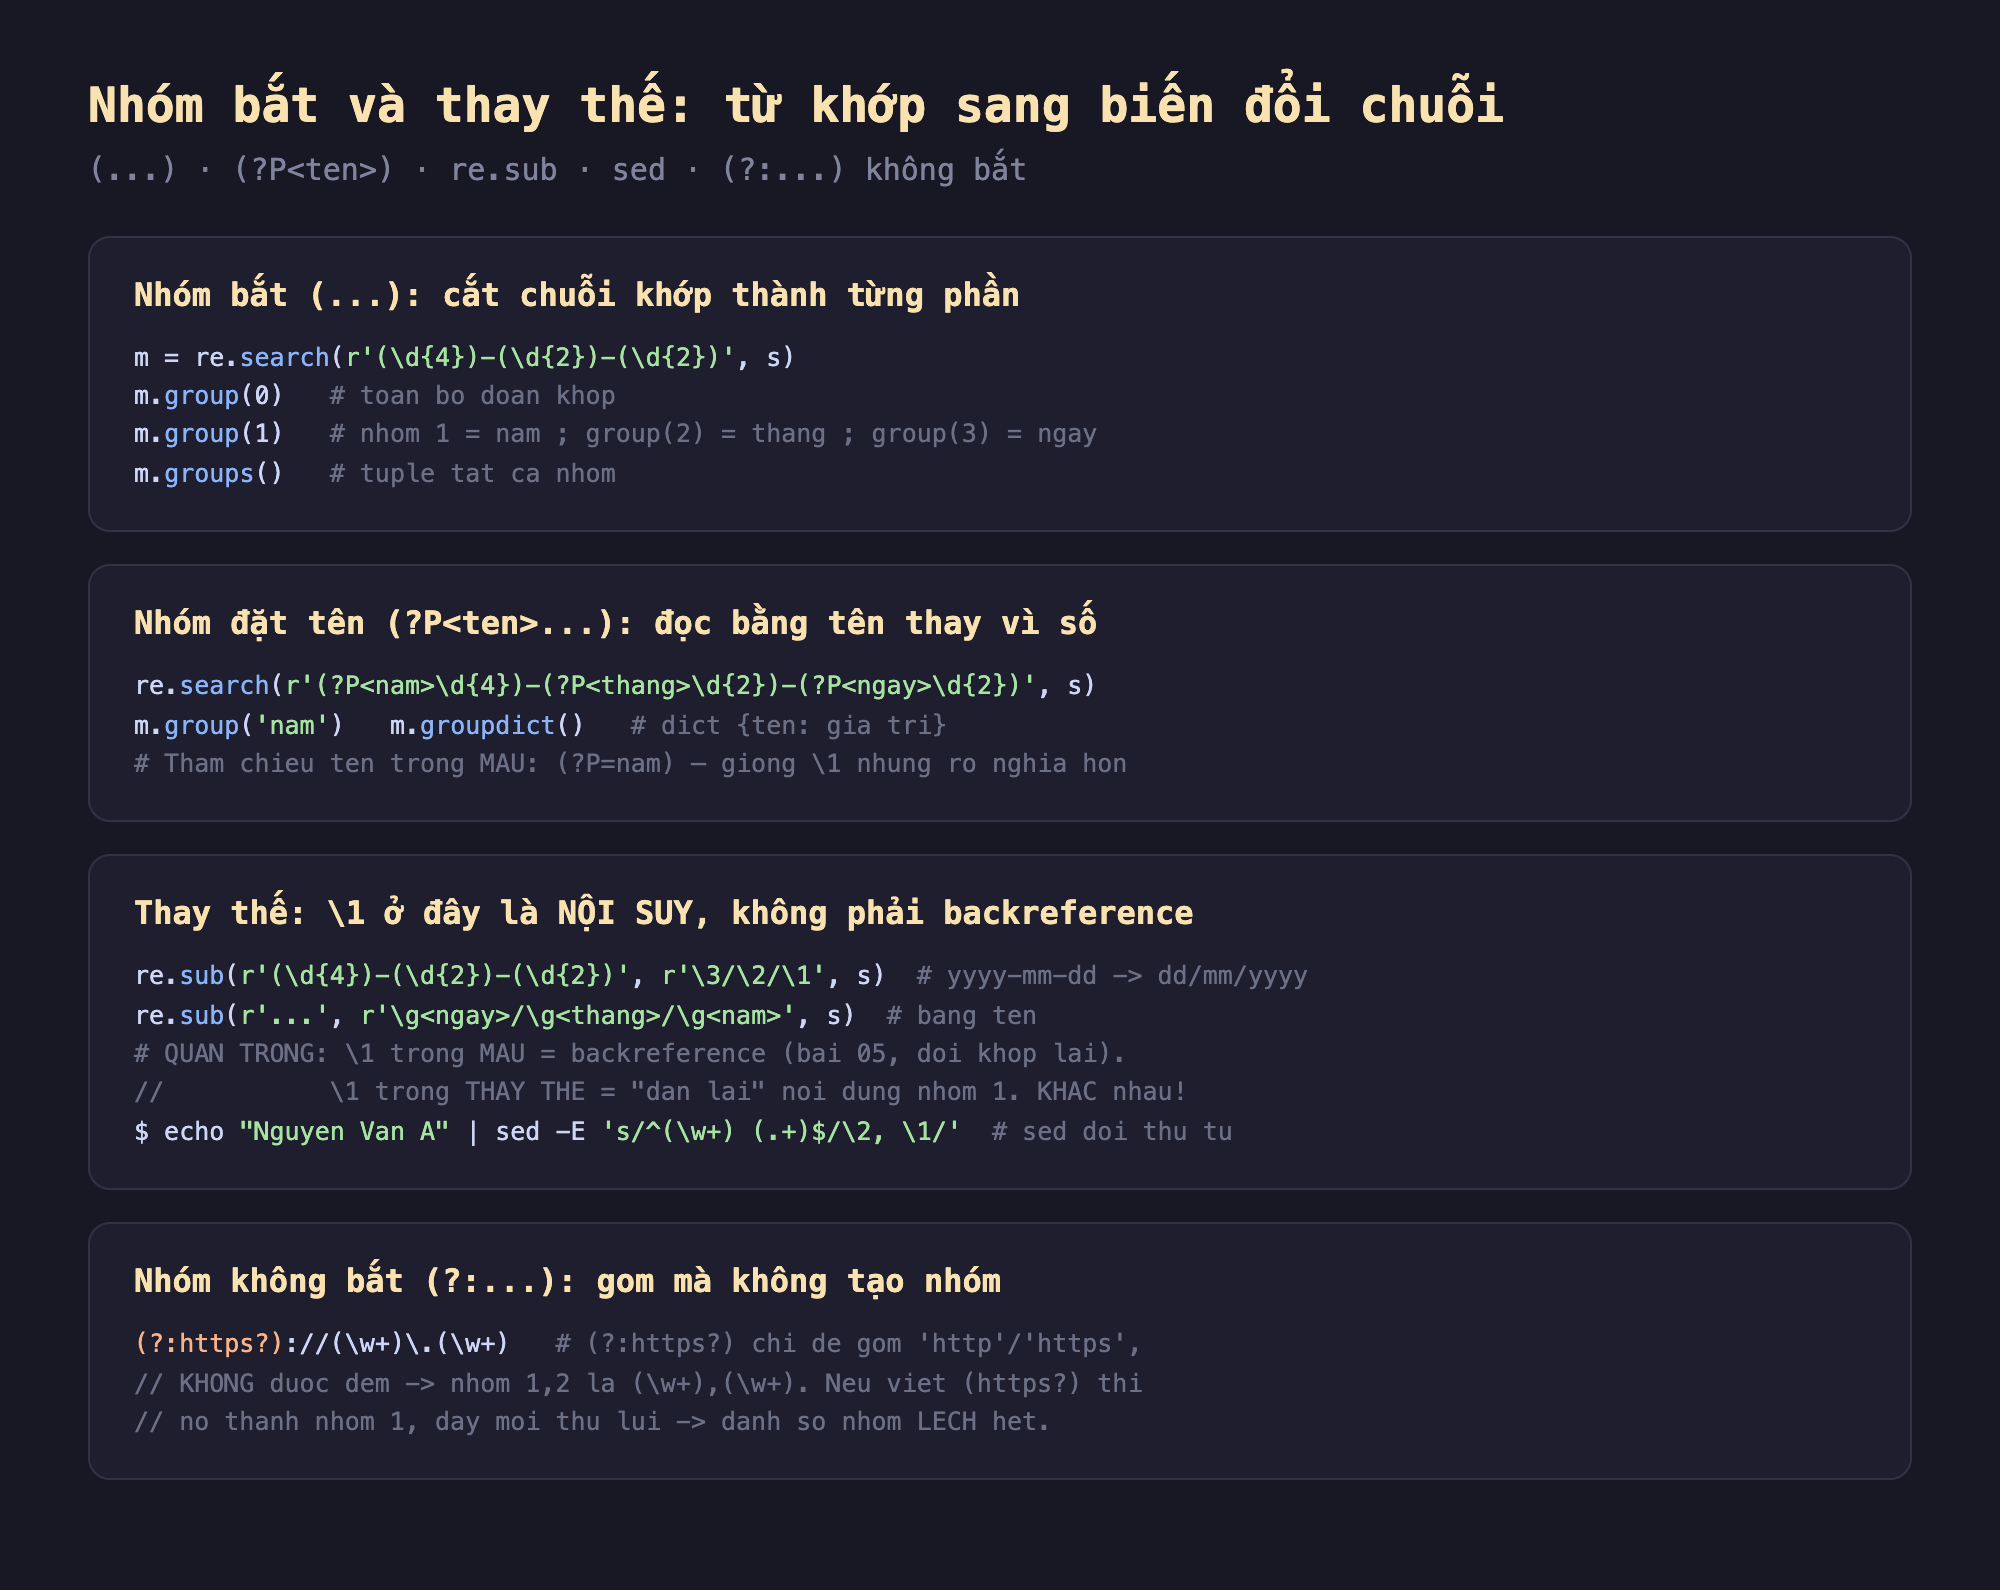
Hình 1: Nhóm bắt (...) cắt chuỗi thành phần đọc bằng group(n)/groups(); nhóm đặt tên (?P<ten>...) đọc bằng tên; thay thế re.sub/sed dán lại nội dung nhóm bằng \1 (nội suy, khác backreference trong mẫu); nhóm không bắt (?:...) gom mà không đánh số.
Đo thật: trích, đổi định dạng, và đếm nhóm
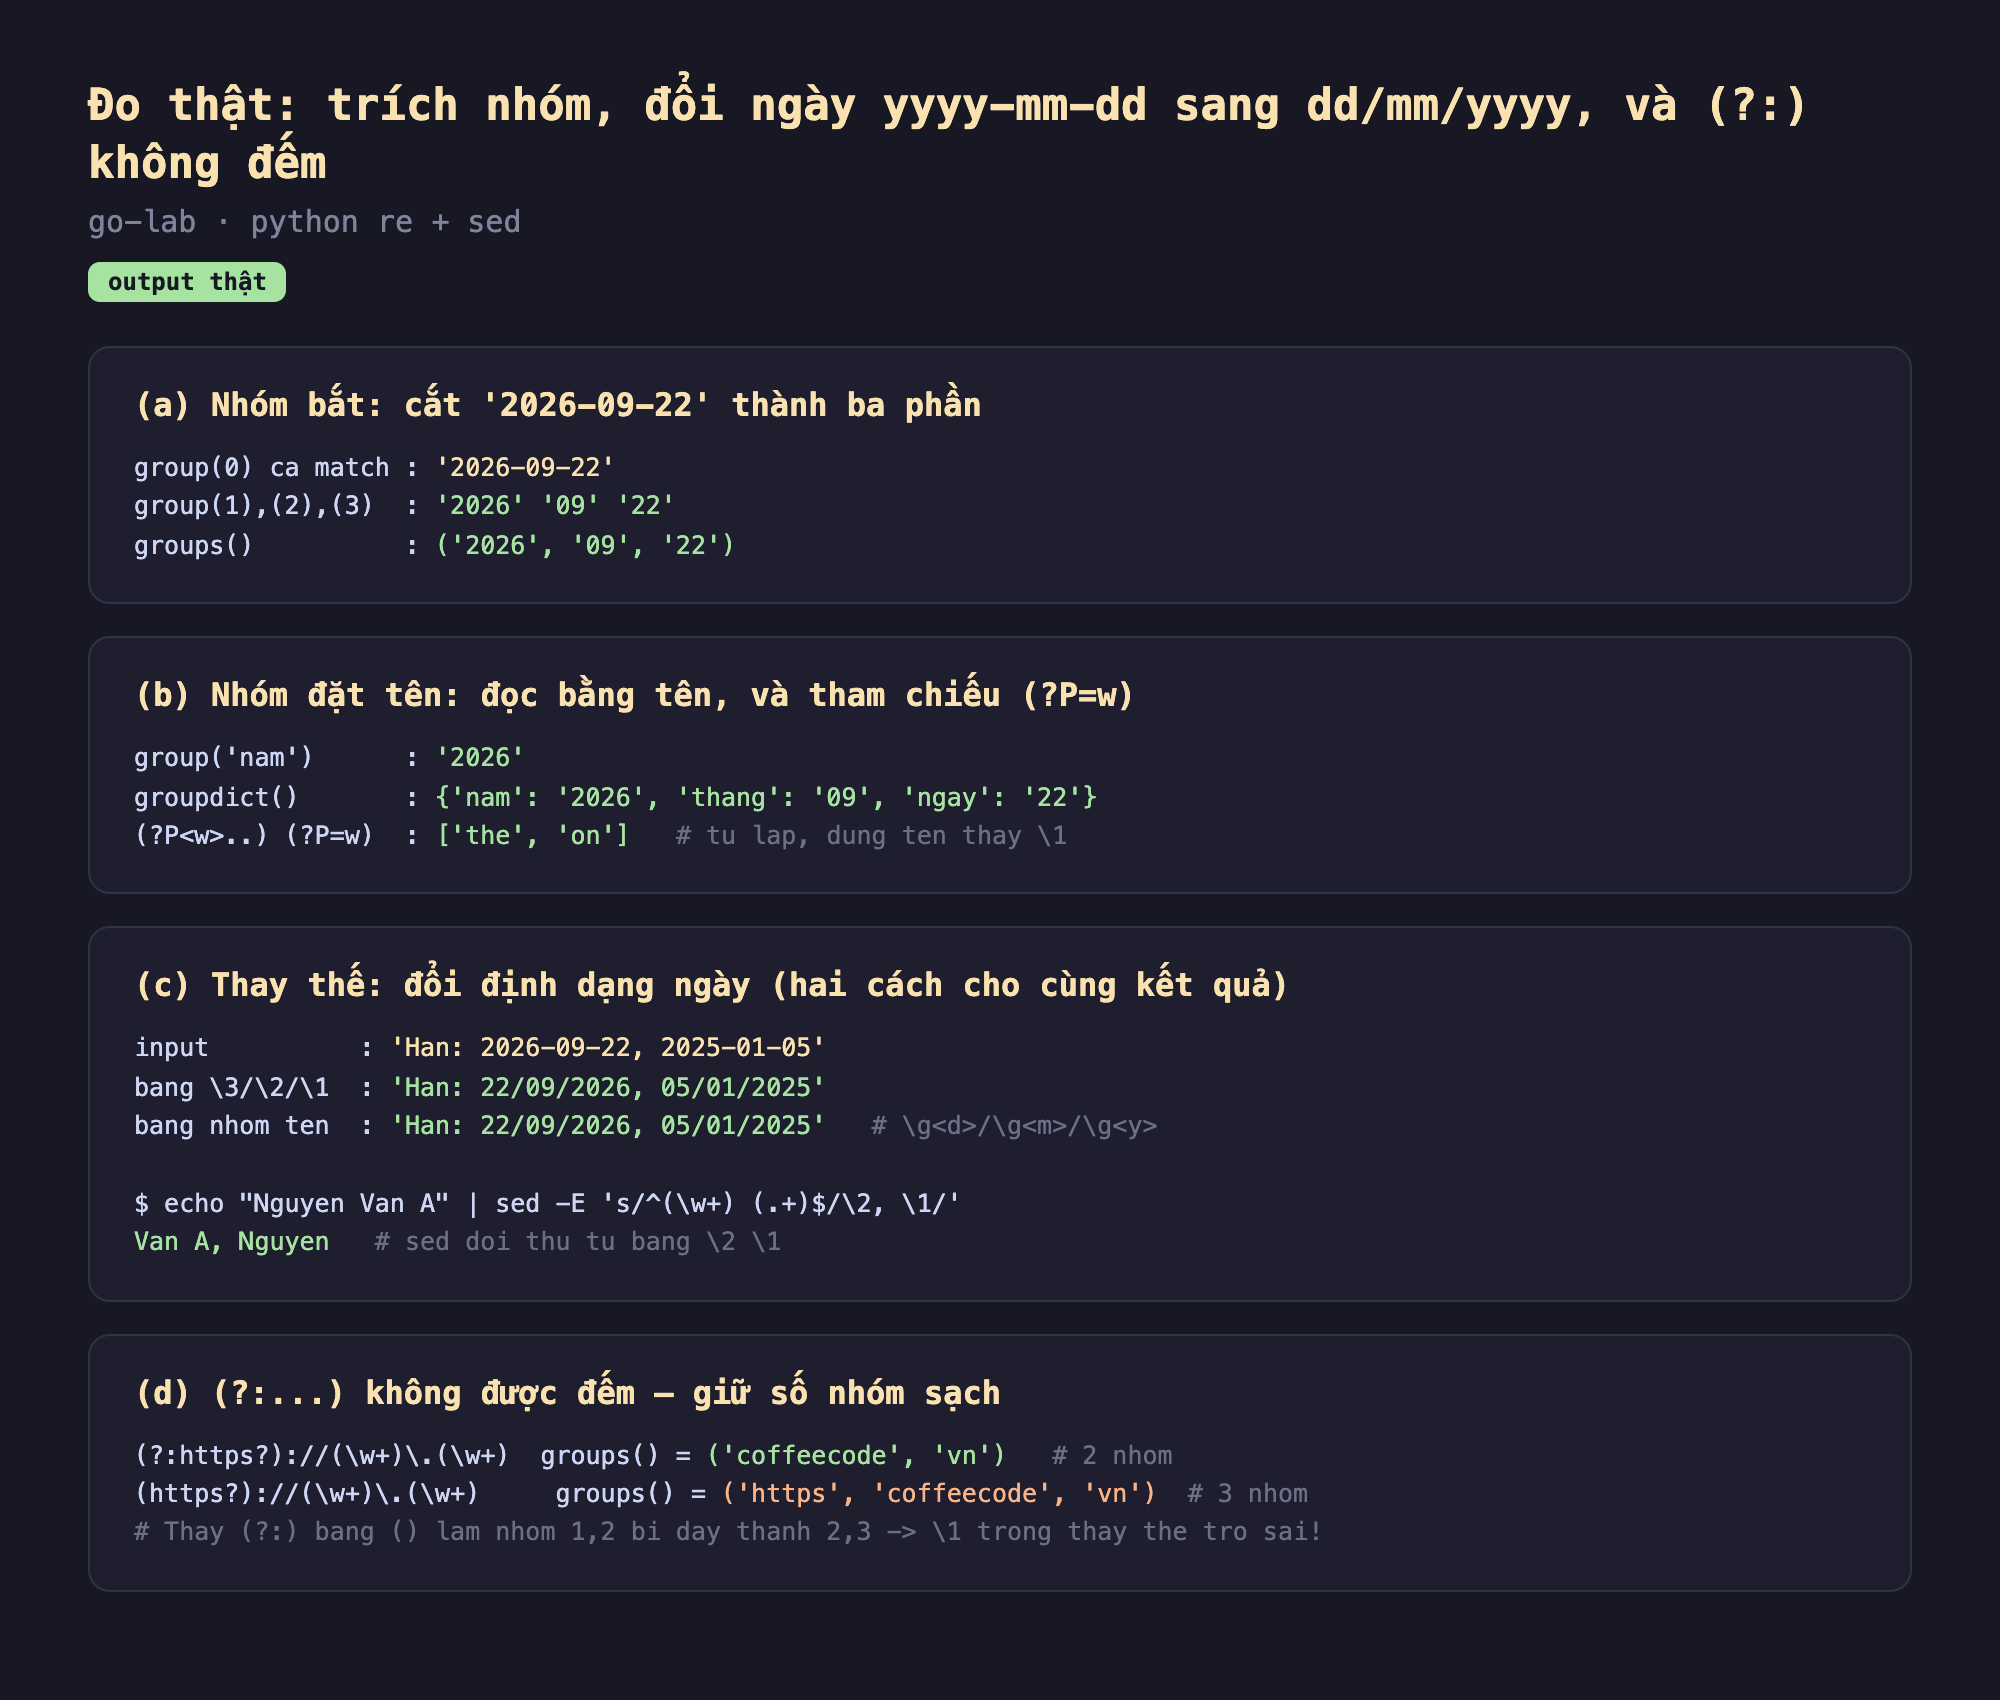
Hình 2: Chạy thật — (a) nhóm bắt cắt 2026-09-22 thành ('2026','09','22'); (b) nhóm đặt tên cho groupdict()={'nam':'2026',...}, (?P<w>..) (?P=w) bắt từ lặp ['the','on']; (c) re.sub đổi ngày sang '22/09/2026, 05/01/2025' (bằng \3/\2/\1 hoặc tên), sed đổi Nguyen Van A→Van A, Nguyen; (d) (?:https?) cho 2 nhóm, (https?) cho 3 nhóm.
- (a) Nhóm bắt cắt chuỗi:
(\d{4})-(\d{2})-(\d{2})trên2026-09-22chogroup(0)='2026-09-22'(cả match) vàgroups()=('2026','09','22')(ba phần riêng). Đây là cách trích cấu trúc ra khỏi một chuỗi phẳng. - (b) Nhóm đặt tên rõ nghĩa hơn:
(?P<nam>\d{4})-(?P<thang>\d{2})-(?P<ngay>\d{2})chogroupdict()={'nam':'2026','thang':'09','ngay':'22'}— đọc bằng tên thay vì đếm số. Và(?P<w>\w+) (?P=w)bắt từ lặp['the','on']bằng cách tham chiếu tên(?P=w)(đây là backreference trong mẫu, kiểu phần 5, nhưng dùng tên cho dễ đọc). - (c) Thay thế biến đổi chuỗi:
re.sub(r'(\d{4})-(\d{2})-(\d{2})', r'\3/\2/\1', s)đổi mọi ngàyyyyy-mm-ddthànhdd/mm/yyyy→'Han: 22/09/2026, 05/01/2025'. Cùng kết quả khi dùng nhóm tên\g<d>/\g<m>/\g<y>. Vớised,echo "Nguyen Van A" | sed -E 's/^(\w+) (.+)$/\2, \1/'choVan A, Nguyen— đảo thứ tự bằng\2 \1. - (d)
(?:...)giữ số nhóm sạch:(?:https?)://(\w+)\.(\w+)chogroups()=('coffeecode','vn')— chỉ 2 nhóm, vì(?:https?)không được đếm. Nhưng nếu viết(https?)://(\w+)\.(\w+)thì thành 3 nhóm('https','coffeecode','vn'). Điều này quan trọng: nếu bạn đang dùng\1để chỉ tên miền mà lỡ đổi(?:)thành(), mọi số nhóm bị đẩy lùi một bậc và\1trỏ sai.
Điểm hay nhầm: \1 trong mẫu vs trong thay thế
Đây là chỗ dễ lẫn nhất, nối tiếp phần 5. \1 trong mẫu là backreference: "khớp lại đúng chuỗi mà nhóm 1 đã bắt" — nó phá vỡ tính regular và cần backtracking ((\w+) \1 tìm từ lặp). \1 trong chuỗi thay thế hoàn toàn khác: nó chỉ là nội suy — "dán lại nội dung nhóm 1 vào đây" — không liên quan gì tới backtracking, chỉ là ghép chuỗi. Cùng ký hiệu, hai vai trò tách biệt: một cái là điều kiện khớp, một cái là công thức dựng chuỗi kết quả.
Đánh đổi cần cân nhắc
Nhóm đặt tên đáng dùng cho mẫu phức tạp — vì số nhóm dễ vỡ. Khi mẫu có nhiều nhóm và bạn còn phải chỉnh sửa nó, dùng \1, \2 là mời lỗi: chèn một nhóm mới vào giữa là mọi số sau đó lệch, và không có lỗi nào báo — chỉ ra kết quả sai. Nhóm đặt tên (?P<...>) miễn nhiễm chuyện này: thêm nhóm không đổi tên nhóm cũ. Với mẫu quá 2-3 nhóm hoặc mẫu sẽ còn sửa, ưu tiên đặt tên.
Nhóm bắt không cần thiết làm chậm và tốn bộ nhớ — dùng (?:...). Mỗi nhóm bắt buộc engine ghi nhớ vị trí bắt đầu/kết thúc của đoạn khớp để trả về sau. Nếu bạn dùng () chỉ để gom (áp | hay quantifier) mà không cần trích, hãy dùng (?:...) — nó bỏ phần ghi nhớ đó, nhanh hơn chút và giữ số nhóm sạch. Thói quen "mọi ngoặc đều là (?:) trừ khi thực sự cần bắt" giúp mẫu vừa nhanh vừa dễ bảo trì.
Cú pháp nhóm tên và thay thế khác nhau giữa các công cụ. Python dùng (?P<ten>) và \g<ten>; JavaScript/.NET/PCRE dùng (?<ten>) và $<ten>/${ten}; sed cơ bản cần escape ngoặc \(...\) (hoặc -E cho ngoặc thường) và dùng \1 khi thay thế. Đừng bê nguyên mẫu từ ngôn ngữ này sang ngôn ngữ khác — đặc biệt phần thay thế, nơi \1 (sed/Python) và $1 (JS/PCRE) khác nhau.
Ba ý mang về
- Nhóm bắt cắt chuỗi, thay thế dán lại: đo thật
(\d{4})-(\d{2})-(\d{2})trích('2026','09','22'), rồire.subvới\3/\2/\1đổiyyyy-mm-ddthànhdd/mm/yyyy(22/09/2026),sedđảoNguyen Van A→Van A, Nguyen— regex biến đổi chứ không chỉ tìm. - Nhóm đặt tên bền hơn số,
(?:...)giữ số nhóm sạch: đo thậtgroupdict()đọc bằng tên;(?:https?)cho 2 nhóm còn(https?)cho 3 — thêm một cặp()thừa đẩy lệch mọi số nhóm và làm\1trỏ sai. \1trong mẫu vs trong thay thế là hai thứ:\1trong mẫu là backreference (khớp lại, cần backtracking — phần 5);\1trong chuỗi thay thế chỉ là nội suy (dán lại nội dung nhóm), không liên quan backtracking.
Nguồn
- Python docs — re (groups,
sub, named groups): https://docs.python.org/3/library/re.html - man7.org — sed(1) (back-references in replacement): https://man7.org/linux/man-pages/man1/sed.1.html
- MDN — Groups and backreferences: https://developer.mozilla.org/en-US/docs/Web/JavaScript/Guide/Regular_expressions/Groups_and_backreferences
Phần sau ta gom mọi thứ đã học thành nghệ thuật tối ưu regex: biên dịch một lần, neo và lớp phủ định để cắt backtracking, atomic group/possessive quantifier — và đo thật mỗi mẹo giúp nhanh lên bao nhiêu.
