Sau mười phần hiểu regex hoạt động thế nào, giờ là lúc dùng hiểu biết đó để làm nó nhanh. Tin tốt: một regex chậm hiếm khi do máy yếu — gần như luôn do mẫu viết chưa khéo, và sửa mẫu thường cho kết quả cải thiện gấp hàng nghìn lần chứ không phải vài phần trăm. Bài này (phần 11 loạt Regex) đo thật bốn kỹ thuật tối ưu, từ cái tiết kiệm khiêm tốn tới cái cứu bạn khỏi ReDoS. Nhưng trước hết, nguyên tắc số một: đo trước khi tối ưu — vì như bạn sẽ thấy, có mẹo giúp khổng lồ trong ca này lại vô ích hoặc phản tác dụng trong ca khác.
Bốn kỹ thuật
- Biên dịch một lần:
re.compilemẫu ngoài vòng lặp và tái dùng, đừng gọi mẫu thô mỗi lần. - Lớp phủ định
[^x]*thay cho lazy.*?: diễn đạt "tớixthì dừng" một cách tường minh. - Atomic group
(?>...)/ possessivea++: khóa kết quả của một phần khớp, cấm engine quay lui — chặn backtracking thảm họa (phần 6). - Neo (
\A,^): khi biết chuỗi phải bắt đầu ở đâu, neo mẫu để engine không thử mọi vị trí.
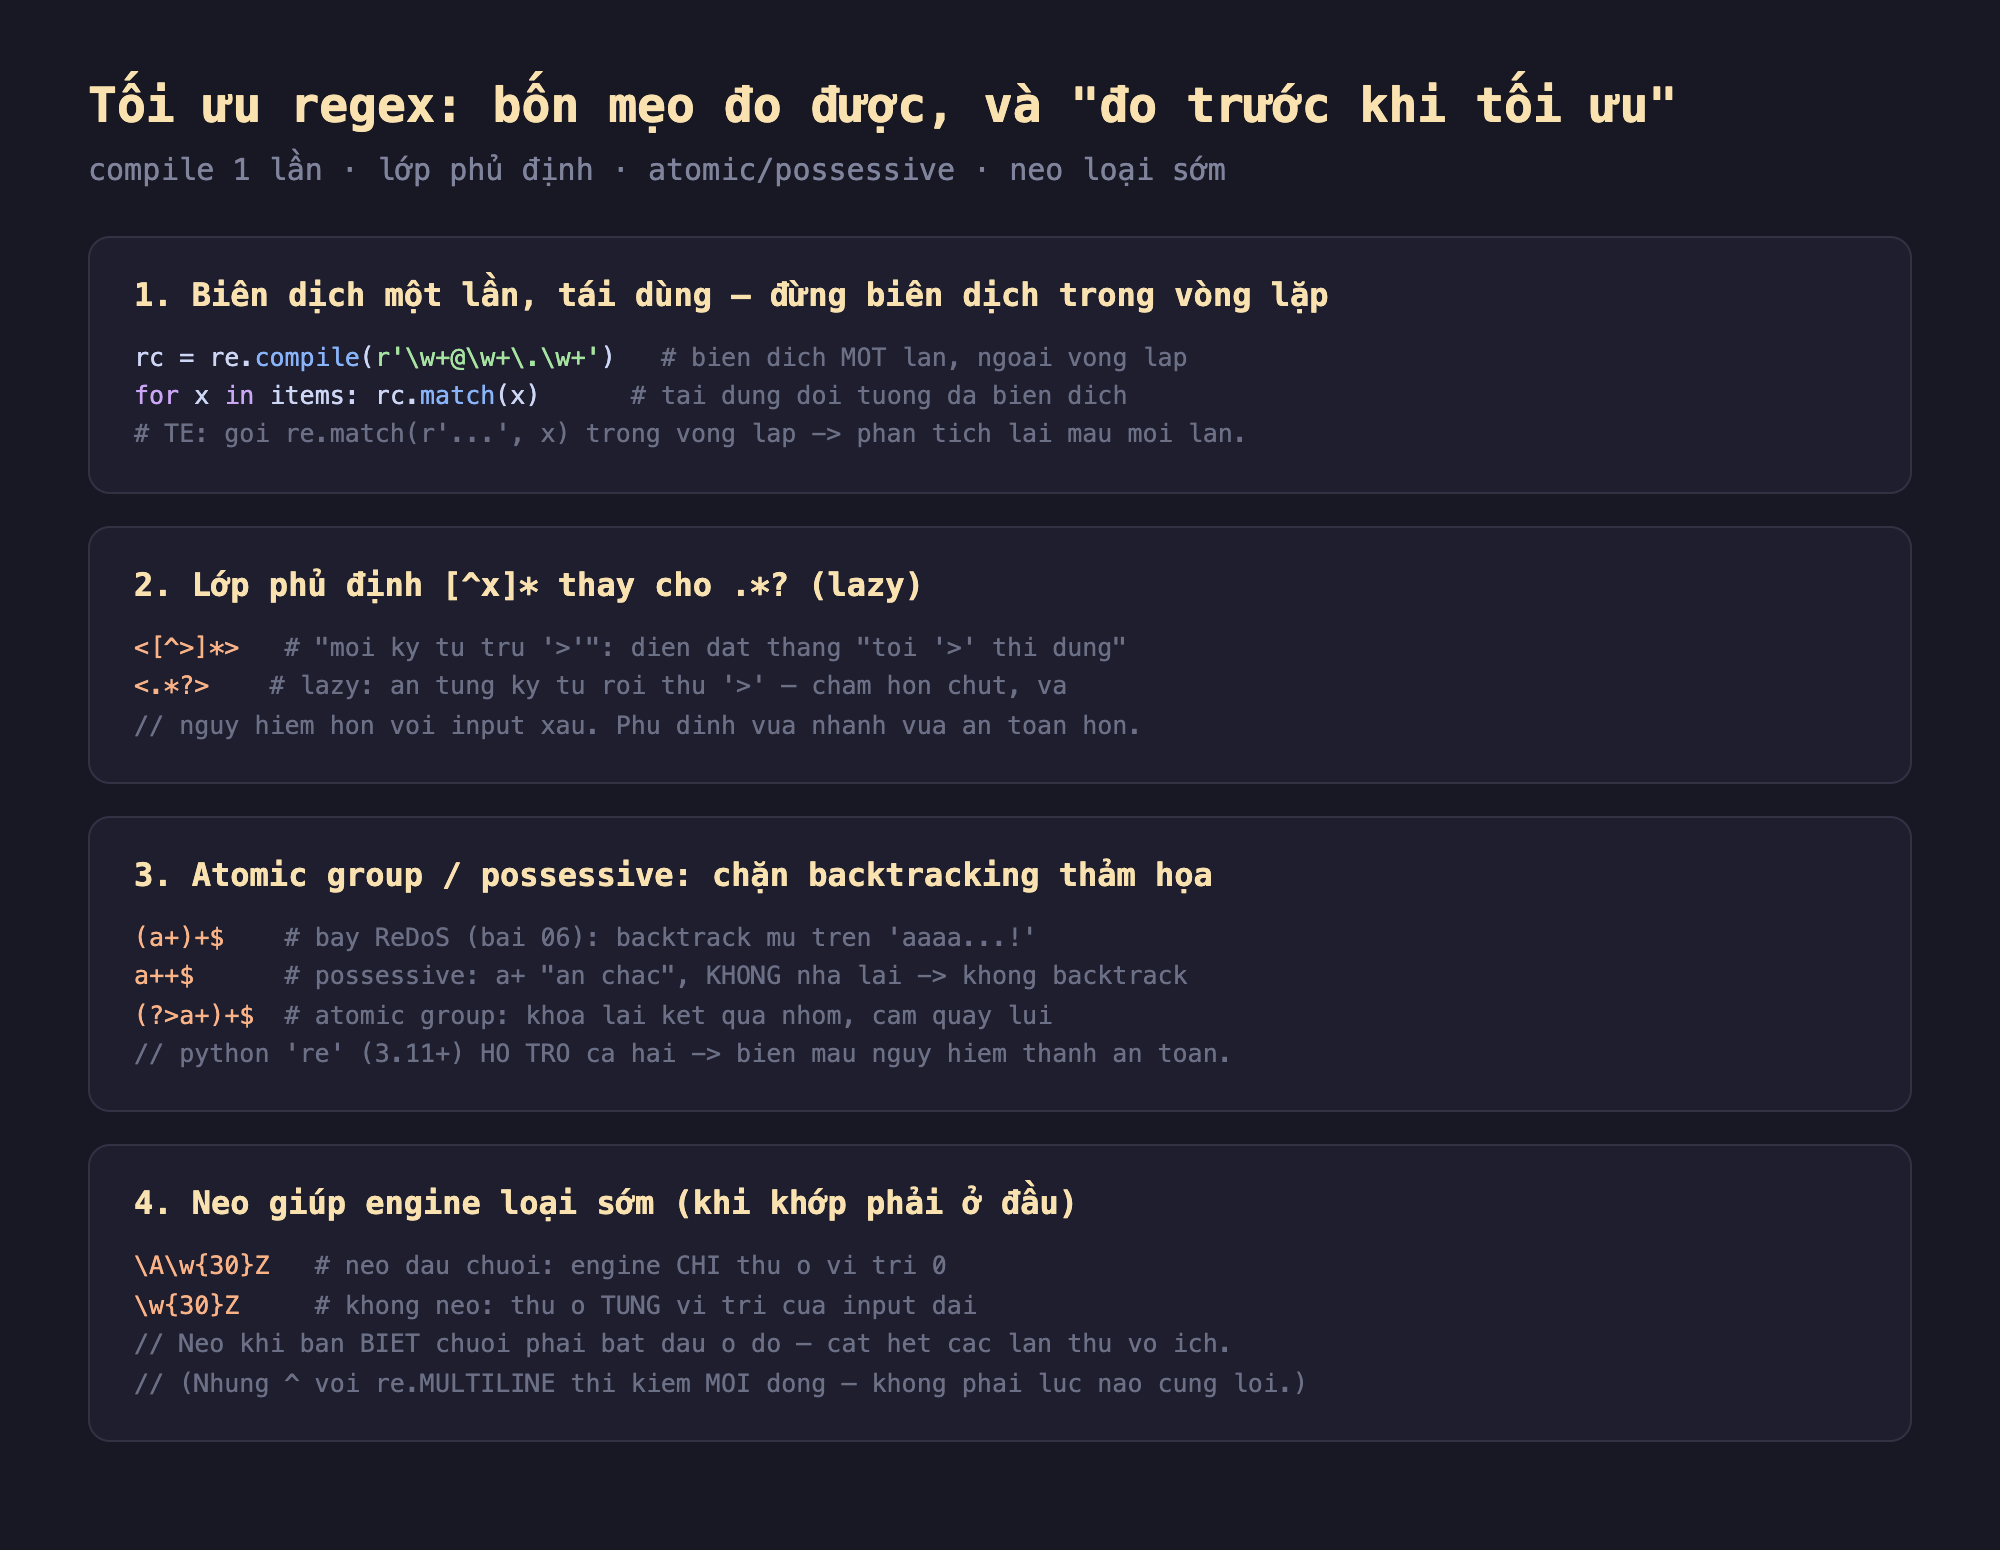
Hình 1: Bốn kỹ thuật tối ưu regex — biên dịch một lần rồi tái dùng; lớp phủ định [^>]* thay lazy .*?; atomic (?>...)/possessive a++ chặn backtracking; neo \A/^ để loại sớm khi biết chuỗi phải bắt đầu ở đó.
Đo thật: từ khiêm tốn tới khổng lồ
Mình đo thời gian bằng time.perf_counter trên Python 3.11 (lấy giá trị nhỏ nhất qua nhiều lần chạy):
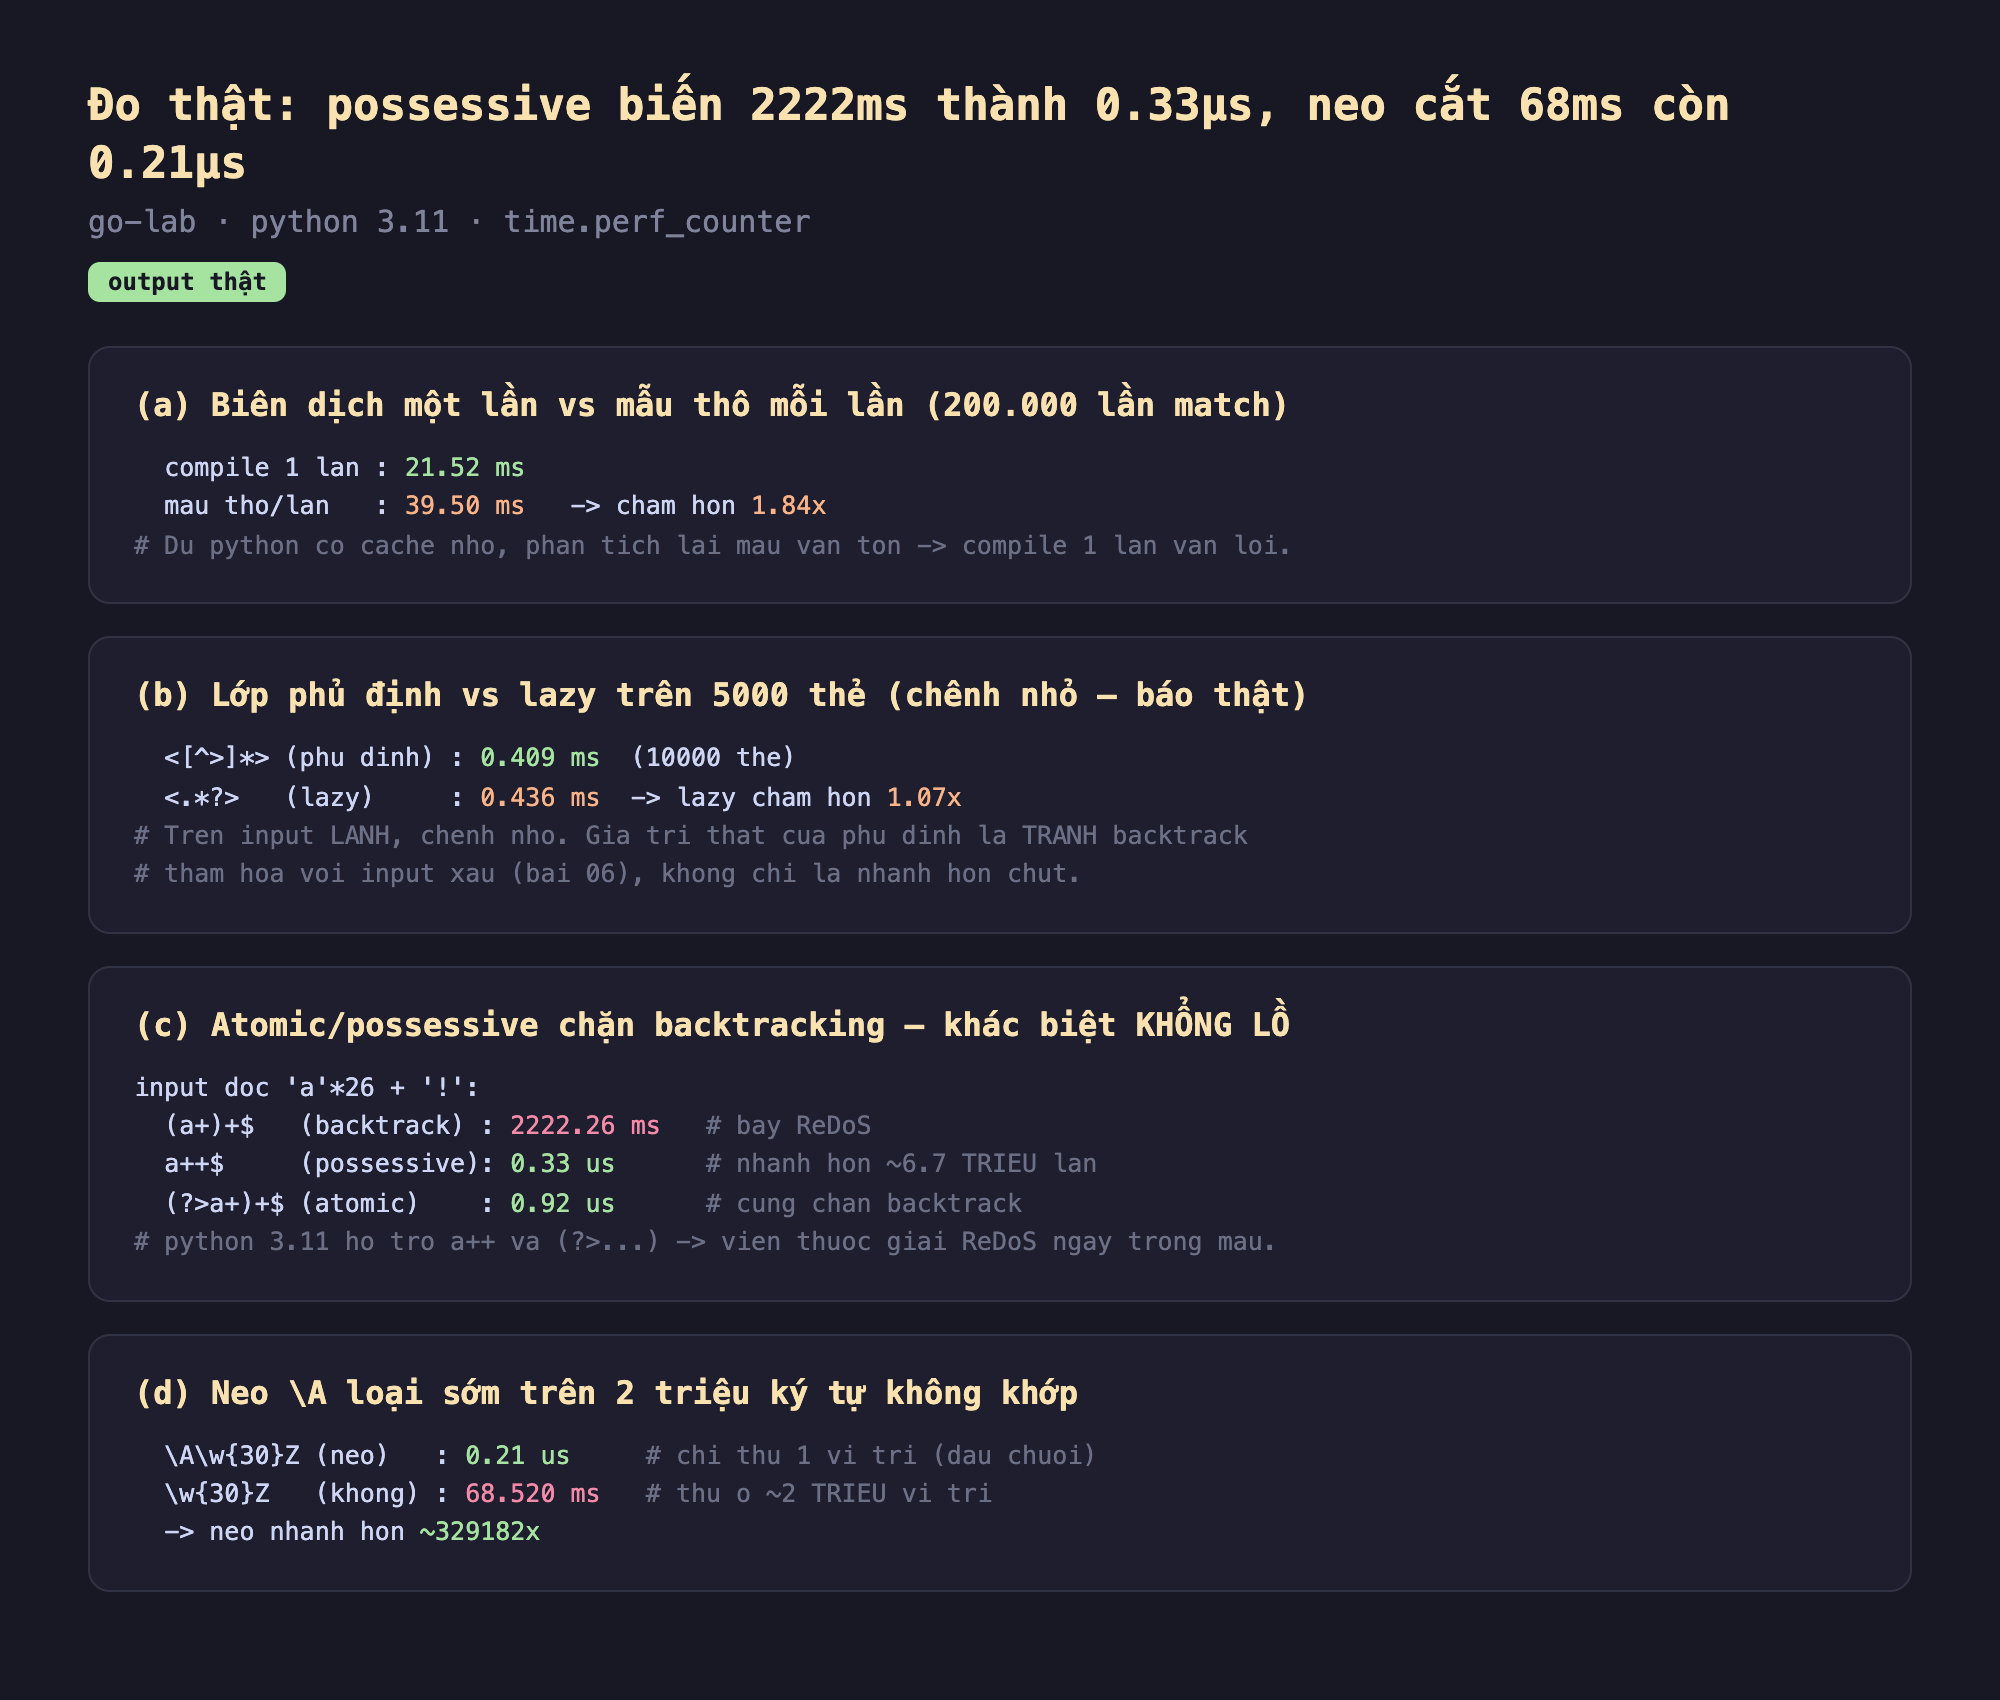
Hình 2: Chạy thật — (a) compile một lần 21.52ms vs mẫu thô 39.50ms (1.84x); (b) [^>]* 0.409ms vs .*? 0.436ms (chỉ 1.07x — chênh nhỏ); (c) (a+)+$ 2222.26ms vs possessive a++$ 0.33µs (~6.7 triệu lần) và atomic (?>a+)+$ 0.92µs; (d) neo \A\w{30}Z 0.21µs vs \w{30}Z 68.52ms (~329182x).
- (a) Biên dịch một lần — lợi vừa phải nhưng có thật: gọi
rc.match()vớircđã compile 200.000 lần mất21.52ms, còn gọire.match(r'...', x)mẫu thô mỗi lần mất39.50ms— chậm hơn 1.84x. Python có cache nội bộ nên chênh không quá lớn, nhưng việc phân tích lại chuỗi mẫu (tra cache, băm) vẫn tốn. Với mẫu chạy trong vòng nóng, compile một lần là thói quen đúng. - (b) Lớp phủ định — chênh nhỏ, nhưng giá trị nằm ở chỗ khác (báo thật):
<[^>]*>mất0.409ms,<.*?>mất0.436ms— lazy chỉ chậm hơn 1.07x. Trên input lành như thế này, khác biệt tốc độ khiêm tốn. Nhưng giá trị thật của lớp phủ định không chủ yếu là nhanh hơn chút — mà là tránh backtracking thảm họa với input xấu (phần 6). Đây là ví dụ cho nguyên tắc "đo trước khi tối ưu": nếu chỉ nhìn con số này, bạn tưởng phủ định không đáng; nhìn cả khía cạnh an toàn mới thấy nó đáng. - (c) Atomic/possessive — khác biệt khổng lồ: đây là ngôi sao. Mẫu độc
(a+)+$trên'a'*26+'!'mất 2222ms (backtracking mũ, ReDoS). Nhưng possessivea++$chỉ mất 0.33µs — nhanh hơn ~6.7 triệu lần — và atomic(?>a+)+$mất0.92µs. Cả hai chặn backtracking:a++ăn hếtarồi không nhả lại, nên khi$hỏng, engine bỏ cuộc ngay thay vì thử mọi cách chia. Python 3.11+ hỗ trợ cảa++lẫn(?>...)— đây là viên thuốc giải ReDoS ngay trong mẫu, không cần đổi engine. - (d) Neo loại sớm — khổng lồ, khi dùng đúng: mẫu
\w{30}Ztrên 2 triệu ký tựa(không khớp) mất 68.52ms vì engine thử khớp ở mỗi trong ~2 triệu vị trí. Neo\A\w{30}Zchỉ mất 0.21µs — nhanh hơn ~329182 lần — vì\Abảo engine chỉ thử ở vị trí đầu chuỗi. Nhưng nhớ bài 3: nếu dùng^với cờre.MULTILINE, engine phải kiểm mỗi đầu dòng, và neo có thể không nhanh hơn (thậm chí chậm hơn). Neo giúp khi bạn biết chắc chuỗi phải bắt đầu ở đó.
Đánh đổi cần cân nhắc
Đo trước, đừng đoán — vì "mẹo tối ưu" phụ thuộc dữ liệu. Bài này chứng minh chính điều đó: lớp phủ định chỉ nhanh hơn 1.07x trên input lành nhưng cứu mạng với input xấu; neo nhanh hơn 329 nghìn lần khi khớp ở đầu nhưng có thể phản tác dụng với re.MULTILINE. Đừng áp mẹo một cách máy móc — profile với dữ liệu thật của bạn (như bài profiling ở loạt Debug) rồi mới quyết. Một "tối ưu" sai ngữ cảnh làm code khó đọc mà chẳng nhanh hơn.
Possessive/atomic đổi tốc độ lấy ngữ nghĩa — có thể làm mẫu không khớp thứ lẽ ra khớp. a++ không nhả lại a nào, nên nếu phần sau cần mượn lại một a thì mẫu sẽ thất bại (đúng như thiết kế — đó là cách nó chặn backtracking). Ví dụ ".++" có thể không khớp "abc" nếu bạn cần dấu " cuối. Dùng possessive khi bạn chắc phần đó không cần nhả lại; nếu không, bạn đổi ReDoS lấy bug khớp hụt.
Cách tối ưu triệt để nhất thường là đổi engine, không phải chỉnh mẫu. Nếu regex chạy trên input không tin cậy và bạn lo ReDoS, đổi sang RE2/Go (phần 7) loại rủi ro tận gốc mà không cần khéo léo từng mẫu. Các mẹo trong bài này quý khi bạn phải dùng engine backtracking (cần lookaround/backreference); nhưng nếu không cần chúng, một engine tuyến tính đơn giản hơn và an toàn hơn mọi mẹo.
Ba ý mang về
- Đo trước khi tối ưu — mẹo phụ thuộc dữ liệu: đo thật lớp phủ định chỉ nhanh hơn 1.07x trên input lành, còn neo nhanh hơn 329182x khi khớp ở đầu nhưng có thể phản tác dụng với
re.MULTILINE; đừng áp mẹo máy móc. - Atomic/possessive là viên thuốc giải ReDoS ngay trong mẫu: đo thật
(a+)+$mất 2222ms nhưnga++$chỉ 0.33µs (~6.7 triệu lần) và(?>a+)+$0.92µs — Python 3.11+ hỗ trợ; nhưng chúng đổi ngữ nghĩa (không nhả lại), dùng khi chắc phần đó không cần backtrack. - Biên dịch một lần và neo đúng chỗ là thói quen rẻ mà lợi: đo thật compile một lần nhanh hơn 1.84x, neo
\Aloại sớm cắt 68ms còn 0.21µs; và nhớ cách triệt để nhất chống ReDoS vẫn là đổi sang engine tuyến tính (RE2) khi không cần lookaround/backreference.
Nguồn
- Python docs — re (
compile, possessive*+, atomic(?>...)— Python 3.11+): https://docs.python.org/3/library/re.html - Jeffrey Friedl — Mastering Regular Expressions (optimization, atomic grouping): https://www.oreilly.com/library/view/mastering-regular-expressions/0596528124/
- Go — RE2 (linear-time alternative): https://github.com/google/re2/wiki/WhyRE2
Phần sau — bài cuối loạt — ta mang mọi thứ ra thực chiến: grep -P, ripgrep, phân tích log thật; đâu là lúc nên dùng regex và đâu là lúc nên dừng lại; kèm tổng kết cả loạt.
