Sau mười một phần đào vào lý thuyết và cơ chế, bài cuối này mang regex về đúng nơi nó tỏa sáng nhất trong công việc hằng ngày: dòng lệnh, đặc biệt là phân tích log. Khi một service gặp sự cố lúc 2 giờ sáng, thứ cứu bạn không phải một framework hoành tráng mà là vài dòng grep -P gõ thẳng vào terminal để tìm ra IP nào đang spam, endpoint nào trả 500, request nào chậm. Bài này (phần 12, bài cuối loạt Regex) chạy thật một phiên điều tra log từ đầu tới cuối, so grep với ripgrep, và — quan trọng không kém — chỉ rõ khi nào nên bỏ regex xuống.
Bộ công cụ regex trên dòng lệnh
grep -P: grep với engine PCRE (Perl-compatible), có\d,\b, lookaround...-ochỉ in phần khớp,-cđếm dòng,\K"vứt" phần đã khớp trước đó.ripgrep(rg): grep hiện đại, mặc định đệ quy, đa luồng, tự bỏ qua.git/binary — nhanh hơn hẳn trên cây thư mục lớn.-Pbật PCRE2.sed/awk: biến đổi và trích field; nhiều việc "tưởng cần regex" thực raawk '{print $N}'gọn hơn.
Kết hợp chúng với pipe Unix (sort | uniq -c | sort -rn) là công thức xếp hạng kinh điển.
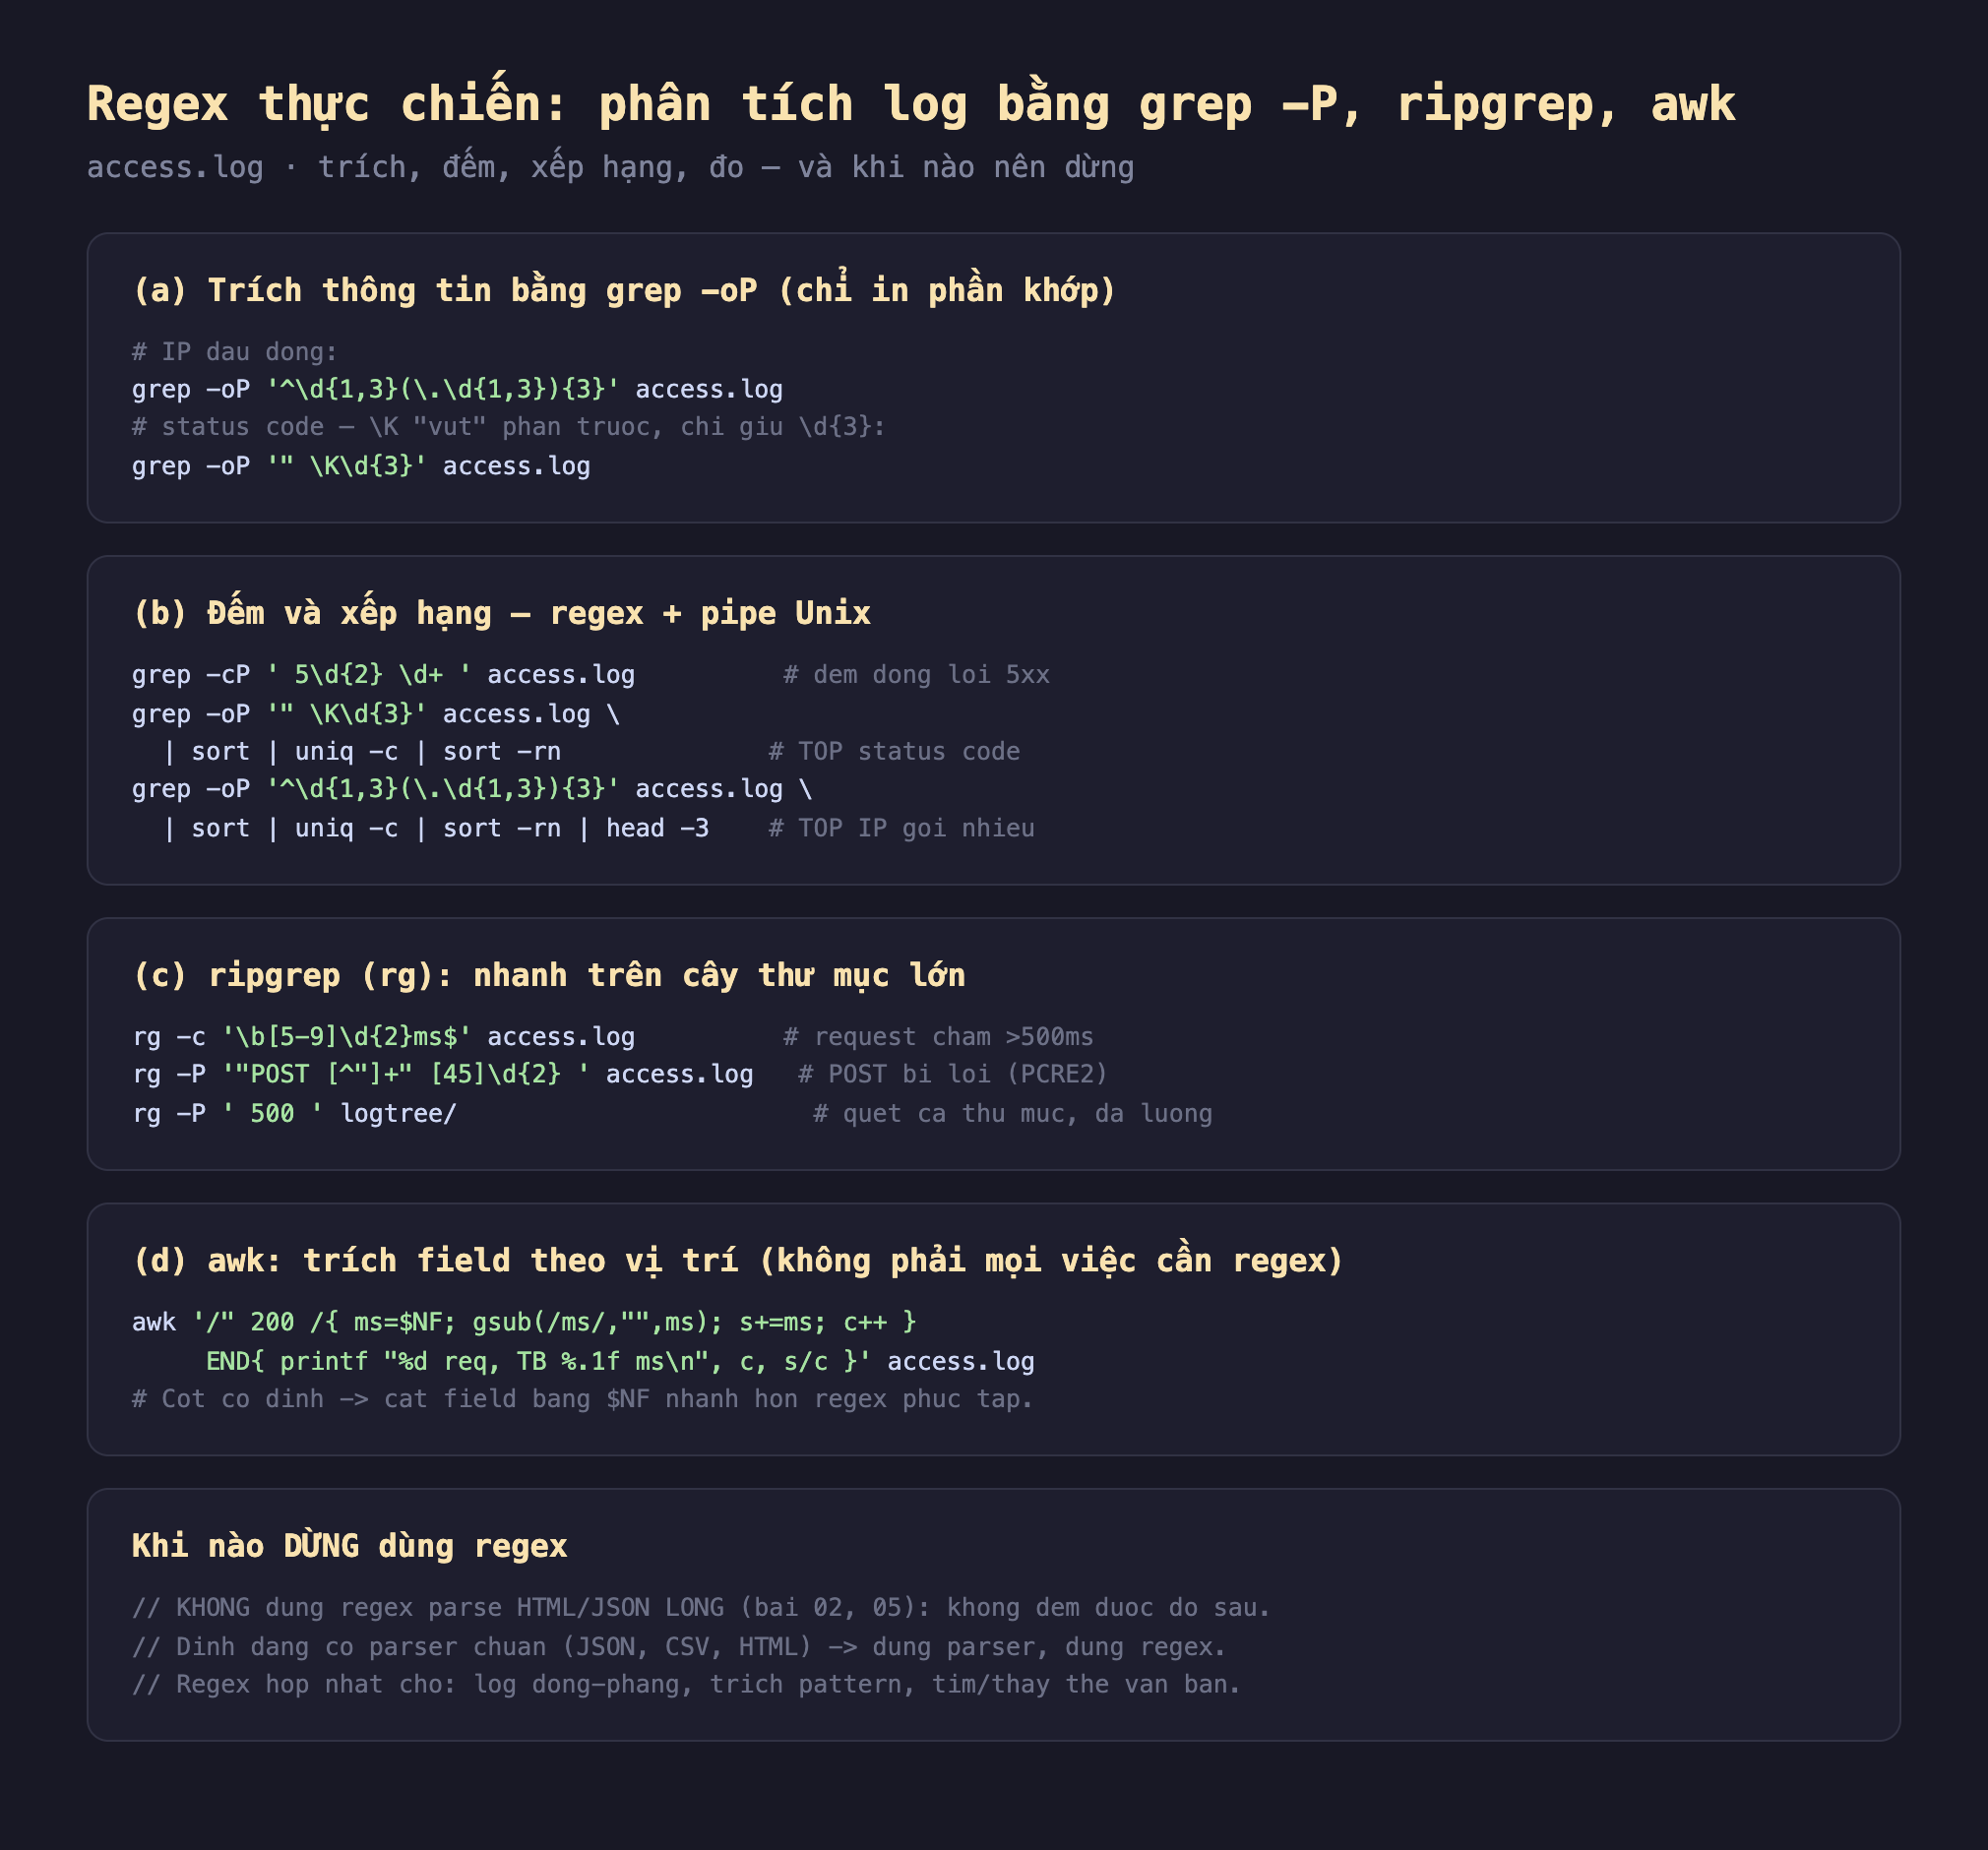
Hình 1: Bộ công cụ regex dòng lệnh — grep -oP trích (với \K), pipe sort|uniq -c|sort -rn xếp hạng, ripgrep quét cây thư mục đa luồng, awk cắt field theo vị trí; và nguyên tắc dừng: không dùng regex parse HTML/JSON lồng.
Đo thật: một phiên điều tra log
Mình tạo một access.log 500 dòng (định dạng Apache/nginx), rồi điều tra:
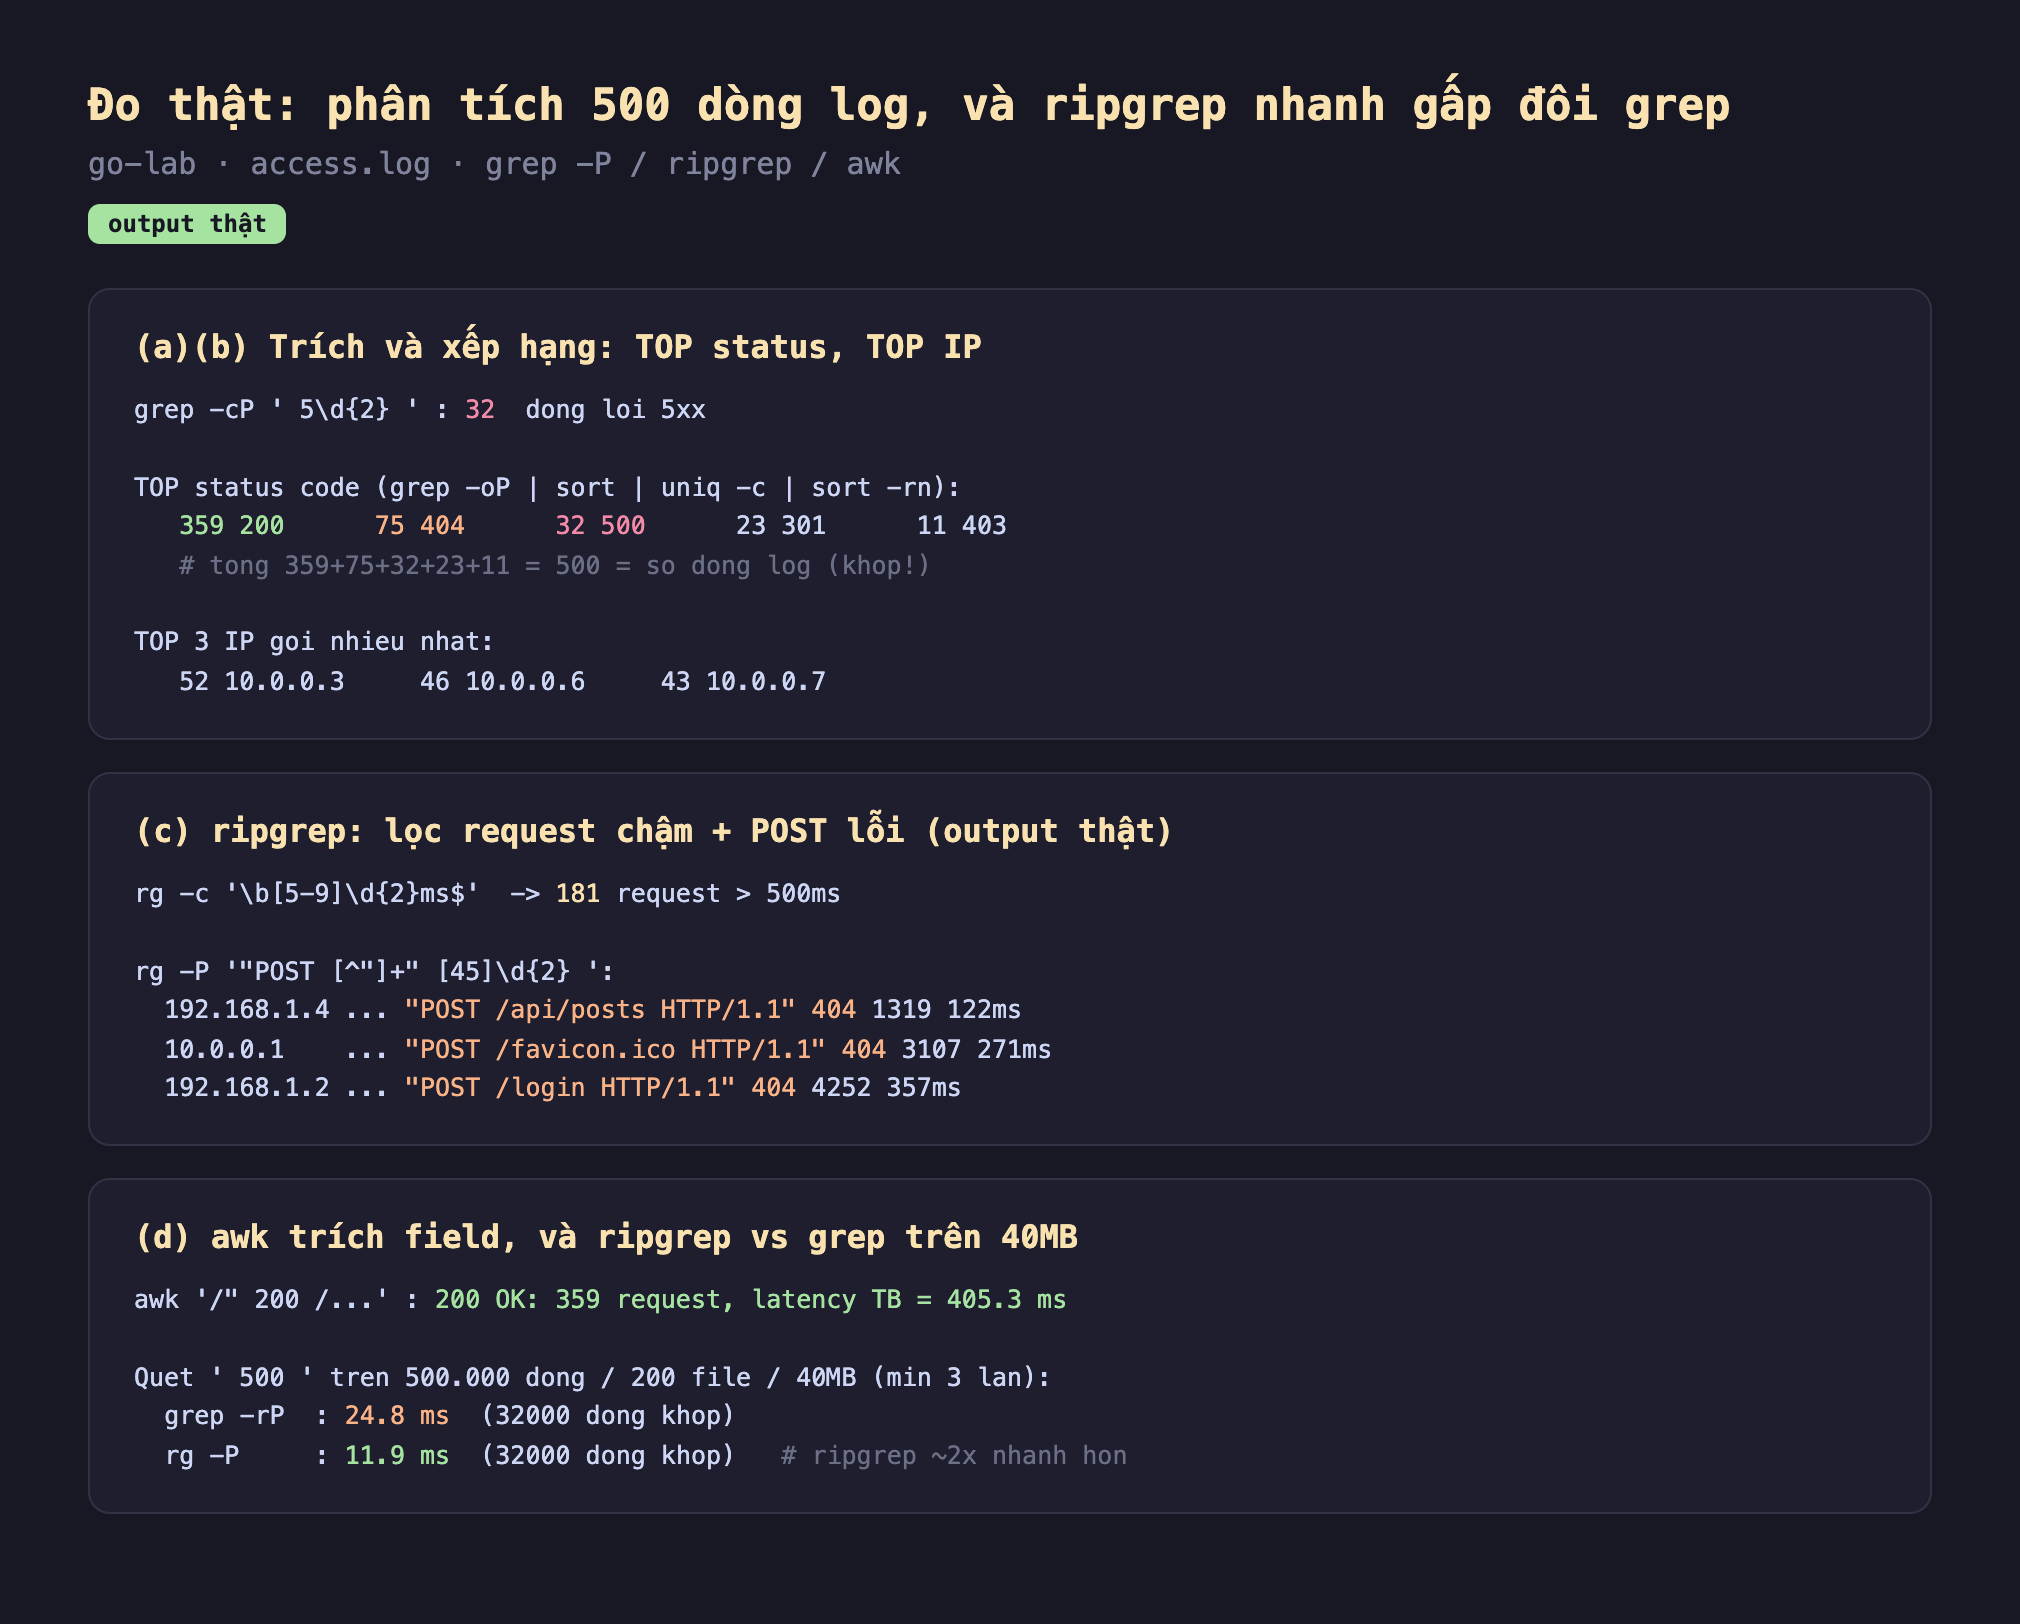
Hình 2: Chạy thật — grep -cP ' 5\d{2} ' cho 32 dòng lỗi 5xx; TOP status 359 200, 75 404, 32 500, 23 301, 11 403 (tổng đúng 500); TOP IP 10.0.0.3(52)...; rg tìm 181 request >500ms và các POST lỗi; awk tính latency 200 OK trung bình 405.3ms; và quét 40MB: grep -rP 24.8ms vs rg -P 11.9ms.
- (a)(b) Trích rồi xếp hạng — công thức vàng:
grep -oP '" \K\d{3}'trích riêng status code (dùng\Kđể chỉ giữ ba chữ số sau dấu"), pipe quasort | uniq -c | sort -rncho bảng xếp hạng: 359 lần 200, 75 lần 404, 32 lần 500, 23 lần 301, 11 lần 403. Tổng đúng 500 — khớp số dòng log, một cách kiểm tra nhanh rằng regex không sót. Cùng công thức đổi mẫu thành IP cho TOP IP gọi nhiều nhất (10.0.0.3với 52 lần).grep -cP ' 5\d{2} 'đếm nhanh 32 dòng lỗi server. - (c) ripgrep cho truy vấn phức tạp:
rg -c '\b[5-9]\d{2}ms$'đếm 181 request chậm hơn 500ms (khớp phầnmscuối dòng).rg -P '"POST [^\"]+" [45]\d{2} '(dùng lớp phủ định[^"]như bài 2 và 11 khuyên) lọc đúng các POST bị 4xx/5xx — thấy ngayPOST /logintrả 404. Đây là kiểu truy vấn "tìm giao của điều kiện" mà regex làm gọn hơn nhiều lần lọc thủ công. - (d) awk khi dữ liệu có cột, và ripgrep khi cây lớn: latency nằm ở field cuối mỗi dòng, nên
awk '{ms=$NF...}'cắt nó ra gọn hơn viết regex phức tạp — tính được latency trung bình của request 200 là 405.3ms. Và khi quét cả cây log 40MB (500.000 dòng, 200 file),ripgrepmất 11.9ms còngrep -rPmất 24.8ms — ripgrep nhanh khoảng gấp đôi (cùng tìm ra 32000 dòng), nhờ đa luồng và tối ưu tìm kiếm.
Khi nào nên DỪNG dùng regex
Đây là bài học đúc kết từ cả loạt, quan trọng ngang mọi kỹ thuật đã học. Regex không phải búa vạn năng:
- Đừng parse HTML/JSON/XML lồng nhau bằng regex (phần 2, 5): các định dạng này có cấu trúc lồng độ sâu tùy ý, mà regex thuần không đếm được độ sâu — đó là giới hạn lý thuyết, không phải chuyện viết khéo. Dùng parser chuẩn (thư viện JSON, jsoup cho HTML,
jqcho JSON trên dòng lệnh). - Dữ liệu có định dạng chuẩn thì dùng công cụ chuẩn: CSV có thư viện CSV (xử lý đúng dấu phẩy trong ngoặc kép), log có định dạng cố định thì
awktheo field an toàn hơn regex đoán mò. - Regex hợp nhất cho: log dòng-phẳng, trích pattern (email, IP, ngày), tìm/thay thế văn bản, kiểm định dạng đầu vào đơn giản. Đúng việc thì nó là công cụ mạnh nhất trong hộp đồ nghề.
Tổng kết loạt "Regex sâu" (12 phần)
Loạt bài đã đi từ bên trong cỗ máy ra tới thực chiến dòng lệnh:
- Phần 1-4 — nền tảng: regex là máy trạng thái; tham lam vs lười; neo và ranh giới (zero-width); lớp ký tự và quantifier (và bẫy
\wvới chữ có dấu). - Phần 5-7 — lý thuyết và hiệu năng: backreference khiến regex "không còn regular"; catastrophic backtracking và ReDoS (một mẫu treo server); RE2 chạy tuyến tính, miễn nhiễm ReDoS nhưng bỏ vài tính năng.
- Phần 8-10 — sức mạnh biểu đạt: lookahead/lookbehind (nhìn mà không nuốt); Unicode và tiếng Việt (
\w, byte vs rune, NFC/NFD,\p{L}); nhóm bắt và thay thế. - Phần 11-12 — làm chủ: tối ưu (possessive/atomic biến 2 giây thành micro-giây); và thực chiến với grep/ripgrep/awk.
Sợi chỉ xuyên suốt: regex không phải phép thuật, mà là một cỗ máy có luật rõ ràng — hiểu luật đó thì bạn viết được mẫu vừa đúng, vừa nhanh, vừa an toàn, và biết khi nào nên dùng công cụ khác. Cảm ơn bạn đã theo trọn loạt bài. Chúc bạn khớp đúng mọi thứ cần khớp, và không bao giờ dính một con ReDoS nào.
Ba ý mang về
- grep -P + pipe Unix là bộ đồ nghề phân tích log: đo thật
grep -oP '" \K\d{3}' | sort | uniq -c | sort -rncho TOP status (359 lần 200, 75 lần 404...), tổng đúng 500 dòng;grep -cPđếm lỗi 5xx (32 dòng) — trích rồi xếp hạng là công thức vàng. - ripgrep nhanh hơn cho cây lớn, awk gọn hơn cho field cố định: đo thật
rgquét 40MB mất 11.9ms vsgrep -rP24.8ms (~2x); vàawk '{ms=$NF}'tính latency 200 OK trung bình 405.3ms gọn hơn regex phức tạp — chọn công cụ theo hình dạng dữ liệu. - Biết khi nào dừng dùng regex: đừng parse HTML/JSON lồng (giới hạn lý thuyết — phần 2, 5), dùng parser chuẩn; regex hợp nhất cho log dòng-phẳng, trích pattern, tìm/thay thế — đúng việc thì nó là công cụ mạnh nhất, sai việc thì nó là nguồn bug.
Nguồn
- man7.org — grep(1) (
-P,-o, PCRE): https://man7.org/linux/man-pages/man1/grep.1.html - ripgrep — User Guide: https://github.com/BurntSushi/ripgrep/blob/master/GUIDE.md
- Stack Overflow — "You can't parse HTML with regex" (giới hạn kinh điển): https://stackoverflow.com/a/1732454
