Nhiều người dùng Redis như một cái bảng key-value khổng lồ: nhét JSON vào string, lấy ra, parse. Hoạt động, nhưng bỏ phí phần lớn sức mạnh của Redis — và thường tốn bộ nhớ hơn cần thiết. Điều làm Redis đặc biệt là nó có năm kiểu dữ liệu, mỗi kiểu kèm những lệnh tối ưu riêng giải một lớp bài toán cụ thể. Chọn đúng kiểu biến một bài toán khó (xếp hạng, tập giao nhau) thành một lệnh; chọn sai thì vừa chậm vừa ngốn RAM. Bài này (phần 2/12) demo thật cả năm kiểu trong redis-lab, với use case thực và đo bộ nhớ để thấy rõ đánh đổi.
Năm kiểu và khi nào dùng
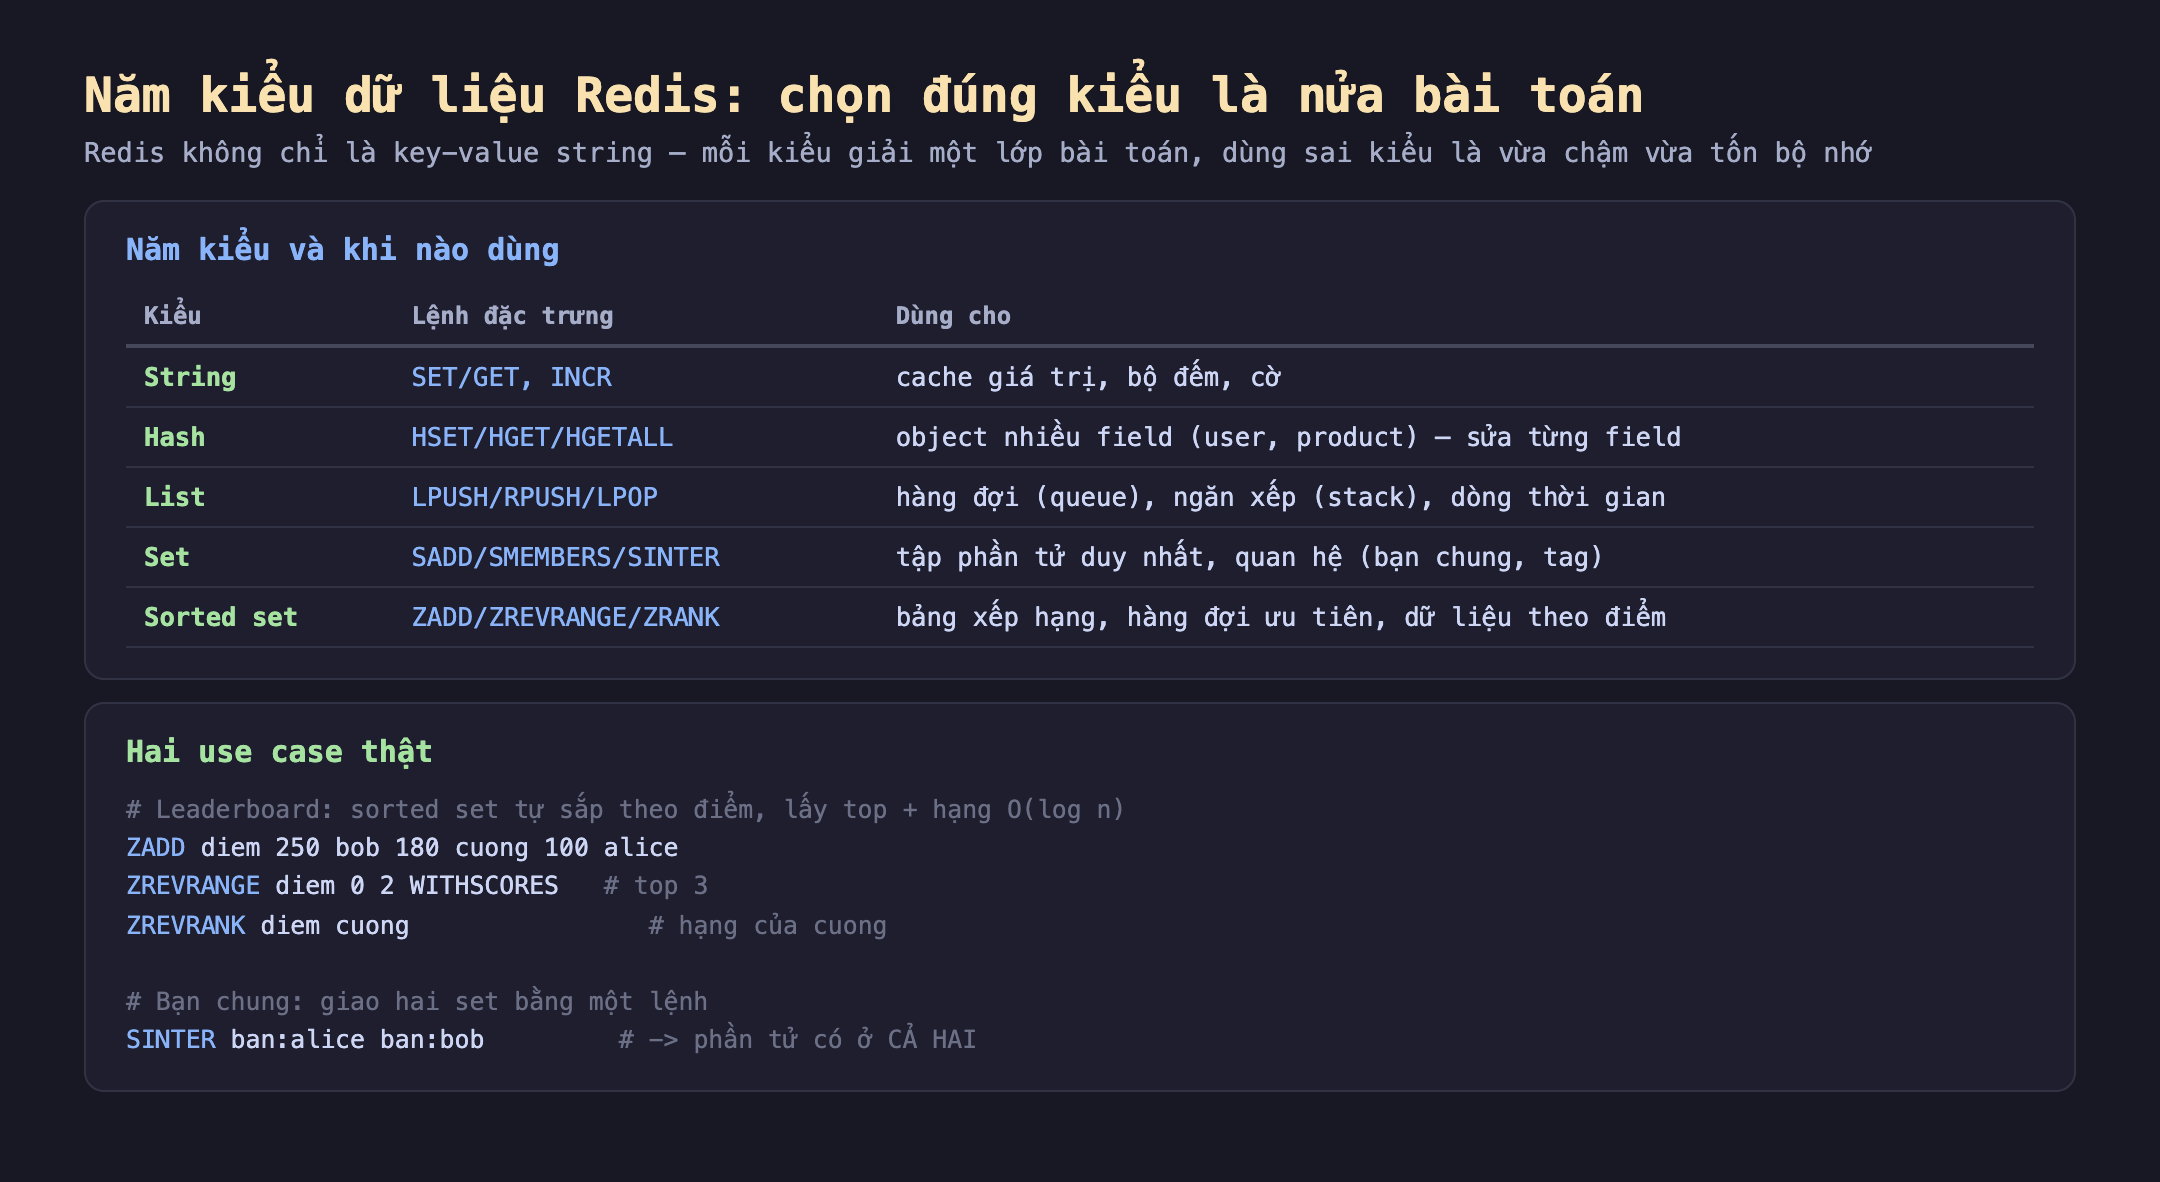
Hình 1: Năm kiểu dữ liệu Redis và bài toán tương ứng — string (cache/counter), hash (object nhiều field), list (queue/stack), set (unique/quan hệ), sorted set (ranking). Hai use case: leaderboard bằng sorted set, bạn chung bằng SINTER.
- String: cache một giá trị, bộ đếm (
INCRnguyên tử), cờ. Đơn giản nhất. - Hash: object nhiều field (
user:1với name/age/city). Ưu điểm lớn: sửa một field (HSET user:1 age 29) mà không phải đọc-sửa-ghi lại cả object như khi lưu JSON string. - List: dãy có thứ tự — hàng đợi (
RPUSH/LPOP), ngăn xếp (LPUSH/LPOP), dòng thời gian. - Set: tập phần tử duy nhất, và các phép quan hệ (giao/hợp/hiệu). Dùng cho tag, danh sách duy nhất, bạn chung.
- Sorted set: như set nhưng mỗi phần tử có điểm và được sắp xếp theo điểm — bảng xếp hạng, hàng đợi ưu tiên, dữ liệu theo thời gian/điểm.
Đo thật: use case và bộ nhớ
Hai bài toán kinh điển, mỗi cái gọn trong vài lệnh:
# Leaderboard — sorted set tự sắp theo điểm
redis-cli ZADD diem 100 alice 250 bob 180 cuong 90 dung
redis-cli ZREVRANGE diem 0 2 WITHSCORES   # top 3
redis-cli ZREVRANK diem cuong             # hạng của cuong
# Bạn chung — giao hai set
redis-cli SINTER ban:alice ban:bob
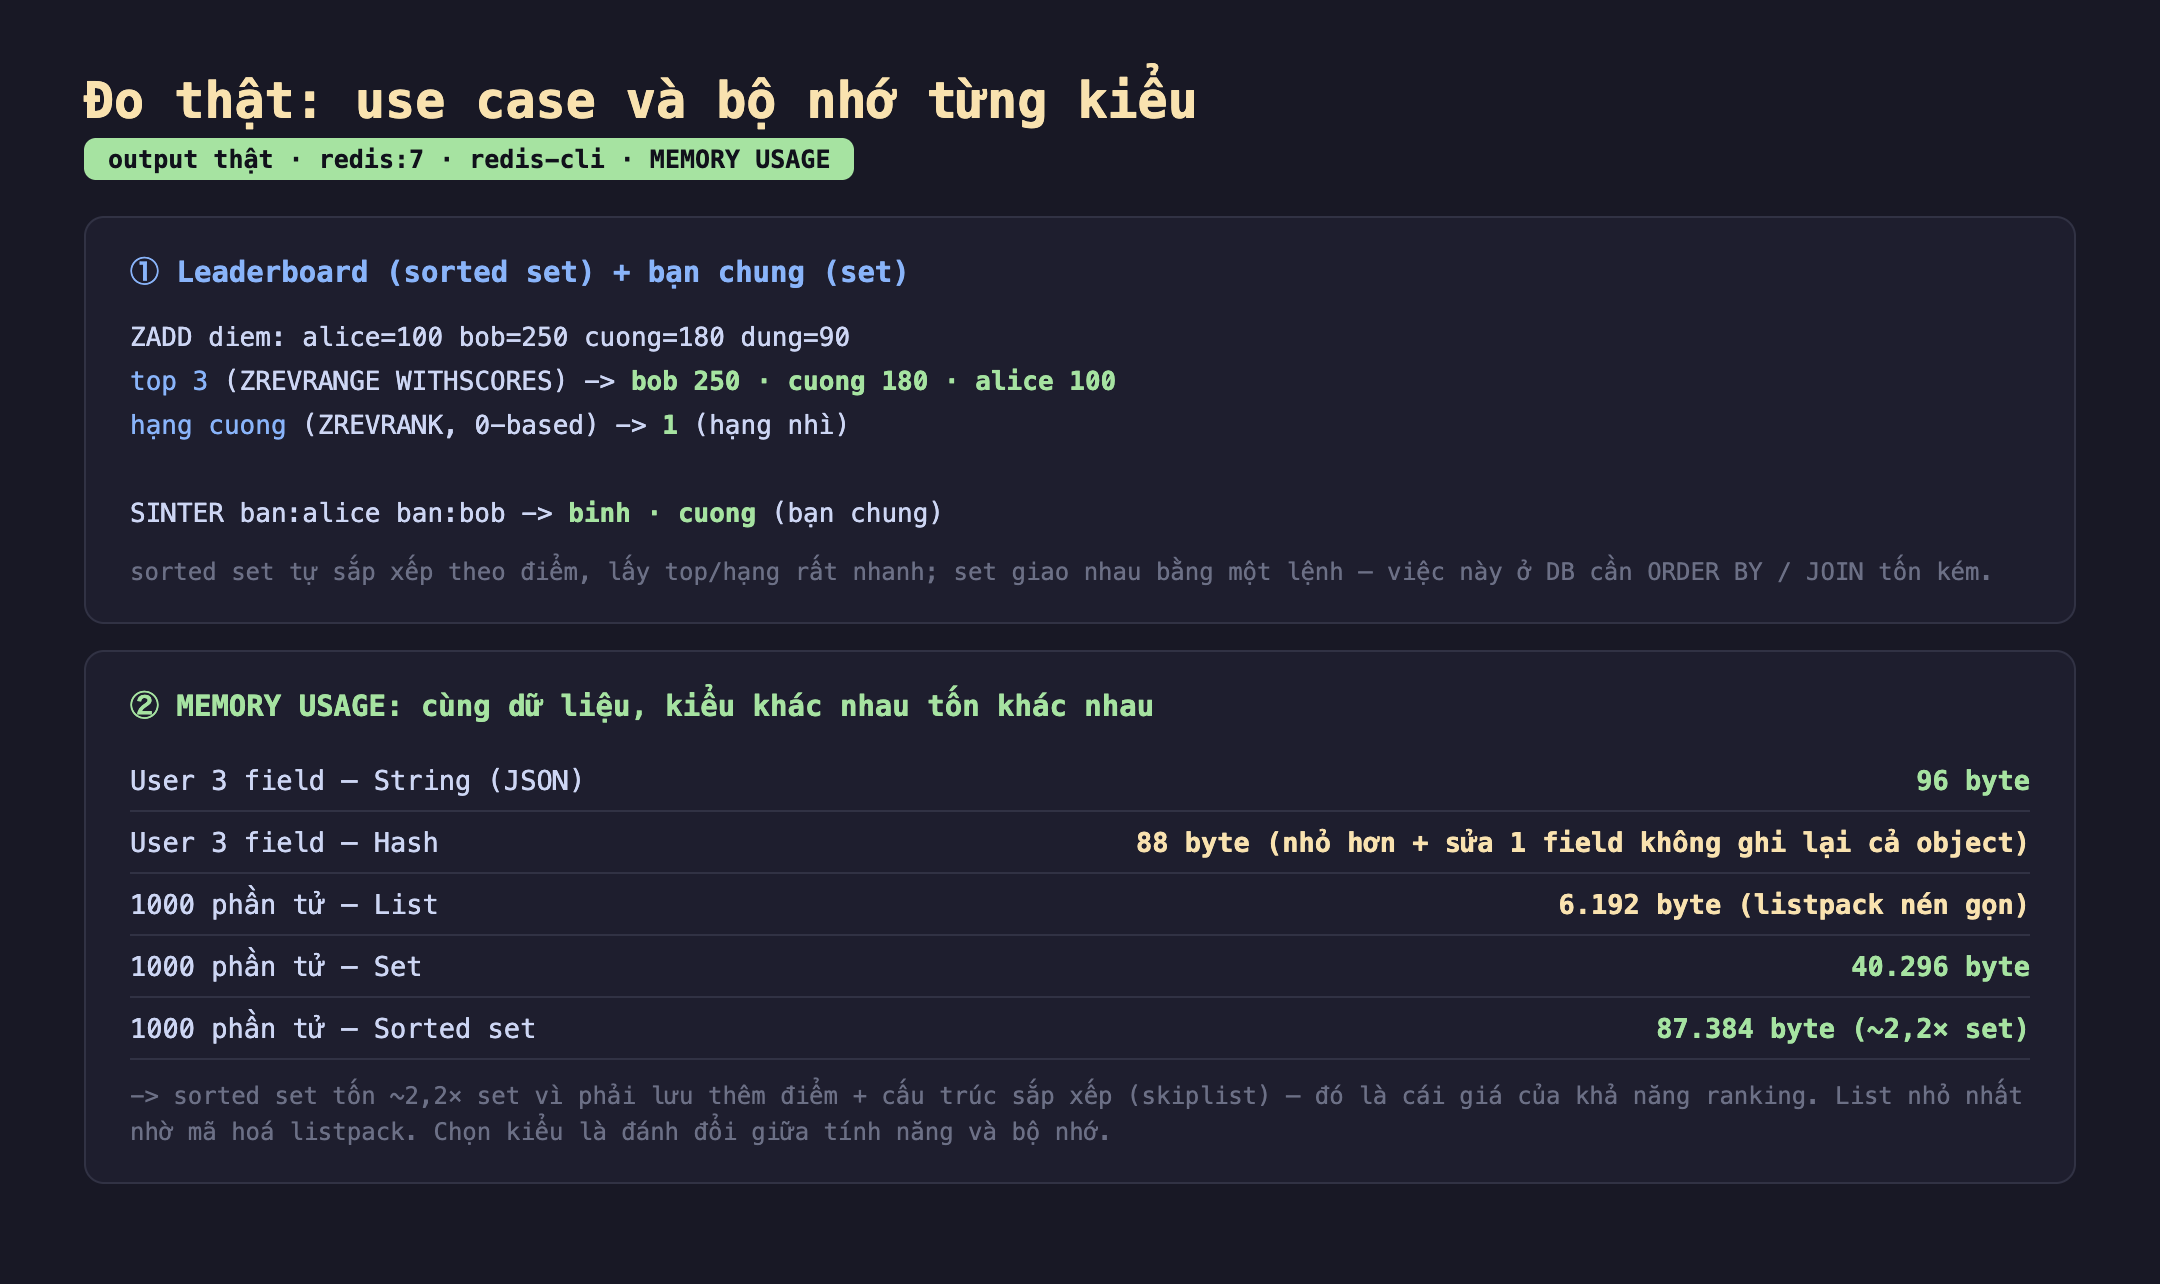
Hình 2: Đo thật. Leaderboard: top 3 = bob 250, cuong 180, alice 100; hạng của cuong = 1 (hạng nhì). SINTER cho bạn chung = binh, cuong. MEMORY USAGE: hash 88 byte vs JSON 96 byte; 1000 phần tử list 6.192, set 40.296, sorted set 87.384 byte.
Kết quả thật:
- Leaderboard bằng sorted set:
ZREVRANGE diem 0 2 WITHSCOREStrả đúng top 3 (bob 250, cuong 180, alice 100),ZREVRANK diem cuongtrả 1 (hạng nhì, đếm từ 0). Những thao tác này là O(log n) — nhanh dù bảng có hàng triệu người. Làm điều này trên database cầnORDER BY ... LIMITquét/sắp xếp tốn kém mỗi lần. - Bạn chung bằng SINTER:
SINTER ban:alice ban:bobtrả vềbinh, cuong— phần tử có ở cả hai set, trong một lệnh. Trên SQL việc này cần mộtJOINhoặcINTERSECT. - Bộ nhớ khác nhau rõ rệt: cùng một user 3 field, lưu JSON string 96 byte vs hash 88 byte — hash nhỏ hơn và cho sửa từng field. Với 1000 phần tử nhỏ: list 6.192 byte (nhỏ nhất, nhờ mã hoá listpack nén gọn), set 40.296 byte, và sorted set 87.384 byte — ~2,2 lần set. Sorted set đắt hơn vì phải lưu thêm điểm và một cấu trúc sắp xếp (skiplist) — đó chính là cái giá của khả năng ranking.
Bài học: chọn kiểu là một đánh đổi giữa tính năng và bộ nhớ. Cần xếp hạng thì sorted set đáng giá dù tốn gấp đôi; chỉ cần kiểm "có thuộc tập không" thì set đủ; chỉ xếp hàng thì list cực rẻ.
Đánh đổi cần cân nhắc
Hash so với nhiều string rời: gom lại gần như luôn tốt hơn. Lưu user:1:name, user:1:age, user:1:city thành ba string riêng tốn nhiều overhead (mỗi key có chi phí cố định) hơn một hash user:1 ba field. Hash gom object lại gọn, cho thao tác field-level, và (với object nhỏ) dùng mã hoá listpack tiết kiệm. Trừ khi cần TTL riêng cho từng field (hash không hỗ trợ tới gần đây), hãy gom object vào hash.
Mã hoá nội bộ đổi theo kích thước — và ảnh hưởng bộ nhớ lẫn tốc độ. Redis dùng mã hoá compact (listpack/intset) cho collection nhỏ, tự chuyển sang cấu trúc đầy đủ (hashtable/skiplist) khi vượt ngưỡng (hash-max-listpack-entries, v.v.). Collection nhỏ vừa tiết kiệm RAM vừa nhanh; nhưng khi lớn, chi phí mỗi phần tử tăng. Đây là lý do con số bộ nhớ không tỉ lệ tuyến tính — biết ngưỡng chuyển mã hoá giúp dự đoán.
Đừng lạm dụng một key khổng lồ. Một sorted set hay hash rất lớn (hàng triệu phần tử trong một key) là "big key" — thao tác trên nó (như HGETALL, ZRANGE 0 -1) là O(n) chặn cả server một luồng (bài 1). Chia nhỏ theo khoá (sharding key) hoặc dùng lệnh phân trang (HSCAN, ZRANGEBYSCORE có LIMIT). Bài redis-11 sẽ đo tác hại của big key.
Ba ý mang về
- Redis có năm kiểu, mỗi kiểu giải một lớp bài toán. String (cache/counter), hash (object), list (queue), set (unique/quan hệ), sorted set (ranking). Chọn đúng kiểu biến bài toán khó thành một lệnh: đo thật leaderboard bằng ZREVRANGE/ZREVRANK, bạn chung bằng SINTER.
- Chọn kiểu là đánh đổi tính năng vs bộ nhớ. Đo thật cùng 1000 phần tử: list 6KB, set 40KB, sorted set 87KB (~2,2× set vì lưu điểm + skiplist). Hash 88 byte nhỏ hơn JSON 96 byte và cho sửa từng field. Trả thêm RAM chỉ khi cần tính năng (ranking) tương ứng.
- Gom object vào hash, cảnh giác mã hoá và big key. Hash tốt hơn nhiều string rời; mã hoá compact (listpack) khiến collection nhỏ rẻ và nhanh; nhưng một key khổng lồ với thao tác O(n) chặn cả server — chia nhỏ hoặc dùng lệnh phân trang.
Nguồn
- Redis — Data types: https://redis.io/docs/latest/develop/data-types/
- Redis — Memory optimization (encoding): https://redis.io/docs/latest/operate/oss_and_stack/management/optimization/memory-optimization/
- Redis — Sorted sets: https://redis.io/docs/latest/develop/data-types/sorted-sets/
Phần sau ta đo kỹ một thứ đã thấy teaser ở bài 1: pipeline — gộp nhiều lệnh vào một lần gửi để cắt round-trip, và vì sao nó đẩy throughput lên gấp nhiều lần.
