Khi một ứng dụng backend chạm trần vì database quá tải, Redis thường là thứ đầu tiên người ta nghĩ tới — đặt một lớp trong RAM phía trước để trả dữ liệu nóng trong micro-giây thay vì chờ database hàng mili-giây. Nhưng Redis không chỉ là "cache": nó là một kho dữ liệu đa năng với tốc độ khó tin — hàng trăm nghìn lệnh mỗi giây. Và điều làm nhiều người bối rối: Redis xử lý lệnh trên đúng một luồng. Nghe như một hạn chế, nhưng đó lại chính là bí quyết tốc độ và là nền tảng cho một tính chất quý giá — mọi lệnh Redis đều nguyên tử. Bài mở màn sê-ri này (phần 1/12) dựng Redis thật trong Docker và đo để thấy rõ.
Ba lý do Redis nhanh
Tốc độ của Redis đến từ ba quyết định thiết kế, không phải phép màu:
- In-memory: toàn bộ dữ liệu nằm trong RAM. Mỗi lệnh đọc/ghi không chạm đĩa — thao tác tính bằng nano-giây (RAM) thay vì mili-giây (đĩa). Đây là khác biệt nền tảng so với database truyền thống lưu trên đĩa.
- Single-thread xử lý lệnh: Redis thực thi lệnh trên một luồng, tuần tự. Nghe ngược đời, nhưng nó loại bỏ hoàn toàn chi phí khoá (lock), tranh chấp (contention), và chuyển ngữ cảnh (context-switch) giữa các luồng — những thứ giết hiệu năng trong hệ đa luồng. Hệ quả tuyệt vời: vì mỗi lệnh chạy trọn vẹn trước khi lệnh sau bắt đầu, mọi lệnh Redis đều nguyên tử một cách tự nhiên.
- I/O đa hợp (epoll) + giao thức RESP gọn: một luồng vẫn phục vụ được hàng nghìn kết nối cùng lúc nhờ I/O multiplexing, và giao thức RESP đơn giản nên phân tích cú pháp cực nhanh.
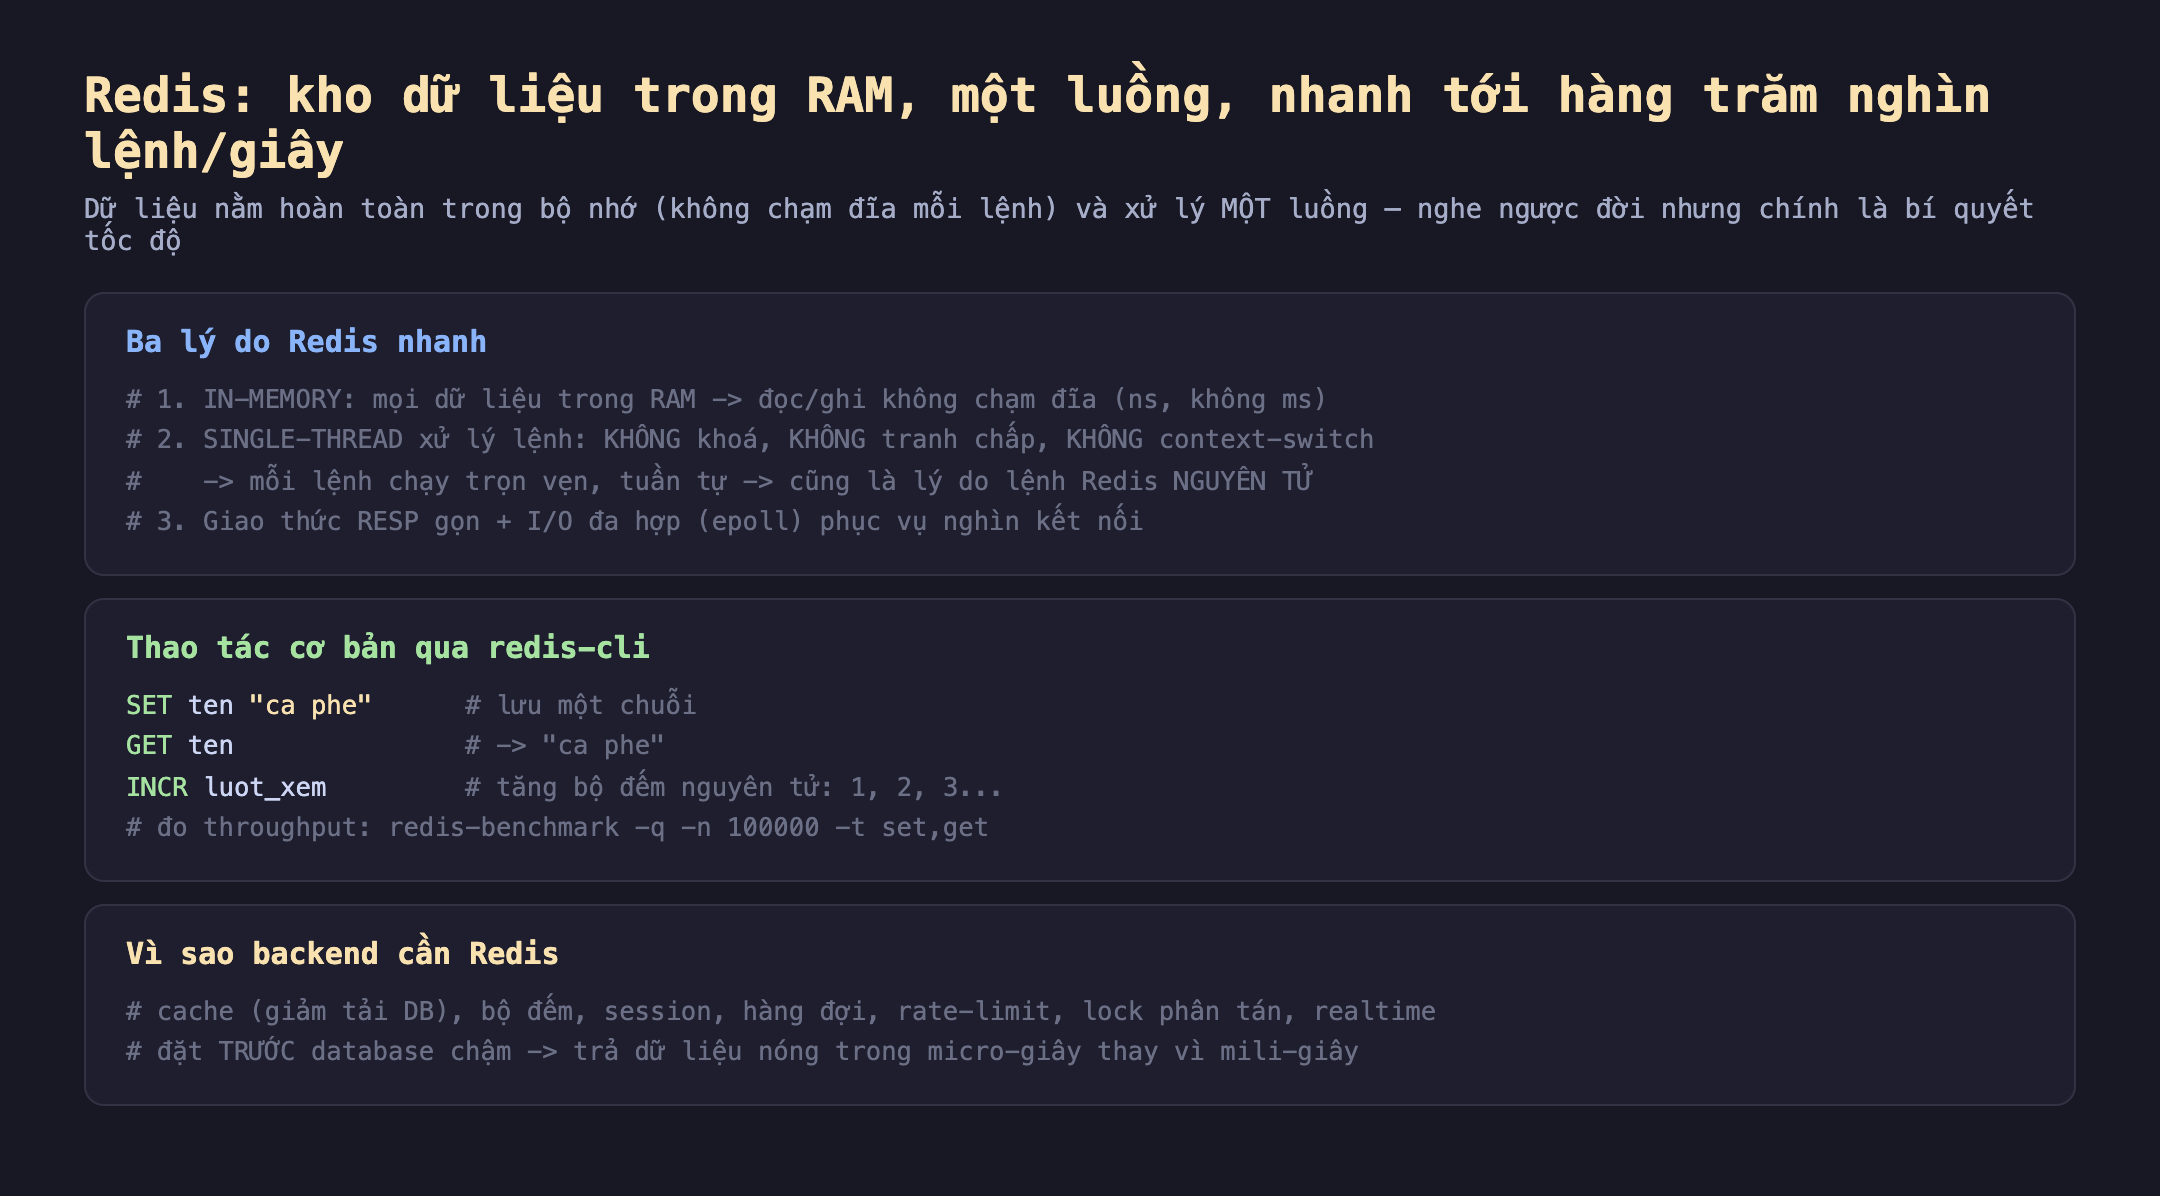
Hình 1: Ba lý do Redis nhanh — in-memory (RAM không đĩa), single-thread xử lý lệnh (không khoá, và khiến lệnh nguyên tử), I/O đa hợp epoll. Thao tác cơ bản qua redis-cli; Redis dùng cho cache, đếm, session, hàng đợi, rate-limit, lock, realtime.
Thao tác cơ bản cực gọn:
redis-cli SET ten "ca phe"   # lưu một chuỗi
redis-cli GET ten            # -> "ca phe"
redis-cli INCR luot_xem      # tăng bộ đếm nguyên tử: 1, 2, 3...
Đo thật: throughput và latency
Mình đo bằng redis-benchmark — 100.000 lệnh cho mỗi loại:
redis-benchmark -q -n 100000 -t set,get
redis-cli --latency    # đo độ trễ liên tục
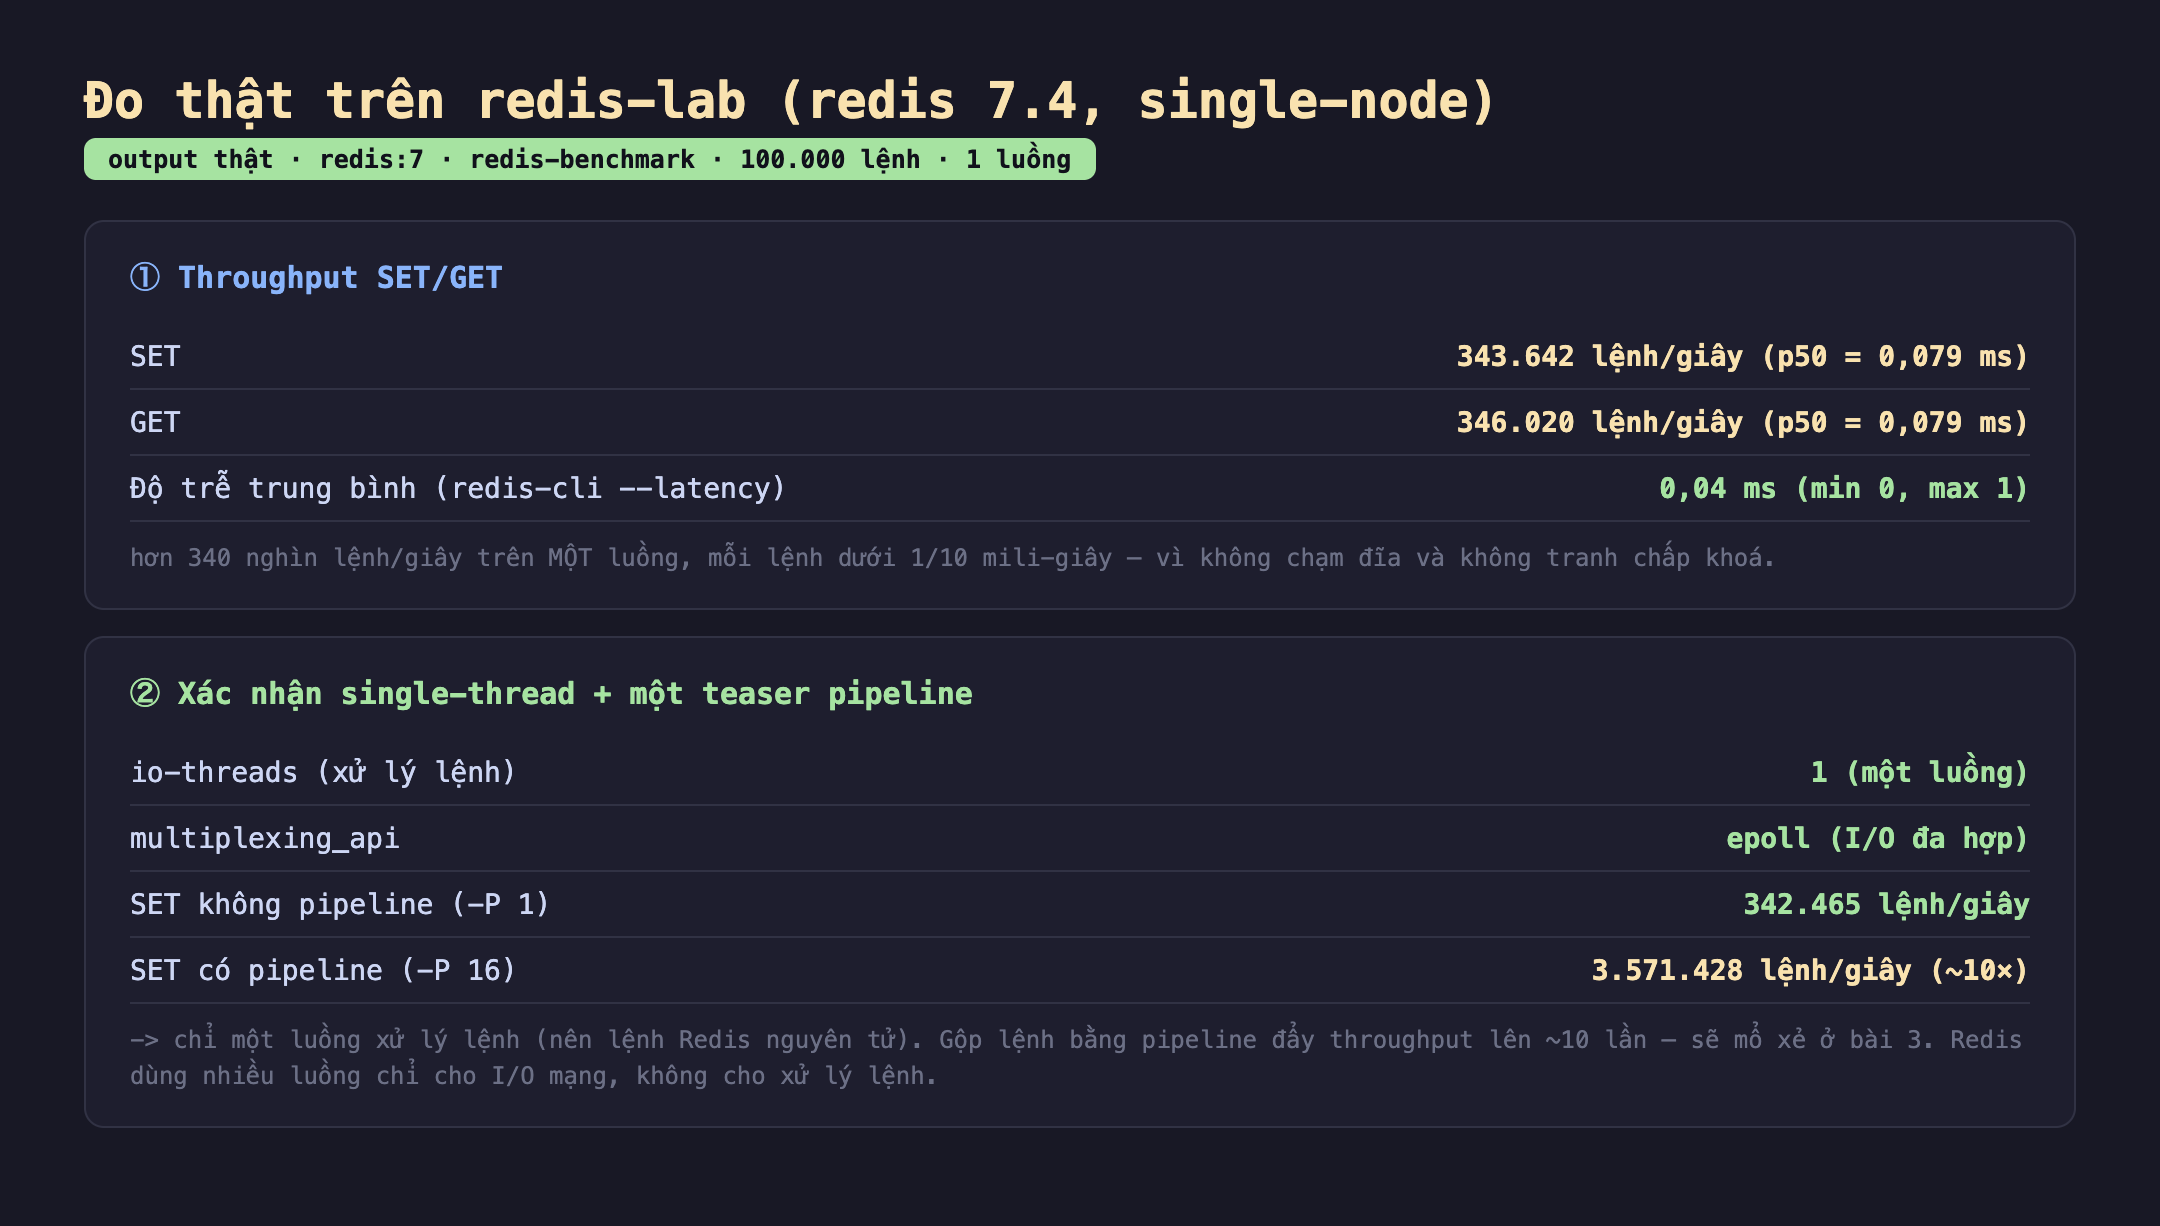
Hình 2: Đo thật. SET 343.642 lệnh/giây, GET 346.020 lệnh/giây (p50 = 0,079 ms); độ trễ trung bình 0,04 ms. io-threads = 1 (một luồng xử lý lệnh), multiplexing_api = epoll. Teaser pipeline: -P 16 cho 3.571.428 lệnh/giây (~10×).
Kết quả thật:
- SET: 343.642 lệnh/giây, GET: 346.020 lệnh/giây, cả hai với p50 = 0,079 ms. Độ trễ trung bình (đo bằng
redis-cli --latency) chỉ 0,04 ms (min 0, max 1 ms). Hơn 340 nghìn lệnh mỗi giây trên một luồng, mỗi lệnh dưới một phần mười mili-giây — vì không chạm đĩa và không tranh chấp khoá. - Xác nhận single-thread:
io-threads = 1(một luồng xử lý lệnh),multiplexing_api = epoll. Redis có thể dùng nhiều luồng cho phần I/O mạng (đọc/ghi socket), nhưng việc thực thi lệnh vẫn trên một luồng — đó là lý do tính nguyên tử được bảo toàn. - Teaser pipeline: cùng lệnh SET, không pipeline (
-P 1) cho 342.465/giây, nhưng gộp lệnh với-P 16cho 3.571.428/giây — nhanh ~10 lần. Vì sao gộp lệnh lại tăng tốc khủng khiếp thế, bài kafka... à, bài redis-03 sẽ mổ xẻ.
Con số này cho thấy bậc độ của Redis: nơi một query database tính bằng mili-giây, một lệnh Redis tính bằng phần trăm mili-giây — nhanh hơn hai, ba bậc. Đó là lý do đặt Redis trước database biến một endpoint chậm thành tức thời.
Đánh đổi cần cân nhắc
In-memory nghĩa là bị giới hạn bởi RAM — và RAM đắt. Toàn bộ dữ liệu phải vừa trong bộ nhớ; không như database trên đĩa chứa được terabyte rẻ tiền. Redis hợp cho dữ liệu nóng và vừa phải (cache, session, counter), không phải kho lưu trữ chính khổng lồ. Vượt RAM thì phải eviction (bài redis-05) hoặc sharding — và luôn tính chi phí RAM, vốn đắt hơn đĩa nhiều lần.
Single-thread: một lệnh chậm chặn TẤT CẢ. Mặt trái của một luồng: nếu một lệnh nặng (ví dụ KEYS * trên hàng triệu key, hay thao tác trên một big key — bài redis-11) chạy lâu, nó chặn toàn bộ server, mọi client khác phải chờ. Trong hệ đa luồng, một request chậm chỉ ảnh hưởng chính nó; trong Redis, nó làm nghẽn tất cả. Vì thế phải tránh lệnh O(n) lớn trên luồng chính — một kỷ luật quan trọng mà các bài sau sẽ nhắc lại.
Redis mặc định không bền bằng database. Dữ liệu trong RAM sẽ mất khi tiến trình chết nếu không có persistence. Redis có RDB/AOF (bài redis-10) để ghi xuống đĩa, nhưng đó là đánh đổi độ bền vs hiệu năng, và vẫn không mạnh bằng cam kết ACID của một RDBMS. Đừng dùng Redis làm nguồn-sự-thật duy nhất cho dữ liệu không được phép mất, trừ khi hiểu rõ mô hình persistence.
Ba ý mang về
- Redis nhanh nhờ in-memory + single-thread + I/O đa hợp. Đo thật: SET 343.642/giây, GET 346.020/giây, p50 0,079 ms, độ trễ trung bình 0,04 ms — nhanh hơn query database hai, ba bậc vì không chạm đĩa.
- Single-thread không phải hạn chế mà là thiết kế — và cho tính nguyên tử. Đo thật: io-threads = 1; mỗi lệnh chạy trọn vẹn tuần tự nên không cần khoá và mọi lệnh nguyên tử. Pipeline (
-P 16) đẩy throughput lên ~10× (3,57 triệu/giây) — chủ đề bài 3. - Sức mạnh đi kèm giới hạn: RAM, lệnh chậm, và độ bền. Dữ liệu phải vừa RAM (đắt); một lệnh O(n) lớn chặn cả server (tránh KEYS/big key); và dữ liệu mất khi chết nếu không cấu hình persistence. Dùng Redis cho dữ liệu nóng, không làm kho lưu trữ chính cho dữ liệu không được mất.
Nguồn
- Redis — Introduction to Redis: https://redis.io/docs/latest/develop/get-started/
- Redis — Why Redis is single-threaded & fast (FAQ): https://redis.io/docs/latest/operate/oss_and_stack/management/optimization/benchmarks/
- Redis — redis-benchmark: https://redis.io/docs/latest/operate/oss_and_stack/management/optimization/benchmarks/
Phần sau ta khám phá thứ làm Redis hơn một cái kho key-value: các kiểu dữ liệu — string, hash, list, set, sorted set — mỗi kiểu giải một lớp bài toán, và chọn đúng kiểu quyết định cả hiệu năng lẫn bộ nhớ.
