Ở bài 1 ta thấy một teaser gây tò mò: cùng lệnh SET, bật pipeline đẩy throughput từ ~340 nghìn lên hàng triệu lệnh/giây. Giờ mổ xẻ nó. Điểm mấu chốt cần hiểu: Redis xử lý mỗi lệnh cực nhanh (phần trăm mili-giây), nhưng nếu client gửi từng lệnh một rồi chờ reply trước khi gửi lệnh sau, phần lớn thời gian trôi qua là chờ mạng — gói tin đi và về (round-trip) — chứ không phải Redis làm việc. Pipeline gộp nhiều lệnh vào một lần gửi, nhận cả loạt reply một lần, cắt phăng số round-trip. Đây là đòn bẩy throughput lớn nhất khi làm việc với Redis. Bài này (phần 3/12) đo thật mức độ.
Round-trip là nút thắt, pipeline cắt nó
Khi không pipeline, N lệnh nghĩa là N lần đi-về mạng:
client ──SET a──▶ server ; client ◀──OK── server   # chờ 1 round-trip
client ──SET b──▶ server ; client ◀──OK── server   # chờ 1 round-trip nữa
# N lệnh = N round-trip -> phần lớn thời gian là CHỜ, Redis ngồi rảnh giữa các lệnh
Pipeline gửi cả loạt rồi nhận cả loạt:
client ──SET a; SET b; SET c; ...──▶ server
client ◀──OK; OK; OK; ...────────── server   # CHỈ 1 round-trip cho cả N lệnh
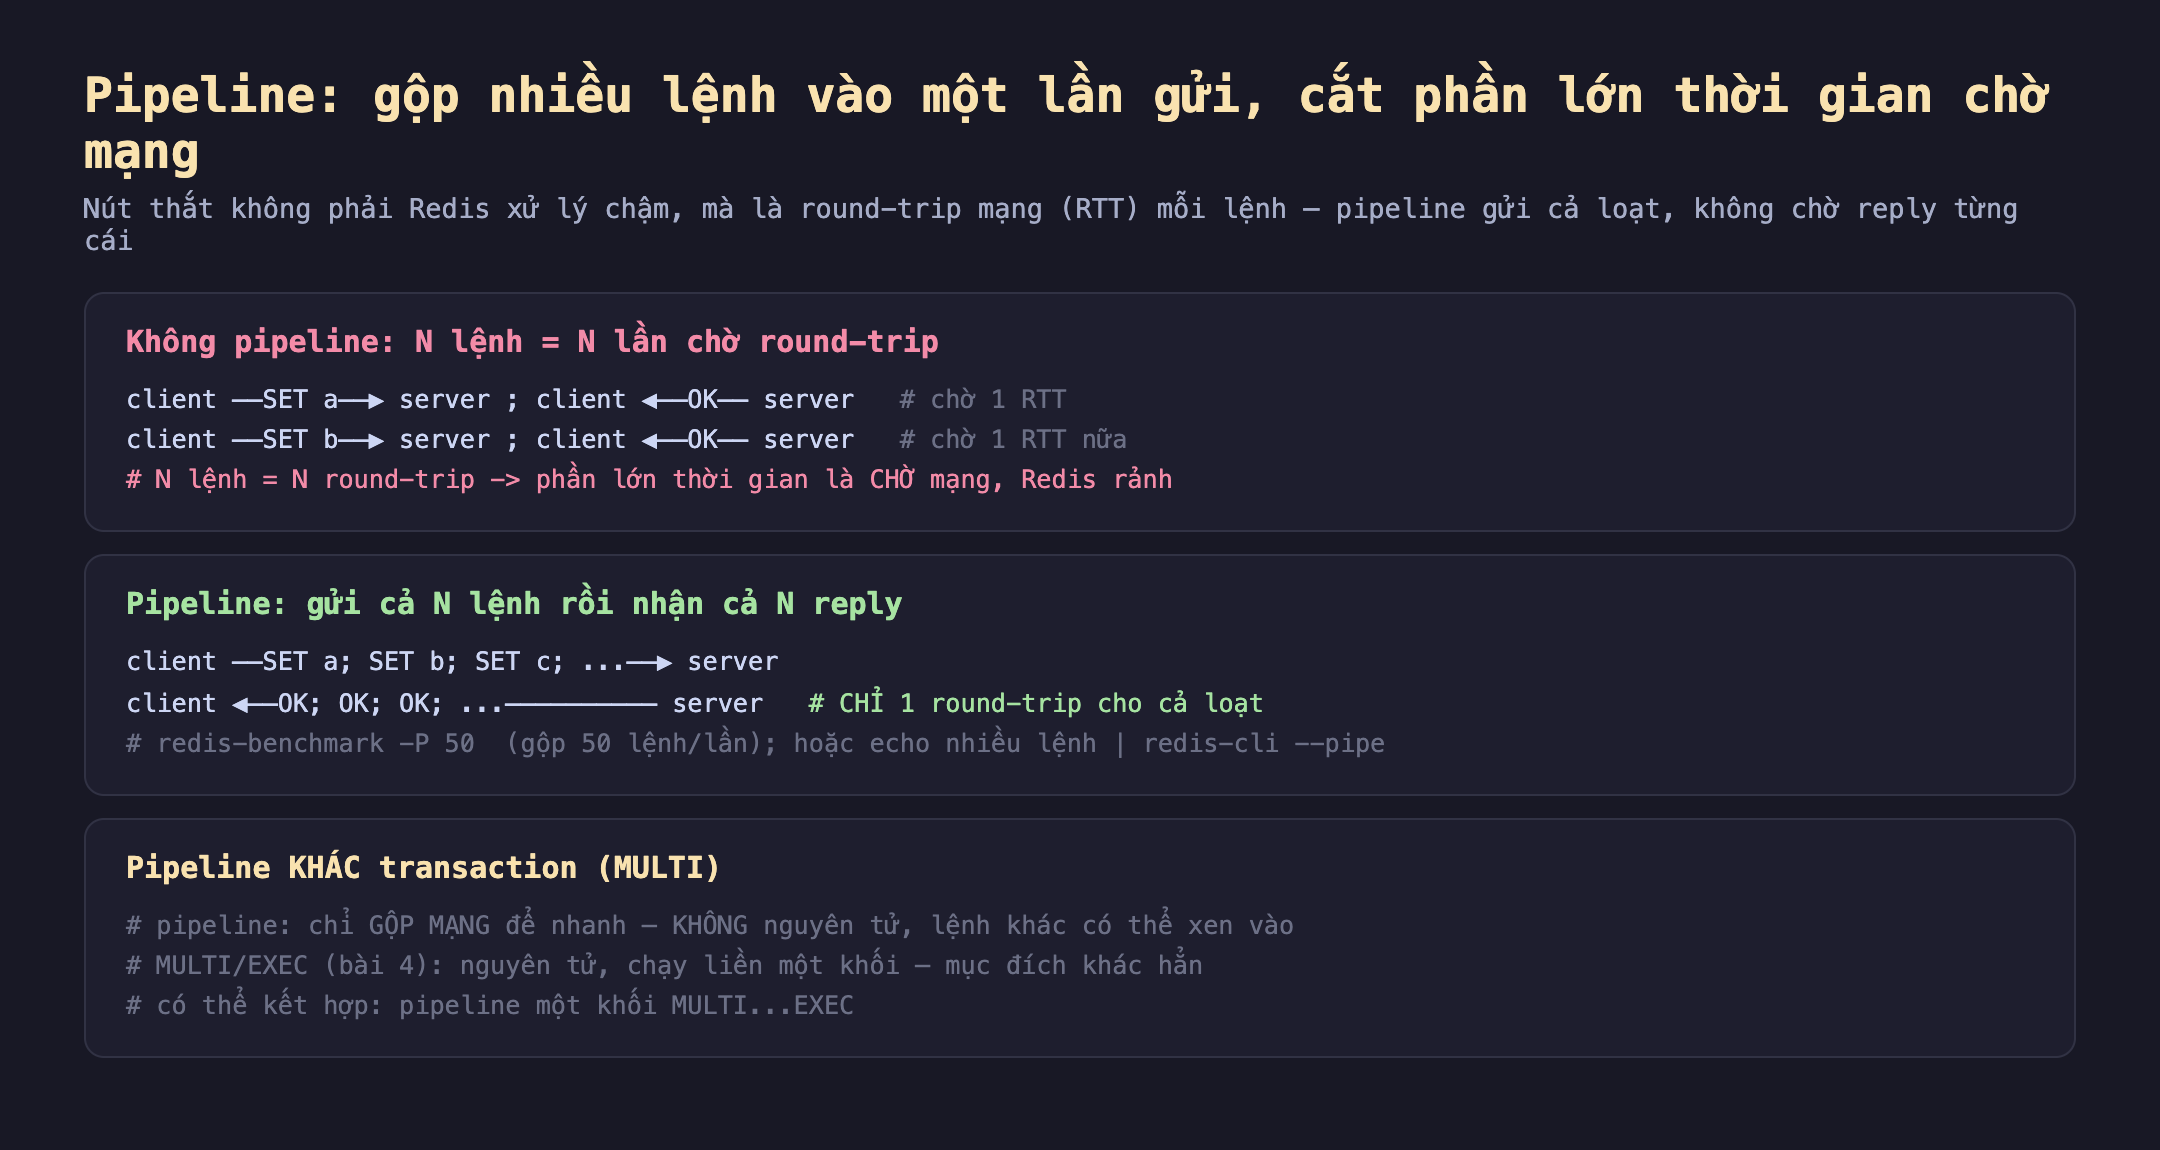
Hình 1: Không pipeline, N lệnh là N round-trip (phần lớn thời gian là chờ mạng). Pipeline gửi cả loạt, chỉ một round-trip cho N lệnh. Lưu ý: pipeline chỉ gộp mạng để nhanh — KHÁC transaction (MULTI/EXEC) vốn đảm bảo nguyên tử.
Dùng rất đơn giản: redis-benchmark -P 50 (gộp 50 lệnh/lần), hoặc echo <nhiều lệnh> | redis-cli --pipe, hoặc gọi API pipeline của client library.
Đo thật: throughput theo mức pipeline
Mình chạy redis-benchmark với SET, 200.000 lệnh, trên cùng một kết nối, chỉ đổi mức gộp -P:
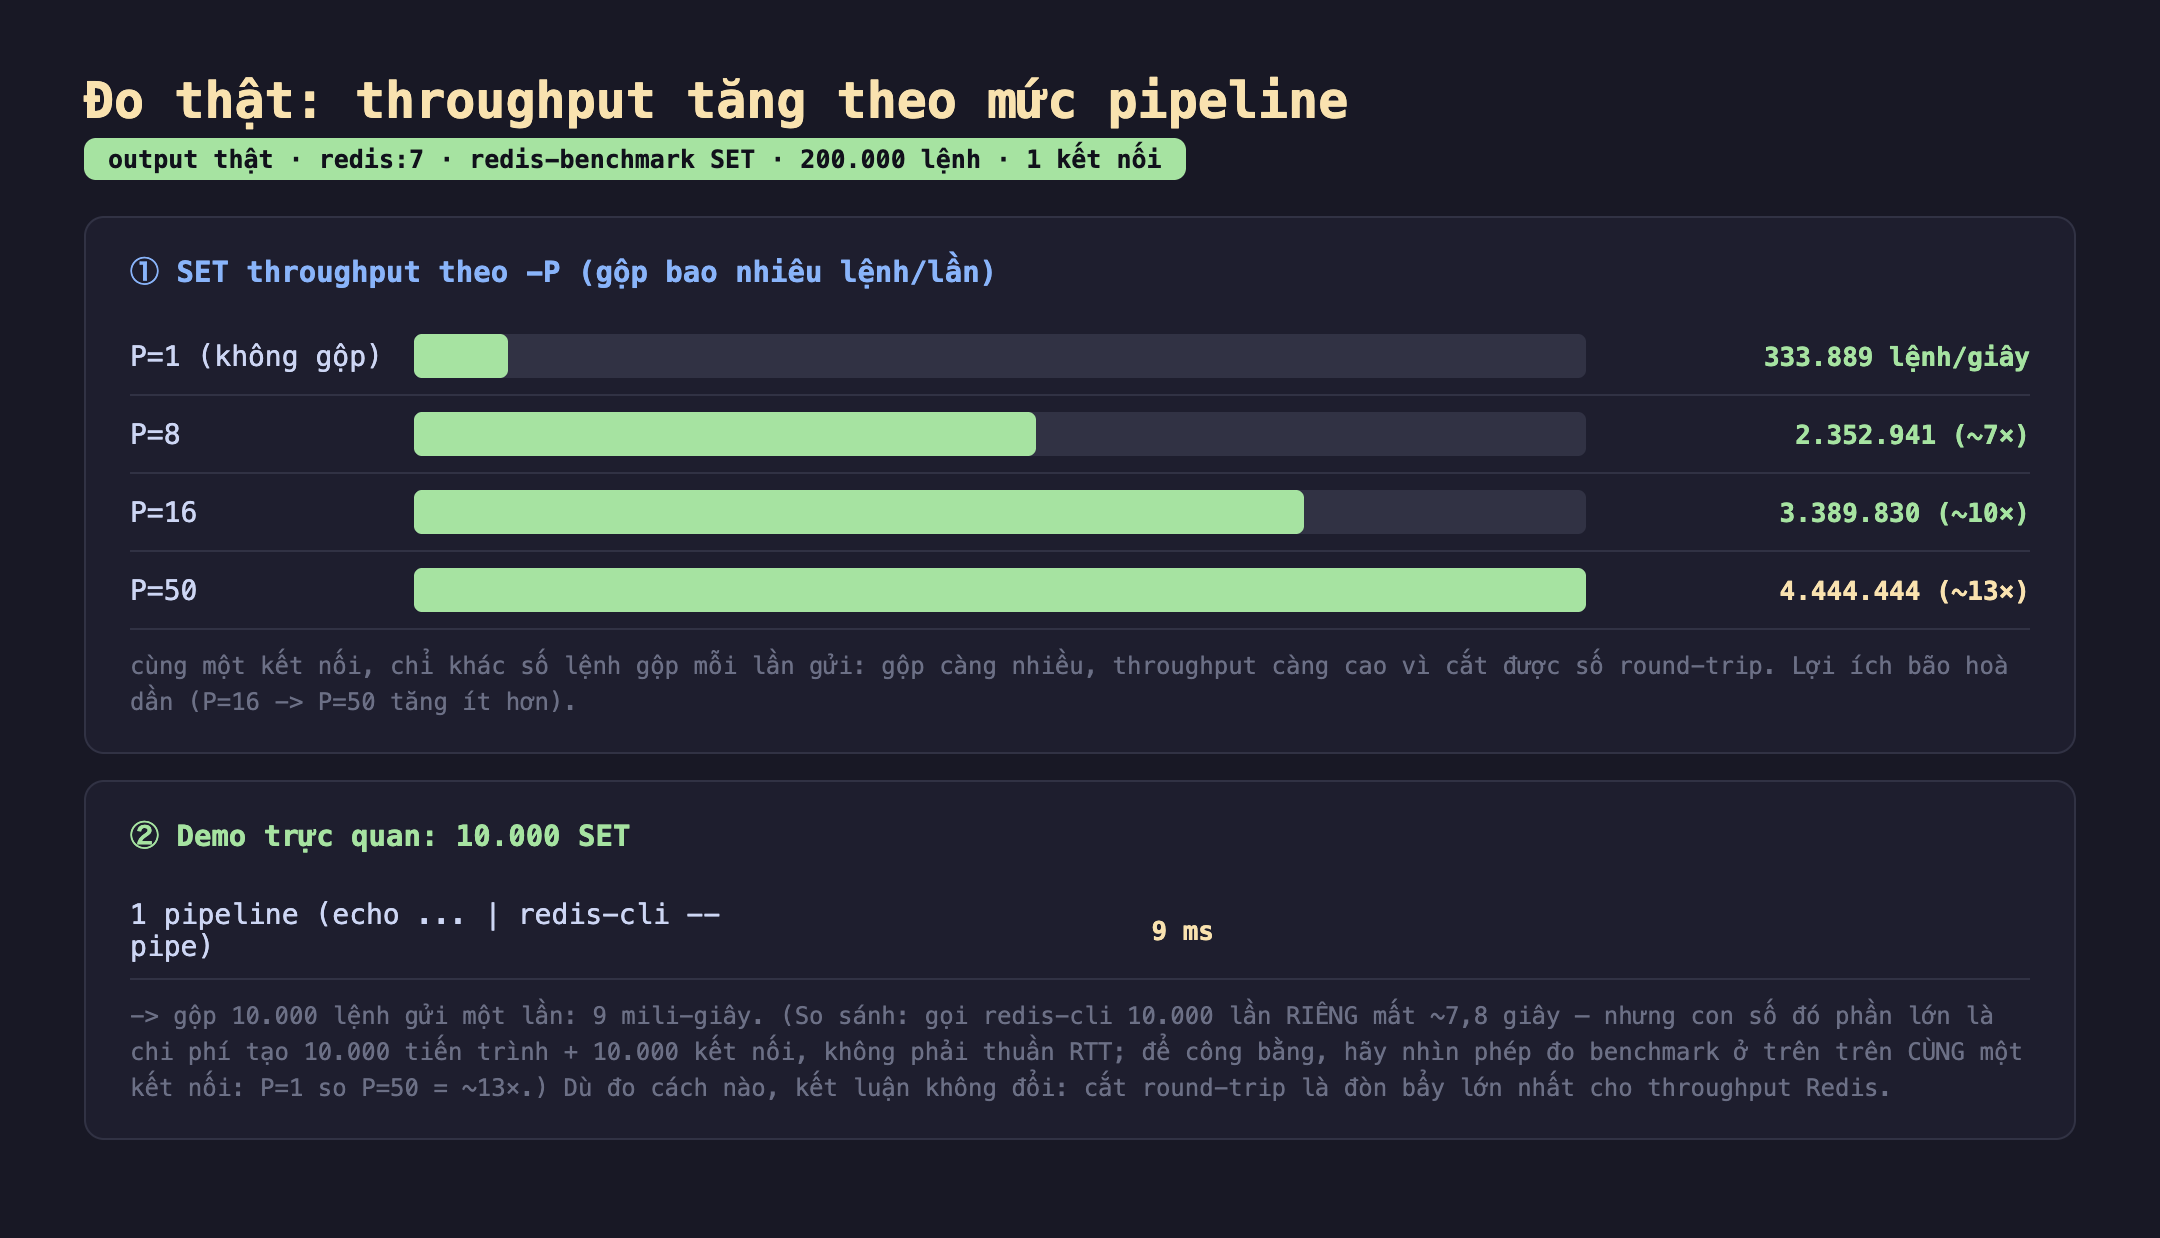
Hình 2: Đo thật. SET throughput: P=1 (không gộp) 333.889/giây, P=8 2.352.941 (~7×), P=16 3.389.830 (~10×), P=50 4.444.444 (~13×). 10.000 SET qua một pipeline --pipe chỉ 9 ms.
Kết quả thật:
- P=1: 333.889 lệnh/giây (không gộp — mỗi lệnh một round-trip).
- P=8: 2.352.941/giây (~7×), P=16: 3.389.830/giây (~10×), P=50: 4.444.444/giây (~13×).
Cùng một kết nối, cùng một Redis, chỉ khác số lệnh gộp mỗi lần gửi — throughput tăng tới 13 lần. Vì sao? Vì ở P=1, CPU và mạng phần lớn chờ; gộp lệnh lấp đầy thời gian chờ đó. Lưu ý lợi ích bão hoà dần: từ P=16 lên P=50 tăng ít hơn từ P=1 lên P=16 — vì khi round-trip không còn là nút thắt, giới hạn chuyển sang tốc độ xử lý thật của Redis.
Một lưu ý trung thực về demo --pipe. Mình cũng gộp 10.000 lệnh SET qua redis-cli --pipe và đo được 9 mili-giây. Để so sánh, chạy một vòng lặp gọi redis-cli SET 10.000 lần riêng mất ~7,8 giây. Con số 7,8 giây nghe sốc (gần 900×), nhưng phần lớn thời gian đó là chi phí tạo 10.000 tiến trình redis-cli + 10.000 kết nối mới, không phải thuần round-trip mạng — nên nó phóng đại lợi ích của pipeline. Phép đo công bằng là redis-benchmark -P ở trên: trên cùng một kết nối, P=1 so P=50 là ~13×. Mình nêu rõ điều này để không đánh lừa: pipeline thật sự nhanh, nhưng con số đúng là ~13×, không phải 900×.
Pipeline khác transaction
Một hiểu lầm phổ biến: pipeline không phải transaction. Pipeline chỉ gộp nhiều lệnh về mặt mạng để nhanh hơn — các lệnh không nguyên tử, và lệnh của client khác vẫn có thể xen vào giữa (vì Redis một luồng xử lý tuần tự, nhưng các lệnh trong pipeline của bạn không được "khoá" lại thành một khối). Nếu cần nguyên tử (nhiều lệnh chạy liền một khối, không ai xen vào), đó là việc của MULTI/EXEC — bài redis-04. Hai thứ giải hai bài toán khác nhau: pipeline cho tốc độ, transaction cho tính nguyên tử. Bạn thậm chí có thể kết hợp — gửi một khối MULTI...EXEC qua pipeline.
Đánh đổi cần cân nhắc
Pipeline quá lớn làm tăng độ trễ và ngốn bộ nhớ. Gộp càng nhiều throughput càng cao, nhưng một pipeline khổng lồ (hàng triệu lệnh) giữ toàn bộ reply trong buffer cho tới khi đọc hết — tốn RAM cả hai phía, và lệnh đầu tiên phải chờ cả loạt gửi xong mới có reply (độ trễ của từng lệnh lẻ tăng). Thực tế gộp theo lô vừa phải (vài chục tới vài trăm lệnh/lần) cho hầu hết lợi ích mà không ôm rủi ro. Đừng gộp hết mười nghìn lệnh vào một pipeline chỉ vì có thể.
Pipeline chỉ hợp khi bạn có SẴN nhiều lệnh độc lập. Lợi ích đến từ việc biết trước một loạt lệnh để gửi cùng lúc. Nếu logic cần kết quả lệnh này để quyết định lệnh sau (phụ thuộc tuần tự), không pipeline được — phải chờ. Pipeline hợp cho: nạp hàng loạt (bulk load), đọc nhiều key cùng lúc, ghi batch. Không hợp cho luồng request-phụ-thuộc.
Pipeline không sửa được lệnh chậm. Pipeline cắt thời gian chờ mạng, không làm Redis xử lý mỗi lệnh nhanh hơn. Nếu bạn gộp 100 lệnh SMEMBERS trên các set khổng lồ, mỗi lệnh vẫn O(n) chặn server (bài 1) — pipeline không cứu được, chỉ gộp phần mạng. Vấn đề hiệu năng do lệnh nặng phải giải bằng chọn đúng cấu trúc/lệnh, không phải pipeline.
Ba ý mang về
- Nút thắt throughput Redis thường là round-trip mạng, không phải Redis. Mỗi lệnh gửi-chờ-reply tốn một round-trip; với lệnh nhẹ, phần lớn thời gian là chờ. Pipeline gộp N lệnh vào một lần gửi để cắt số round-trip.
- Gộp lệnh tăng throughput tới ~13 lần (đo thật, cùng kết nối). SET: P=1 333.889/giây → P=50 4.444.444/giây. Lợi ích bão hoà dần khi round-trip không còn là nút thắt. (Con số 900× từ demo
--pipebị phóng đại bởi chi phí tạo tiến trình — con số công bằng là ~13×.) - Pipeline ≠ transaction, và không phải thuốc chữa bách bệnh. Pipeline chỉ gộp mạng (không nguyên tử — dùng MULTI/EXEC cho nguyên tử); chỉ hợp khi có sẵn nhiều lệnh độc lập; gộp lô vừa phải; và không cứu được lệnh O(n) nặng.
Nguồn
- Redis — Pipelining: https://redis.io/docs/latest/develop/use/pipelining/
- Redis — redis-cli --pipe (mass insertion): https://redis.io/docs/latest/develop/use/mass-insertion/
- Redis — Benchmark pipeline (-P): https://redis.io/docs/latest/operate/oss_and_stack/management/optimization/benchmarks/
Phần sau ta sang tính nguyên tử: MULTI/EXEC và WATCH cho giao dịch, và script Lua chạy nguyên tử phía server — khi nào cần chúng và khác pipeline ra sao.
