Ứng dụng của bạn đọc nhiều hơn ghi rất nhiều — trang sản phẩm, tìm kiếm, báo cáo, dashboard. Một máy chủ primary duy nhất gồng gánh cả ghi lẫn đọc sẽ đến lúc quá tải. Bài trước ta đã dựng một streaming replica — một bản sao nóng chỉ đọc. Bài này khai thác chính nó cho mục đích mở rộng: đưa truy vấn đọc sang replica để giải phóng primary, và cộng thêm năng lực đọc. Tôi đo thật trên hai node đang chạy để xem thông lượng tăng bao nhiêu.
Ý tưởng: tách đường ghi và đường đọc
Nguyên tắc đơn giản: ghi đi primary, đọc đi replica. Mọi INSERT/UPDATE/DELETE phải qua primary (replica từ chối ghi). Nhưng SELECT thì có thể đi tới bất kỳ replica nào — và mỗi replica gánh một phần tải đọc, nên tổng năng lực đọc của hệ thống tăng theo số node.
-- Ép một nhánh giao dịch chỉ đọc (dễ định tuyến sang replica)
SET default_transaction_read_only = on;
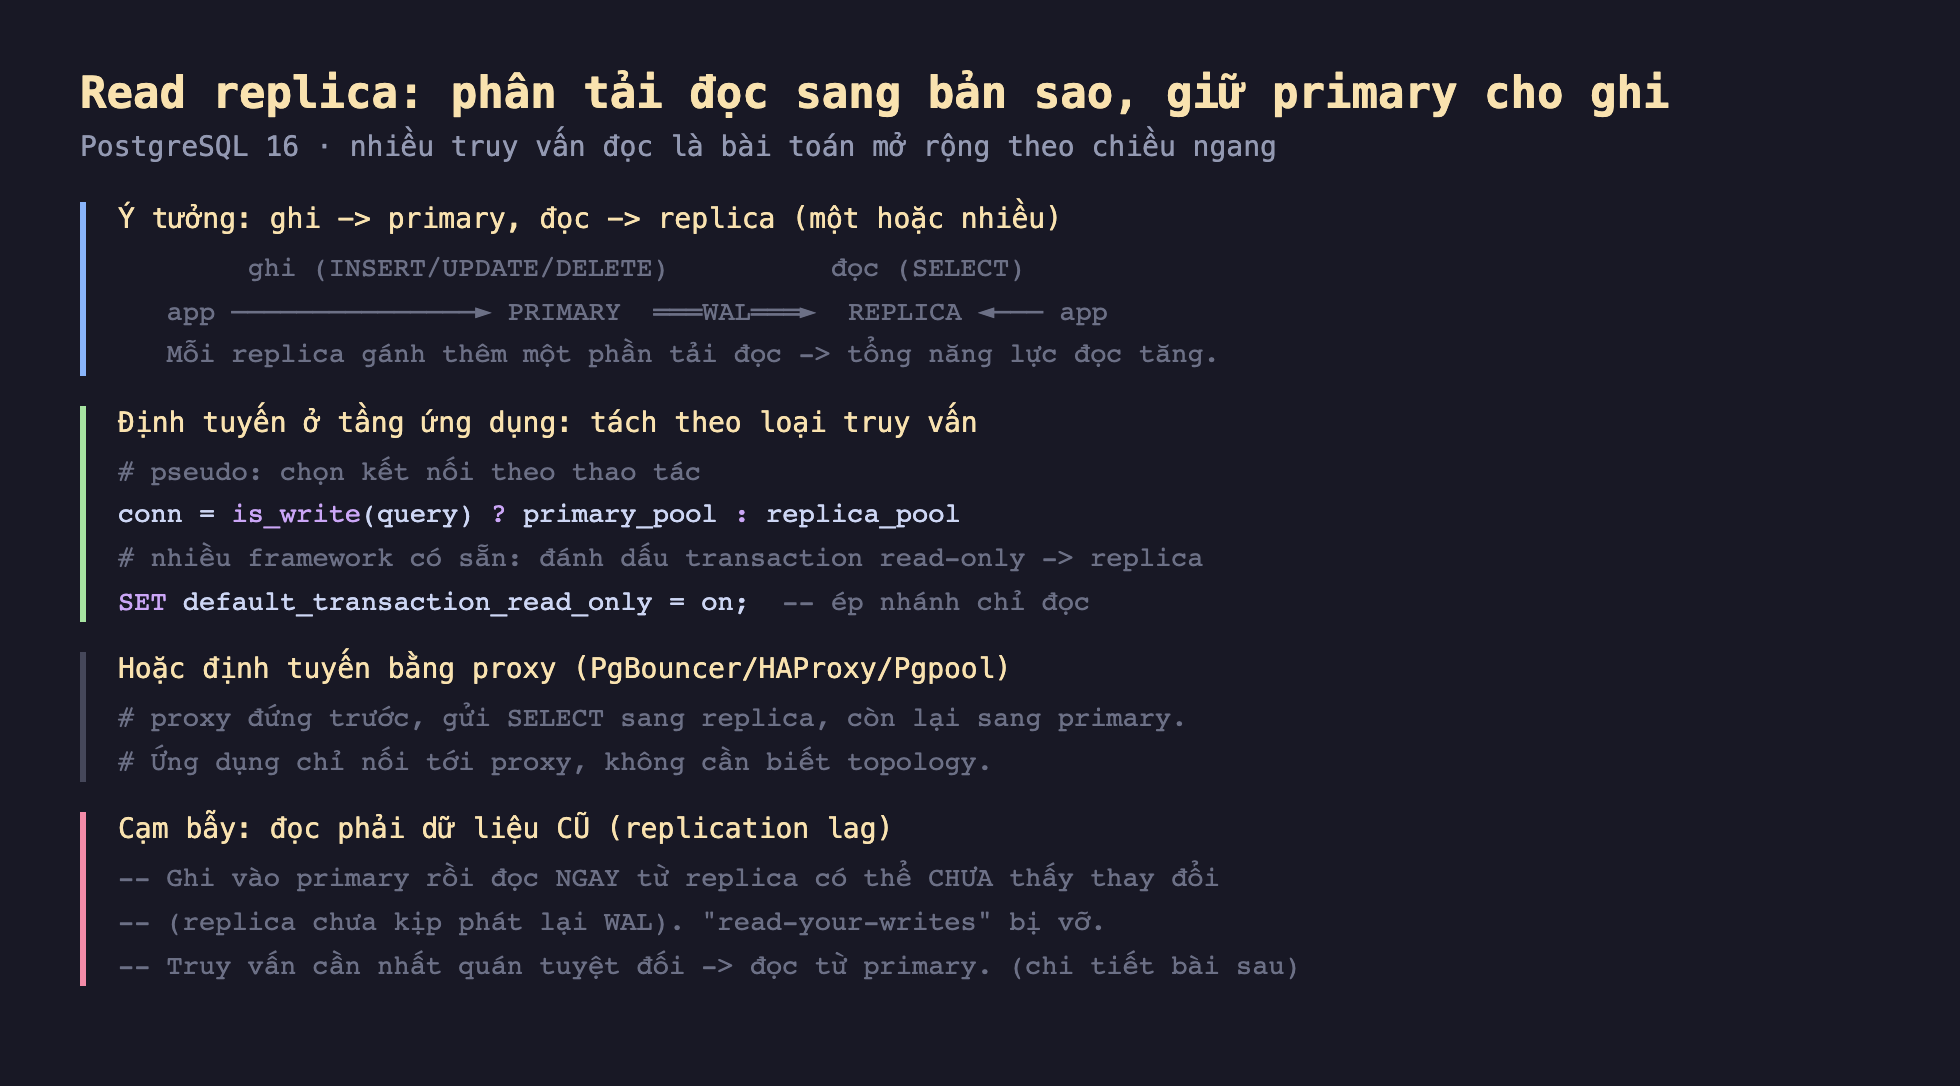
Hình 1: Ghi đi primary, đọc đi replica. Định tuyến ở tầng ứng dụng (theo loại truy vấn) hoặc bằng proxy. Cạm bẫy: đọc ngay sau khi ghi có thể thấy dữ liệu cũ do replication lag.
Đo thật: thông lượng đọc gấp 2,6 lần
Tôi có primary và replica đang streaming với cùng một triệu dòng dữ liệu. Truy vấn đọc cho kết quả giống hệt trên cả hai (SELECT count(*) WHERE gia > 500 → 500.272 ở cả primary lẫn replica). Giờ đo thông lượng đọc bằng pgbench (chế độ chỉ đọc, 8 client):
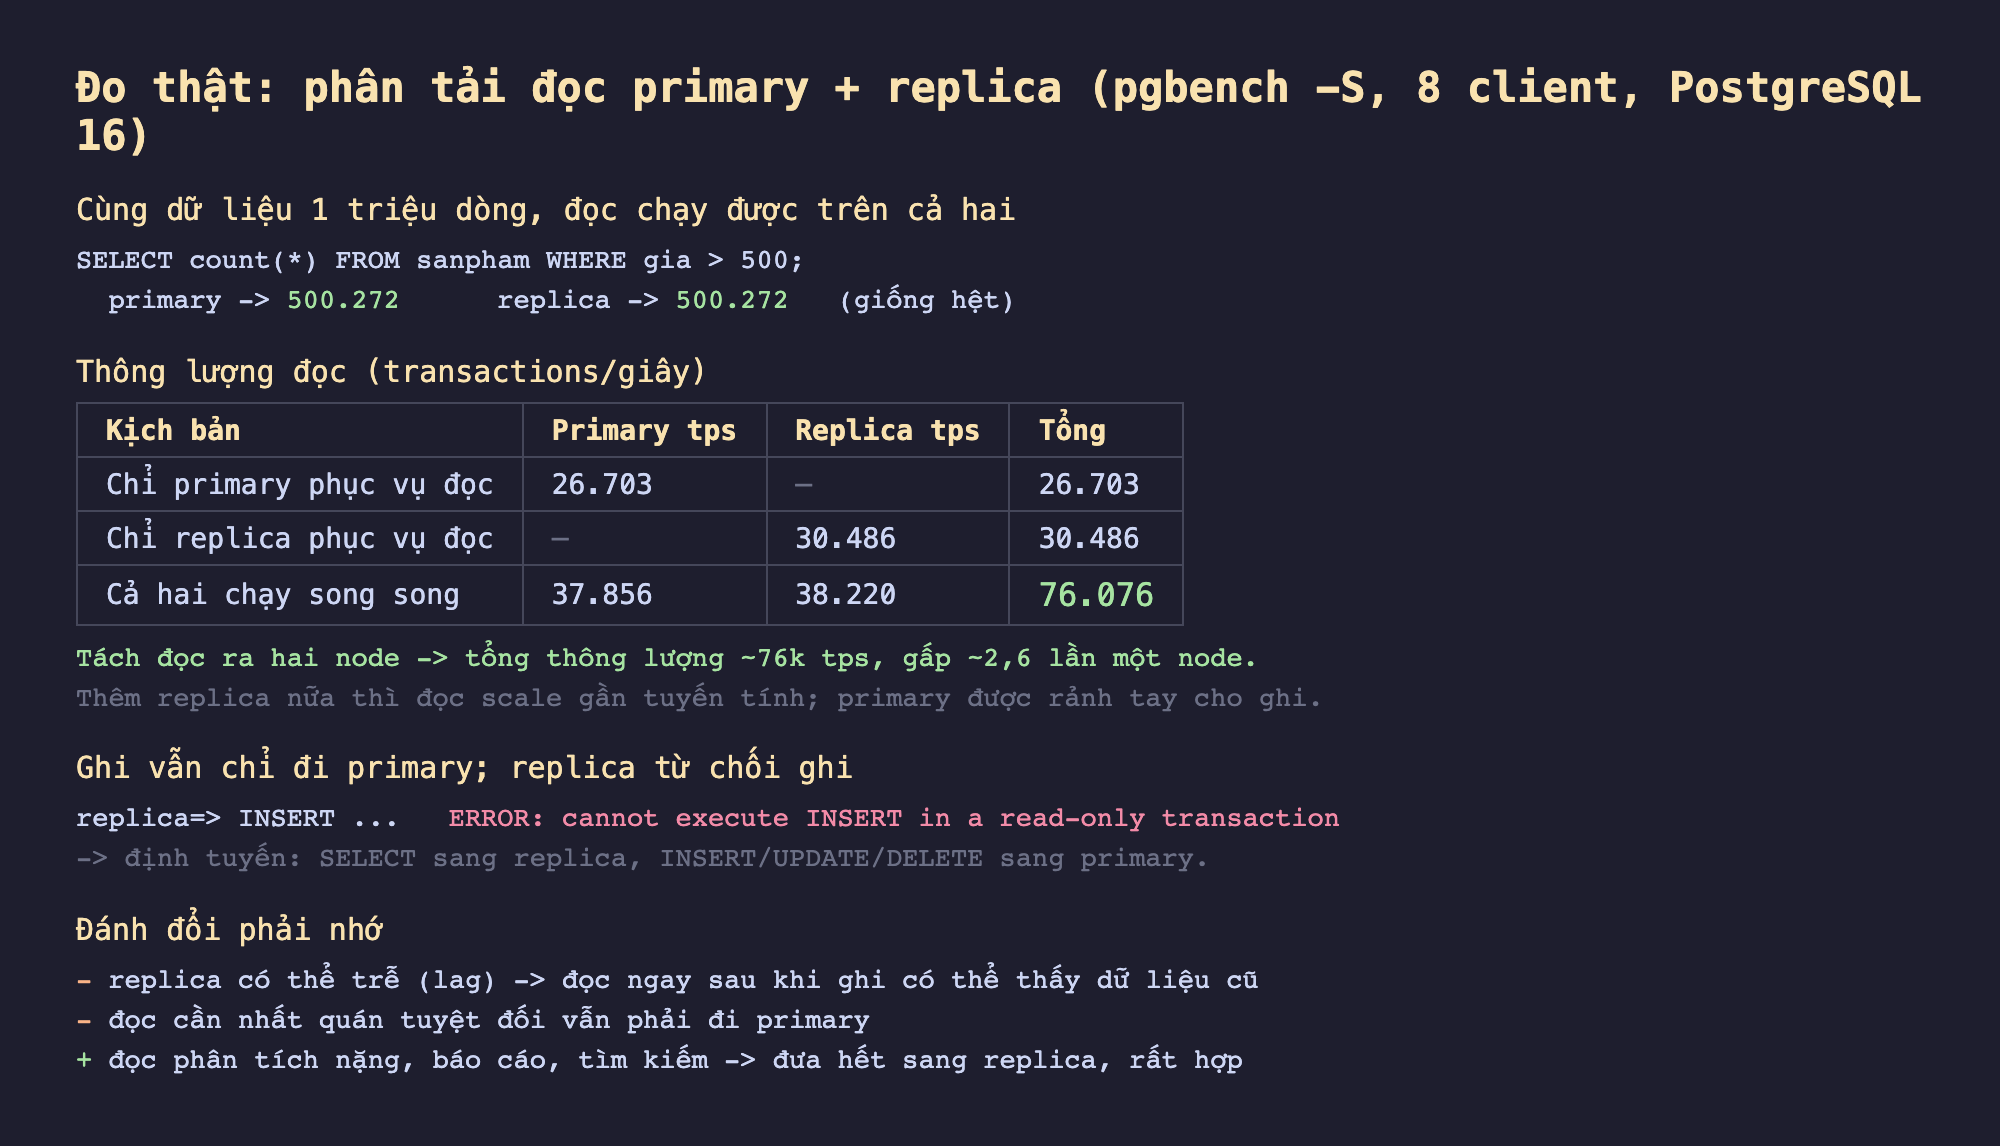
Hình 2: Chỉ primary phục vụ đọc: 26.703 tps. Chỉ replica: 30.486 tps. Cả hai chạy song song: primary 37.856 + replica 38.220 = 76.076 tps — gấp ~2,6 lần một node. Ghi vẫn chỉ đi primary; replica từ chối ghi.
Con số thật:
- Chỉ primary phục vụ đọc: 26.703 tps.
- Chỉ replica phục vụ đọc: 30.486 tps (mỗi node đọc độc lập được).
- Cả hai chạy song song: primary 37.856 + replica 38.220 = 76.076 tps cộng lại.
Khi tải đọc được chia ra hai node, tổng thông lượng đạt ~76 nghìn tps — gấp khoảng 2,6 lần so với một node đơn lẻ. Thêm replica thứ hai, thứ ba thì năng lực đọc scale gần như tuyến tính. Và quan trọng không kém: khi reads đổ sang replica, primary được rảnh tay để tập trung xử lý ghi — thứ mà không thể phân tán.
Định tuyến: ứng dụng hay proxy
Có hai cách phổ biến để "gửi đọc sang replica":
Ở tầng ứng dụng. Code chọn kết nối theo loại thao tác: ghi → pool tới primary, đọc → pool tới replica. Nhiều framework hỗ trợ sẵn (đánh dấu một giao dịch là read-only thì tự định tuyến sang replica). Cách này linh hoạt nhưng lập trình viên phải nhớ phân loại đúng.
Bằng proxy. Một proxy (PgBouncer/HAProxy/Pgpool-II) đứng trước, tự nhận diện SELECT và gửi sang replica, còn lại sang primary. Ứng dụng chỉ nối tới proxy, không cần biết có bao nhiêu replica hay chúng ở đâu. Đổi lại thêm một tầng phải vận hành và giám sát.
Đánh đổi cần cân nhắc
Cạm bẫy lớn nhất: đọc phải dữ liệu cũ. Replica async luôn trễ sau primary một chút (replication lag). Nếu bạn ghi vào primary rồi đọc ngay từ replica, có thể replica chưa kịp phát lại thay đổi đó — bạn thấy dữ liệu cũ. Đây là vấn đề "read-your-writes": người dùng vừa sửa hồ sơ, tải lại trang thấy dữ liệu cũ. Với thao tác cần nhất quán tuyệt đối (ngay sau khi ghi), phải đọc từ primary. Bài sau đo cụ thể độ trễ này và cách xử lý.
Không phải mọi truy vấn nên đi replica. Phù hợp nhất cho replica: báo cáo, phân tích nặng, tìm kiếm, dashboard — những thứ đọc nhiều và chấp nhận dữ liệu trễ vài giây. Không phù hợp: đọc ngay sau ghi trong cùng luồng nghiệp vụ, kiểm tra số dư trước khi trừ tiền, bất cứ thứ gì yêu cầu thấy trạng thái mới nhất tuyệt đối.
Replica cũng tiêu tài nguyên và cần vận hành. Mỗi replica là một máy chủ đầy đủ cần RAM, đĩa, giám sát. Nó không "miễn phí" — chỉ đáng khi tải đọc thật sự lớn. Với ứng dụng nhỏ, tối ưu truy vấn và index trên một node thường đủ và đơn giản hơn nhiều.
Ba ý mang về
- Read replica cộng thêm năng lực đọc theo chiều ngang: đo thật, tách tải đọc ra hai node cho tổng 76.076 tps (primary 37.856 + replica 38.220) — gấp ~2,6 lần một node đơn lẻ, và primary được giải phóng để lo phần ghi không phân tán được.
- Định tuyến ghi-sang-primary, đọc-sang-replica ở tầng ứng dụng (chọn pool theo loại truy vấn) hoặc bằng proxy (PgBouncer/HAProxy/Pgpool tự nhận diện SELECT) — replica từ chối ghi nên phân loại sai một câu ghi sẽ báo lỗi rõ ràng.
- Cạm bẫy là đọc phải dữ liệu cũ do replication lag: đọc ngay sau khi ghi có thể chưa thấy thay đổi (read-your-writes vỡ) — đưa báo cáo/phân tích/tìm kiếm sang replica, giữ các đọc cần nhất quán tuyệt đối ở primary.
Phần sau ta mổ xẻ chính con số quyết định tất cả: Phần sau đo replication lag thật — cách đo bằng LSN và thời gian, điều gì làm nó tăng, và hệ quả cụ thể lên tính đúng đắn của ứng dụng.
