Bài trước ta thấy read replica tăng thông lượng đọc, nhưng kèm một cảnh báo: đọc từ replica có thể thấy dữ liệu cũ. Con số đứng sau lời cảnh báo đó là replication lag — khoảng cách giữa những gì primary đã ghi và những gì replica đã phát lại. Bài này không nói chung chung: tôi đo lag bằng cả byte lẫn giây, rồi cố ý làm nó phình lên để bạn thấy tận mắt hệ quả — replica trả về dữ liệu cũ trong khi primary đã có dữ liệu mới.
Lag là gì, và ba mức của nó
Nhớ lại cơ chế: primary ghi thay đổi vào WAL, gửi WAL sang replica, replica phát lại (replay) để cập nhật bảng của mình. Mỗi bước có độ trễ riêng, nên PostgreSQL cho ba con số:
- write_lag: từ khi primary ghi tới khi replica nhận được WAL.
- flush_lag: tới khi replica ghi WAL xuống đĩa (an toàn dữ liệu).
- replay_lag: tới khi replica phát lại xong — tức dữ liệu thấy được khi bạn đọc.
Đọc từ replica quan tâm nhất tới replay_lag, vì đó là lúc dữ liệu thực sự hiện ra trong truy vấn.
-- Đo từ PRIMARY:
SELECT application_name,
  pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS lag_byte,
  write_lag, flush_lag, replay_lag
FROM pg_stat_replication;
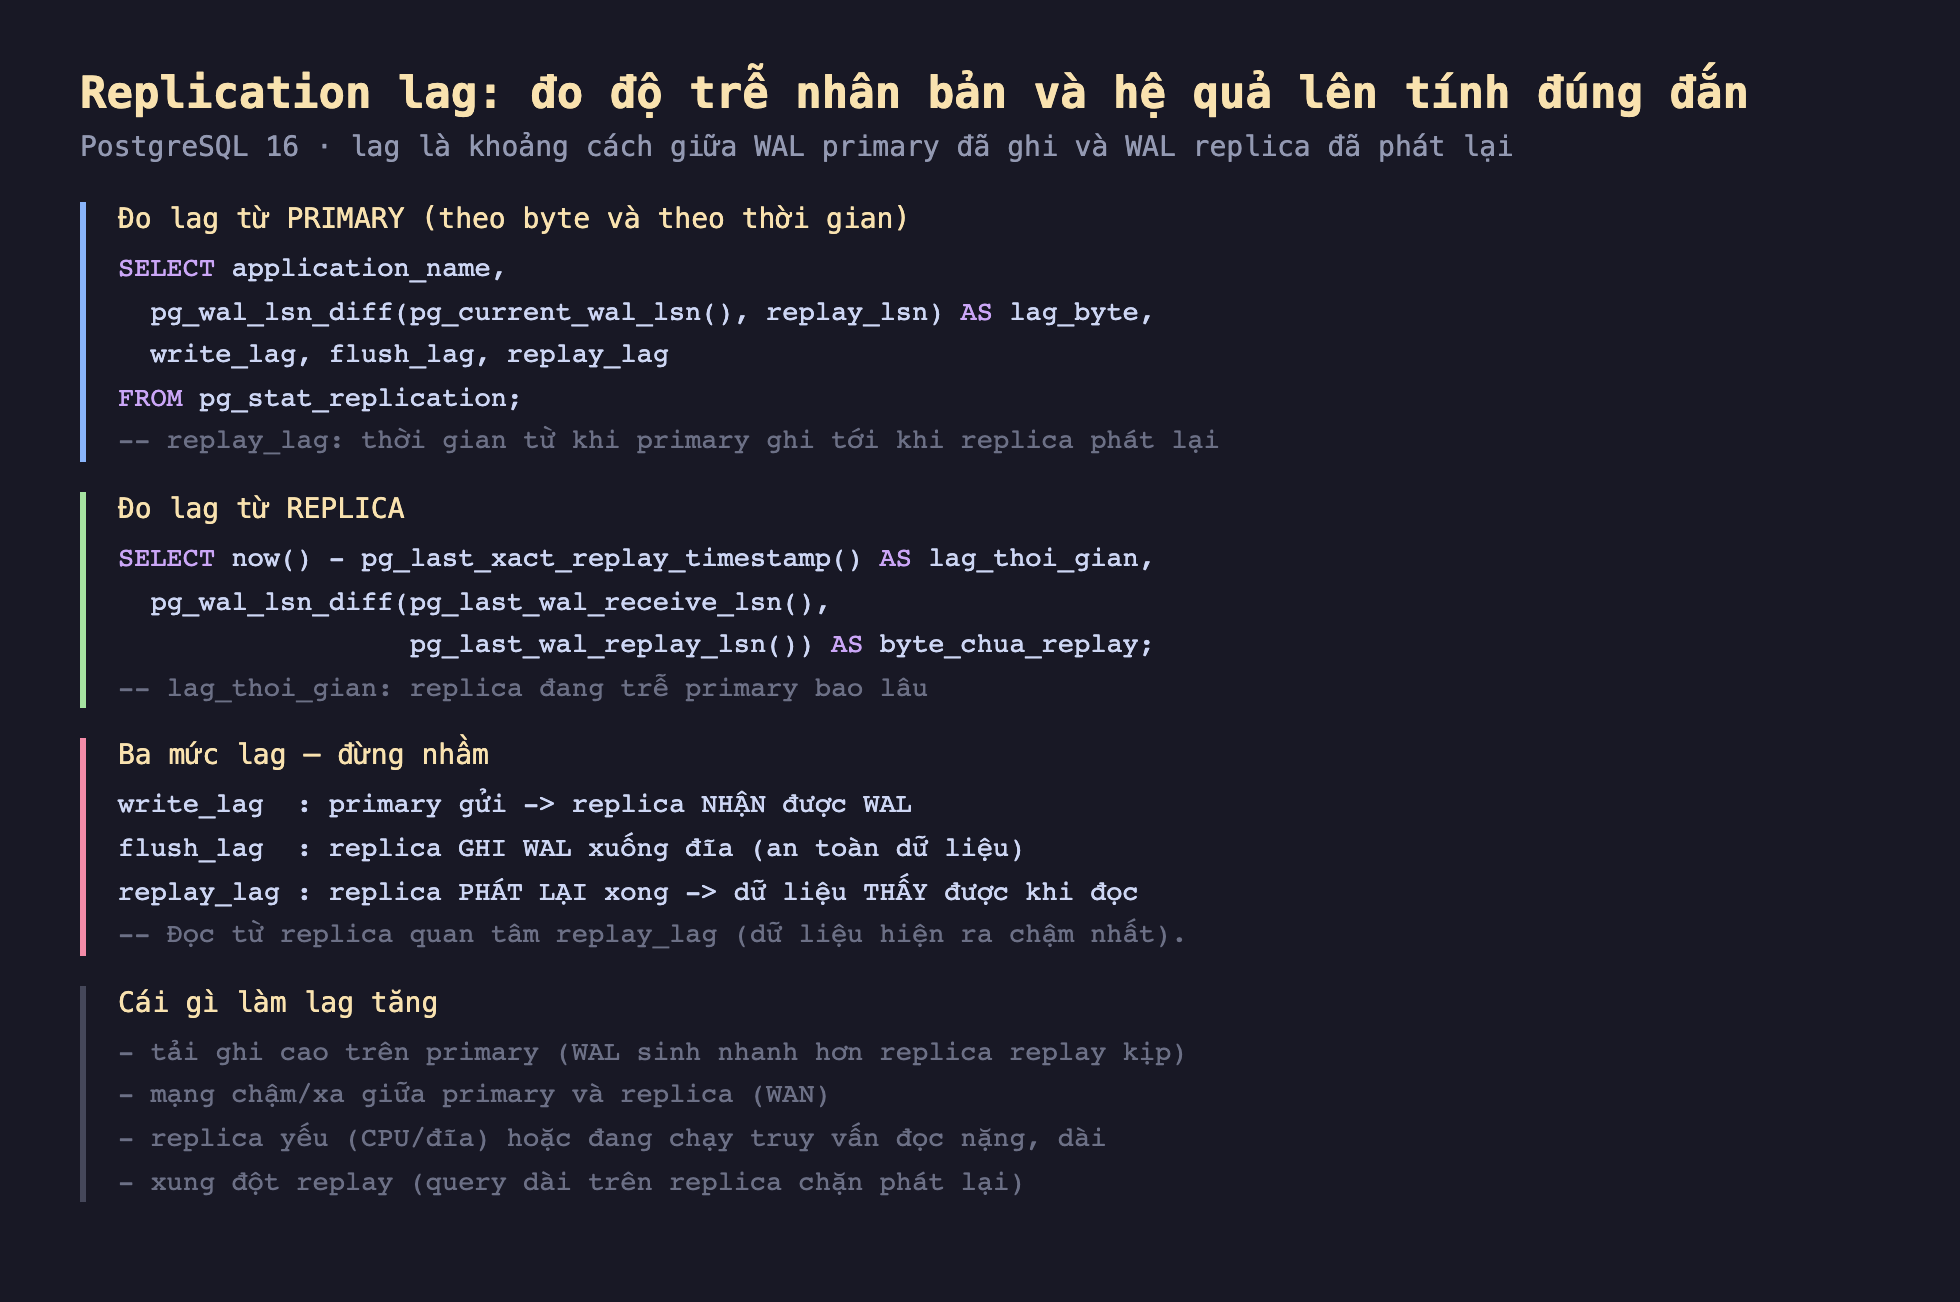
Hình 1: Đo lag từ primary (pg_stat_replication) và từ replica (pg_last_xact_replay_timestamp). Ba mức write/flush/replay — đọc từ replica quan tâm replay_lag. Và những nguyên nhân làm lag tăng.
Đo thật: làm lag phình lên và thấy dữ liệu cũ
Ở điều kiện bình thường trên lab của tôi, replica bám sát primary: replay_lag chỉ khoảng 0,002 giây (2 mili giây), primary và replica đều thấy 1.000 dòng. Lag gần như bằng không.
Để thấy hệ quả, tôi cố ý làm replica chậm lại bằng pg_wal_replay_pause() — tạm dừng việc phát lại WAL (mô phỏng một replica quá tải hoặc mạng nghẽn). Rồi ghi 500.000 dòng vào primary:
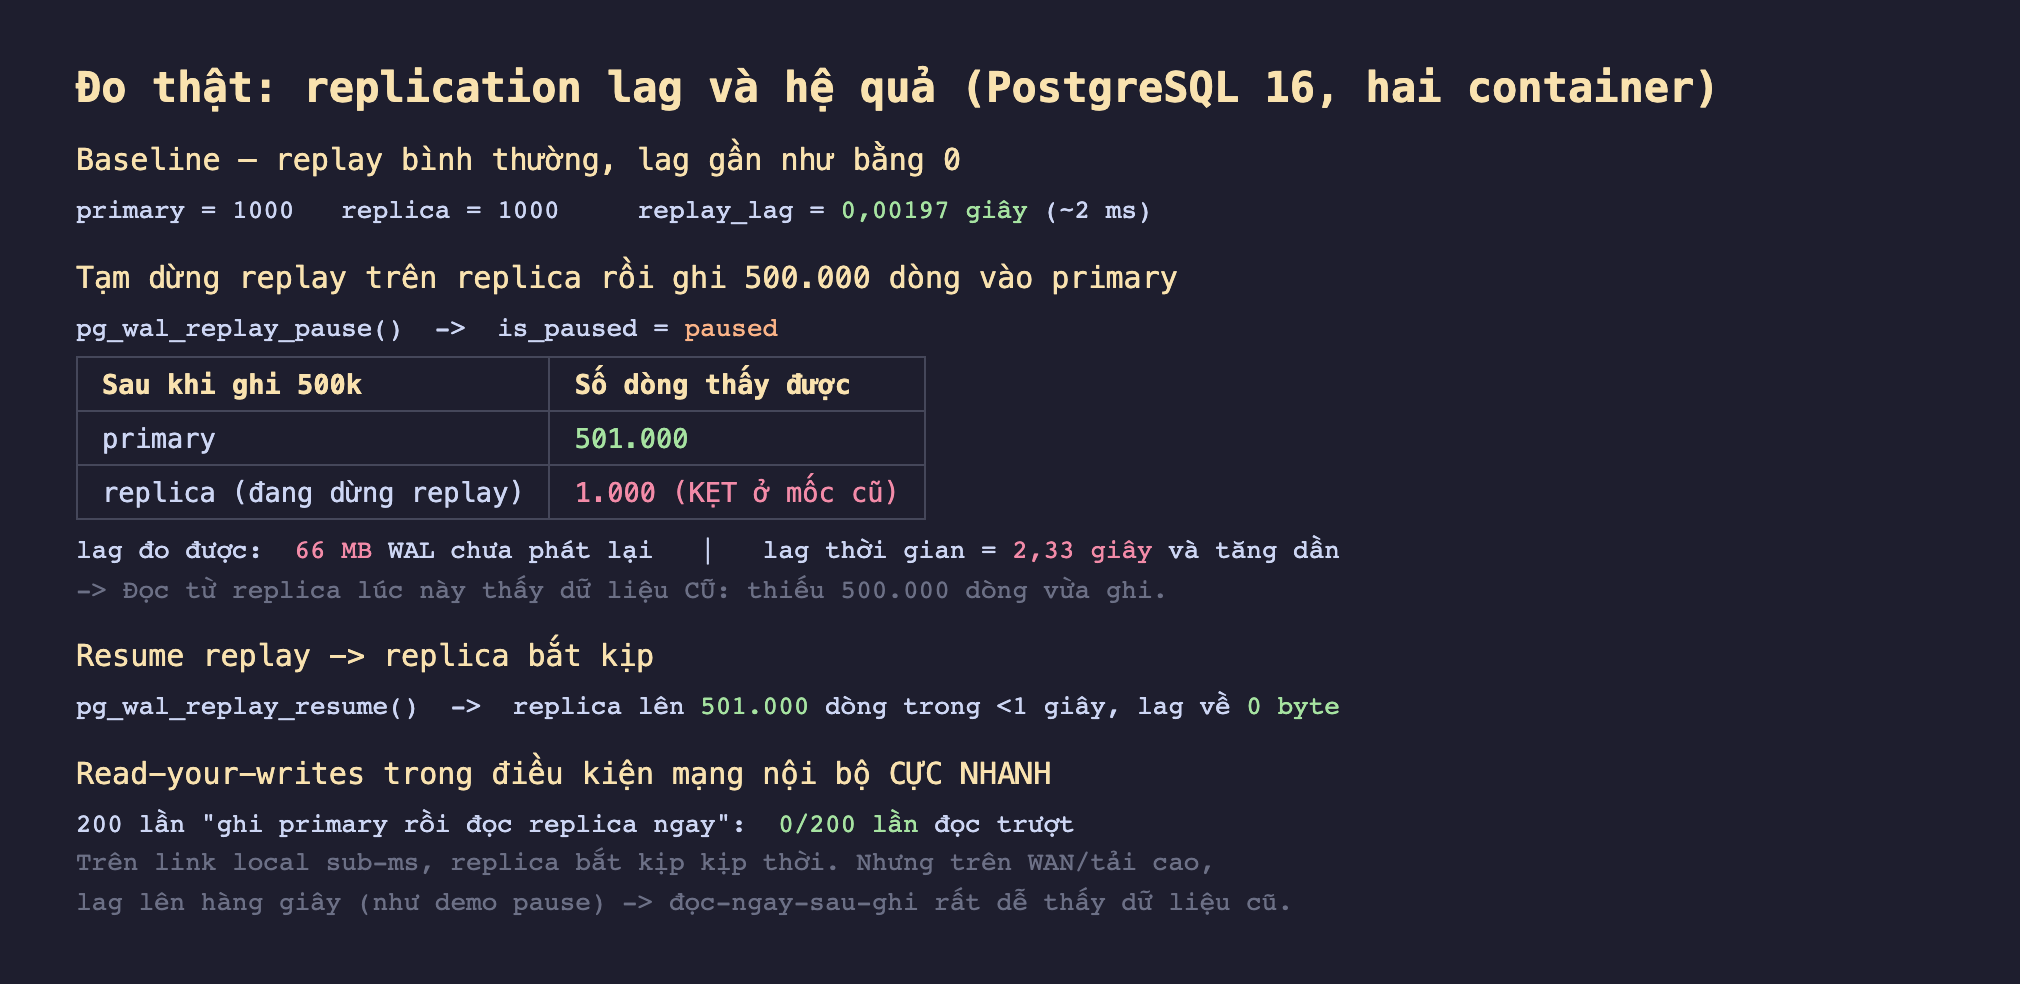
Hình 2: Baseline replay_lag ~2 ms. Sau khi dừng replay và ghi 500k: primary có 501.000 dòng, replica kẹt ở 1.000 (66 MB WAL chưa phát lại, lag 2,33 giây và tăng). Resume: bắt kịp trong dưới 1 giây, lag về 0. Read-your-writes trên link local nhanh: 0/200 trượt.
Kết quả thật rất rõ:
- Primary: 501.000 dòng.
- Replica (đang dừng replay): vẫn 1.000 dòng — kẹt cứng ở mốc cũ.
- Lag đo được: 66 MB WAL chưa phát lại, và lag thời gian 2,33 giây tăng dần.
Đây chính là "đọc phải dữ liệu cũ" thành hiện thực: nếu ứng dụng đọc bảng này từ replica ngay lúc đó, nó sẽ thiếu 500.000 dòng vừa ghi — một sai lệch tính đúng đắn, không phải chỉ chậm. Khi tôi pg_wal_replay_resume(), replica bắt kịp lên 501.000 dòng trong dưới một giây và lag về 0 byte.
Trung thực về điều kiện lab
Tôi cũng thử kịch bản "read-your-writes" trong điều kiện bình thường (không dừng replay): ghi một dòng vào primary rồi đọc ngay từ replica, lặp 200 lần. Kết quả: 0/200 lần replica trượt — nó luôn kịp thấy dòng vừa ghi.
Đây là con số thật và cần nói thẳng: trên mạng docker nội bộ với độ trễ dưới một mili giây, replica bắt kịp gần như tức thì, nên race hiếm khi xảy ra. Nhưng điều đó không có nghĩa vấn đề không tồn tại — demo dừng replay ở trên chứng minh lag có thể lên hàng giây rất dễ dàng. Trên hệ thống thật (replica ở data center khác, tải ghi cao, replica đang chạy truy vấn phân tích nặng), lag hàng giây là chuyện thường, và khi đó "đọc ngay sau khi ghi" từ replica sẽ thường xuyên thấy dữ liệu cũ.
Cái gì làm lag tăng, và cách giảm
Nguyên nhân chính: tải ghi cao trên primary (WAL sinh nhanh hơn replica replay kịp), mạng chậm hoặc xa (WAN), replica yếu về CPU/đĩa, hoặc một truy vấn đọc dài trên replica chặn việc phát lại (xung đột replay). Con số replay_lag trong pg_stat_replication là thứ cần giám sát liên tục.
Giảm lag: cho replica phần cứng đủ mạnh (nhất là đĩa), đặt replica gần primary về mạng, và với truy vấn đọc dài trên replica cân nhắc max_standby_streaming_delay (đánh đổi giữa để query chạy xong hay ưu tiên replay). Nếu ứng dụng thật sự cần đọc thấy ghi của chính mình, đừng chống lag — hãy đọc từ primary cho những truy vấn đó, hoặc dùng synchronous replication (bài sau).
Đánh đổi cần cân nhắc
Giám sát lag là bắt buộc khi dùng read replica. Một replica lag mà không ai biết là một quả bom: ứng dụng vẫn đọc từ nó và âm thầm trả dữ liệu cũ cho người dùng. Đặt cảnh báo khi replay_lag vượt ngưỡng bạn chấp nhận được (ví dụ vài giây).
Lag byte và lag thời gian nói hai chuyện khác nhau. Lag byte (66 MB) cho biết khối lượng WAL tồn đọng; lag thời gian (2,33 giây) cho biết dữ liệu cũ bao lâu. Khi primary im (không ghi), lag byte có thể 0 nhưng lag thời gian vẫn nhích lên vì đồng hồ chạy — dùng đúng con số cho đúng câu hỏi.
Đừng để replica lag làm đầy WAL trên primary. Nếu dùng replication slot (như ta đã dựng), primary giữ WAL cho tới khi replica nhận. Replica lag nặng và kéo dài khiến pg_wal trên primary phình to — theo dõi và cân nhắc max_slot_wal_keep_size để primary không sập vì hết đĩa.
Ba ý mang về
- Replication lag là khoảng cách giữa WAL primary đã ghi và replica đã phát lại, đo bằng byte (
pg_wal_lsn_diff) và giây (replay_lag) — ba mức write/flush/replay, trong đó đọc từ replica quan tâmreplay_lagvì đó là lúc dữ liệu hiện ra. - Lag có hệ quả thật lên tính đúng đắn: đo thật, khi làm replica chậm lại, nó kẹt ở 1.000 dòng trong khi primary có 501.000 (66 MB chưa replay, 2,33 giây) — đọc từ replica lúc đó thiếu nửa triệu dòng vừa ghi, một sai lệch chứ không chỉ là chậm.
- Trên link nhanh replica bắt kịp gần tức thì (0/200 lần trượt) nhưng đừng dựa vào đó: trên WAN hoặc tải ghi cao lag lên hàng giây — giám sát
replay_lag, đọc từ primary cho các truy vấn cần thấy ghi của chính mình, và canh WAL slot để primary không đầy đĩa.
Phần sau ta đi vào đúng cơ chế quyết định độ bền và độ trễ đó: Phần sau đo nhân bản đồng bộ và bất đồng bộ — vì sao sync không mất dữ liệu nhưng làm mỗi commit chậm hơn, và cách chọn giữa hai.
