Một máy chủ database duy nhất là một điểm chết duy nhất: nó hỏng thì cả ứng dụng ngừng. Streaming replication là cơ chế nền của PostgreSQL để giải bài toán đó — nó đẩy WAL (nhật ký ghi trước) từ máy chính (primary) sang một hoặc nhiều máy dự phòng (standby) theo thời gian thực, giữ một bản sao gần như đồng bộ. Bài này không nói lý thuyết suông: tôi dựng thật hai container PostgreSQL, cho chúng nhân bản với nhau, và đo từng bước.
Cơ chế: WAL là nguồn chân lý
PostgreSQL ghi mọi thay đổi vào WAL trước khi áp vào bảng. Streaming replication tận dụng chính điều đó: standby mở một kết nối tới primary, nhận luồng WAL, và phát lại (replay) nó liên tục để bảng của mình luôn giống primary. Vì standby luôn ở trạng thái "đang phục hồi", nó chỉ đọc — không nhận ghi trực tiếp.
-- TRÊN PRIMARY: bật replication
-- wal_level = replica  (mặc định PG16, không cần đổi)
CREATE ROLE replica_user WITH REPLICATION LOGIN PASSWORD '...';
SELECT pg_create_physical_replication_slot('slot1');
-- pg_hba.conf: host replication replica_user 0.0.0.0/0 md5
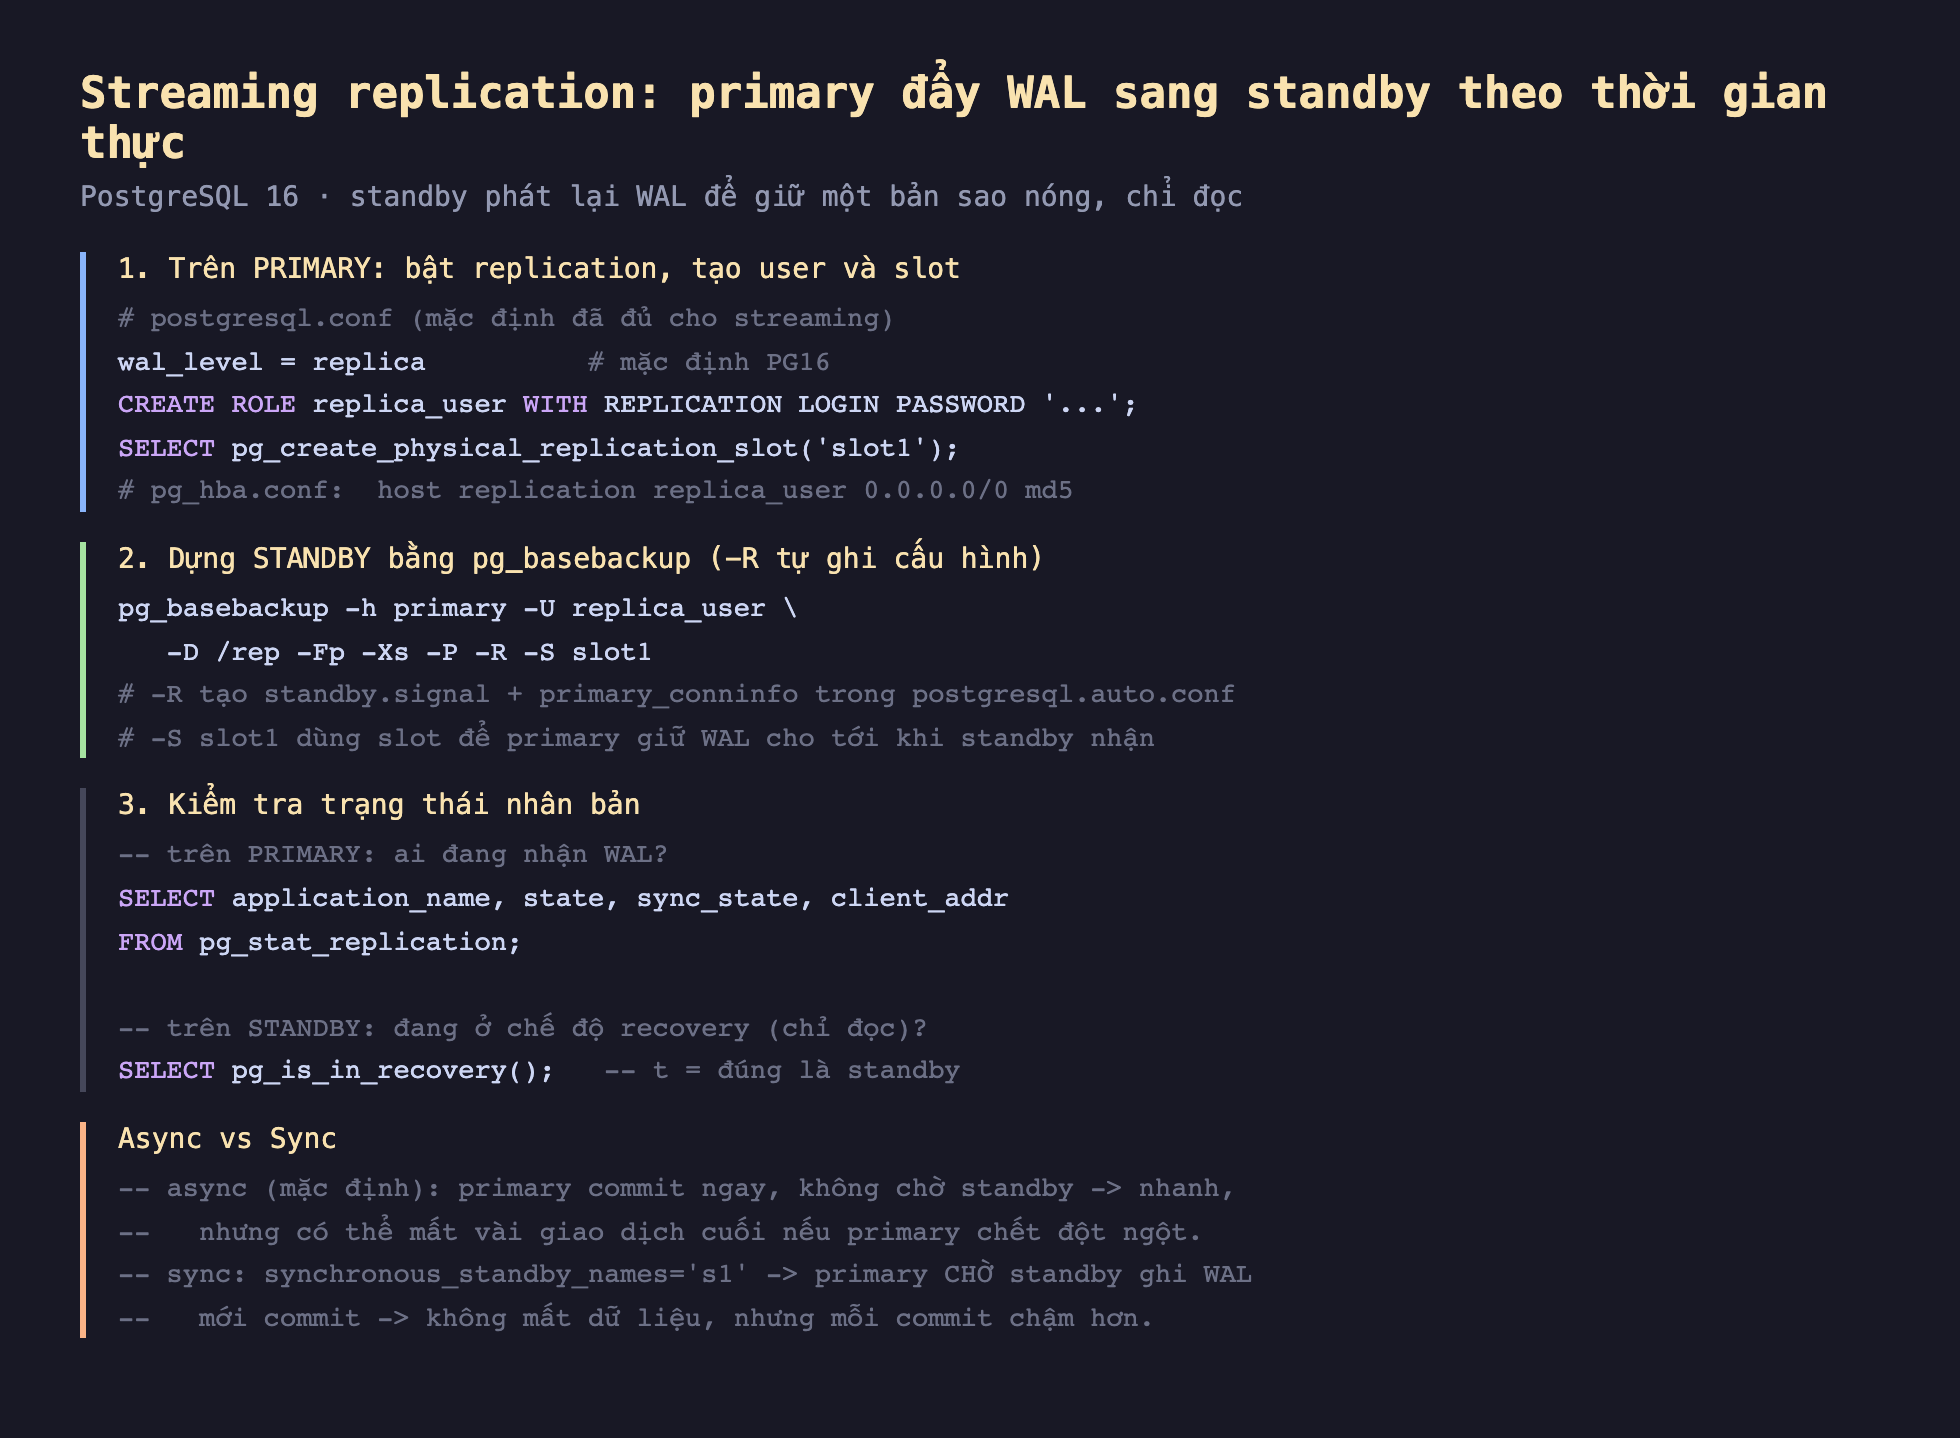
Hình 1: Ba bước — cấu hình primary (user, slot, pg_hba), dựng standby bằng pg_basebackup -R, kiểm tra bằng pg_stat_replication và pg_is_in_recovery. Cùng đánh đổi async vs sync.
Dựng standby bằng pg_basebackup
Standby là một bản sao vật lý của primary tại một thời điểm, sau đó bắt kịp bằng WAL. Công cụ pg_basebackup làm cả hai:
pg_basebackup -h primary -U replica_user -D /rep -Fp -Xs -P -R -S slot1
Cờ -R rất tiện: nó tự tạo file standby.signal (báo PostgreSQL khởi động ở chế độ standby) và ghi primary_conninfo (địa chỉ primary để kết nối). Cờ -S slot1 gắn với replication slot đã tạo — slot đảm bảo primary giữ lại WAL cho tới khi standby xác nhận đã nhận, tránh việc standby bị rớt do primary xoá WAL quá sớm.
Khi tôi khởi động container standby với bản sao này, log cho thấy nó vào việc ngay:
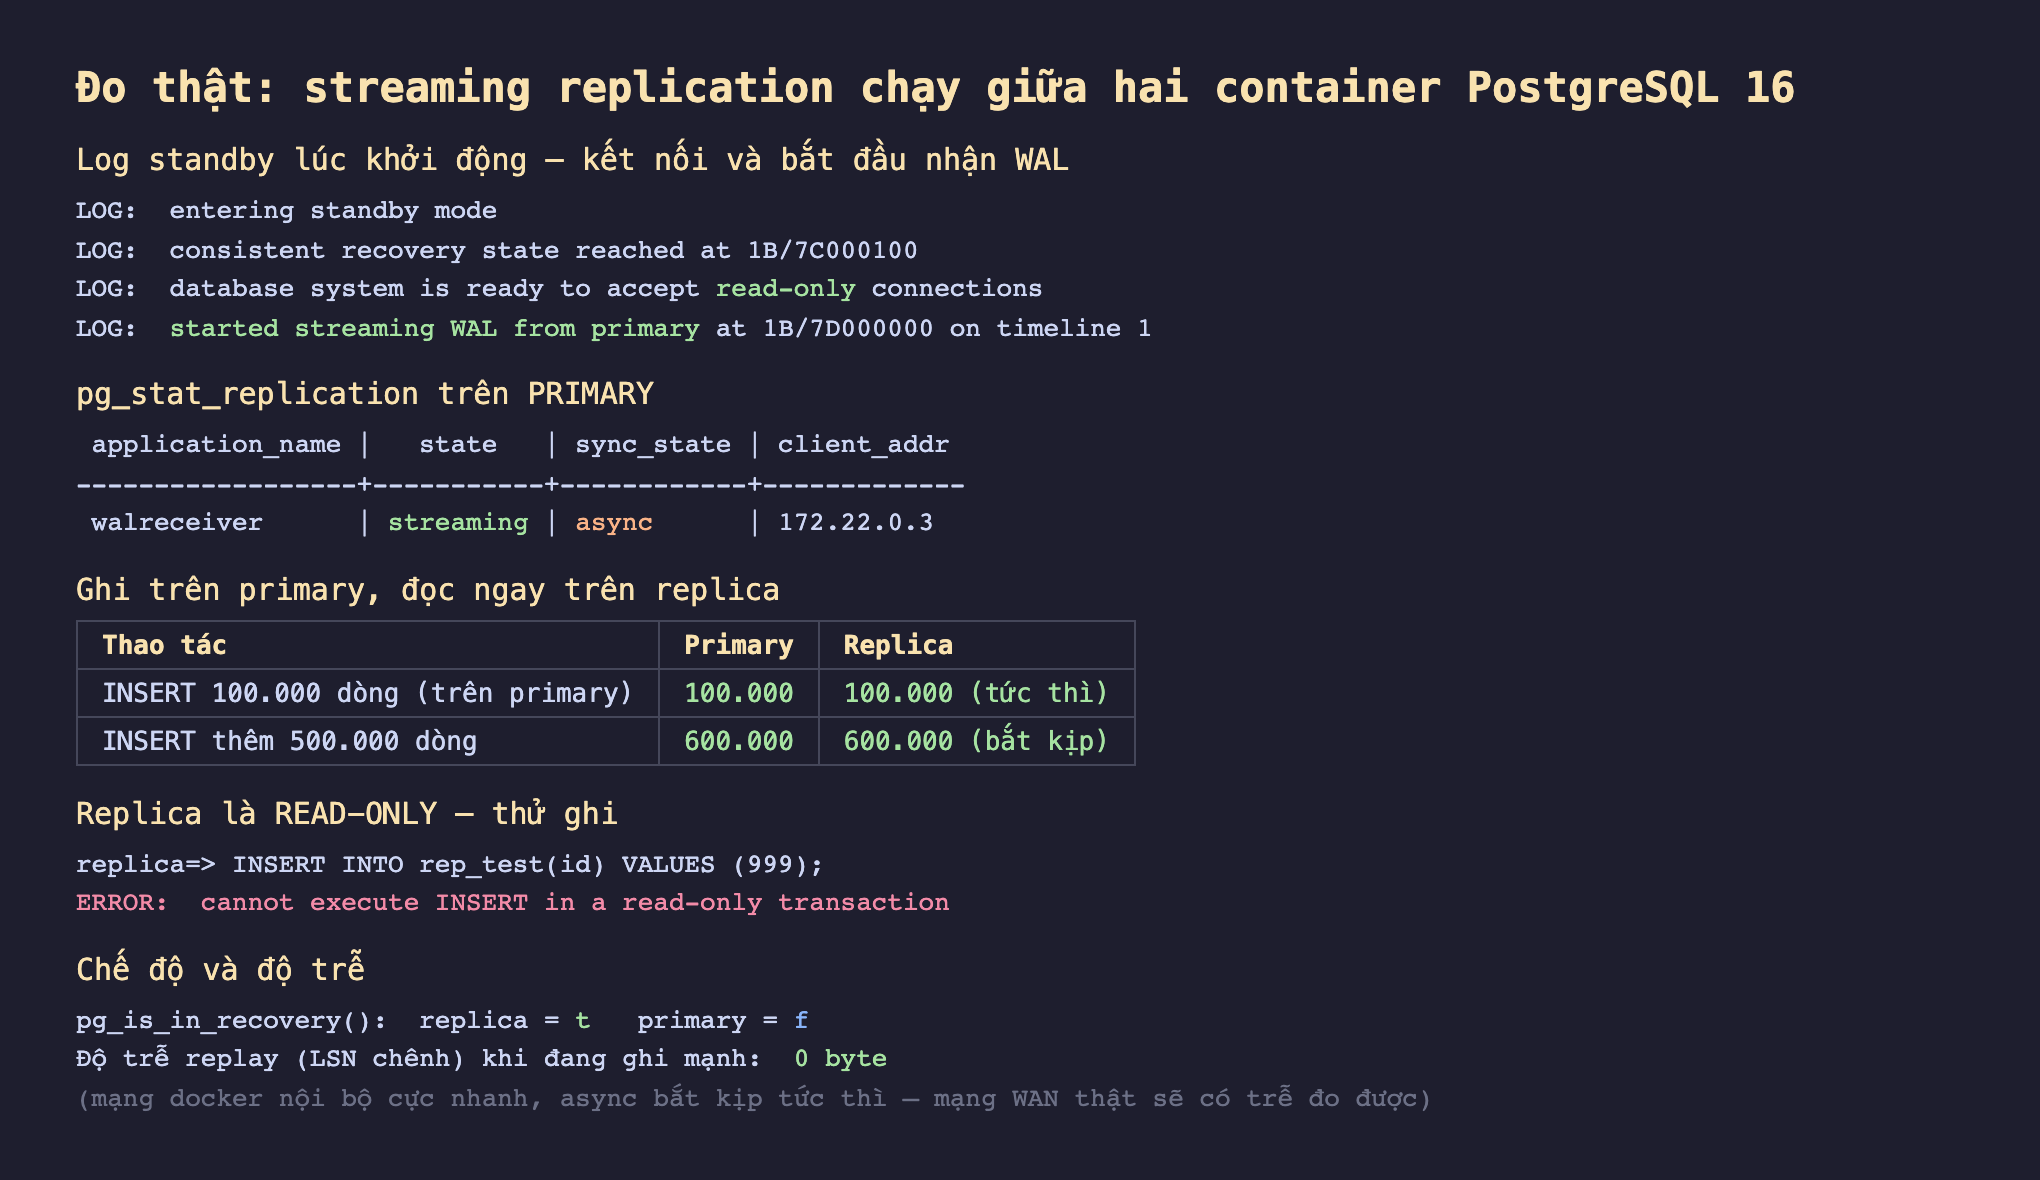
Hình 2: Log standby cho thấy "started streaming WAL from primary". pg_stat_replication báo state=streaming, sync_state=async. 600 nghìn dòng ghi trên primary xuất hiện tức thì trên replica. Replica từ chối ghi. Độ trễ ~0 byte trên mạng nội bộ.
Đo thật: nó chạy
Sau khi standby lên, tôi đo trên hệ thống thật:
1. pg_stat_replication trên primary cho thấy đúng một walreceiver đang kết nối: state = streaming, sync_state = async, client_addr = 172.22.0.3 (địa chỉ standby). Đây là bằng chứng replication đang chạy.
2. Ghi trên primary, đọc trên replica. Tôi INSERT 100.000 dòng vào một bảng trên primary; ngay sau đó, replica cũng có đúng 100.000 dòng. Ghi thêm 500.000 nữa — replica bắt kịp lên 600.000. Dữ liệu chảy sang gần như tức thì.
3. Replica là chỉ đọc. Thử INSERT trực tiếp lên replica cho lỗi thật:
ERROR: cannot execute INSERT in a read-only transaction
SELECT pg_is_in_recovery() trả về t trên replica (đang phục hồi) và f trên primary. Standby cố ý không nhận ghi — mọi thay đổi phải đi qua primary rồi mới chảy xuống.
4. Độ trễ. Đo pg_wal_lsn_diff giữa vị trí WAL hiện tại của primary và vị trí replica đã phát lại, ngay cả khi đang ghi mạnh: 0 byte. Trên mạng docker nội bộ cực nhanh, standby async bắt kịp tức thì. Cần thành thật ở đây: trên mạng WAN thật (standby ở data center khác), con số này sẽ khác 0 và đo được — đó chính là "replication lag" mà bạn theo dõi trong vận hành thật.
Async và sync: đánh đổi cốt lõi
Mặc định là async: primary commit ngay khi ghi WAL cục bộ, không chờ standby xác nhận. Nhanh — độ trễ commit không phụ thuộc mạng tới standby — nhưng nếu primary chết đột ngột trước khi standby kịp nhận, vài giao dịch cuối có thể mất.
Sync (synchronous_standby_names = 's1') thì ngược lại: primary chờ standby ghi WAL xong mới xác nhận commit. Không mất dữ liệu ngay cả khi primary chết — nhưng mỗi commit giờ phải chịu thêm một vòng đi-về mạng tới standby, nên chậm hơn, và nếu standby chết thì primary có thể treo chờ. Đây là đánh đổi kinh điển giữa độ bền và độ trễ: chọn theo mức mất mát bạn chấp nhận được.
Đánh đổi cần cân nhắc
Replication slot là con dao hai lưỡi. Slot đảm bảo primary không xoá WAL standby chưa nhận — tốt cho độ tin cậy. Nhưng nếu standby chết và không quay lại, primary sẽ giữ WAL mãi mãi, làm đầy đĩa pg_wal cho tới khi hết chỗ và primary sập. Luôn theo dõi standby còn sống, và cân nhắc max_slot_wal_keep_size để giới hạn.
Standby async có thể tụt lại khi tải ghi cao. Nếu primary ghi nhanh hơn mạng đẩy WAL, standby lag tăng dần. Với read replica (bài sau), lag nghĩa là truy vấn trên replica đọc dữ liệu hơi cũ. Theo dõi replay_lag trong pg_stat_replication.
Đây là nhân bản vật lý, toàn bộ cụm. Streaming replication sao chép cả instance (mọi database), ở mức byte của WAL. Nó không cho phép chọn lọc bảng hay database, cũng không nhân bản giữa các phiên bản PostgreSQL khác nhau. Cần nhân bản chọn lọc theo bảng thì dùng logical replication — một cơ chế khác.
Ba ý mang về
- Streaming replication đẩy WAL từ primary sang standby theo thời gian thực để có bản sao nóng chỉ đọc: dựng thật bằng
pg_basebackup -R+ replication slot, đo đượcpg_stat_replicationbáo state=streaming và 600 nghìn dòng ghi trên primary xuất hiện tức thì trên replica. - Standby luôn ở chế độ chỉ đọc:
pg_is_in_recovery()trảt, và thử ghi cho lỗi thậtcannot execute INSERT in a read-only transaction— mọi thay đổi phải qua primary rồi mới chảy xuống. - Async vs sync là đánh đổi độ trễ và độ bền: async (mặc định) commit nhanh nhưng có thể mất vài giao dịch cuối khi primary chết; sync không mất dữ liệu nhưng mỗi commit chậm hơn và có thể treo nếu standby chết — cùng với đó, canh replication slot để primary không giữ WAL đầy đĩa.
Phần sau ta khai thác chính bản sao nóng này để tăng khả năng phục vụ: Phần sau đo cách dùng read replica để phân tải đọc — định tuyến truy vấn đọc sang replica, và cạm bẫy đọc phải dữ liệu cũ do replication lag.
