Bạn cần đổi trạng thái hai triệu đơn hàng, hoặc dọn một triệu dòng log cũ. Câu lệnh đơn giản nhất — một UPDATE hoặc DELETE phủ cả bảng — chạy được ngay trên môi trường dev. Nhưng trên hệ thống production đang phục vụ người dùng, chính câu lệnh "một phát" đó là thứ làm treo cả database vài giây, đầy đĩa WAL, và để lại một cái bảng phình gấp đôi. Nghịch lý của bài này: cách chia lô chậm hơn về tổng thời gian, mà vẫn là cách đúng. Ta đo thật để thấy vì sao.
Cái giá ẩn của một câu lệnh khổng lồ
PostgreSQL dùng MVCC: mỗi lần UPDATE một dòng, nó không ghi đè tại chỗ mà tạo một phiên bản dòng mới và đánh dấu dòng cũ là dead tuple. DELETE cũng chỉ đánh dấu dòng là chết chứ chưa trả lại chỗ. Khi bạn làm việc đó cho hàng triệu dòng trong một giao dịch, ba thứ xảy ra cùng lúc: hàng triệu dead tuple sinh ra, hàng trăm MB WAL được ghi, và mọi dòng bị đụng đều bị khoá cho tới khi giao dịch kết thúc.
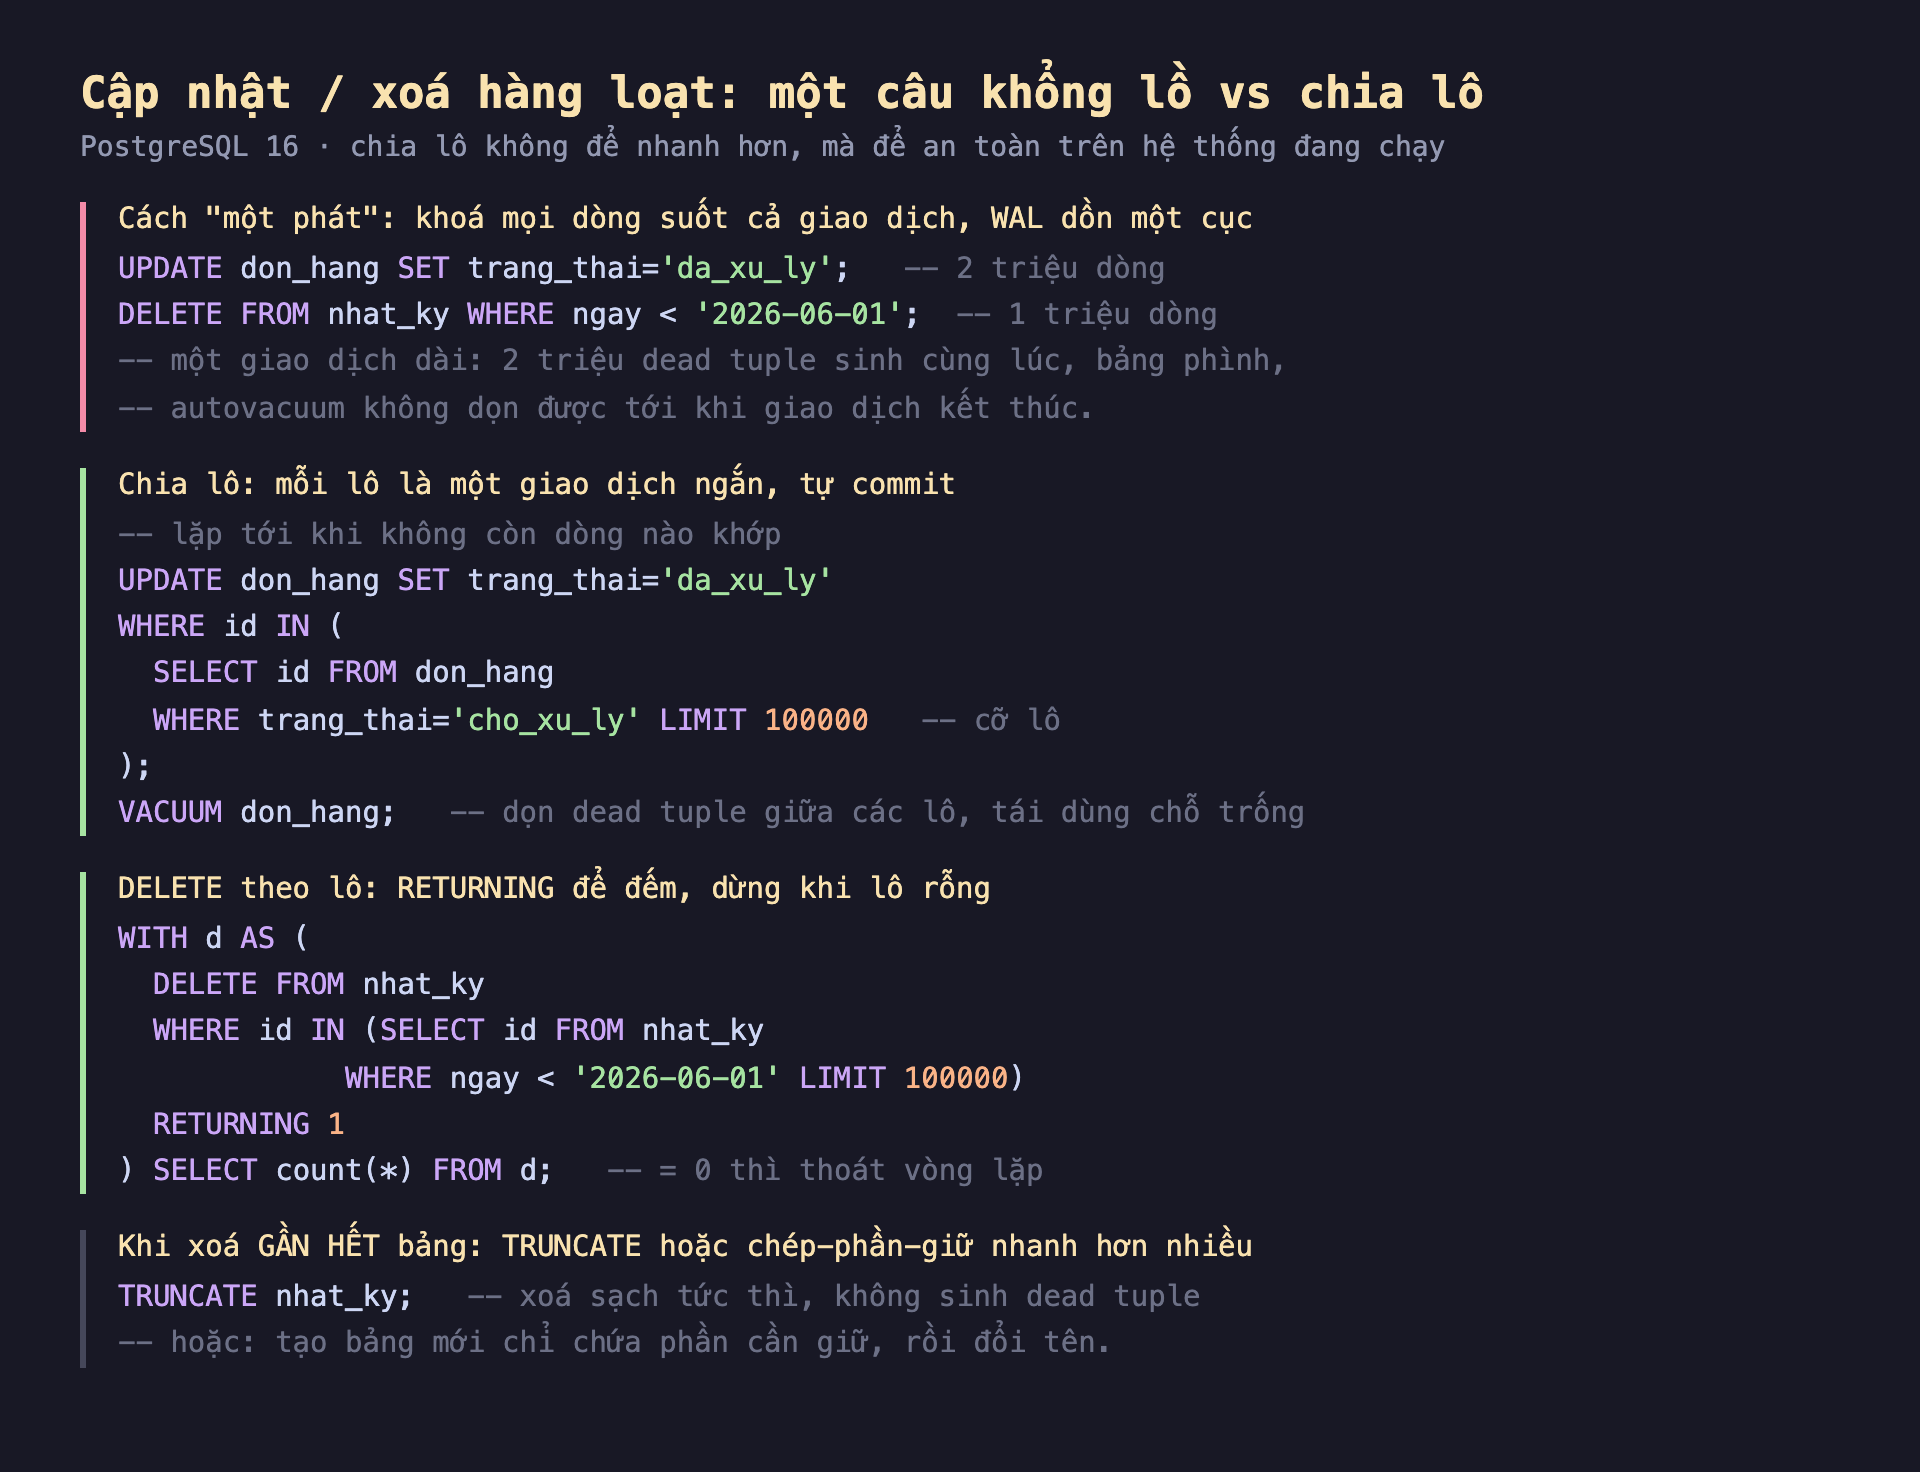
Hình 1: Một câu khổng lồ khoá mọi dòng suốt giao dịch và dồn WAL một cục; chia lô tách thành nhiều giao dịch ngắn tự commit, VACUUM giữa các lô để dọn dead tuple. Khi xoá gần hết bảng thì TRUNCATE mới là lựa chọn đúng.
Đo thật: UPDATE hai triệu dòng
Bảng don_hang hai triệu dòng, ban đầu 187 MB. Đổi trang_thai của toàn bộ, hai cách:
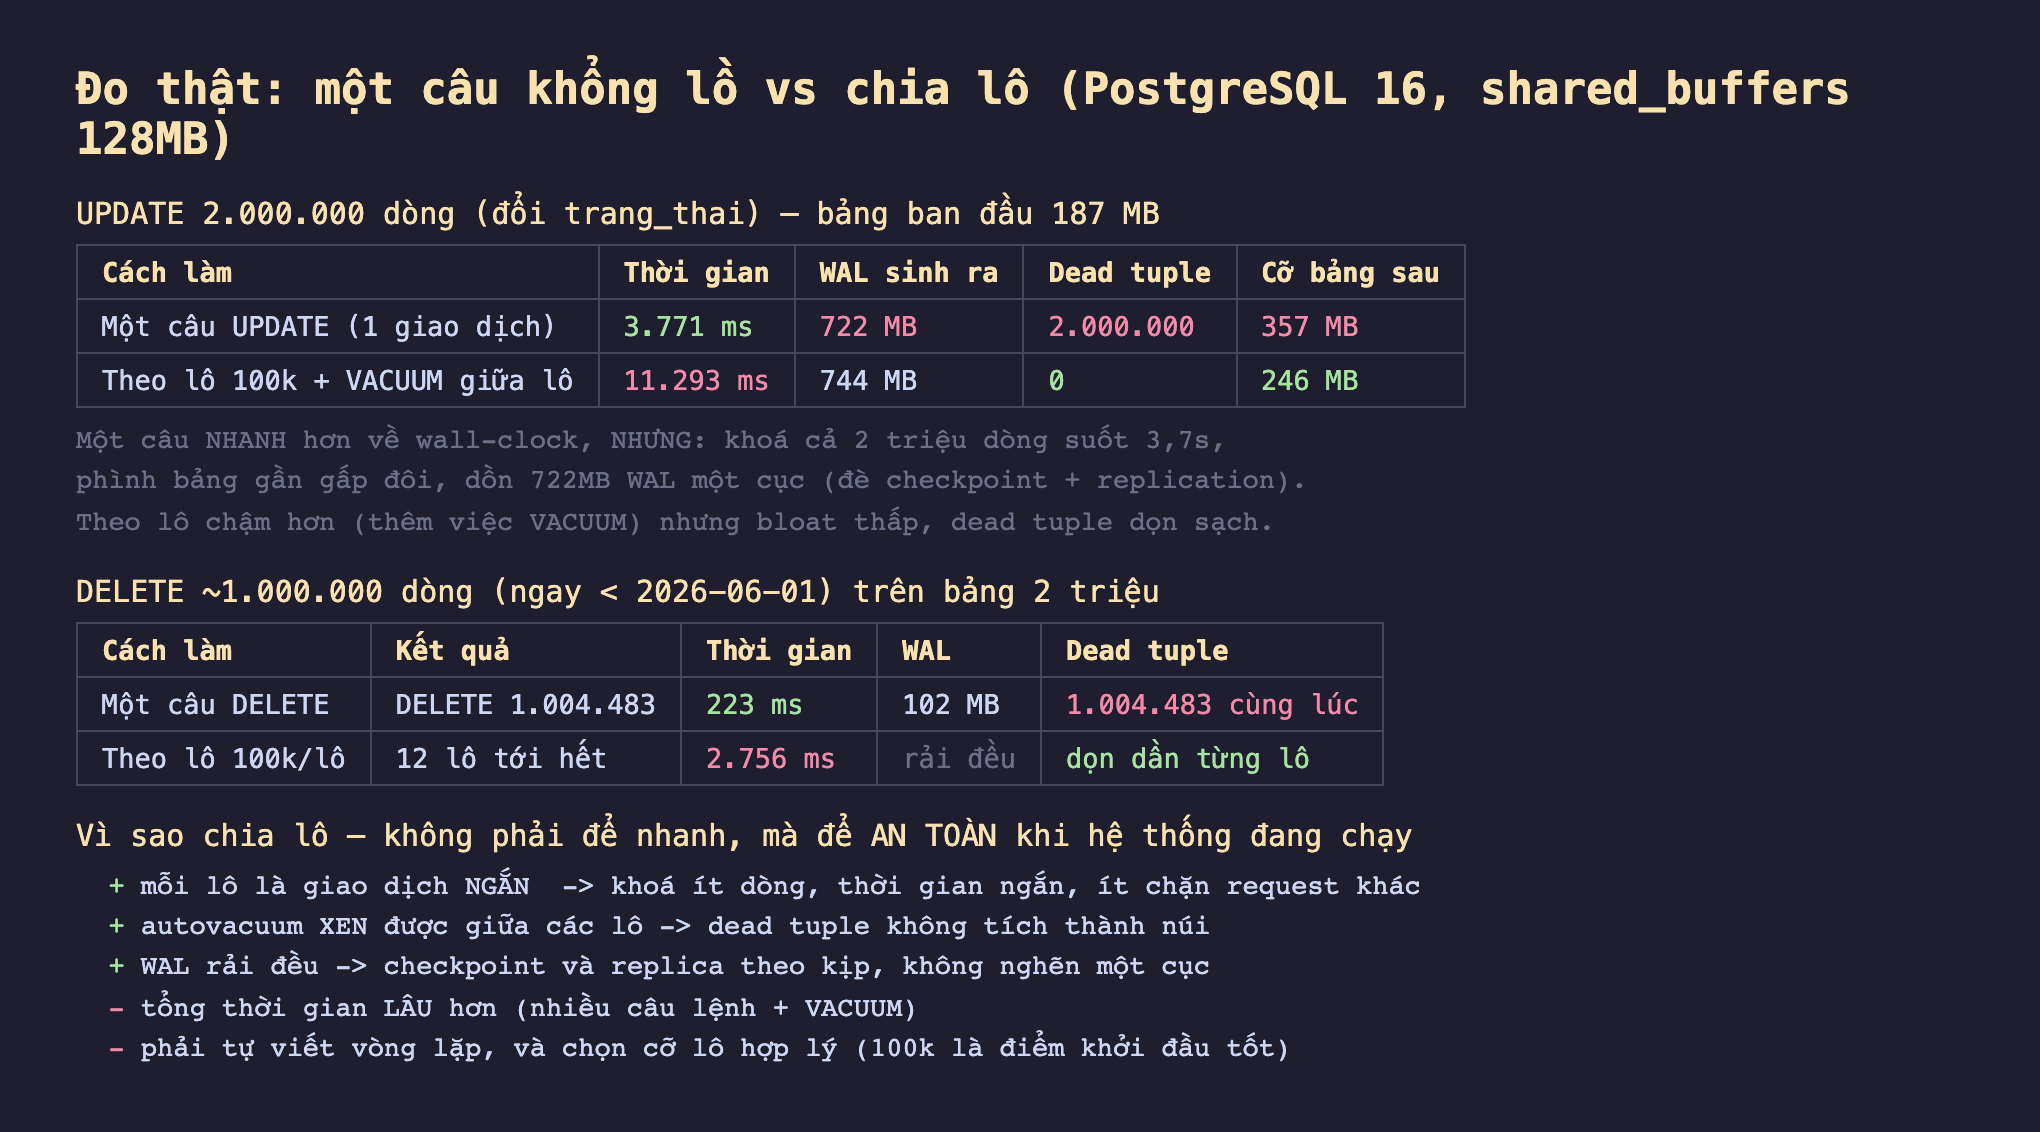
Hình 2: UPDATE một câu: 3.771 ms nhưng 722 MB WAL, 2 triệu dead tuple, bảng phình 187→357 MB. Theo lô 100k + VACUUM: 11.293 ms (chậm hơn) nhưng bloat chỉ 246 MB và 0 dead tuple còn lại. DELETE một câu 223 ms vs theo lô 12 lô 2.756 ms.
Con số thật cho UPDATE:
- Một câu UPDATE: 3.771 ms. Nhanh. Nhưng nó sinh 722 MB WAL (gần gấp 4 lần kích thước bảng!), tạo 2.000.000 dead tuple cùng lúc, và bảng phình từ 187 MB lên 357 MB — gần gấp đôi.
- Theo lô 100k + VACUUM giữa lô: 11.293 ms — chậm gấp ba. WAL tổng vẫn ~744 MB nhưng được rải đều qua 20 giao dịch, nên checkpoint và replica theo kịp thay vì bị đè một cục. Quan trọng hơn: sau khi xong, còn 0 dead tuple (mỗi
VACUUMdọn sạch lô vừa rồi và trả chỗ trống cho lô sau tái dùng), và bảng chỉ 246 MB.
Điểm mấu chốt cần thành thật: chia lô không nhanh hơn — nó chậm hơn. Lợi ích của nó không nằm ở tốc độ mà ở chỗ nó không làm database "khựng" một cái dài, không đầy đĩa WAL đột ngột, và không để lại đống bloat khổng lồ.
Đo thật: DELETE một triệu dòng
Bảng nhat_ky hai triệu dòng, xoá những dòng cũ (ngay < '2026-06-01') — khoảng một triệu dòng:
- Một câu DELETE: xoá 1.004.483 dòng trong 223 ms, sinh 102 MB WAL. Nhưng cả triệu dead tuple xuất hiện cùng lúc, và trong suốt 223 ms đó mọi dòng bị xoá đều bị khoá.
- Theo lô 100k/lô: 12 lô tới hết, tổng 2.756 ms. Chậm hơn ~12 lần, nhưng mỗi lô là một giao dịch chỉ vài trăm mili giây — giữa các lô, autovacuum và các request khác đều có khe để chen vào.
DELETE sinh ít WAL hơn UPDATE (chỉ ghi phần xoá, không ghi lại toàn bộ dòng mới), nên với DELETE cái giá chính là khoá dài và dead tuple dồn cục, hơn là WAL.
Khi nào chia lô, khi nào không
Chia lô khi bảng đang được dùng và bạn cập nhật/xoá một phần. Đây là tình huống điển hình trên production: hệ thống vẫn phục vụ, bạn không thể để một câu lệnh khoá hàng triệu dòng vài giây. Cỡ lô 100k là điểm khởi đầu hợp lý; chỉnh theo độ trễ bạn chấp nhận được cho mỗi lô.
Đừng chia lô khi bạn xoá gần hết bảng. Nếu bạn muốn xoá 95% số dòng, cả DELETE khổng lồ lẫn chia lô đều lãng phí — chúng tạo dead tuple cho từng dòng. Nhanh hơn nhiều: TRUNCATE (xoá sạch tức thì, không sinh dead tuple, trả chỗ ngay), hoặc tạo một bảng mới chỉ chứa 5% cần giữ rồi DROP bảng cũ và đổi tên. Cách này biến việc xoá triệu dòng thành gần như tức thời.
Đánh đổi cần cân nhắc
Chia lô đổi tốc độ lấy sự mượt mà. Bạn trả thêm tổng thời gian (thậm chí gấp nhiều lần) để đổi lấy: khoá ngắn, WAL rải đều, bloat kiểm soát, autovacuum theo kịp. Trên hệ thống rảnh (cửa sổ bảo trì ban đêm, database không ai dùng) thì một câu khổng lồ lại hợp lý hơn vì nó xong nhanh.
VACUUM giữa các lô quan trọng cho bloat, nhưng tốn thời gian. Đo thật cho thấy có VACUUM giữa lô thì bảng chỉ 246 MB thay vì 357 MB — vì chỗ trống được tái dùng ngay trong quá trình. Nếu bỏ VACUUM giữa lô, bloat sẽ gần bằng cách một câu; bạn chỉ được lợi phần khoá ngắn. Cân nhắc theo thứ bạn cần nhất.
Chọn cỡ lô là cân bằng. Lô quá nhỏ (1.000 dòng) thì tốn overhead giao dịch, tổng thời gian rất lâu. Lô quá lớn (một triệu) thì gần như quay lại vấn đề khoá dài. 10k–100k thường là vùng hợp lý — đo trên chính dữ liệu của bạn.
Ba ý mang về
- Một
UPDATE/DELETEkhổng lồ nhanh hơn về wall-clock nhưng đắt theo cách ẩn: đo thật, UPDATE 2 triệu dòng chạy 3.771 ms nhưng sinh 722 MB WAL một cục, 2 triệu dead tuple, và phình bảng từ 187 lên 357 MB — trong lúc khoá mọi dòng bị đụng suốt cả giao dịch. - Chia lô chậm hơn nhưng an toàn hơn trên hệ thống đang chạy: mỗi lô là một giao dịch ngắn tự commit (khoá ít, WAL rải đều để checkpoint/replica theo kịp), và
VACUUMgiữa các lô giữ bloat thấp (246 MB thay vì 357) cùng 0 dead tuple đọng lại. - Khi xoá gần hết bảng, đừng dùng cả hai — dùng
TRUNCATEhoặc chép-phần-giữ: xoá triệu dòng theo lô vẫn tạo triệu dead tuple, cònTRUNCATExoá sạch tức thì mà không sinh dead tuple nào.
Phần sau ta xét một chiến thuật tối ưu cho việc nạp dữ liệu khối lượng lớn: Phần sau đo vì sao bỏ index trước khi nạp rồi tạo lại sau lại nhanh hơn nhiều so với giữ index và chèn từng dòng.
