Bài toán quen thuộc: "cập nhật tồn kho SP-001, nếu chưa có thì tạo mới". Cách nhiều người viết đầu tiên là SELECT xem có chưa, rồi IF để UPDATE hoặc INSERT. Nó chạy được trên máy bạn — cho tới khi hai request chạy song song, cả hai cùng SELECT thấy "chưa có", cả hai cùng INSERT, và một cái nổ duplicate key. PostgreSQL có câu trả lời gọn và atomic: INSERT ... ON CONFLICT. Bài này đo thật cả tốc độ lẫn những cái bẫy của nó.
Vì sao không chỉ INSERT thẳng
Khi cột có ràng buộc PRIMARY KEY hoặc UNIQUE, chèn một khoá đã tồn tại là lỗi cứng — truy vấn dừng, giao dịch phải rollback:
INSERT INTO ton_kho(sku, so_luong) VALUES ('SP-001', 5);
-- ERROR:  duplicate key value violates unique constraint "ton_kho_pkey"
-- DETAIL:  Key (sku)=(SP-001) already exists.
Đây là lỗi thật, không phải cảnh báo. ON CONFLICT là cách nói với PostgreSQL: "nếu đụng ràng buộc này thì đừng nổ, mà làm việc kia thay vào".
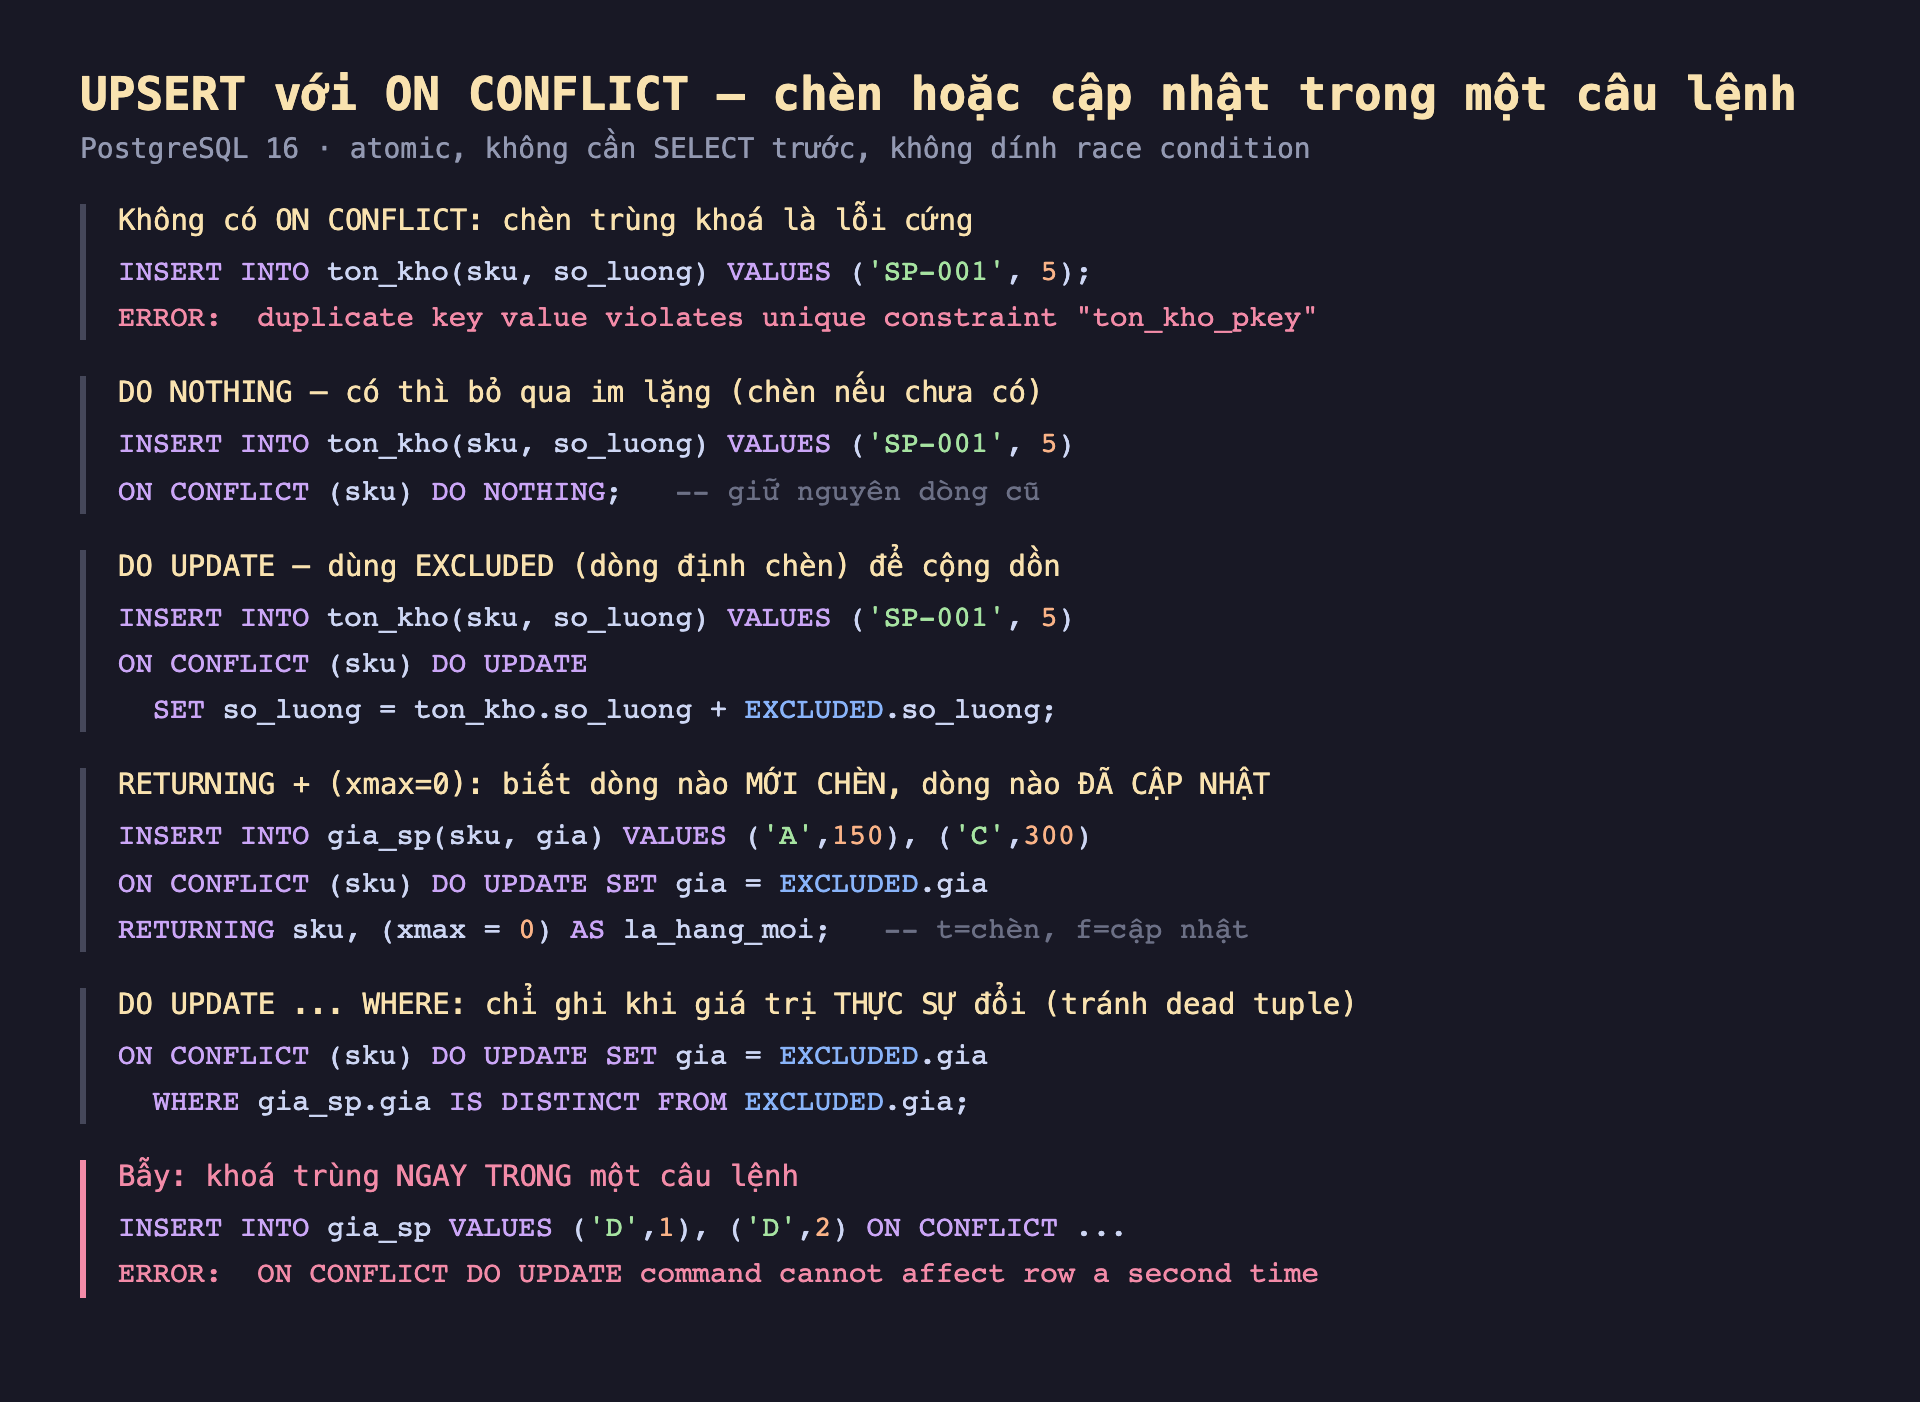
Hình 1: Ba nhánh của ON CONFLICT — DO NOTHING, DO UPDATE với EXCLUDED, thêm RETURNING/WHERE, và cái bẫy khoá trùng trong cùng câu lệnh.
Hai nhánh: DO NOTHING và DO UPDATE
ON CONFLICT (cot) DO NOTHING — nếu khoá đã có thì bỏ qua im lặng, không lỗi, không đổi gì. Chèn nếu chưa có. Dùng khi bạn chỉ muốn "đảm bảo dòng tồn tại":
INSERT INTO ton_kho(sku, so_luong) VALUES ('SP-001', 5)
ON CONFLICT (sku) DO NOTHING;   -- INSERT 0 0, so_luong vẫn = 10
ON CONFLICT (cot) DO UPDATE — nếu khoá đã có thì cập nhật dòng hiện tại. Chìa khoá ở đây là bảng ảo EXCLUDED: nó chứa đúng dòng mà bạn định chèn, nên bạn tham chiếu được cả giá trị cũ (qua tên bảng) lẫn giá trị mới (qua EXCLUDED):
INSERT INTO ton_kho(sku, so_luong) VALUES ('SP-001', 5)
ON CONFLICT (sku) DO UPDATE
  SET so_luong = ton_kho.so_luong + EXCLUDED.so_luong;   -- 10 + 5 = 15
Đo thật trên SP-001 bắt đầu với so_luong = 10: DO NOTHING giữ nguyên 10 (INSERT 0 0), còn DO UPDATE cộng dồn thành 15 (INSERT 0 1). Cả hai đều là một câu lệnh atomic — không có khe hở nào giữa "kiểm tra" và "ghi" để một giao dịch khác chen vào.
Đo thật: nhanh hơn SELECT-rồi-ghi bao nhiêu
Đây mới là lý do thật sự để dùng UPSERT thay vì tự viết logic kiểm-tra-rồi-ghi. Kịch bản: đồng bộ 200.000 dòng vào bảng luot_xem, trong đó 100.000 khoá đã có (cần cập nhật) và 100.000 khoá mới (cần chèn).
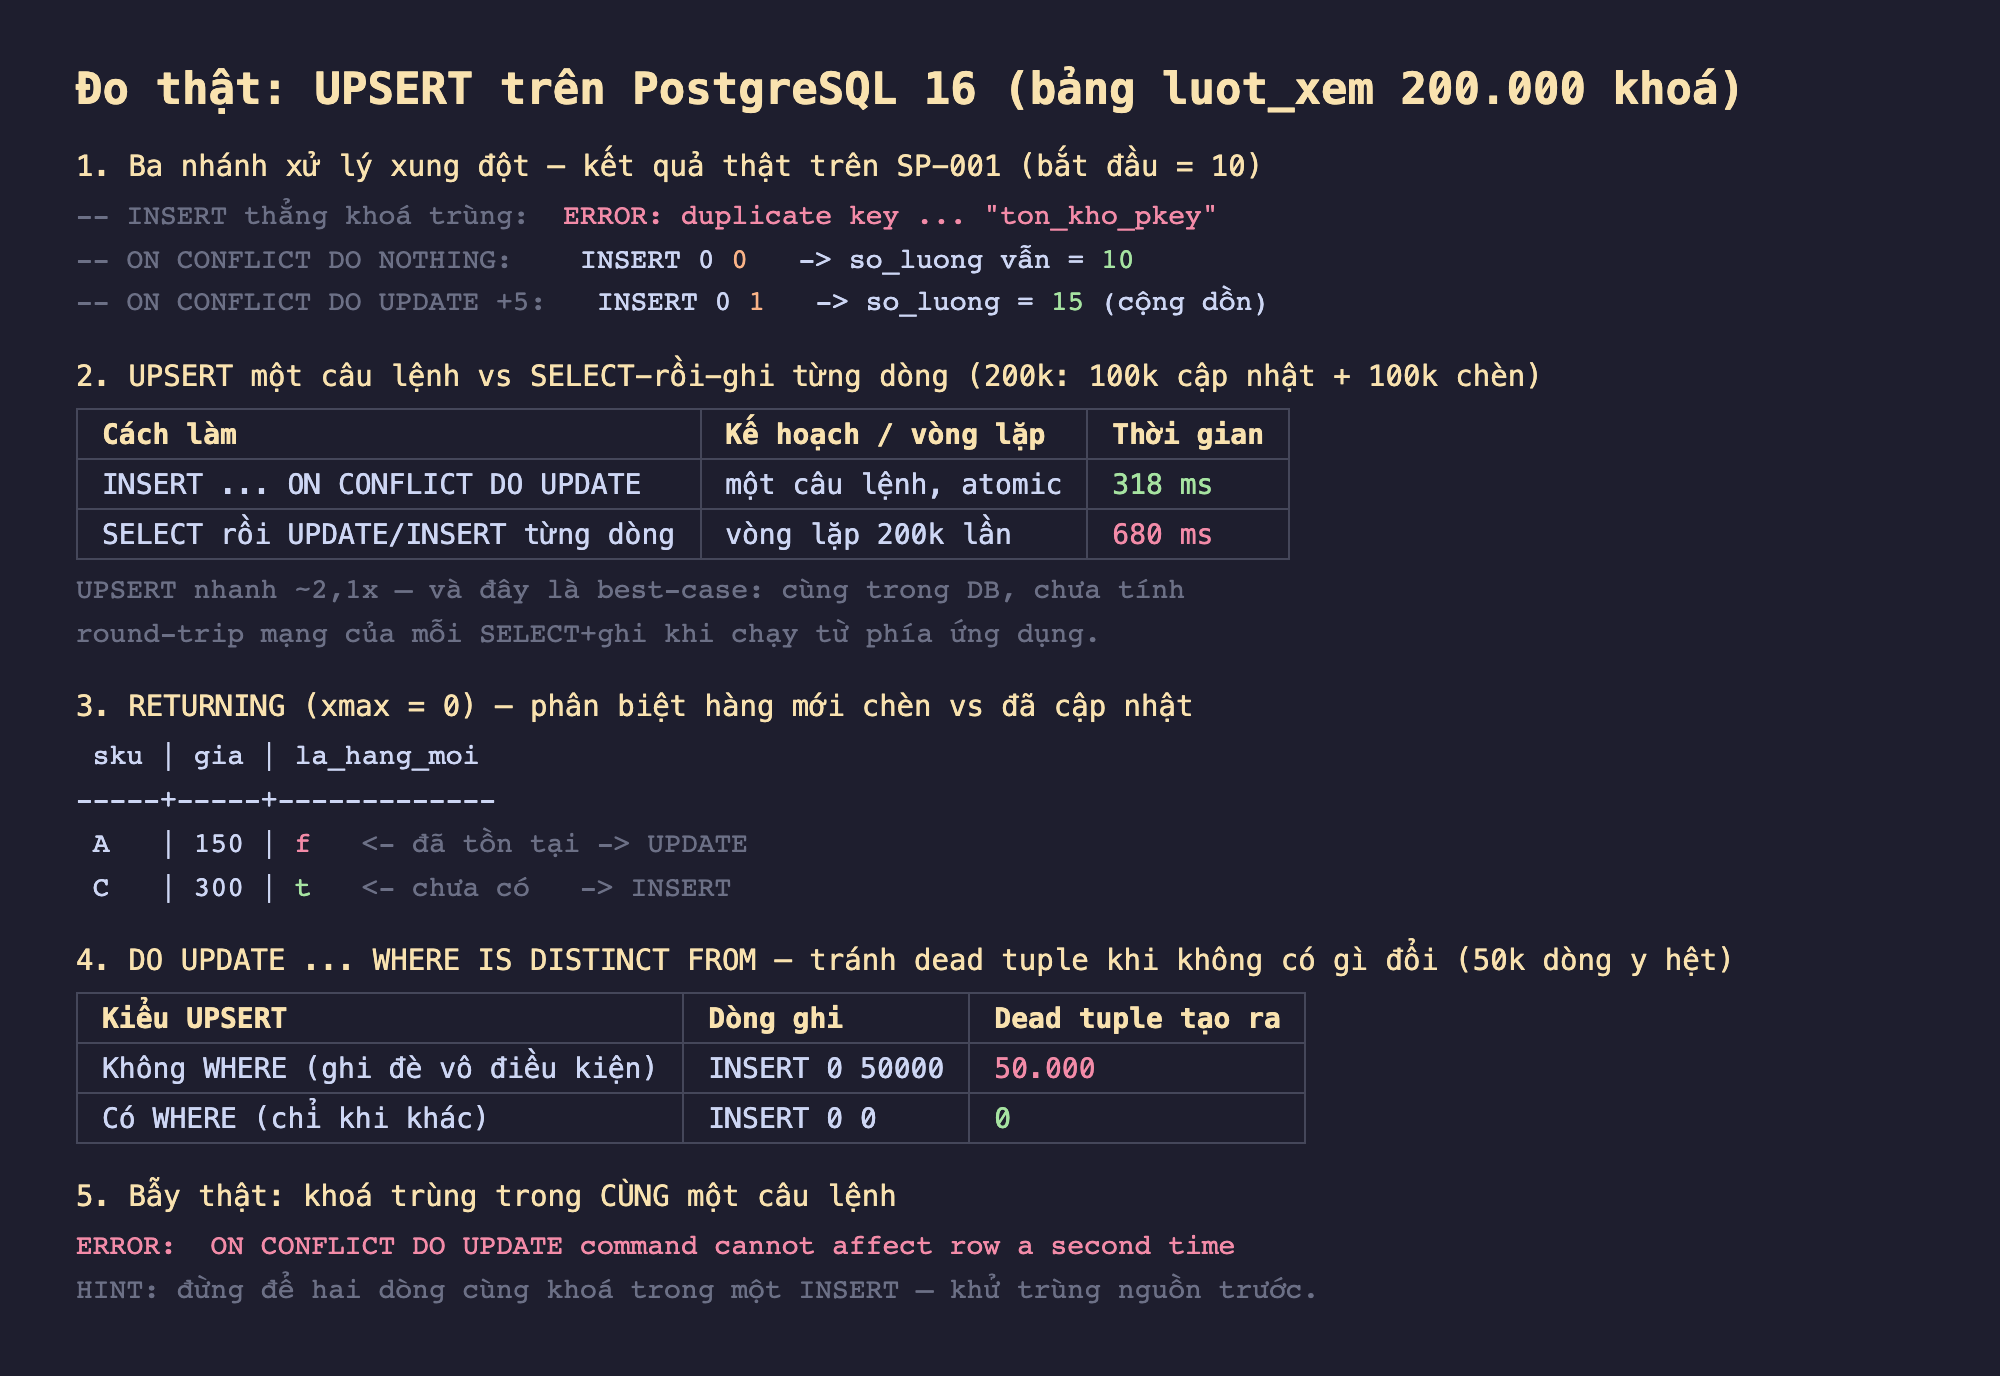
Hình 2: UPSERT một câu (318 ms) so với vòng lặp SELECT-rồi-ghi từng dòng (680 ms) — nhanh ~2,1 lần. RETURNING (xmax=0) phân biệt insert/update. Mệnh đề WHERE xoá 50.000 dead tuple khi không có gì đổi.
Con số thật:
- UPSERT một câu lệnh:
INSERT ... ON CONFLICT DO UPDATEcho cả 200.000 dòng — 318 ms. - SELECT-rồi-ghi từng dòng: vòng lặp 200.000 lần, mỗi lần
SELECTxem có chưa rồiUPDATEhoặcINSERT— 680 ms, chậm ~2,1 lần.
Và đây là con số tử tế nhất cho cách row-by-row, vì tôi chạy vòng lặp đó ngay bên trong database (bằng khối DO), không có round-trip mạng. Khi logic này nằm ở phía ứng dụng, mỗi dòng là một SELECT rồi một INSERT/UPDATE — hai lần đi-về mạng cho mỗi dòng. Với độ trễ mạng vài trăm micro giây mỗi lượt, khoảng cách không còn là 2 lần mà là hàng chục lần. Chưa kể race condition mà cách row-by-run không bao giờ tránh được một cách sạch sẽ.
Biết dòng nào được chèn, dòng nào được cập nhật
Sau UPSERT hàng loạt, đôi khi bạn cần biết dòng nào thực sự mới. Mẹo dùng cột hệ thống xmax: với dòng vừa được INSERT, xmax = 0; với dòng bị UPDATE, xmax khác 0. Kết hợp RETURNING:
INSERT INTO gia_sp(sku, gia) VALUES ('A', 150), ('C', 300)
ON CONFLICT (sku) DO UPDATE SET gia = EXCLUDED.gia
RETURNING sku, (xmax = 0) AS la_hang_moi;
Đo thật: A (đã có) trả la_hang_moi = f — bị cập nhật; C (chưa có) trả t — mới chèn. Rất tiện khi cần đếm "thêm bao nhiêu mới, sửa bao nhiêu cũ" mà không phải chạy thêm truy vấn.
Mệnh đề WHERE: đừng ghi khi không có gì đổi
DO UPDATE mặc định ghi đè dù giá trị mới có giống hệt giá trị cũ hay không. Mỗi lần ghi đè tạo một phiên bản dòng mới và để lại một dead tuple — sau này VACUUM phải dọn, chỉ số phình ra. Với công việc đồng bộ lặp lại (nhiều dòng thực ra không đổi), đây là lãng phí lớn.
Thêm WHERE để chỉ ghi khi giá trị thực sự khác:
INSERT INTO gia_sp(sku, gia) VALUES ('B', 200)
ON CONFLICT (sku) DO UPDATE SET gia = EXCLUDED.gia, cap_nhat = now()
WHERE gia_sp.gia IS DISTINCT FROM EXCLUDED.gia;
Đo thật trên 50.000 dòng "đồng bộ lại y hệt": bản không có WHERE ghi đè cả 50.000 dòng và tạo 50.000 dead tuple; bản có WHERE cho INSERT 0 0 và 0 dead tuple. Lưu ý dùng IS DISTINCT FROM chứ không phải <> — nó xử lý NULL đúng (hai NULL được coi là bằng nhau, không cho ra UNKNOWN).
Cái bẫy: khoá trùng trong cùng một câu lệnh
Một lỗi thật hay gặp khi UPSERT hàng loạt: nếu chính câu INSERT của bạn chứa hai dòng cùng khoá, PostgreSQL từ chối:
INSERT INTO gia_sp(sku, gia) VALUES ('D', 1), ('D', 2)
ON CONFLICT (sku) DO UPDATE SET gia = EXCLUDED.gia;
-- ERROR:  ON CONFLICT DO UPDATE command cannot affect row a second time
Lý do: DO UPDATE không thể cập nhật cùng một dòng đích hai lần trong một câu lệnh. Nguồn dữ liệu của bạn (một mảng, một file CSV, một bảng tạm) phải được khử trùng khoá trước — ví dụ gộp bằng DISTINCT ON (sku) hoặc một truy vấn tổng hợp — rồi mới đưa vào UPSERT. Đây là lỗi lặng lẽ chờ sẵn khi bạn nghĩ dữ liệu nguồn đã sạch mà thật ra chưa.
Đánh đổi cần cân nhắc
ON CONFLICT cần một ràng buộc cụ thể để "đụng" vào. Bạn phải nêu đúng cột (hoặc tên ràng buộc) có UNIQUE/PRIMARY KEY. Không có index duy nhất phù hợp thì ON CONFLICT (cot) báo lỗi "no unique or exclusion constraint matching". UPSERT không phải phép màu — nó dựa hoàn toàn vào ràng buộc bạn đã định nghĩa.
Với unique index cho phép NULL, hành vi tinh tế. Mặc định nhiều NULL được coi là phân biệt (nên nhiều dòng NULL cùng lọt qua unique index, không kích hoạt conflict). PostgreSQL 15 trở lên có NULLS NOT DISTINCT để đảo hành vi đó. Nếu khoá conflict của bạn có thể NULL, hãy kiểm kỹ đang dùng luật nào.
UPSERT có chi phí khoá. Để atomic, ON CONFLICT DO UPDATE khoá dòng đích trong lúc xử lý. Dưới tải ghi rất cao trên một số ít khoá nóng (ví dụ một bộ đếm toàn cục), nhiều giao dịch UPSERT cùng dòng vẫn phải xếp hàng chờ nhau. Đó là bản chất của tính đúng đắn, nhưng cần biết khi thiết kế khoá.
Ba ý mang về
INSERT ... ON CONFLICTgộp chèn và cập nhật vào một câu lệnh atomic — thay cho SELECT-rồi-ghi vừa dính race condition (hai request cùng thấy "chưa có" rồi cùng chèn →duplicate key) vừa chậm: đo thật 318 ms so với 680 ms cho 200.000 dòng, và khoảng cách còn giãn rộng khi tính round-trip mạng từ phía ứng dụng.EXCLUDEDlà dòng bạn định chèn, dùng nó trongDO UPDATEđể cộng dồn hay ghi đè; thêmRETURNING (xmax = 0)để biết dòng nào mới chèn, vàWHERE ... IS DISTINCT FROMđể không ghi khi giá trị không đổi — đo thật xoá được 50.000 dead tuple trên 50.000 dòng đồng bộ y hệt.- Cẩn thận hai bẫy: khoá trùng ngay trong một câu lệnh cho lỗi "cannot affect row a second time" (phải khử trùng nguồn trước), và
ON CONFLICTbắt buộc có một ràng buộcUNIQUE/PRIMARY KEYkhớp để hoạt động.
Phần sau ta chuyển từ chèn/cập nhật một dòng sang xử lý khối lượng lớn: Phần sau đo cách cập nhật và xoá hàng loạt theo lô — vì sao một UPDATE/DELETE khổng lồ khoá bảng và phình WAL, và chia lô thế nào cho an toàn.
