Bài trước cho thấy COPY nhanh nhất cho khối rất lớn, nhưng nhiều ứng dụng thực tế dùng cấp độ ở giữa: multi-row INSERT — gộp nhiều dòng vào một câu INSERT ... VALUES (...),(...),.... Nó tiện (không cần file), hợp với ORM/driver, và hỗ trợ ON CONFLICT. Câu hỏi thực dụng: gộp bao nhiêu dòng mỗi lô là tối ưu? Bài này đo thật đường cong và tìm điểm ngọt.
Multi-row INSERT giảm chi phí lặp lại
Thay vì N câu INSERT riêng lẻ, gộp nhiều dòng vào một câu:
INSERT INTO t VALUES (1,'a'), (2,'b'), (3,'c'), ...;
Một câu lệnh thay vì N câu nghĩa là: một lần phân tích cú pháp + lập kế hoạch (thay vì N lần), một round-trip client↔server (thay vì N round-trip), và một giao dịch nếu autocommit (một fsync thay vì N). Khi client và server cách nhau qua mạng, round-trip là chi phí thống trị — mỗi câu lệnh chờ một vòng đi-về. Gộp 500 dòng vào một câu giảm số round-trip đi 500 lần.
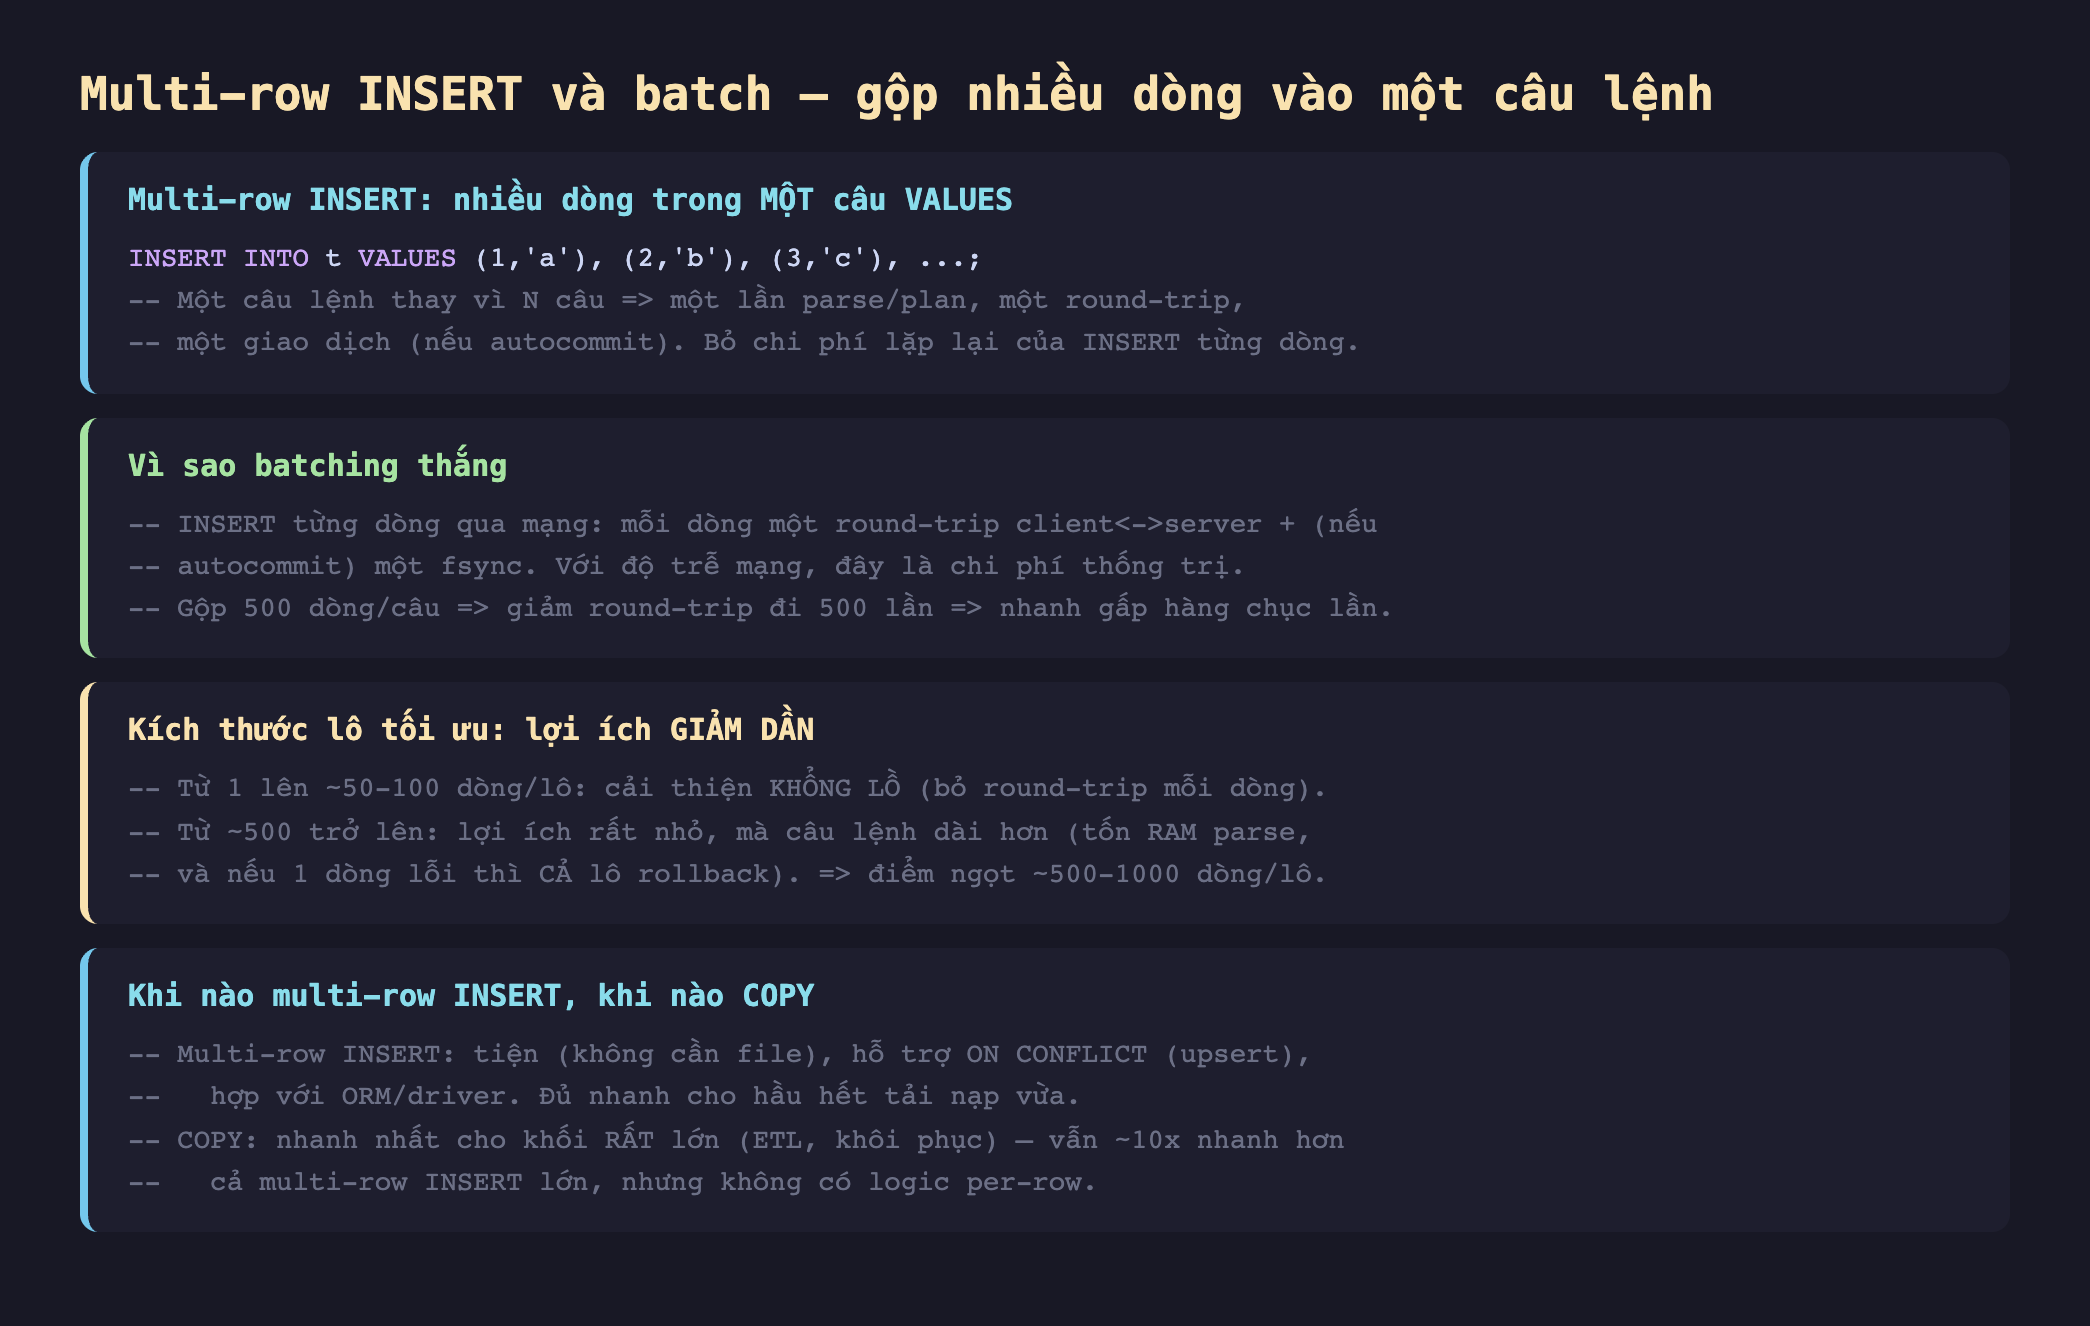
Hình 1: Multi-row INSERT gộp nhiều dòng vào một câu — một lần parse/plan, một round-trip, một giao dịch. Batching bỏ round-trip mỗi dòng. Điểm ngọt ~500-1000 dòng/lô; COPY vẫn nhanh hơn cho khối rất lớn.
Đo thật: đường cong lợi ích giảm dần
Nạp 100.000 dòng bằng multi-row INSERT với các kích thước lô khác nhau:
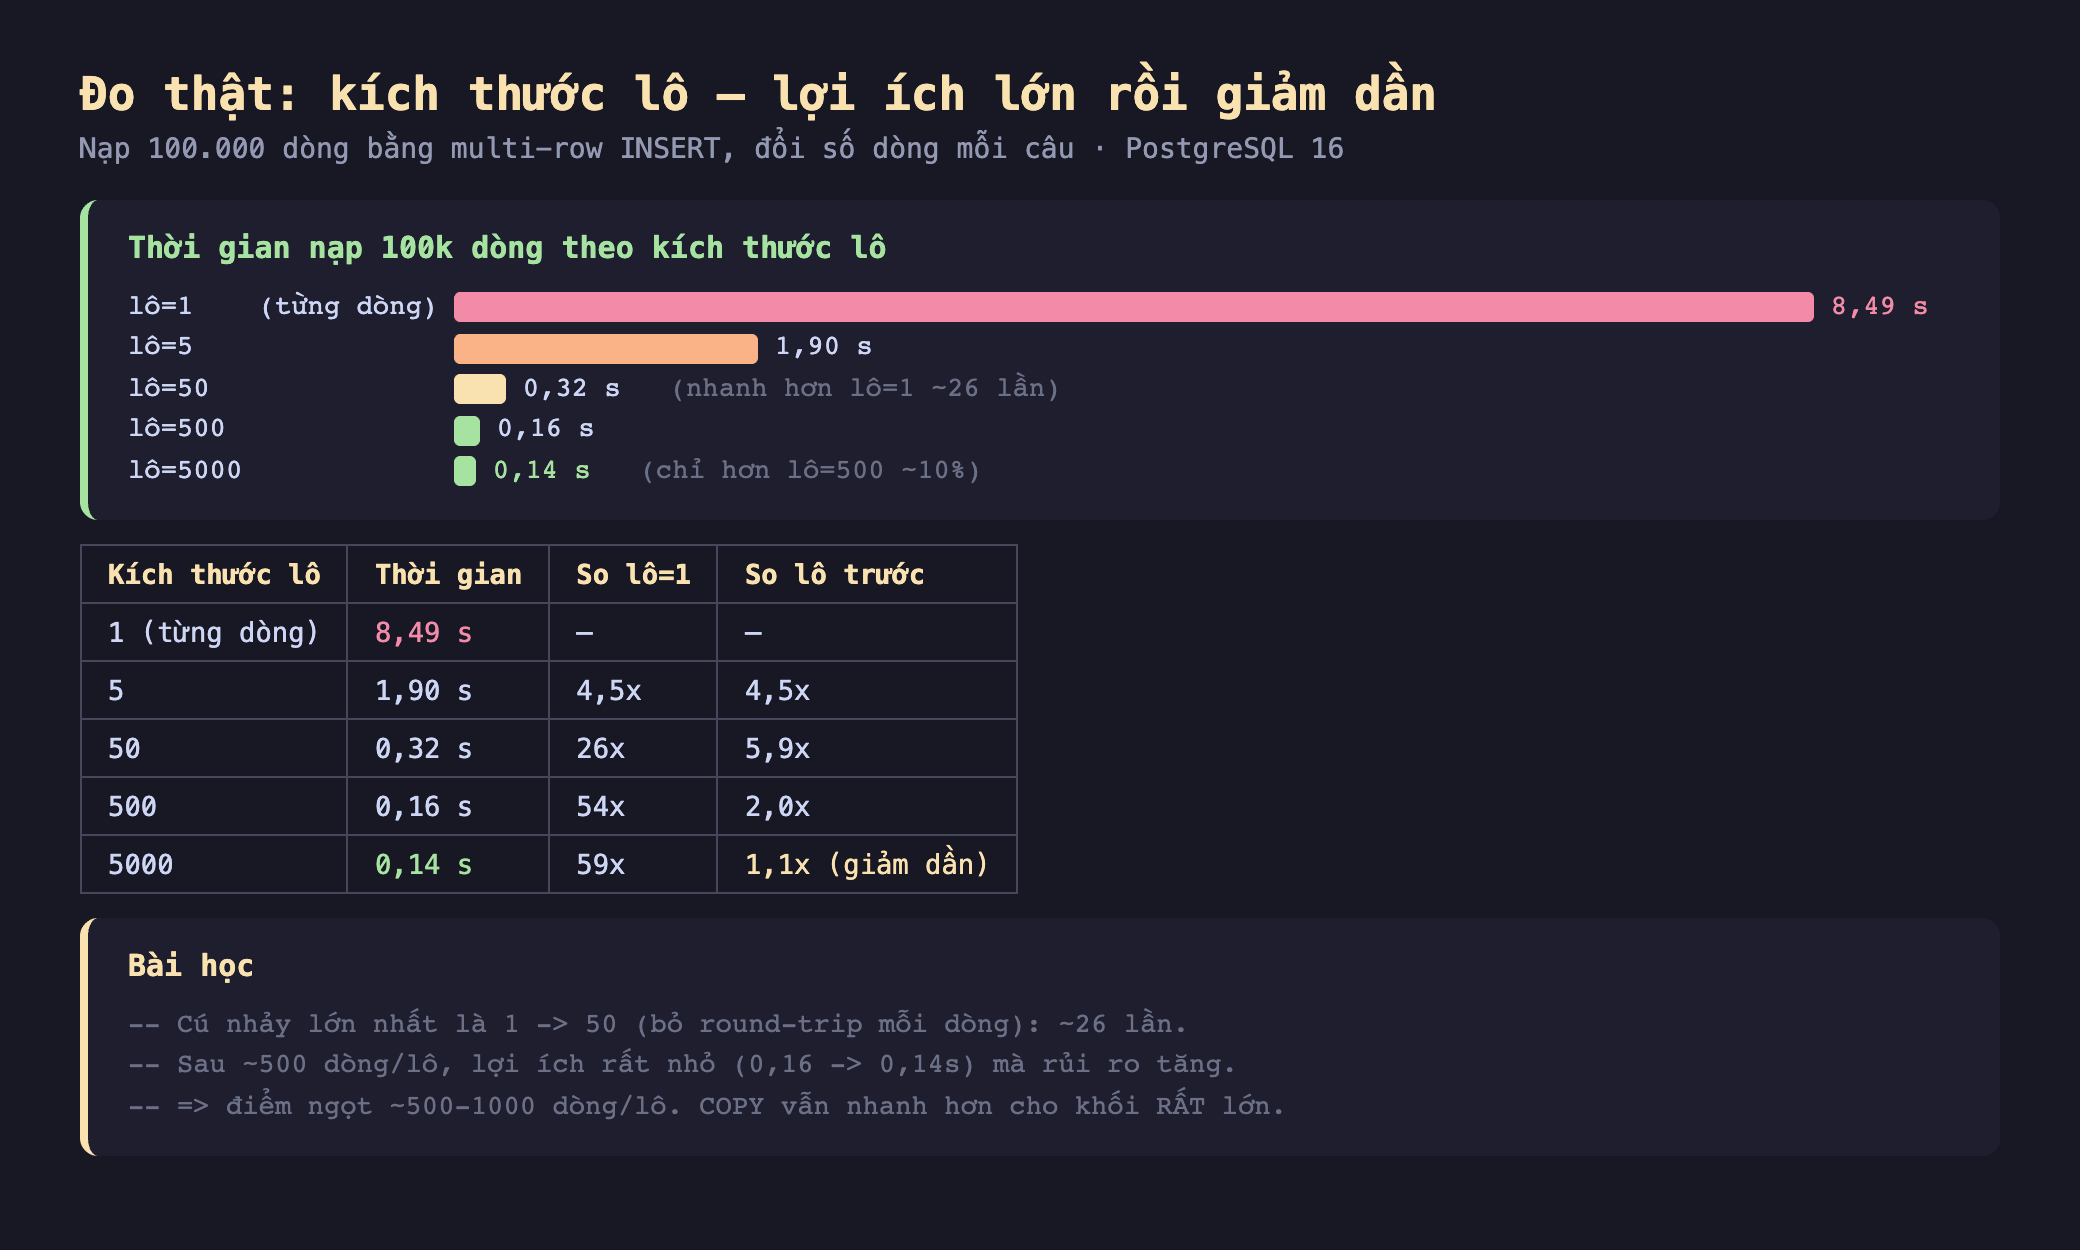
Hình 2: Nạp 100k dòng — lô 1 dòng (từng dòng) mất 8,49 s; lô 5 → 1,90 s; lô 50 → 0,32 s (nhanh ~26 lần); lô 500 → 0,16 s; lô 5000 → 0,14 s (chỉ hơn lô 500 ~10%). Lợi ích giảm dần rõ sau lô ~500.
- Lô 1 (từng dòng): 8,49 s.
- Lô 5: 1,90 s (nhanh 4,5 lần).
- Lô 50: 0,32 s — nhanh hơn lô 1 tới ~26 lần.
- Lô 500: 0,16 s (54 lần).
- Lô 5000: 0,14 s (59 lần) — chỉ hơn lô 500 khoảng 10%.
Đường cong rõ ràng: cú nhảy lớn nhất là từ 1 lên ~50 (bỏ round-trip mỗi dòng cho ~26 lần), rồi lợi ích giảm dần nhanh sau lô ~500. Từ 500 lên 5000 chỉ nhanh thêm 10%, trong khi câu lệnh dài gấp 10 lần. Điểm ngọt thực tế là ~500-1000 dòng mỗi lô.
Đánh đổi cần cân nhắc
Lô quá lớn tăng rủi ro và chi phí bộ nhớ. Câu INSERT với 10.000 dòng VALUES là một chuỗi SQL rất dài — tốn bộ nhớ để phân tích, và nếu một dòng vi phạm ràng buộc thì cả lô rollback (mất công làm lại 10.000 dòng). Lô vừa phải (500-1000) cân bằng tốc độ với rủi ro và bộ nhớ. Ngoài ra có giới hạn cứng: một câu lệnh không quá 65535 tham số bound (với prepared statement) — lô quá lớn có thể vượt.
Đừng nhầm "batch" với gói-trong-giao-dịch. Multi-row INSERT gộp ở tầng câu lệnh. Một cải thiện khác là gói nhiều câu (kể cả nhiều multi-row INSERT) trong một BEGIN ... COMMIT để giảm số fsync. Hai kỹ thuật này bù nhau: dùng multi-row INSERT ~500 dòng/câu, và gói vài câu trong một giao dịch, cho tải nạp lớn qua ORM.
COPY vẫn nhanh hơn cho khối thật lớn. Như bài trước đo, COPY nạp 200k dòng trong ~29 ms — nhanh hơn cả multi-row INSERT lô lớn. Nếu bạn nạp hàng triệu dòng (ETL, khôi phục) và không cần logic per-row, dùng COPY. Multi-row INSERT là lựa chọn khi cần tiện lợi (không file), cần ON CONFLICT, hoặc tải vừa phải qua driver ứng dụng.
Ba ý mang về
- Multi-row INSERT gộp nhiều dòng vào một câu, giảm round-trip và chi phí lặp lại: đo thật, nạp 100k dòng với lô 50 nhanh hơn lô 1 tới ~26 lần — cú nhảy lớn nhất đến từ việc có batching (bỏ round-trip mỗi dòng), không phải từ lô cực lớn.
- Lợi ích giảm dần sau lô ~500: đo thật, lô 500 (0,16 s) so với lô 5000 (0,14 s) chỉ nhanh thêm ~10% dù câu lệnh dài gấp 10 — điểm ngọt thực tế là ~500-1000 dòng mỗi lô, cân bằng tốc độ với rủi ro rollback cả lô và bộ nhớ parse.
- Chọn công cụ theo quy mô và nhu cầu: multi-row INSERT ~500-1000 dòng/lô (tiện, hỗ trợ ON CONFLICT, hợp ORM) cho tải vừa; gói thêm trong giao dịch để giảm fsync; COPY cho khối rất lớn không cần logic per-row.
Phần sau ta xét một tình huống nạp đặc biệt phổ biến — chèn hoặc cập nhật tùy tồn tại: Phần sau mổ xẻ UPSERT với INSERT ... ON CONFLICT — cách nó xử lý xung đợt khóa hiệu quả, so với mẫu SELECT-rồi-INSERT dễ dính đua tranh.
