Nạp một khối lượng dữ liệu lớn — ETL hằng ngày, khôi phục, nạp ban đầu, đổ dữ liệu vào shard — là việc mà cách làm ngây thơ chậm hơn cách đúng hàng chục đến hàng trăm lần. Sê-ri đã bàn nhiều tối ưu đọc; bài này đo thật phía ghi khối lớn: vì sao COPY bỏ xa INSERT từng dòng, và những cấp độ giữa hai thái cực đó.
Sai lầm đắt nhất: INSERT từng dòng tự commit
Cách làm ngây thơ nhất — vòng lặp trong code ứng dụng, mỗi dòng một INSERT và mỗi INSERT tự commit — là thảm họa hiệu năng. Vì mỗi commit buộc PostgreSQL fsync WAL ra đĩa (với synchronous_commit=on), và fsync là thao tác chậm nhất. Làm fsync cho từng dòng nghĩa là hàng nghìn cú ghi đĩa đồng bộ.
INSERT INTO t VALUES (...); -- tự commit => 1 fsync đĩa MỖI dòng
Đo thật: nạp 20.000 dòng bằng INSERT autocommit riêng lẻ mất 2,40 giây; cùng 20.000 dòng bằng COPY chỉ 0,046 giây — COPY nhanh hơn ~52 lần. Ở quy mô lớn hơn, chênh lệch càng thảm khốc.
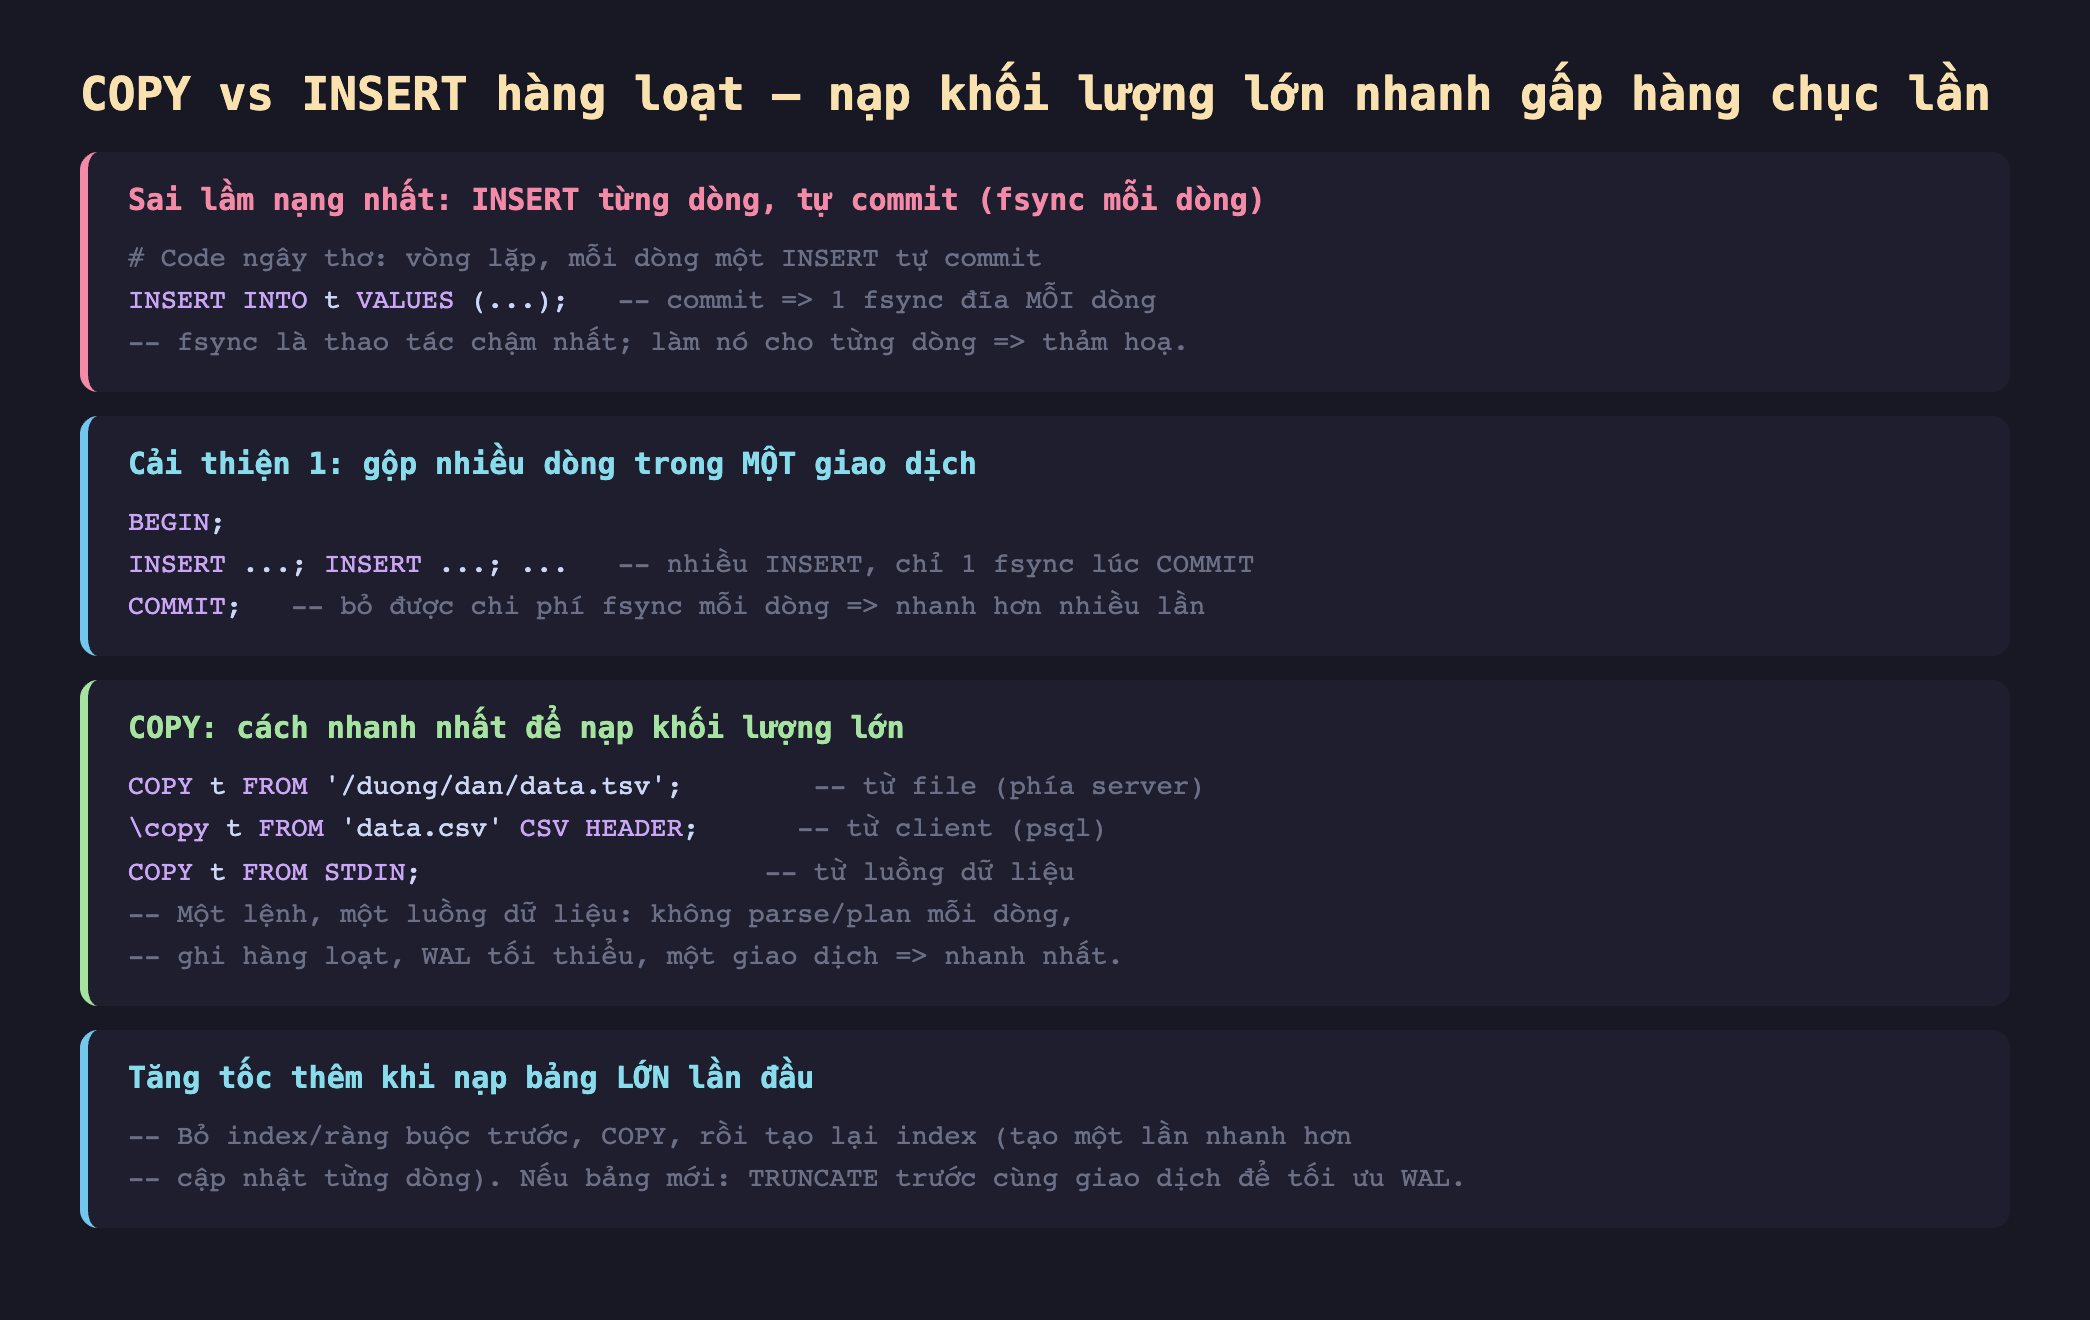
Hình 1: INSERT từng dòng tự commit làm fsync mỗi dòng — thảm họa. Gộp nhiều dòng trong một giao dịch bỏ được fsync mỗi dòng. COPY (từ file/client/STDIN) là cách nhanh nhất: một lệnh, ghi hàng loạt, WAL tối thiểu.
Đo thật: bốn cấp độ nạp dữ liệu
Đo cùng 200.000 dòng bằng bốn cách:
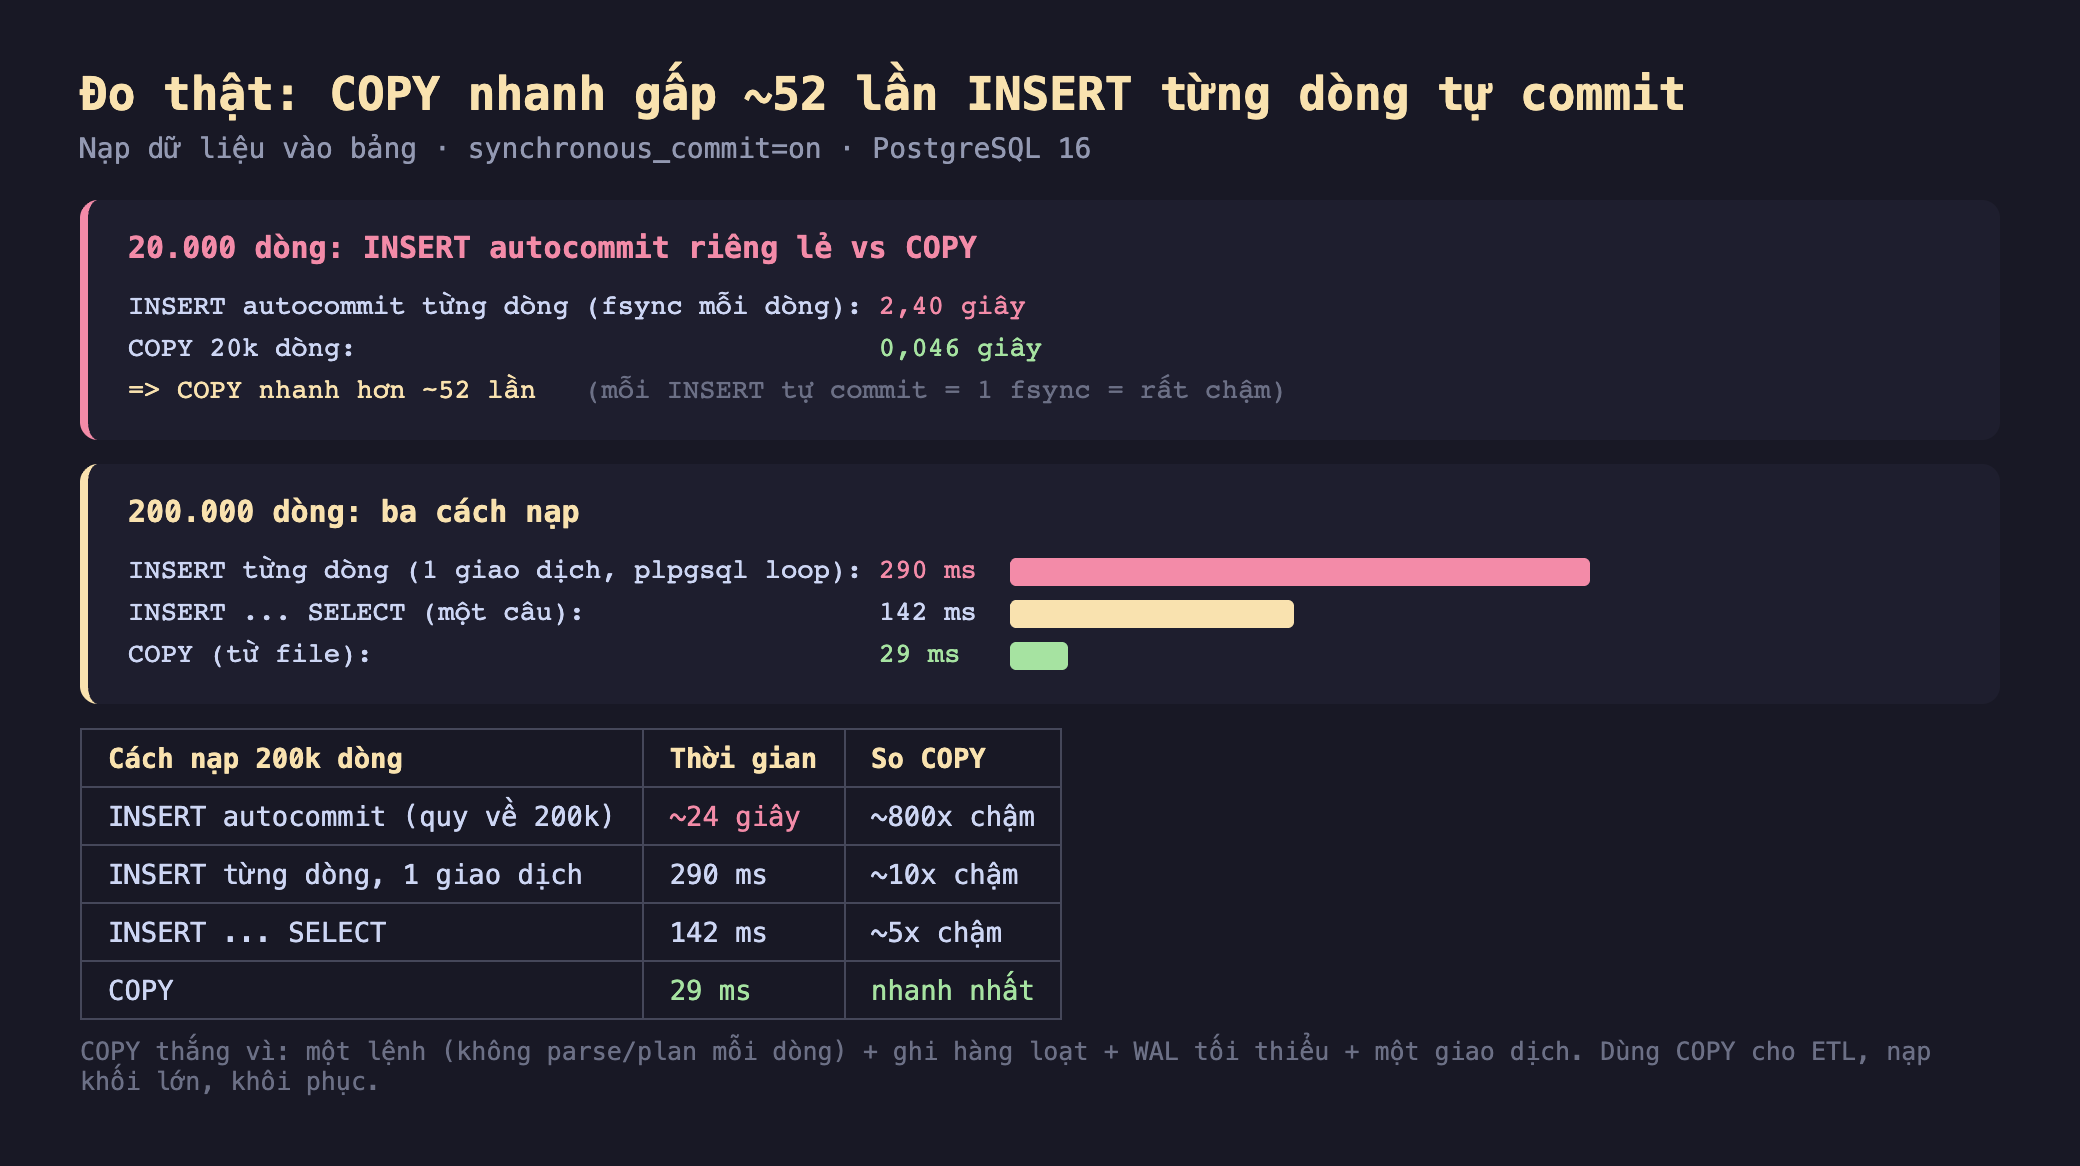
Hình 2: 20k dòng — INSERT autocommit 2,40 giây so với COPY 0,046 giây (~52×). 200k dòng — INSERT từng dòng trong một giao dịch 290 ms, INSERT ... SELECT một câu 142 ms, COPY 29 ms. INSERT autocommit quy về 200k dòng khoảng 24 giây (~800× chậm hơn COPY).
- INSERT autocommit riêng lẻ: chậm nhất — fsync mỗi dòng (quy về 200k dòng là ~24 giây, ~800× chậm hơn COPY).
- INSERT từng dòng trong MỘT giao dịch: 290 ms — bỏ được fsync mỗi dòng (chỉ 1 fsync lúc COMMIT), nhanh hơn hàng chục lần, nhưng vẫn phải parse/plan mỗi câu.
- INSERT ... SELECT (một câu, chèn 200k dòng): 142 ms — một câu lệnh duy nhất, không round-trip mỗi dòng.
- COPY (từ file): 29 ms — nhanh nhất.
Ba cải thiện lớn nhất theo thứ tự: (1) đừng autocommit từng dòng — gói vào giao dịch; (2) dùng một câu (multi-row INSERT hoặc INSERT-SELECT) thay vì N câu; (3) dùng COPY cho khối thật lớn.
Vì sao COPY nhanh
COPY thắng vì nó tránh được mọi chi phí lặp lại của INSERT: một lệnh duy nhất (không phân tích cú pháp và lập kế hoạch cho từng dòng), dữ liệu đến dưới dạng một luồng (không round-trip mỗi dòng), rows được ghi hàng loạt vào trang, WAL tối thiểu (một số trường hợp còn giảm WAL nếu bảng vừa tạo trong cùng giao dịch), và tất cả trong một giao dịch (một fsync). Đó là công cụ đúng cho mọi tình huống nạp khối lớn: ETL, khôi phục (pg_restore dùng COPY), nạp ban đầu, đổ dữ liệu vào shard.
COPY t FROM '/duong/dan/data.tsv';    -- từ file (đọc bởi server)
\copy t FROM 'data.csv' CSV HEADER;   -- từ client (psql đọc file cục bộ)
COPY t FROM STDIN;                    -- từ luồng (driver ứng dụng)
Đánh đổi cần cân nhắc
Bỏ index trước khi COPY bảng lớn lần đầu, tạo lại sau. Nếu nạp vào bảng đã có index, mỗi dòng COPY vẫn phải cập nhật mọi index — chậm dần. Với nạp ban đầu khối lớn: DROP (hoặc chưa tạo) index, COPY, rồi CREATE INDEX một lần (tạo một lần nhanh hơn cập nhật từng dòng). Với bảng đang phục vụ thì không làm được điều này.
COPY không có logic per-row như INSERT ... ON CONFLICT. COPY nạp thô, không hỗ trợ upsert/xử lý xung đột trực tiếp. Mẫu chuẩn: COPY vào một bảng tạm (staging), rồi INSERT INTO ... SELECT FROM staging ON CONFLICT ... để merge. Đây là cách ETL thực dụng: COPY nhanh vào staging, xử lý logic bằng SQL tập hợp.
Một dòng lỗi làm hỏng cả COPY. COPY mặc định thất bại toàn bộ nếu một dòng sai định dạng/vi phạm ràng buộc (giao dịch rollback). PostgreSQL mới có tùy chọn ON_ERROR ignore (PG17) để bỏ qua dòng lỗi; bản cũ hơn thì phải làm sạch dữ liệu trước, hoặc COPY vào staging không ràng buộc rồi lọc.
Ba ý mang về
- Đừng bao giờ INSERT từng dòng tự commit cho khối lớn: đo thật, 20k dòng autocommit mất 2,40 giây (fsync mỗi dòng) so với COPY 0,046 giây — chậm ~52 lần; quy về 200k dòng là ~24 giây so với 29 ms của COPY (~800×).
- Có bốn cấp độ, dùng cấp phù hợp: autocommit từng dòng (tệ nhất) → gộp trong một giao dịch (290 ms, bỏ fsync mỗi dòng) → INSERT ... SELECT một câu (142 ms) → COPY (29 ms, nhanh nhất cho khối lớn).
- COPY nhanh vì một lệnh + ghi hàng loạt + WAL tối thiểu + một giao dịch: dùng cho ETL/khôi phục/nạp ban đầu; bỏ index trước rồi tạo lại khi nạp bảng lớn lần đầu; và COPY vào staging rồi merge bằng SQL nếu cần logic upsert.
Phần sau ta đo cấp độ ở giữa mà nhiều ứng dụng dùng thực tế: Phần sau mổ xẻ multi-row INSERT (INSERT ... VALUES (...),(...),...) và batch — kích thước lô tối ưu, và khi nào chúng đủ tốt thay cho COPY.
