Mọi tối ưu trên một máy đơn — index, phân vùng, nén, pool — đều có trần. Khi lượng ghi và dữ liệu vượt sức một máy chủ mạnh nhất, lựa chọn còn lại là sharding: chia dữ liệu ngang qua nhiều máy, mỗi máy giữ một phần. Đây là bước nhảy về độ phức tạp lớn nhất trong sê-ri. Bài này đo thật cơ chế sharding bằng postgres_fdw và làm rõ đánh đổi cốt lõi: shard key quyết định thành bại.
Khi nào cần sharding
Trước sharding, hãy vắt kiệt các lựa chọn rẻ hơn: nâng cấp máy (vertical scaling — có trần RAM/CPU/đĩa), thêm replica đọc (mở rộng đọc, nhưng ghi vẫn dồn về một primary). Chỉ khi lượng ghi hoặc dữ liệu vượt sức một máy — replica không cứu được ghi, và một máy không chứa/xử lý nổi — thì mới cần chia ngang qua nhiều máy.
Có ba cách tiếp cận:
- postgres_fdw (native): bảng phân vùng mà một số partition là foreign table ở server khác — PostgreSQL tự route truy vấn theo shard key. (Demo bài này.)
- Citus (extension): biến PostgreSQL thành CSDL phân tán thực thụ — coordinator + worker nodes, tự phân mảnh và fan-out song song.
- Application-level: ứng dụng tự chọn shard theo khóa và tự gộp kết quả — linh hoạt nhất nhưng dồn phức tạp vào code.
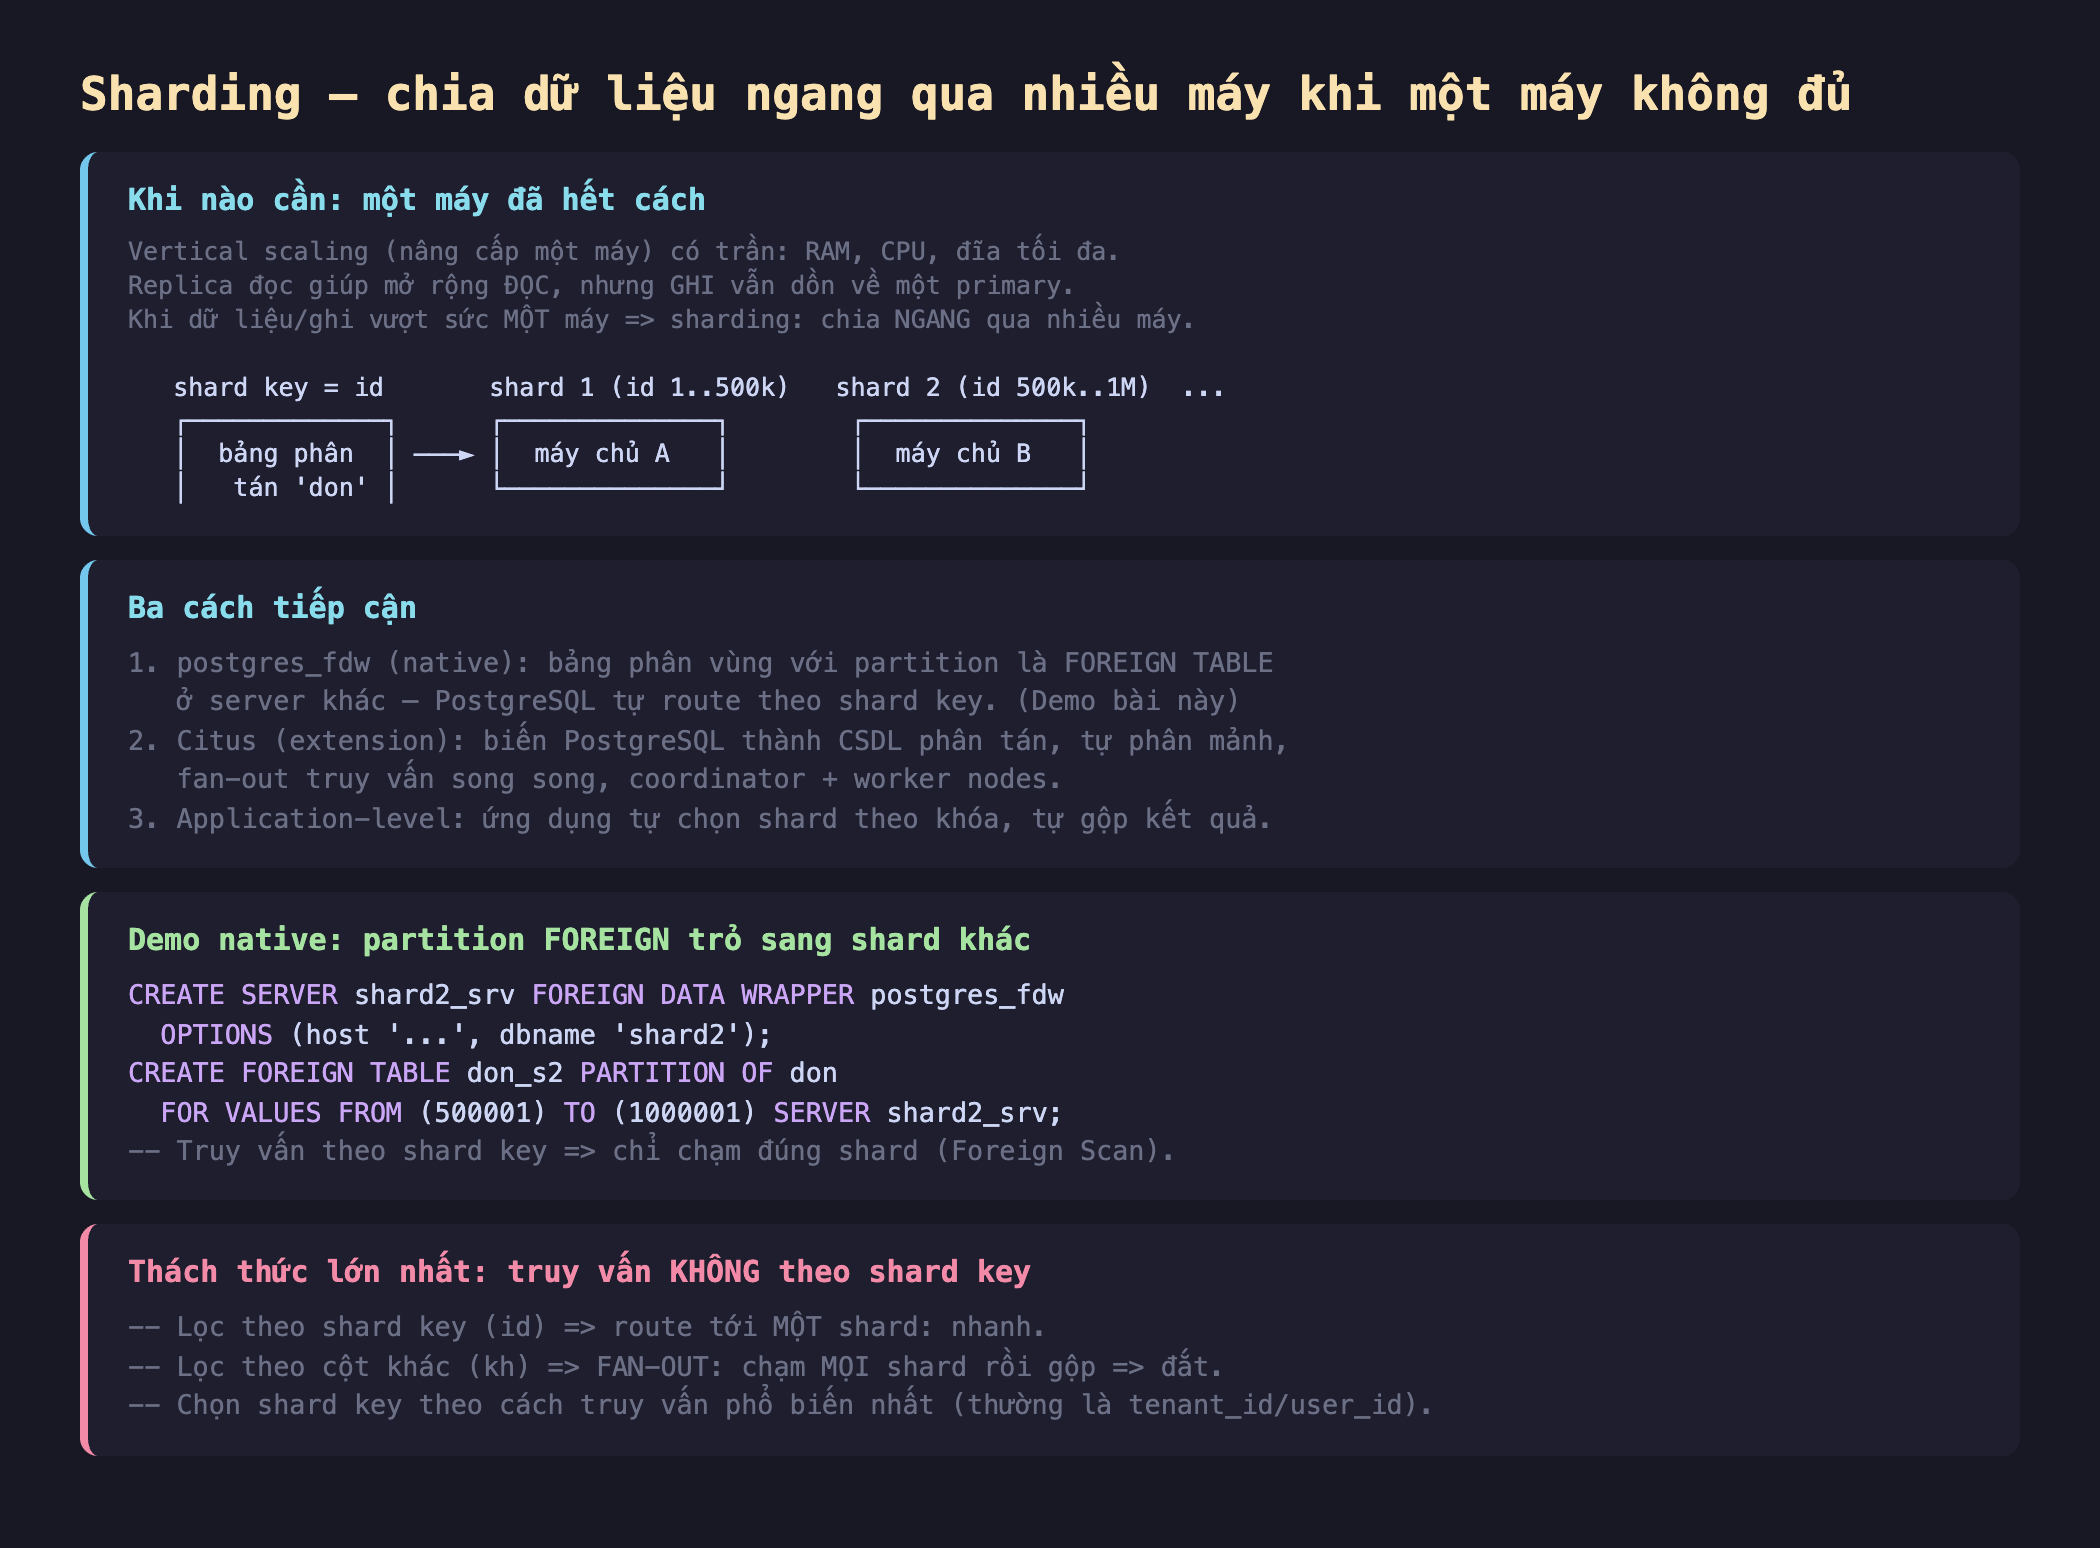
Hình 1: Sharding chia dữ liệu ngang qua nhiều máy theo shard key khi một máy không đủ. Ba cách tiếp cận: postgres_fdw (native), Citus (phân tán), application-level. Thách thức lớn nhất là truy vấn không theo shard key.
Đo thật: bảng phân tán qua postgres_fdw
Tôi dựng một shard thứ hai (database shard2), rồi tạo bảng phân vùng don với partition đầu cục bộ và partition thứ hai là foreign table trên shard2:
CREATE SERVER shard2_srv FOREIGN DATA WRAPPER postgres_fdw
  OPTIONS (host '...', dbname 'shard2');
CREATE FOREIGN TABLE don_s2 PARTITION OF don
  FOR VALUES FROM (500001) TO (1000001) SERVER shard2_srv;
Bảng don giờ có 1 triệu dòng: 500k cục bộ (don_s1) + 500k trên shard2 (don_s2). Truy vấn xuyên suốt như một bảng. Đo thật cách truy vấn route:
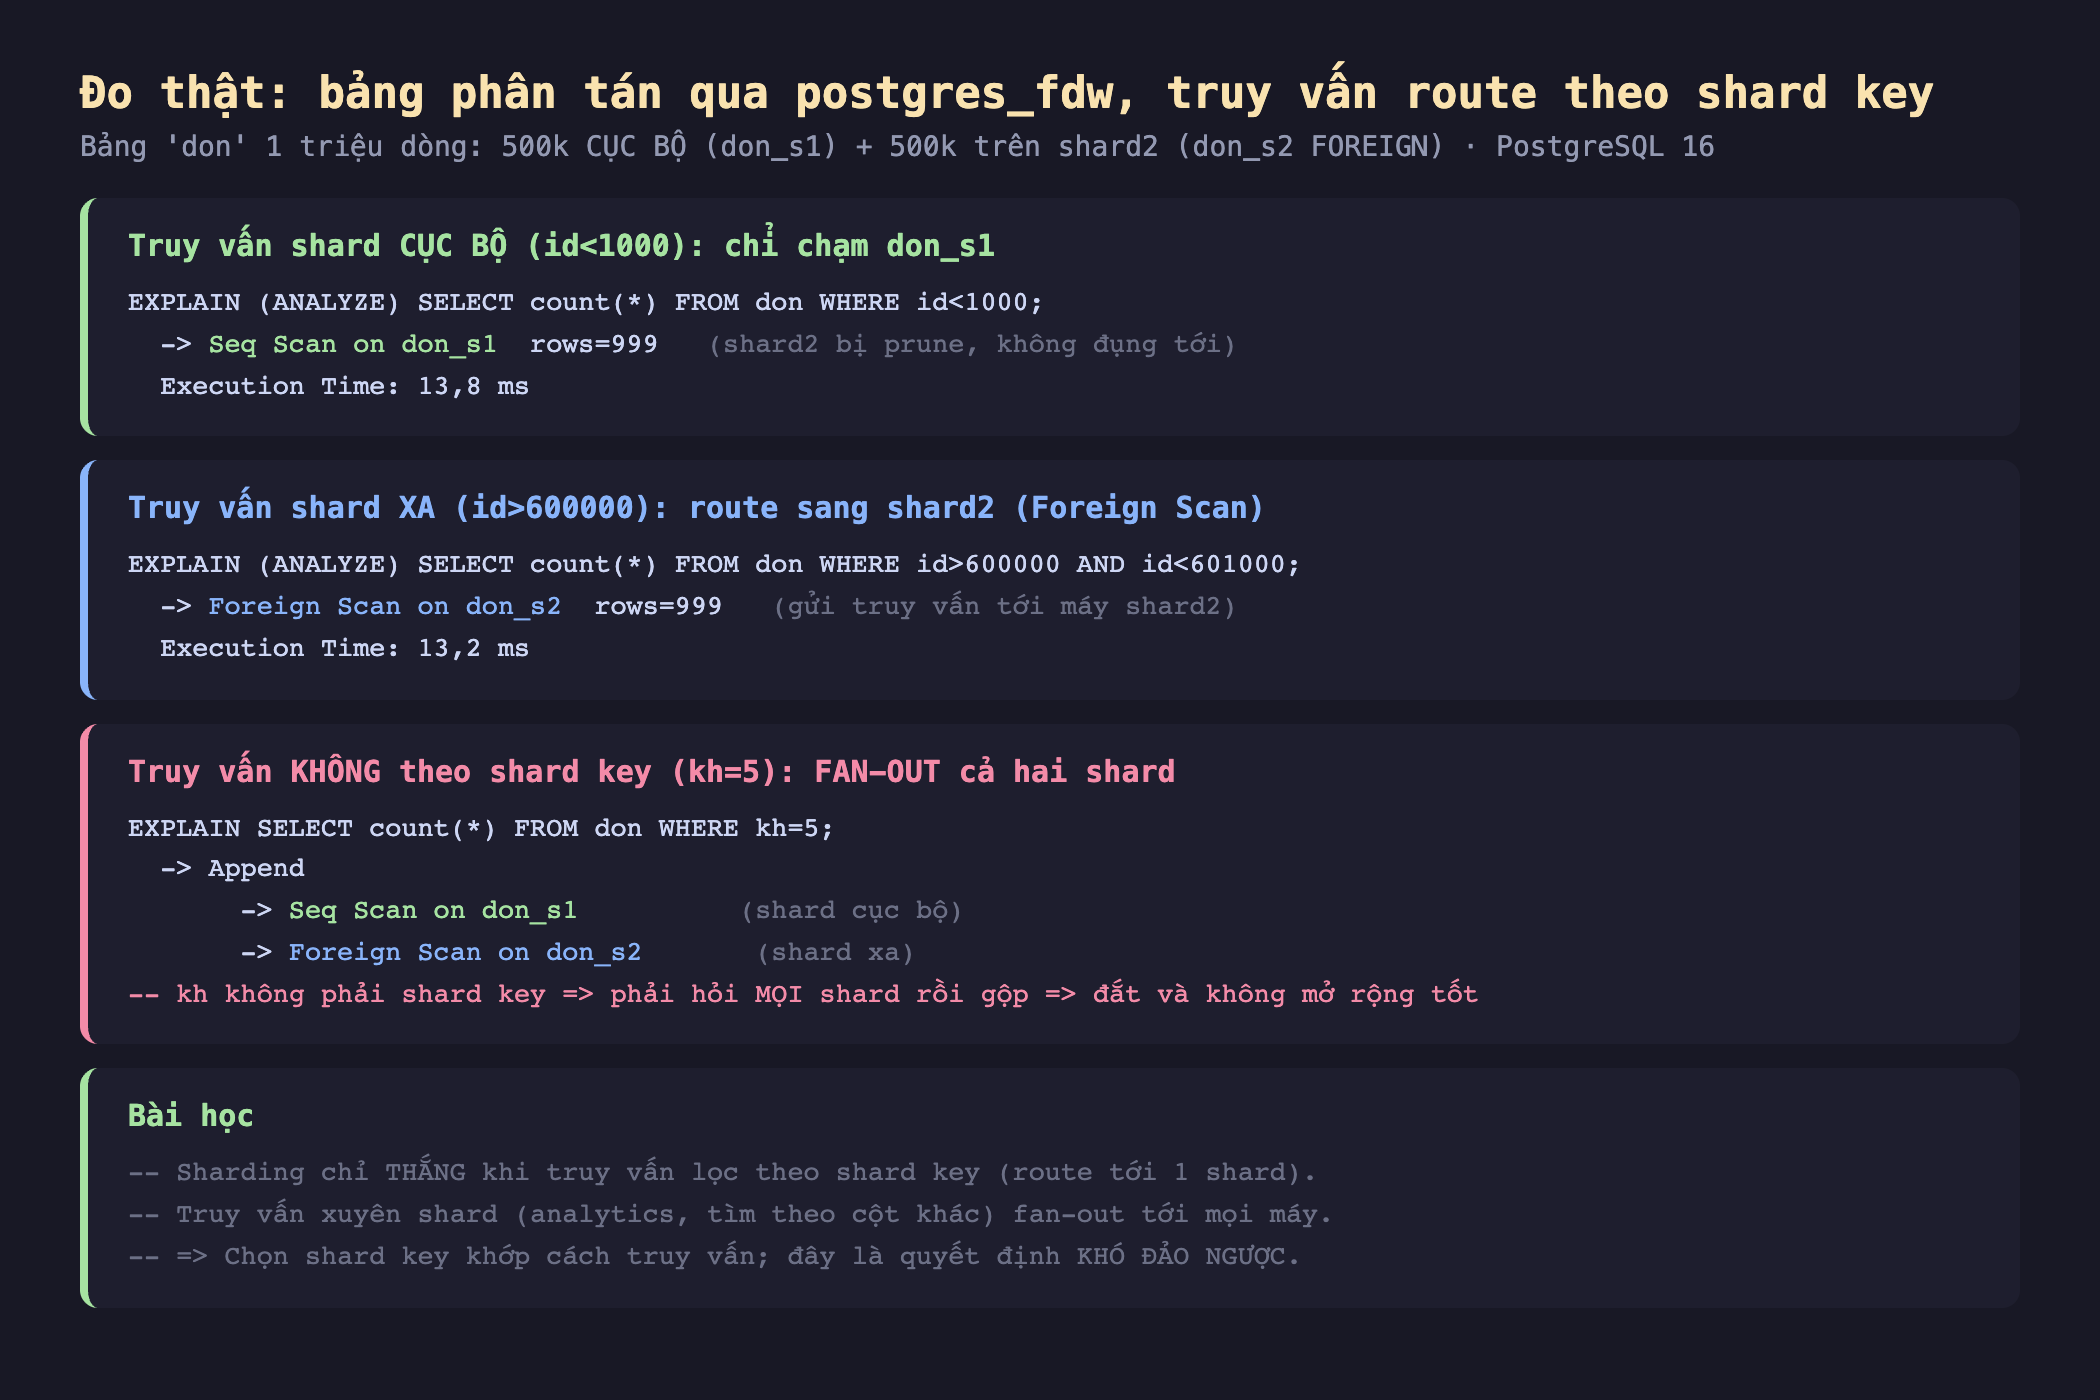
Hình 2: Truy vấn id<1000 (shard cục bộ) chỉ Seq Scan on don_s1 (shard2 bị prune), 13,8 ms. Truy vấn id>600000 route sang shard2 qua Foreign Scan on don_s2, 13,2 ms. Truy vấn kh=5 (không phải shard key) fan-out: Append của Seq Scan cục bộ + Foreign Scan xa — chạm cả hai shard.
- Truy vấn theo shard key (
id<1000): chỉ chạmdon_s1cục bộ — shard2 bị prune hoàn toàn, không đụng tới. 13,8 ms. - Truy vấn shard xa (
id>600000): PostgreSQL gửi truy vấn tới máy shard2 quaForeign Scan on don_s2. 13,2 ms. Chỉ một shard được hỏi. - Truy vấn KHÔNG theo shard key (
kh=5): phải fan-out —AppendcủaSeq Scan on don_s1(cục bộ) vàForeign Scan on don_s2(xa). Chạm mọi shard rồi gộp.
Đây là bức tranh cốt lõi của sharding: truy vấn lọc theo shard key route tới đúng một shard (nhanh, mở rộng tuyến tính theo số máy). Truy vấn không theo shard key phải hỏi mọi shard — đắt và không mở rộng tốt.
Đánh đổi cần cân nhắc
Chọn shard key là quyết định khó đảo ngược nhất. Shard key quyết định dữ liệu nằm ở đâu và truy vấn nào route tới một máy (nhanh) so với fan-out mọi máy (chậm). Chọn theo cách ứng dụng truy vấn phổ biến nhất — thường là tenant_id hoặc user_id (đa số truy vấn theo một tenant/user). Chọn sai thì đổi lại nghĩa là reshard — di chuyển toàn bộ dữ liệu, cực tốn kém. Cân nhắc kỹ từ đầu.
Sharding đánh mất nhiều tiện ích của một máy đơn. JOIN xuyên shard tốn kém (dữ liệu ở máy khác); ràng buộc unique/khóa ngoại toàn cục khó (mỗi shard độc lập); giao dịch phân tán (two-phase commit) chậm và phức tạp; ANALYZE, backup, nâng cấp phải làm trên nhiều máy. Đây là cái giá thật của phân tán — đừng shard sớm.
Đừng shard khi chưa cần. Sharding là biện pháp cuối. Một PostgreSQL đơn hiện đại xử lý được hàng chục TB và hàng trăm nghìn TPS với phần cứng tốt + phân vùng + pool + tối ưu truy vấn. Phần lớn hệ thống không cần shard; những hệ thống cần thì thường dùng Citus (để đỡ tự dựng) hoặc thiết kế sharding vào ứng dụng từ đầu. Vắt kiệt một máy trước.
Ba ý mang về
- Sharding chia dữ liệu ngang qua nhiều máy khi một máy không đủ: đo thật với postgres_fdw, bảng phân tán 1 triệu dòng qua 2 shard truy vấn xuyên suốt như một bảng — nhưng là biện pháp cuối, sau khi đã vắt kiệt nâng cấp máy, replica, phân vùng và tối ưu truy vấn.
- Truy vấn theo shard key route tới một máy, không theo shard key thì fan-out mọi máy: đo thật,
id<1000chỉ chạm shard cục bộ,id>600000route sang shard2 (Foreign Scan), cònkh=5(không phải shard key) fan-out cả hai shard — sharding chỉ mở rộng tốt cho truy vấn khớp shard key. - Chọn shard key là quyết định khó đảo ngược: chọn theo cách truy vấn phổ biến nhất (thường tenant_id/user_id); và nhớ sharding đánh mất JOIN/unique/giao dịch dễ dàng của một máy đơn — dùng Citus hoặc thiết kế từ đầu, đừng shard sớm.
Phần sau ta quay về một kỹ thuật thực dụng dùng cho cả nạp dữ liệu vào shard lẫn ETL hằng ngày: Phần sau đo COPY so với INSERT hàng loạt — vì sao COPY nhanh hơn nhiều lần khi nạp khối lượng lớn, và cách dùng đúng.
