Bạn có ba triệu dòng cần nạp vào một bảng — di cư dữ liệu, khôi phục từ backup, hay nhập một khối lớn. Bảng đích đã có sẵn vài index. Bạn chạy INSERT ... SELECT và ngồi chờ... rất lâu. Thủ phạm không phải là việc ghi dữ liệu, mà là các index: mỗi dòng chèn buộc PostgreSQL cập nhật từng index một. Có một chiến thuật kinh điển đảo ngược điều này: bỏ index đi, nạp, rồi tạo lại. Bài này đo thật xem nó nhanh hơn bao nhiêu — và một chỗ mà trực giác về maintenance_work_mem bị sai.
Vì sao index làm chậm việc nạp
Khi bảng có index, mỗi lần chèn một dòng không chỉ là ghi dòng đó vào heap. PostgreSQL còn phải chèn một mục vào mỗi cây B-tree của mỗi index — tìm đúng trang lá, chèn vào, đôi khi tách trang. Với bốn index, một dòng chèn thành năm thao tác ghi rải rác. Làm ba triệu lần, các cây B-tree bị sửa lung tung theo thứ tự ngẫu nhiên của dữ liệu, trang phân mảnh, và tổng thời gian đội lên.
Ngược lại, CREATE INDEX trên một bảng đã đầy đọc toàn bộ dữ liệu một lượt, sắp xếp, rồi dựng cây B-tree từ dưới lên — gọn gàng và tuần tự. Đó là lý do tạo index một lần sau khi nạp thường rẻ hơn nhiều so với vá nó từng dòng trong lúc nạp.
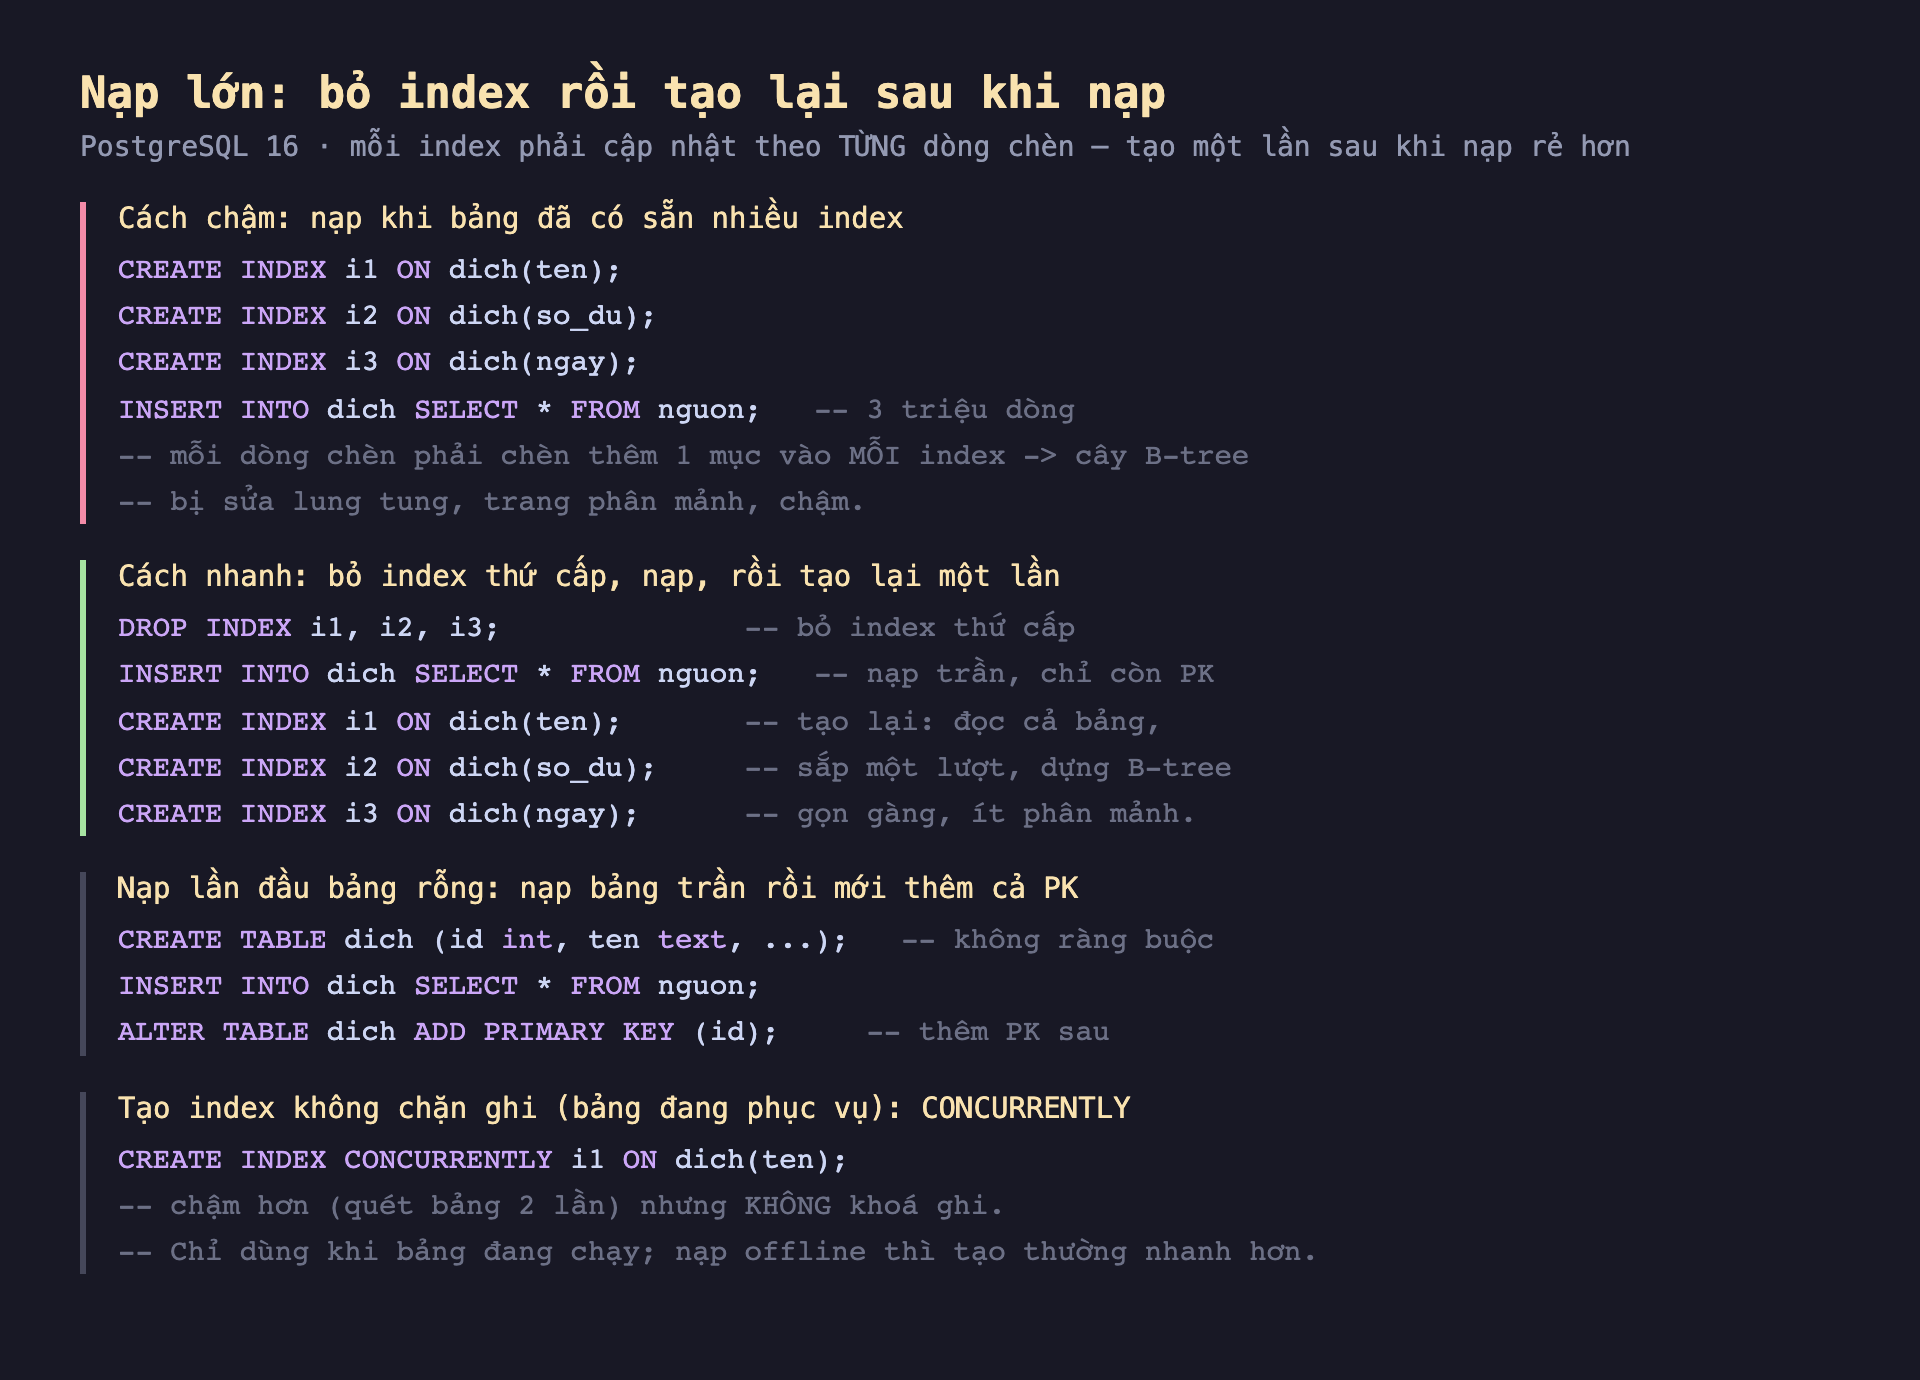
Hình 1: Nạp khi index đã có sẵn buộc cập nhật mỗi index theo từng dòng; bỏ index thứ cấp, nạp, rồi CREATE INDEX một lần thì rẻ hơn. Thêm cách thêm PK sau, và CONCURRENTLY cho bảng đang phục vụ.
Đo thật: 12,6 giây so với 7 giây
Bảng năm cột, dữ liệu nguồn ba triệu dòng, bốn index (khoá chính id, cộng ten, so_du, ngay). So hai cách nạp:
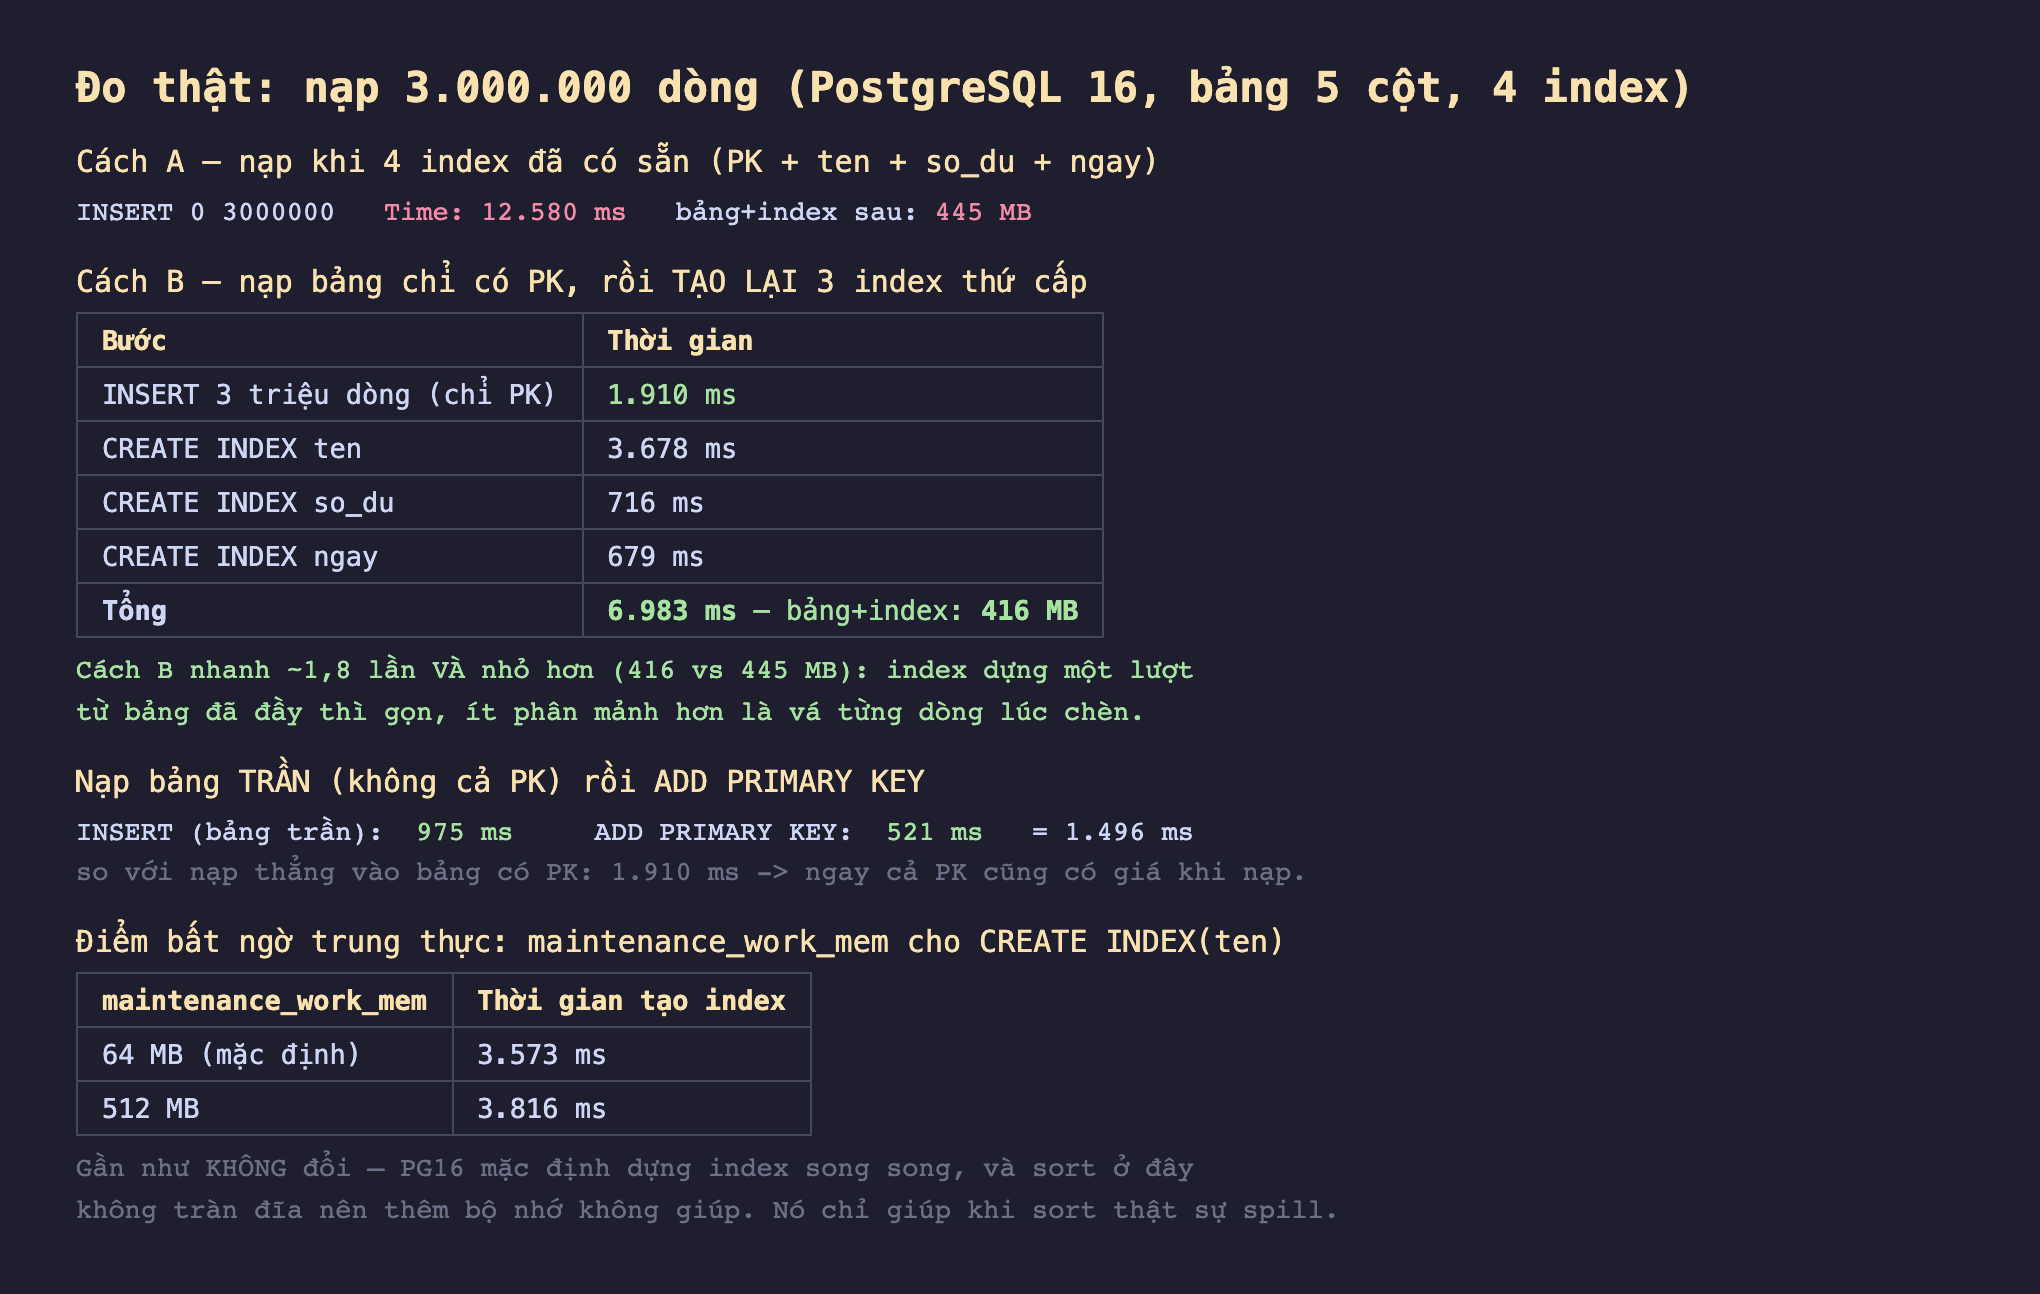
Hình 2: Cách A (4 index sẵn) 12.580 ms, bảng 445 MB. Cách B (nạp chỉ PK rồi tạo lại 3 index) tổng 6.983 ms, bảng 416 MB — nhanh ~1,8 lần và nhỏ hơn. Nạp bảng trần rồi thêm PK: 1.496 ms. maintenance_work_mem 64→512 MB gần như không đổi.
Con số thật:
- Cách A — nạp khi 4 index đã có sẵn:
INSERTba triệu dòng mất 12.580 ms, bảng + index cuối cùng 445 MB. - Cách B — nạp bảng chỉ có PK, rồi tạo lại 3 index thứ cấp:
INSERTchỉ 1.910 ms (nhanh hơn hẳn vì không phải vá ba index phụ), rồi tạo lại ba index mất 3.678 + 716 + 679 ms. Tổng 6.983 ms, bảng + index 416 MB.
Cách B nhanh ~1,8 lần và cho ra bảng nhỏ hơn (416 so với 445 MB). Điểm thứ hai đáng chú ý: index được dựng một lượt từ bảng đã đầy thì đặc và ít phân mảnh hơn là index bị chèn dần từng dòng theo thứ tự ngẫu nhiên. Nghĩa là bỏ-rồi-tạo-lại không chỉ nhanh hơn mà còn cho index chất lượng tốt hơn.
Ngay cả khoá chính cũng có giá
Ở cách B tôi vẫn giữ khoá chính trong lúc nạp. Nếu đây là lần nạp đầu tiên vào bảng rỗng, ta có thể đi xa hơn: nạp vào bảng hoàn toàn trần rồi thêm khoá chính sau.
CREATE TABLE dich (id int, ten text, so_du int, ma_hash text, ngay date);
INSERT INTO dich SELECT * FROM nguon;      -- 975 ms
ALTER TABLE dich ADD PRIMARY KEY (id);     -- 521 ms
Đo thật: nạp bảng trần mất 975 ms rồi thêm khoá chính 521 ms — tổng 1.496 ms, so với 1.910 ms khi nạp thẳng vào bảng đã có khoá chính. Ngay cả một index duy nhất là khoá chính cũng làm chậm việc nạp, vì nó phải kiểm tra tính duy nhất cho từng dòng. Lưu ý cách này chỉ hợp lý khi nạp lần đầu; nếu bảng đã có dữ liệu thì thêm khoá chính sau có thể thất bại nếu dữ liệu mới trùng khoá.
Điểm bất ngờ: maintenance_work_mem không phải lúc nào cũng giúp
CREATE INDEX dùng maintenance_work_mem để sắp xếp. Trực giác thường thấy: tăng nó lên thì tạo index nhanh hơn. Tôi thử tạo lại index trên cột ten với hai mức:
maintenance_work_mem = 64 MB(mặc định): 3.573 msmaintenance_work_mem = 512 MB: 3.816 ms
Gần như không đổi — thậm chí nhỉnh hơn chút do nhiễu. Lý do trung thực: PostgreSQL 16 mặc định dựng index song song bằng nhiều tiến trình, và với dữ liệu này bước sắp xếp không tràn ra đĩa ở mức 64 MB. Khi sort đã nằm gọn trong bộ nhớ, cấp thêm bộ nhớ chẳng thay đổi gì. maintenance_work_mem chỉ thật sự giúp khi bước sắp xếp tràn đĩa (bảng rất lớn, cột index rộng) — lúc đó tăng nó tránh được external merge sort. Đừng tăng nó theo thói quen mà không đo.
Đánh đổi cần cân nhắc
Chỉ hiệu quả khi nạp một khối đủ lớn. Với vài nghìn dòng, chi phí DROP/CREATE INDEX (quét lại cả bảng) lớn hơn phần tiết kiệm. Chiến thuật này dành cho nạp hàng trăm nghìn tới hàng triệu dòng. Chèn lắt nhắt vài dòng thì cứ giữ index.
Bảng "mù" trong lúc index bị bỏ. Giữa lúc DROP INDEX và CREATE INDEX xong, mọi truy vấn dựa trên các index đó sẽ quét tuần tự — chậm. Nếu bảng đang phục vụ production, đây là vấn đề. Khi đó dùng CREATE INDEX CONCURRENTLY để tạo lại mà không khoá ghi (đổi lại nó quét bảng hai lần nên chậm hơn), hoặc chọn cửa sổ bảo trì. Với nạp offline (bảng chưa ai dùng) thì CREATE INDEX thường nhanh hơn CONCURRENTLY.
Đừng quên tạo lại đủ mọi index và ràng buộc. Bỏ rồi tạo lại thủ công dễ sót một index, hoặc quên UNIQUE/NOT NULL. Ghi lại định nghĩa index trước khi bỏ (\d+ bang hoặc pg_get_indexdef), và với dữ liệu quan trọng, cân nhắc COPY cùng các kỹ thuật khác (như bài COPY đã đo) để tối ưu tổng thể.
Ba ý mang về
- Mỗi index phải cập nhật theo từng dòng chèn, nên nạp vào bảng đã đầy index rất chậm: đo thật, nạp 3 triệu dòng với 4 index sẵn mất 12.580 ms, còn bỏ index thứ cấp rồi tạo lại sau khi nạp chỉ 6.983 ms — nhanh ~1,8 lần và bảng còn nhỏ hơn (416 so với 445 MB) vì index dựng một lượt thì ít phân mảnh.
- Ngay cả khoá chính cũng có giá khi nạp: nạp bảng trần rồi
ADD PRIMARY KEYmất 1.496 ms so với 1.910 ms khi nạp thẳng vào bảng có khoá chính — hợp lý cho lần nạp đầu tiên vào bảng rỗng. maintenance_work_memchỉ giúp tạo index khi bước sắp xếp tràn đĩa: đo thật 64 MB và 512 MB cho cùng kết quả (~3,6 giây) vì PG16 dựng index song song và sort không spill — đừng tăng theo thói quen mà không đo; và nhớ dùngCONCURRENTLYnếu bảng đang phục vụ.
Phần sau ta xét một loại bảng đặc biệt cho dữ liệu tạm và nạp nhanh: Phần sau đo UNLOGGED TABLE — vì sao bỏ ghi WAL giúp nạp nhanh hơn nhiều, và cái giá phải trả khi database khởi động lại.
