Đây là một trong những cạm bẫy hiệu năng phổ biến nhất mà PostgreSQL âm thầm giăng ra: bạn khai một khóa ngoại REFERENCES, cho rằng cơ sở dữ liệu "tự lo mọi thứ", rồi vài tháng sau một lệnh xóa đơn giản mất hàng giây. Sự thật ít ai biết: PostgreSQL tự tạo index cho PRIMARY KEY và UNIQUE, nhưng KHÔNG tạo cho cột khóa ngoại. Cột khóa ngoại của bạn trần trụi không index cho tới khi bạn tự đánh. Bài này đo thật cái giá của việc quên, và chỉ ra khi nào bạn thật sự cần index đó.
Bất ngờ: khóa ngoại không có index tự động
CREATE TABLE don_hang (
  id int8 PRIMARY KEY,               -- tự có index (don_hang_pkey)
  khach_id int8 REFERENCES khach(id),  -- KHÔNG có index tự động!
  tien int4);
Chạy \d don_hang sau lệnh này, bạn chỉ thấy don_hang_pkey — index cho khóa chính. Cột khach_id, dù là khóa ngoại, hoàn toàn không có index. PostgreSQL ép ràng buộc khóa ngoại (không cho chèn khach_id không tồn tại), nhưng không tạo index để tăng tốc cho nó. Đây là quyết định thiết kế có chủ đích — không phải index nào cũng đáng — nhưng nó khiến rất nhiều người vấp.
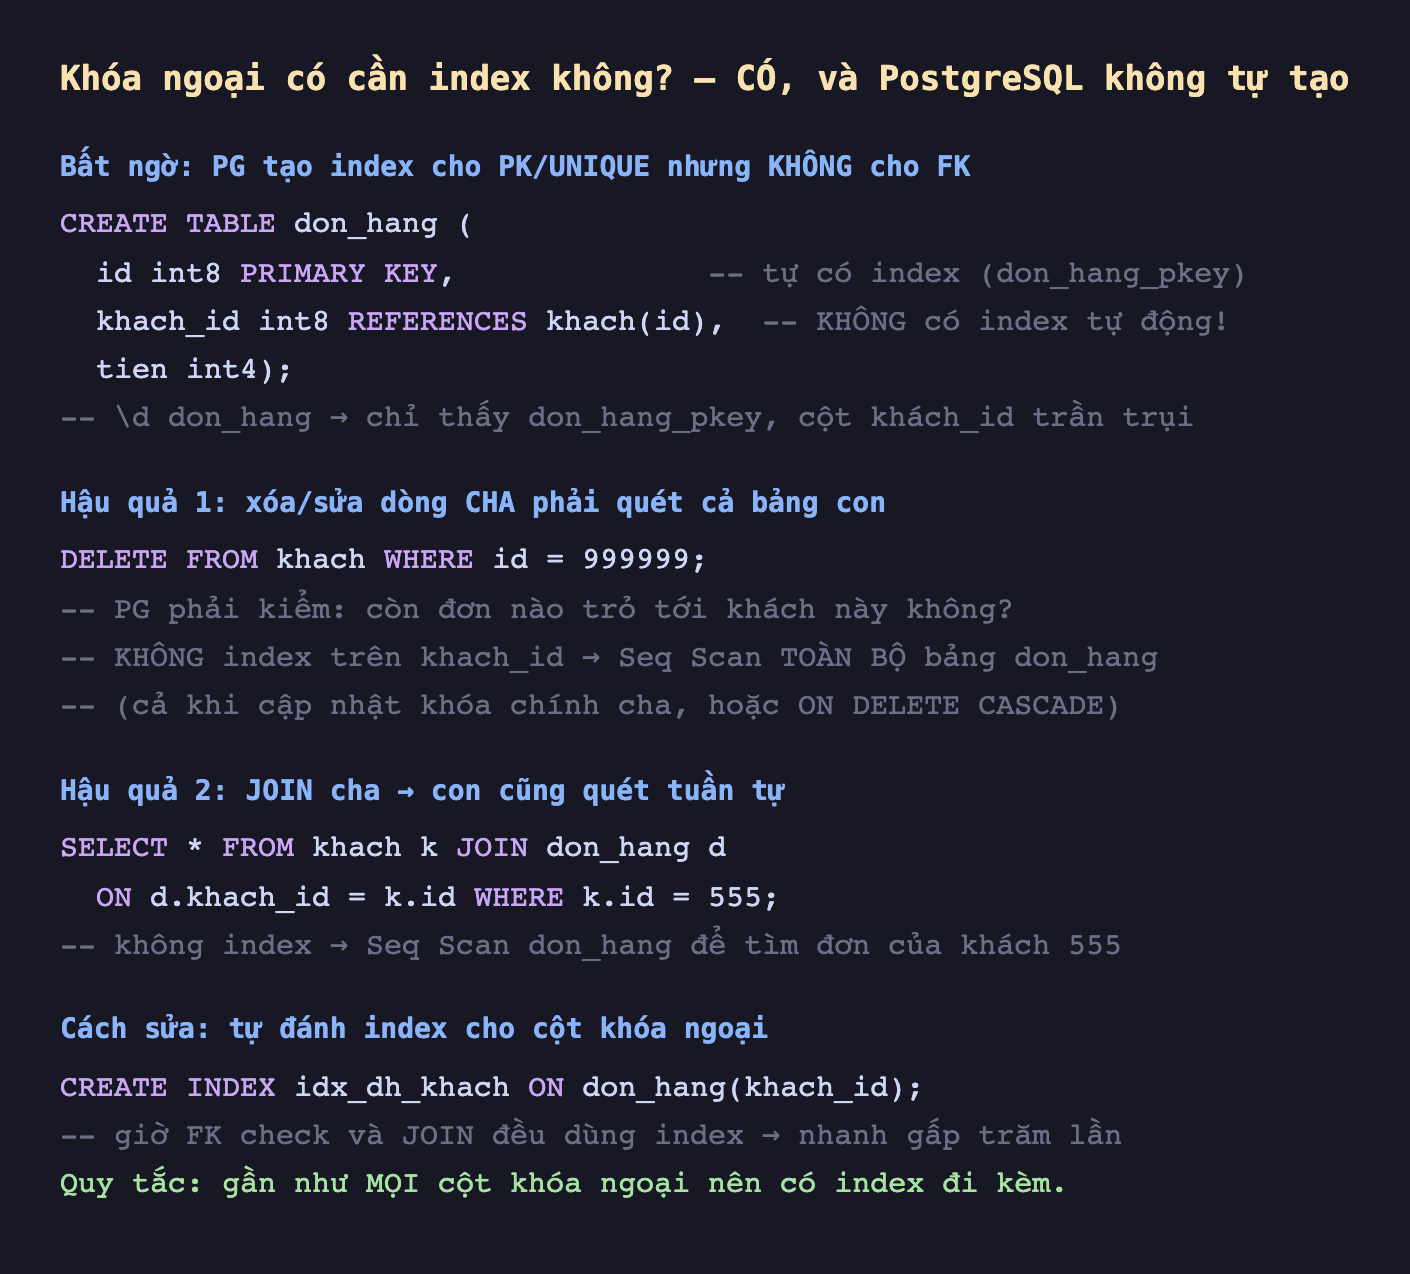
Hình 1: PostgreSQL tự tạo index cho PRIMARY KEY/UNIQUE nhưng không cho cột khóa ngoại. Thiếu nó, xóa/sửa dòng cha phải quét bảng con, và JOIN cha con seq scan. Phải tự đánh index.
Đo thật: 179 ms so với 0,7 ms
Bảng khach 100.000 dòng cha, don_hang 5 triệu dòng con với khóa ngoại khach_id không có index. Xóa một khách không còn đơn nào:
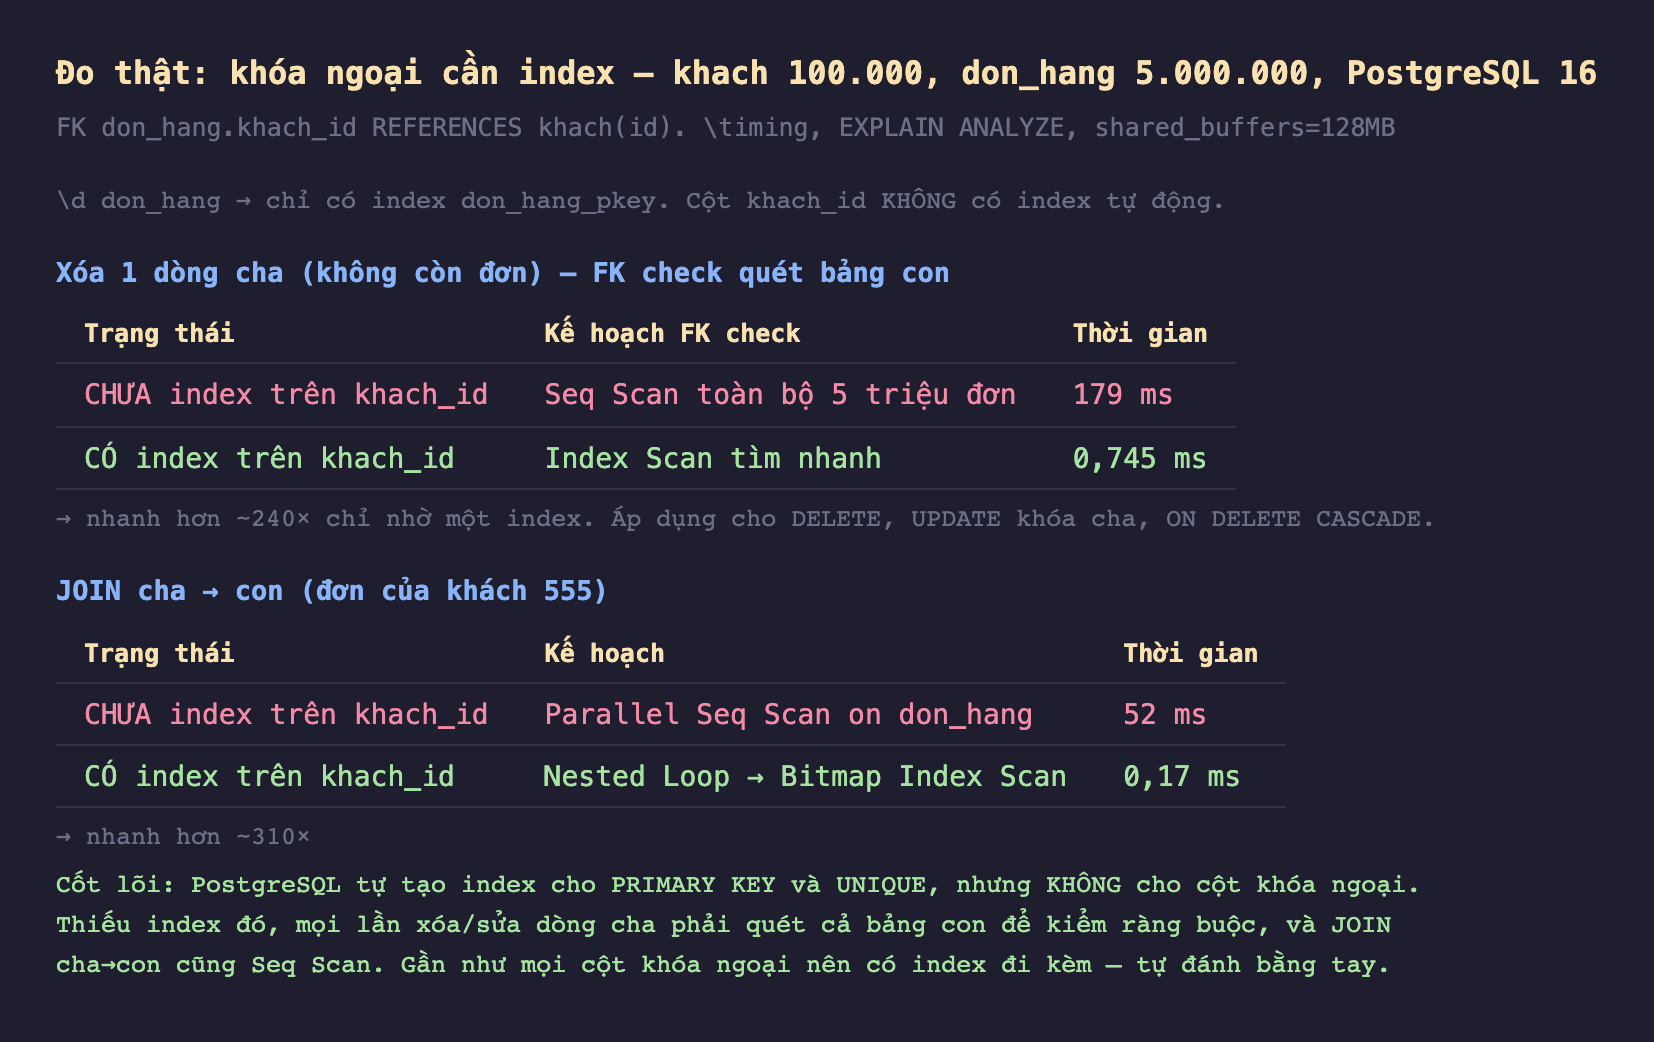
Hình 2: Xóa một dòng cha không còn con: chưa có index trên khach_id phải Seq Scan toàn bộ 5 triệu đơn (179 ms), có index chỉ 0,745 ms (~240×). JOIN cha con: Parallel Seq Scan 52 ms so với Nested Loop → Bitmap Index Scan 0,17 ms (~310×).
- Xóa dòng cha, chưa index: 179 ms. Vì sao chậm vậy cho một dòng? Khi xóa
khach, PostgreSQL phải kiểm "còn đơn nào trỏ tới khách này không" — và không có index trênkhach_id, nó phảiSeq Scantoàn bộ 5 triệu dòngdon_hangđể chắc chắn. - Xóa dòng cha, có index: 0,745 ms — nhanh hơn ~240 lần. Cùng lý do áp dụng cho
UPDATEkhóa chính của cha vàON DELETE CASCADE. - JOIN cha con, chưa index: 52 ms (
Parallel Seq Scan); có index: 0,17 ms (Nested Loop → Bitmap Index Scan) — nhanh hơn ~310 lần.
Cả hai kịch bản đều cải thiện hàng trăm lần chỉ nhờ một dòng CREATE INDEX.
Cách sửa
CREATE INDEX idx_dh_khach ON don_hang(khach_id);
Sau đó, FK check khi xóa/sửa cha dùng index tìm nhanh, và JOIN từ cha xuống con dùng index thay vì quét. Quy tắc thực dụng: gần như mọi cột khóa ngoại nên có index đi kèm — hãy tạo nó cùng lúc khai khóa ngoại, đừng để quên.
Đánh đổi cần cân nhắc
Không phải khóa ngoại nào cũng bắt buộc có index — nhưng đa số nên có. Ngoại lệ hiếm: nếu bảng cha không bao giờ bị xóa/sửa khóa chính (bảng tra cứu tĩnh như danh mục quốc gia), và bạn không bao giờ JOIN hay lọc theo cột khóa ngoại đó, thì index chỉ tốn chi phí ghi mà không dùng tới. Nhưng "không bao giờ" là lời hứa khó giữ; mặc định an toàn là luôn đánh index.
Index có chi phí ghi và dung lượng. Mỗi index làm INSERT/UPDATE chậm hơn một chút và chiếm chỗ. Với bảng con ghi cực nhiều mà FK gần như không bao giờ dùng cho xóa cha hay JOIN, cân nhắc. Nhưng chi phí này thường nhỏ so với rủi ro một lệnh xóa cha khóa bảng vài giây.
Index khóa ngoại nên khớp thứ tự truy vấn thật. Nếu bạn thường lọc WHERE khach_id=? AND ngay>?, một index tổng hợp (khach_id, ngay) phục vụ cả FK check lẫn truy vấn đó — hiệu quả hơn hai index riêng. Nghĩ về cách cột khóa ngoại được dùng trong truy vấn thật, không chỉ cho ràng buộc.
Ba ý mang về
- PostgreSQL không tự tạo index cho cột khóa ngoại (chỉ cho
PRIMARY KEYvàUNIQUE) — đây là cạm bẫy phổ biến; cột khóa ngoại trần trụi cho tới khi bạn tự đánhCREATE INDEX. - Thiếu index khóa ngoại làm xóa/sửa dòng cha quét cả bảng con: đo thật, xóa một khách không còn đơn mất 179 ms (Seq Scan 5 triệu dòng) so với 0,745 ms khi có index (~240×) — vì FK check phải xác nhận không còn dòng con nào tham chiếu.
- JOIN cha con cũng chậm nếu thiếu: đo thật JOIN theo khóa ngoại mất 52 ms không index so với 0,17 ms có index (~310×) — quy tắc thực dụng là gần như mọi cột khóa ngoại nên có index đi kèm, tạo cùng lúc khai khóa ngoại.
Phần sau ta lên tầm thiết kế tổng thể: Phần sau đo chuẩn hóa so với phi chuẩn hóa — khi nào tách bảng để tránh trùng lặp, khi nào gộp lại để tránh JOIN đắt, và cách cân bằng đúng.
