Chọn kiểu khóa chính là một trong những quyết định thiết kế khó đảo ngược nhất — nó lan ra mọi khóa ngoại, mọi index, mọi lần chèn. Cuộc tranh luận kinh điển: bigserial (số nguyên tuần tự) hay UUID? UUID hấp dẫn vì phân tán toàn cục (sinh ở bất kỳ đâu không sợ trùng) và không lộ số lượng bản ghi. Nhưng UUID ngẫu nhiên có một cái giá ẩn mà nhiều người không đo: nó làm chậm chèn và phình index. Bài này đo thật cái giá đó, và giải thích vì sao UUIDv7 thay đổi cuộc chơi.
Ba lựa chọn khóa chính
CREATE TABLE t (id bigserial PRIMARY KEY);                           -- 8 byte, tuần tự 1,2,3...
CREATE TABLE t (id uuid PRIMARY KEY DEFAULT gen_random_uuid());      -- 16 byte, NGẪU NHIÊN (v4)
CREATE TABLE t (id uuid PRIMARY KEY DEFAULT gen_uuidv7());           -- 16 byte, thời gian ở đầu (PG18)
Khác biệt cốt lõi không phải là kích thước (dù 16 byte so với 8 cũng đáng kể), mà là thứ tự sinh. bigserial sinh khóa tăng dần; gen_random_uuid() (UUID v4) sinh khóa ngẫu nhiên hoàn toàn. Thứ tự này quyết định cách khóa mới rơi vào cây btree của index.
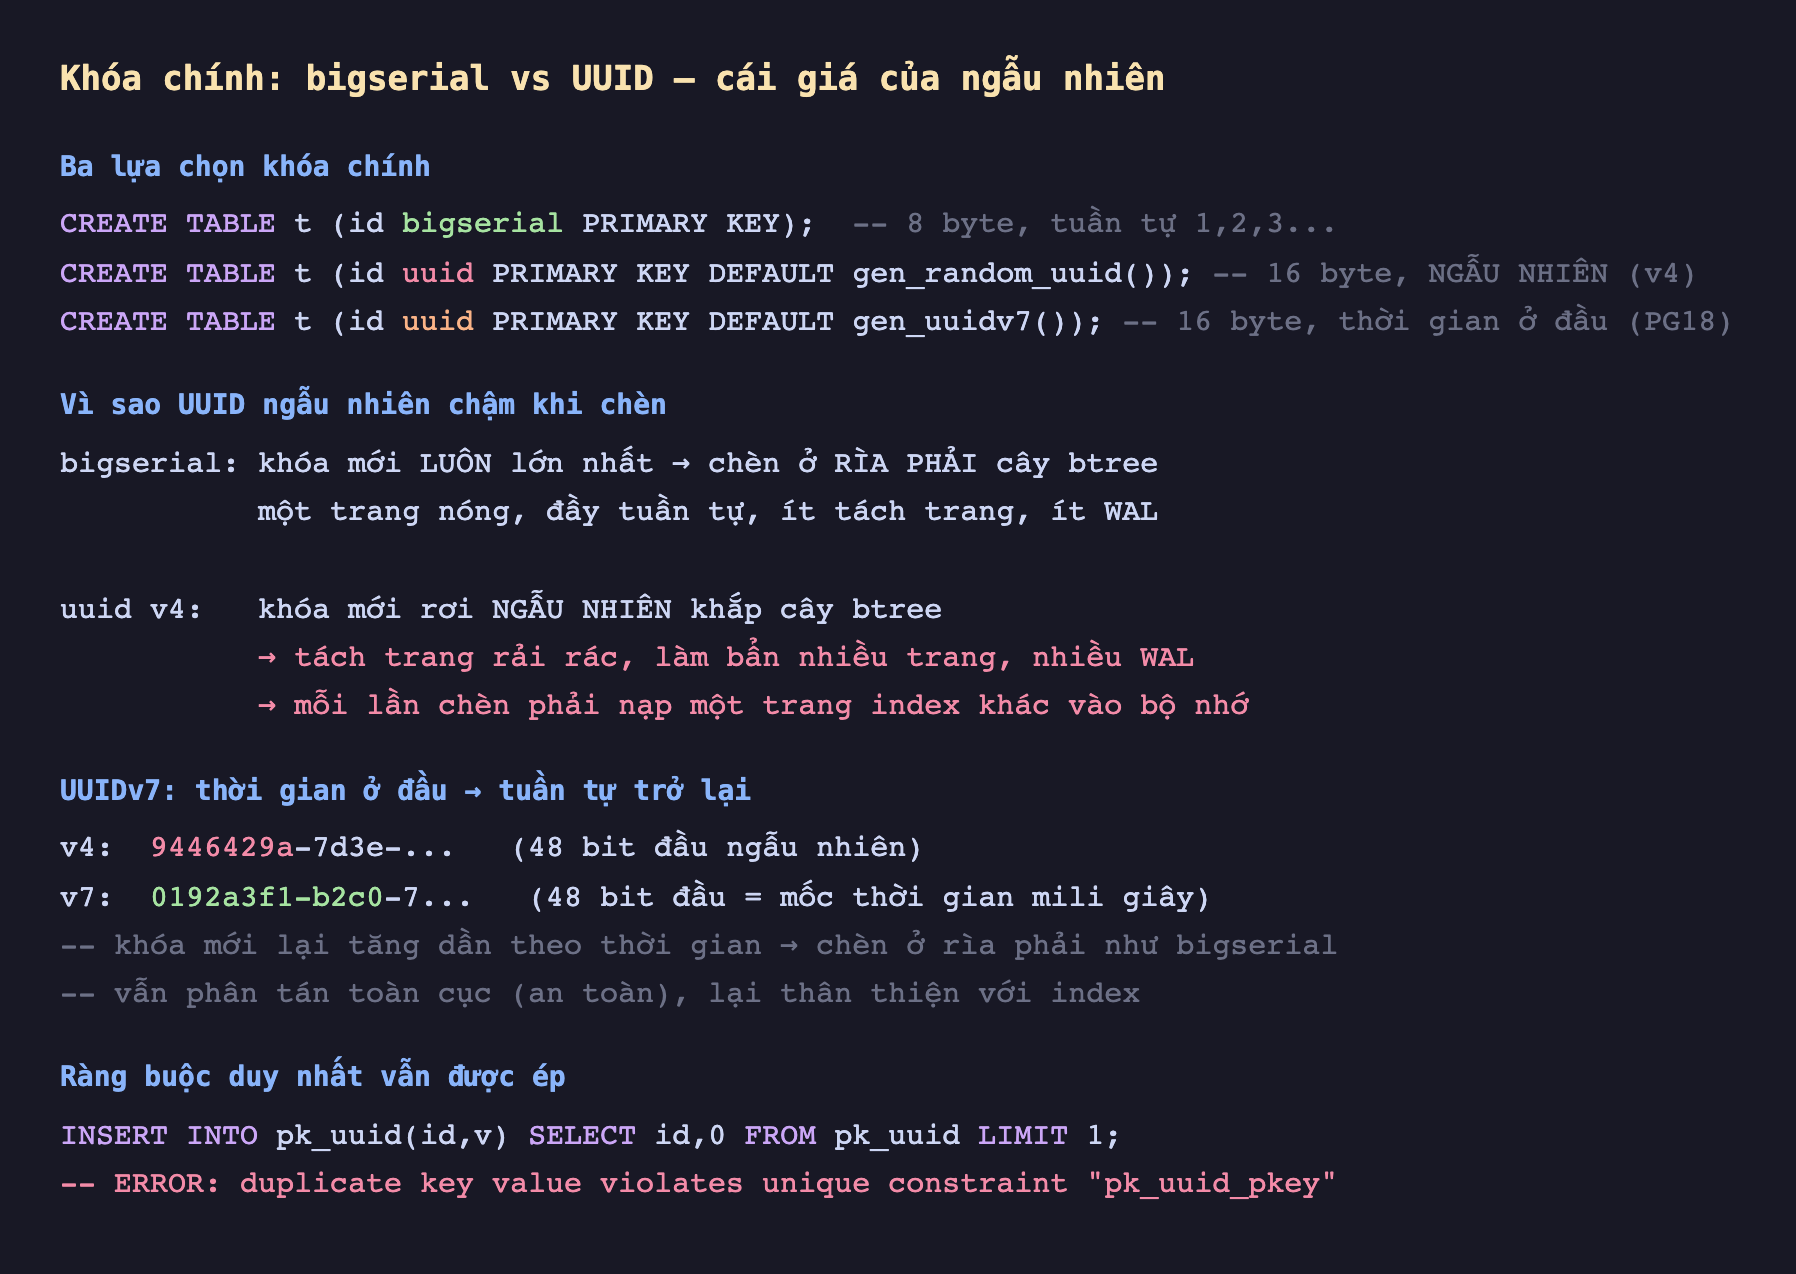
Hình 1: bigserial sinh khóa tuần tự nên chèn ở rìa phải btree; UUID v4 ngẫu nhiên rơi khắp cây gây tách trang rải rác. UUIDv7 đặt thời gian ở đầu để lấy lại tính tuần tự.
Đo thật: UUID chèn chậm 2,7 lần
Chèn 2 triệu dòng vào hai bảng, một dùng bigserial, một dùng gen_random_uuid():
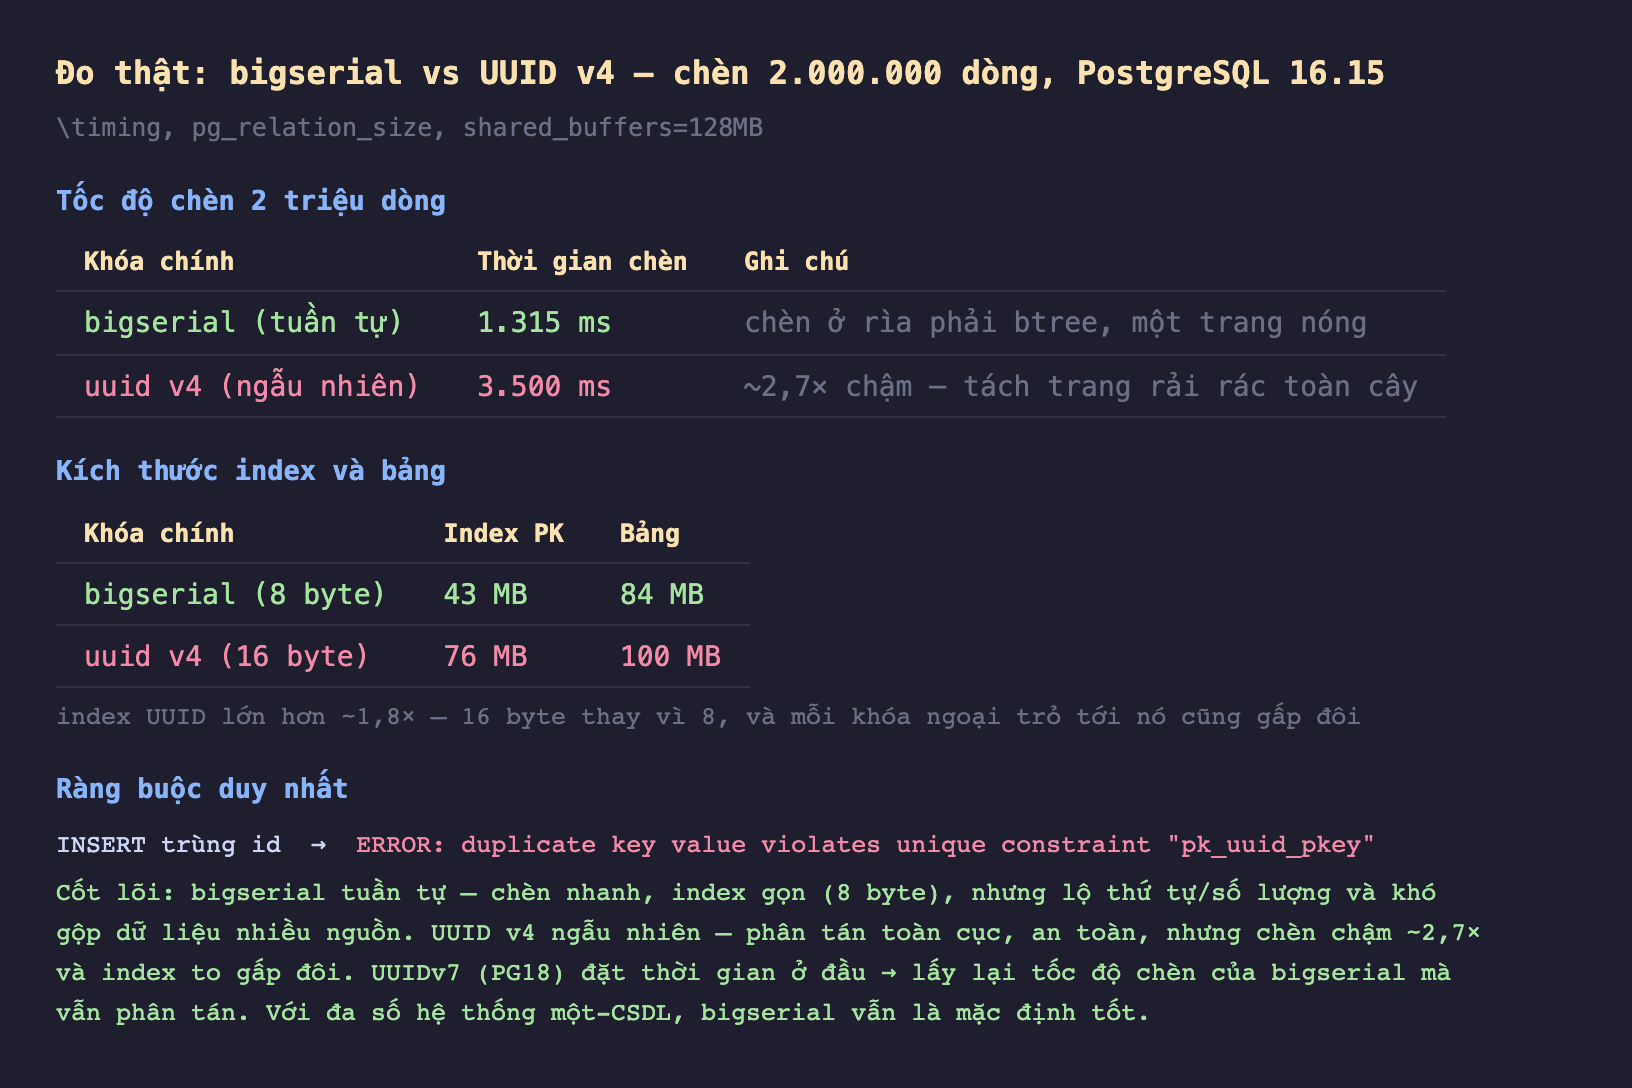
Hình 2: Chèn 2 triệu dòng: bigserial 1.315 ms so với UUID v4 3.500 ms (~2,7× chậm). Index PK bigserial 43 MB so với UUID 76 MB (~1,8× lớn hơn); bảng 84 MB so với 100 MB. Chèn trùng id báo lỗi duplicate key value violates unique constraint.
- Tốc độ chèn: bigserial 1.315 ms so với UUID v4 3.500 ms — chậm hơn ~2,7 lần.
- Index PK: bigserial 43 MB so với UUID 76 MB — lớn hơn ~1,8 lần (16 byte so với 8).
- Bảng: 84 MB so với 100 MB.
Vì sao UUID ngẫu nhiên chậm? Với bigserial, mỗi khóa mới luôn lớn nhất, nên nó chèn vào rìa phải của cây btree — một trang "nóng" duy nhất, lấp tuần tự, ít tách trang, ít WAL. Với UUID v4, khóa mới rơi ngẫu nhiên khắp cây: mỗi lần chèn có thể phải nạp một trang index khác vào bộ nhớ, gây tách trang rải rác, làm bẩn nhiều trang, sinh nhiều WAL. Trên bảng lớn hơn bộ nhớ, khoảng cách này còn giãn ra nữa.
UUIDv7: thời gian ở đầu, tuần tự trở lại
Vấn đề của UUID không phải là "UUID" mà là "ngẫu nhiên". UUIDv7 giải quyết đúng điều đó: nó đặt mốc thời gian mili giây ở 48 bit đầu, phần còn lại mới ngẫu nhiên.
v4:  9446429a-7d3e-...   (48 bit đầu ngẫu nhiên → rơi khắp btree)
v7:  0192a3f1-b2c0-7...   (48 bit đầu = thời gian → tăng dần)
Kết quả: khóa v7 tăng dần theo thời gian, nên chèn ở rìa phải btree giống bigserial — lấy lại tốc độ chèn — mà vẫn giữ tính phân tán toàn cục và không lộ số lượng. PostgreSQL 18 có gen_uuidv7() sẵn; các phiên bản trước cần hàm tự viết hoặc sinh ở tầng ứng dụng. Nếu bạn cần UUID, hãy dùng v7 chứ đừng dùng v4 cho khóa chính.
Đánh đổi cần cân nhắc
bigserial là mặc định tốt cho hệ thống một-CSDL. Nếu ứng dụng của bạn chạy trên một PostgreSQL (hoặc một cụm với một nguồn ghi), bigserial thắng rõ: chèn nhanh, index gọn, khóa ngoại nhỏ (mỗi khóa ngoại trỏ tới PK cũng chỉ 8 byte thay vì 16). Đừng chọn UUID chỉ vì "nghe hiện đại".
UUID đáng giá khi cần sinh khóa phân tán. Khi khóa phải sinh được ở nhiều nơi mà không phối hợp (nhiều dịch vụ, sinh ở client, gộp dữ liệu từ nhiều nguồn, đồng bộ offline), UUID giải quyết bài toán mà bigserial không làm được — hai máy không thể cùng cấp một số tuần tự an toàn. Ở đây UUID (v7) là đúng, và cái giá chèn chấp nhận được.
bigserial lộ thông tin qua khóa. Số tuần tự để lộ số lượng bản ghi (đơn hàng #1050 cho biết bạn có ~1050 đơn) và thứ tự tạo. Với dữ liệu nhạy cảm về mặt cạnh tranh hoặc riêng tư, tính không đoán được của UUID là một ưu điểm bảo mật thật. Cân nhắc theo ngữ cảnh — đôi khi che giấu quy mô quan trọng hơn vài mili giây chèn.
Ba ý mang về
- UUID v4 ngẫu nhiên làm chèn chậm và index phình: đo thật, chèn 2 triệu dòng mất 3.500 ms với UUID so với 1.315 ms của bigserial (~2,7×), và index PK 76 MB so với 43 MB (~1,8×) — vì khóa ngẫu nhiên rơi khắp cây btree gây tách trang rải rác.
- bigserial nhanh và gọn nhưng lộ thứ tự/số lượng: khóa tuần tự chèn ở rìa phải btree (một trang nóng, ít WAL) và chỉ 8 byte, nhưng để lộ quy mô dữ liệu và không sinh được phân tán ở nhiều nguồn.
- UUIDv7 lấy lại tốc độ chèn mà vẫn phân tán: đặt thời gian ở 48 bit đầu để khóa tăng dần theo thời gian (chèn rìa phải như bigserial), giữ tính toàn cục — nếu cần UUID cho khóa chính, dùng v7 (PostgreSQL 18 có
gen_uuidv7()) chứ đừng dùng v4.
Phần sau ta xét một câu hỏi index thường bị bỏ sót và gây chậm âm thầm: Phần sau đo khóa ngoại có cần index không — vì sao PostgreSQL không tự tạo index cho cột khóa ngoại, và cái giá thật khi xóa dòng cha hoặc JOIN.
