"JOIN đắt, nên sao chép dữ liệu vào một bảng cho khỏi JOIN" — đây là lý do phổ biến nhất khiến người ta phi chuẩn hóa, và trong PostgreSQL nó thường sai. Chuẩn hóa (tách dữ liệu để mỗi sự thật chỉ nằm một chỗ) bị mang tiếng chậm vì đòi JOIN, còn phi chuẩn hóa (sao chép dữ liệu để đọc nhanh) được ca ngợi. Nhưng khi đo thật, bức tranh đảo ngược: JOIN tới bảng nhỏ có index gần như miễn phí, còn cái giá của phi chuẩn hóa — cập nhật đắt và dữ liệu lệch — mới là thật. Bài này đo cả hai.
Hai cách thiết kế
Đơn hàng cần hiển thị tên và thành phố của khách. Hai cách:
-- chuẩn hóa: mỗi sự thật một chỗ, đơn tham chiếu khách qua id
CREATE TABLE n_khach (id, ten, thanh_pho);
CREATE TABLE n_don   (id, khach_id REFERENCES n_khach, tien);

-- phi chuẩn hóa: SAO CHÉP ten + thanh_pho vào MỖI đơn
CREATE TABLE d_don (id, khach_id, khach_ten, khach_thanh_pho, tien);
Cách chuẩn hóa lưu tên khách một lần trong n_khach; muốn hiển thị kèm đơn thì JOIN. Cách phi chuẩn hóa lặp tên khách ở mỗi đơn — khách có 50 đơn thì tên lưu 50 lần, nhưng đọc không cần JOIN.
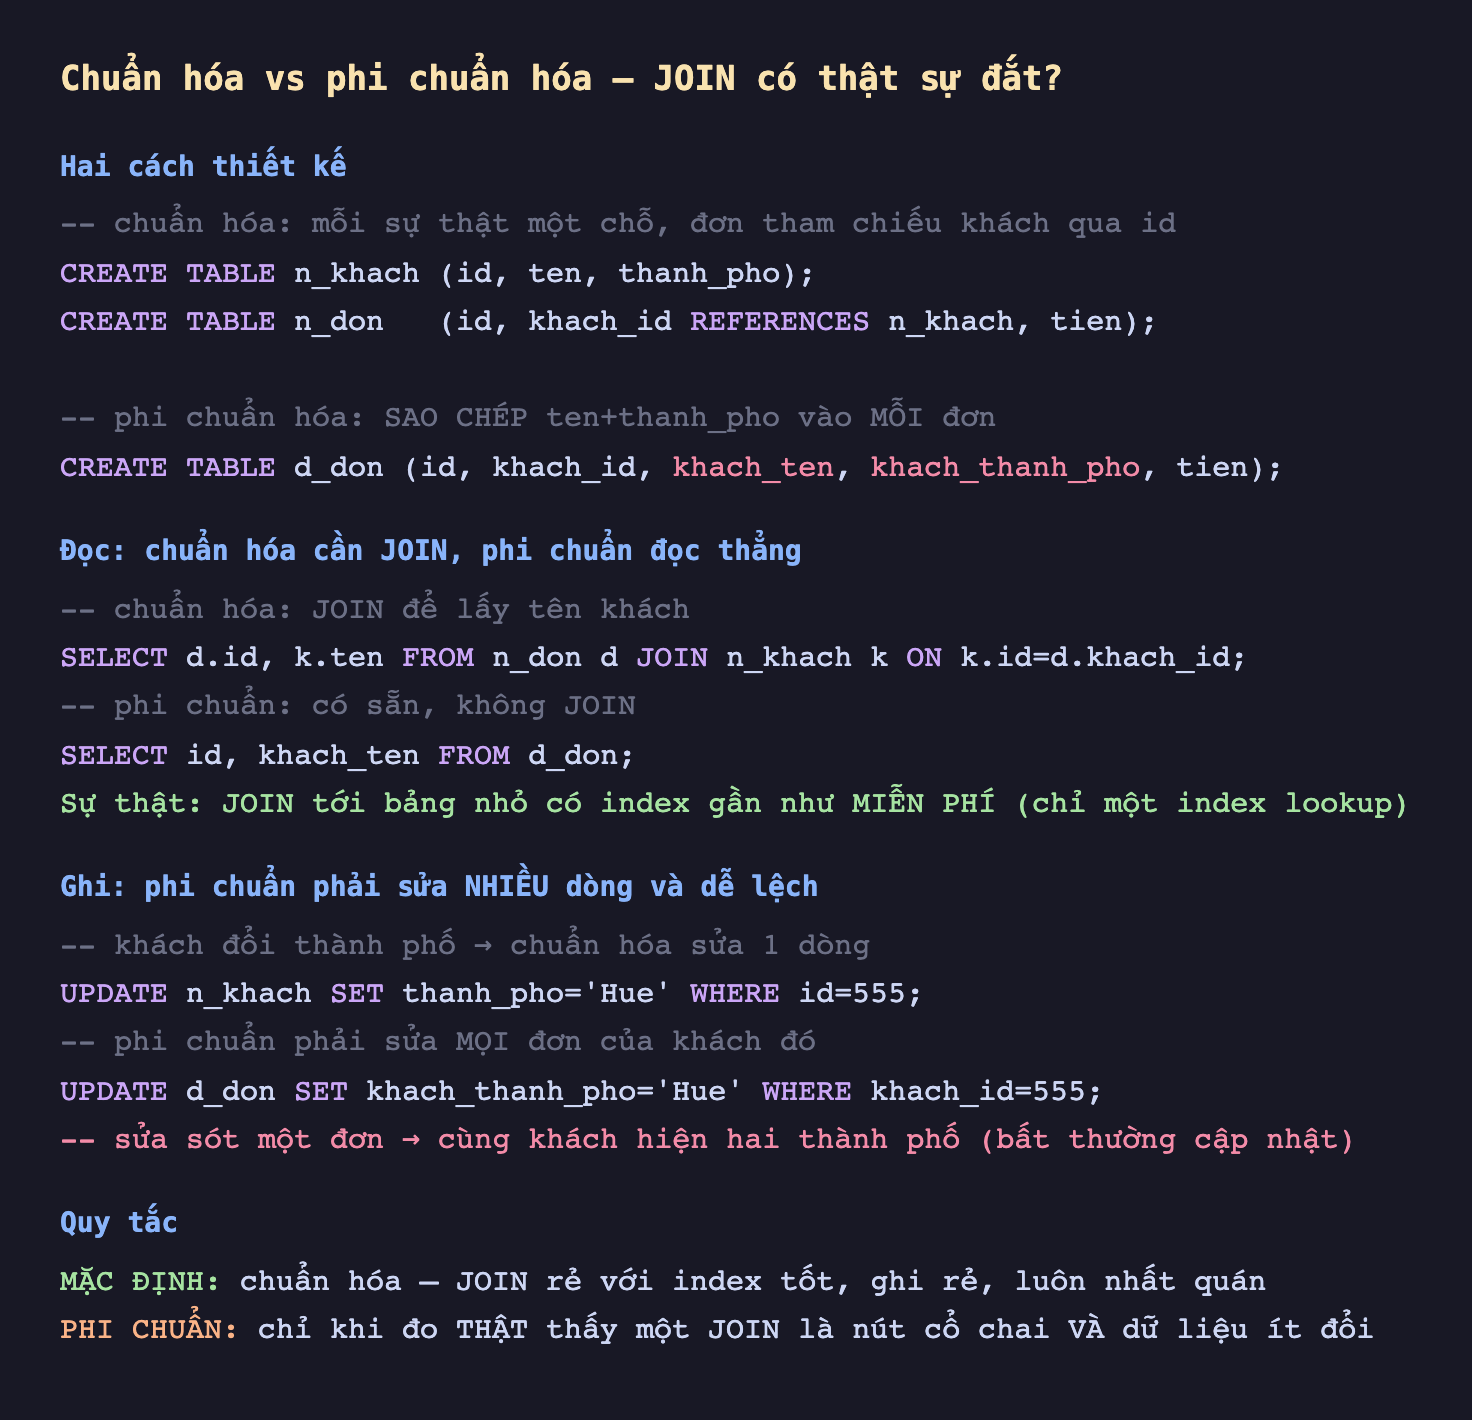
Hình 1: Chuẩn hóa tách tên khách ra bảng riêng và JOIN khi cần; phi chuẩn hóa sao chép tên vào mỗi đơn. JOIN tới bảng nhỏ có index gần như miễn phí; ghi phi chuẩn phải sửa nhiều dòng và dễ lệch.
Đo thật: JOIN gần như miễn phí
Trên khach 100.000 dòng và don 5 triệu dòng, đọc đơn của một khách kèm tên (có index khach_id):
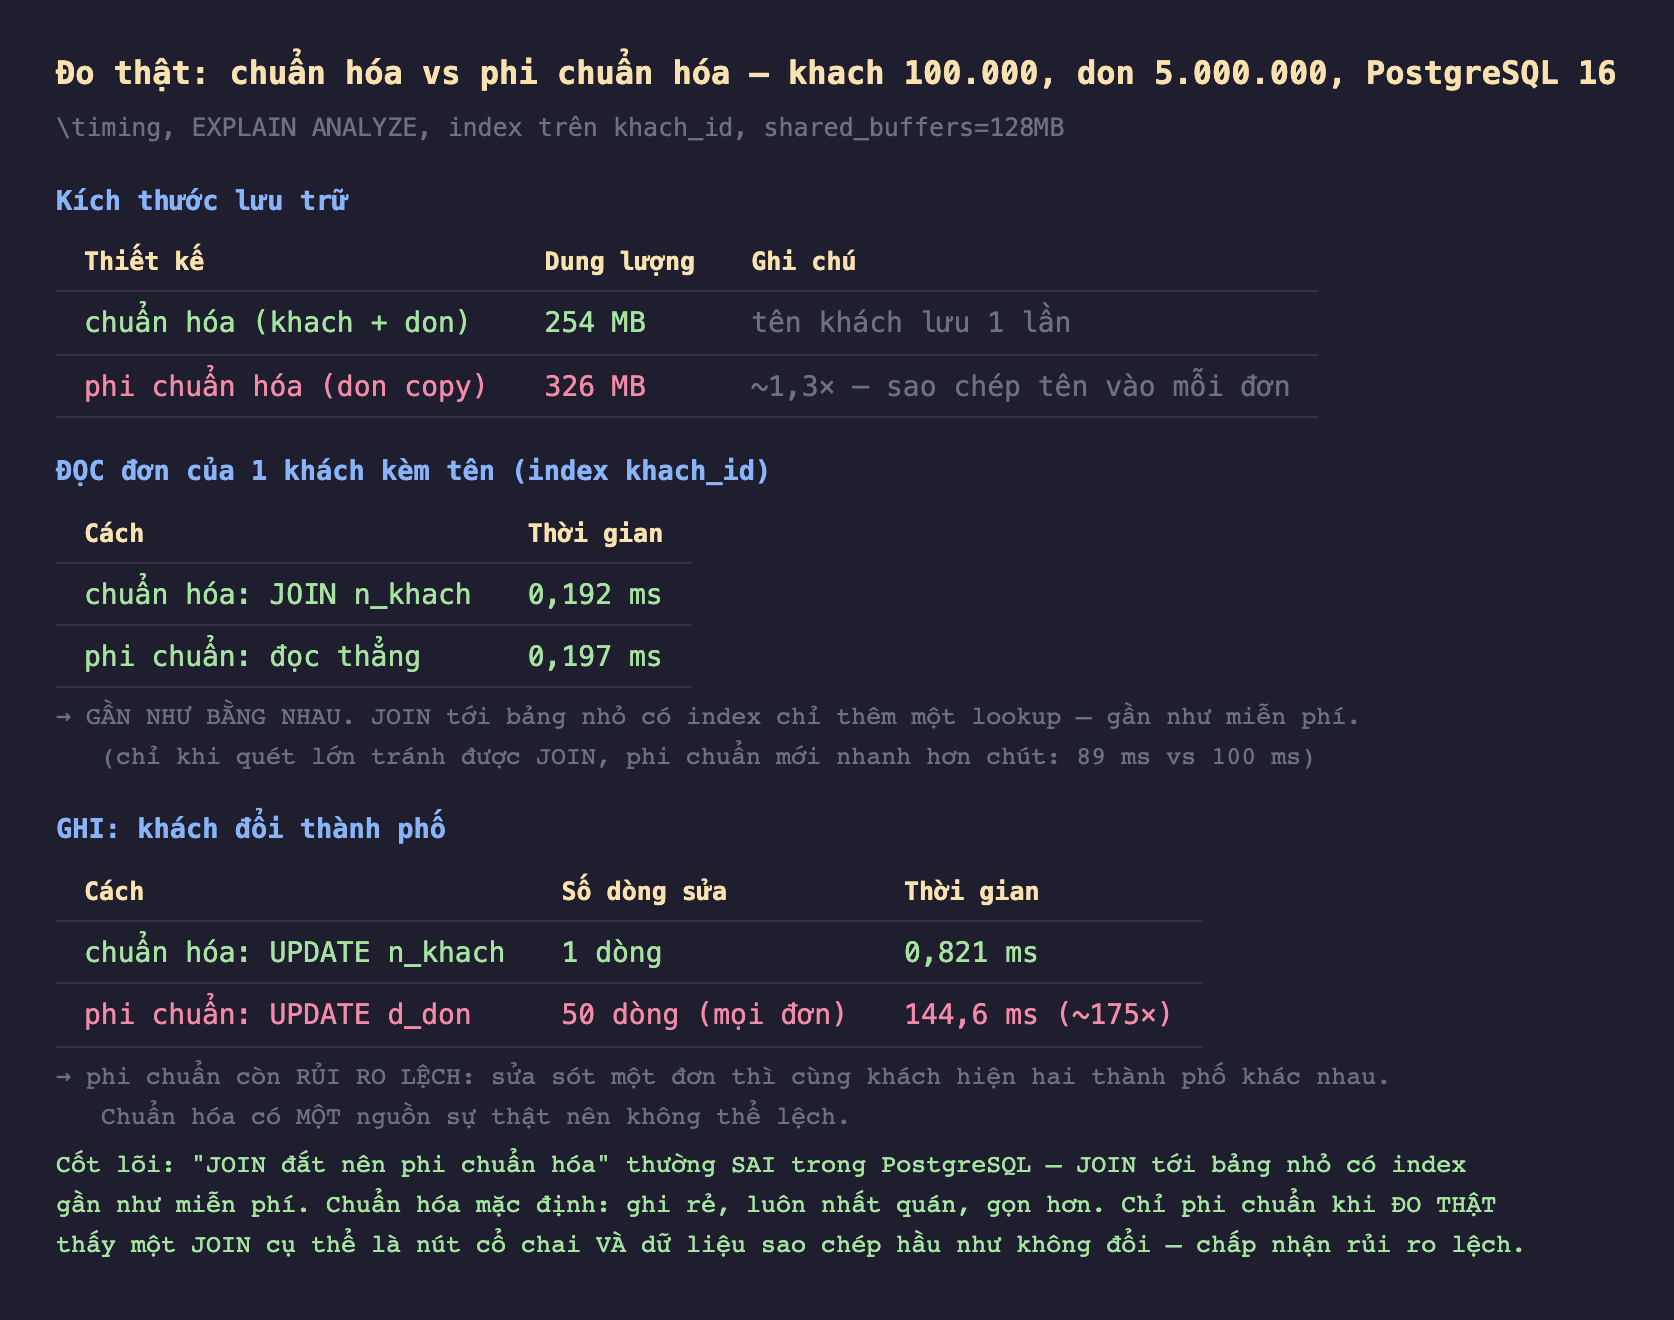
Hình 2: Đọc đơn của một khách kèm tên: chuẩn hóa JOIN 0,192 ms so với phi chuẩn đọc thẳng 0,197 ms — gần như bằng nhau. Cập nhật thành phố khách: chuẩn hóa 1 dòng 0,821 ms so với phi chuẩn 50 dòng 144,6 ms (~175×). Chuẩn hóa gọn hơn (254 MB so với 326 MB).
- Đọc theo khách (có index): chuẩn hóa JOIN 0,192 ms, phi chuẩn đọc thẳng 0,197 ms — gần như bằng nhau. JOIN tới bảng
khachnhỏ có index chỉ thêm một index lookup cho mỗi đơn — chi phí gần như bằng không. Đây là điểm mấu chốt bị hiểu sai: trong PostgreSQL, JOIN tới bảng nhỏ được index tốt không phải là kẻ thù. - Đọc quét lớn (lọc
tien>995trên cả bảng): phi chuẩn nhanh hơn chút (89 ms so với 100 ms), vì tránh được bước JOIN khi cả hai đều phải quét bảng lớn. Nhưng khác biệt nhỏ, không kịch tính.
Cái giá thật của phi chuẩn hóa: ghi và nhất quán
Đây mới là nơi phi chuẩn hóa trả giá. Khi một khách đổi thành phố:
- Chuẩn hóa:
UPDATE n_khach SET thanh_pho='Hue' WHERE id=555— sửa 1 dòng, 0,821 ms. - Phi chuẩn hóa: phải
UPDATE d_don ... WHERE khach_id=555— sửa 50 dòng (mọi đơn của khách đó), 144,6 ms — chậm hơn ~175 lần.
Và tệ hơn tốc độ là rủi ro lệch dữ liệu: nếu lệnh cập nhật sót một đơn (lỗi, race condition, quên), cùng một khách sẽ hiện hai thành phố khác nhau ở các đơn khác nhau — "bất thường cập nhật" (update anomaly) kinh điển. Chuẩn hóa có một nguồn sự thật duy nhất nên không thể lệch: thành phố của khách chỉ nằm một chỗ.
Đánh đổi cần cân nhắc
Chuẩn hóa là mặc định đúng. Nó ghi rẻ (sửa một chỗ), luôn nhất quán (không lệch được), và gọn hơn (không lặp dữ liệu — 254 MB so với 326 MB). Với index tốt, JOIN gần như miễn phí. Đừng phi chuẩn hóa theo phản xạ "sợ JOIN" — hãy đo trước.
Phi chuẩn hóa có lý khi đo thật chứng minh. Nếu profiling cho thấy một JOIN cụ thể là nút cổ chai thật (ví dụ bảng lớn JOIN bảng lớn, hoặc chuỗi nhiều JOIN trên đường dẫn nóng), và dữ liệu sao chép hầu như không đổi (danh mục tĩnh, snapshot lịch sử), thì phi chuẩn hóa là hợp lý — chấp nhận cái giá ghi và rủi ro lệch để đổi lấy đọc nhanh. Đây là tối ưu có chủ đích sau khi đo, không phải mặc định.
Có lựa chọn trung gian. Materialized view (làm mới định kỳ) cho bạn dữ liệu "phi chuẩn hóa đọc nhanh" mà vẫn dựng từ nguồn chuẩn hóa — tránh lệch tay. Cột sinh tự động (GENERATED) hoặc trigger giữ đồng bộ cũng là cách phi chuẩn hóa an toàn hơn sao chép thủ công. Snapshot lịch sử (như lưu tên khách tại thời điểm đặt đơn) thực ra là dữ liệu khác nghĩa, không phải phi chuẩn hóa — và ở đó sao chép là đúng.
Ba ý mang về
- "JOIN đắt nên phi chuẩn hóa" thường sai trong PostgreSQL: đo thật, đọc đơn của một khách kèm tên chạy 0,192 ms với JOIN so với 0,197 ms không JOIN — JOIN tới bảng nhỏ có index chỉ thêm một lookup, gần như miễn phí.
- Phi chuẩn hóa trả giá đắt khi ghi và dễ lệch dữ liệu: đo thật, cập nhật thành phố một khách sửa 1 dòng (0,821 ms) khi chuẩn hóa so với 50 dòng (144,6 ms, ~175×) khi phi chuẩn — và sửa sót một dòng làm cùng khách hiện hai thành phố, điều chuẩn hóa không thể mắc.
- Chuẩn hóa mặc định, phi chuẩn hóa chỉ sau khi đo: chuẩn hóa ghi rẻ, luôn nhất quán, gọn hơn; chỉ phi chuẩn khi profiling chứng minh một JOIN cụ thể là nút cổ chai và dữ liệu sao chép hầu như không đổi — hoặc dùng materialized view/trigger để phi chuẩn an toàn hơn.
Phần sau ta đi vào cách PostgreSQL xử lý giá trị lớn dưới lớp vỏ: Phần sau mổ xẻ TOAST — cơ chế lưu giá trị lớn (text dài, jsonb, bytea) ra ngoài trang chính, nén tự động, và ảnh hưởng của nó tới hiệu năng đọc.
