SELECT DISTINCT và GROUP BY — hai cách khử trùng lặp mà nhiều người tranh cãi cái nào nhanh hơn. Câu trả lời cho phần "nhanh hơn" rất đơn giản (chúng giống hệt nhau). Nhưng câu chuyện thật sự đáng nói là một anti-pattern: SELECT DISTINCT thường được dán lên như miếng băng để che dòng trùng do một JOIN sai — và đo thật cho thấy nó biến truy vấn thành 26 giây. Bài này đo cả hai và một biến thể PostgreSQL rất tiện: DISTINCT ON.
DISTINCT và GROUP BY: giống hệt nhau
Khử trùng lặp user_id từ bảng log 3 triệu dòng, hai cách viết:
SELECT DISTINCT user_id FROM log;
SELECT user_id FROM log GROUP BY user_id;
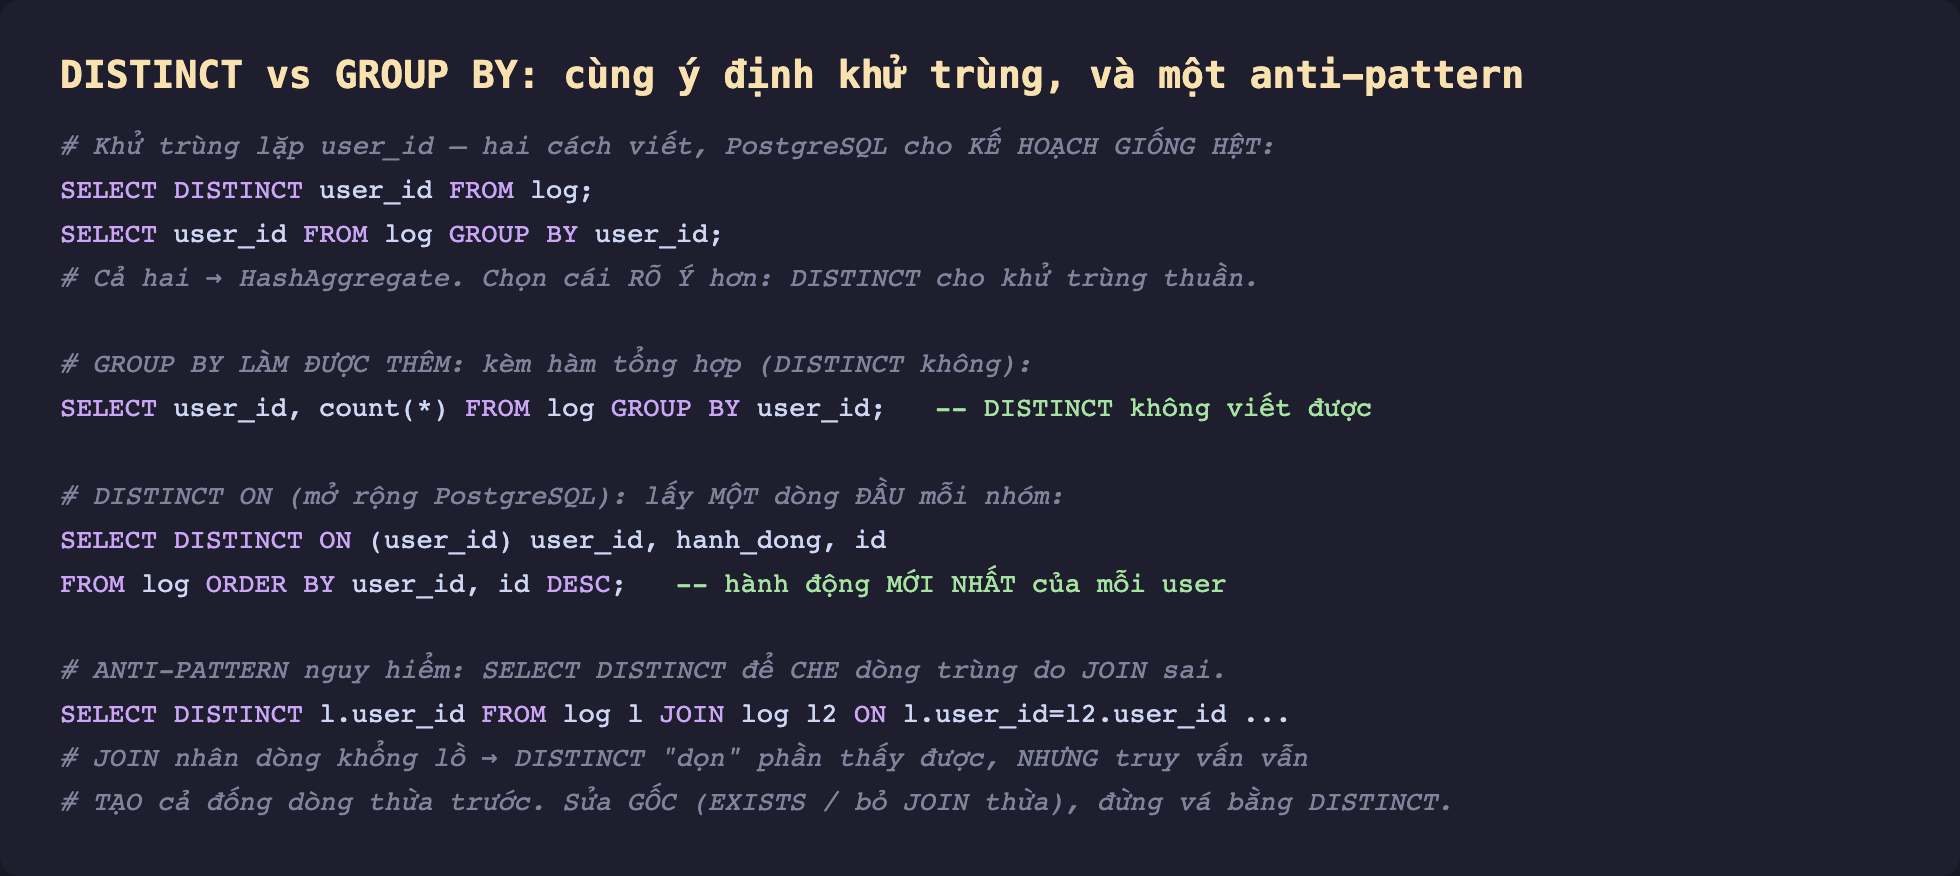
Hình 1: DISTINCT và GROUP BY tương đương cho khử trùng; GROUP BY thêm được hàm tổng hợp; DISTINCT ON lấy một dòng đầu mỗi nhóm; và anti-pattern DISTINCT che JOIN sai.
Đo thật:
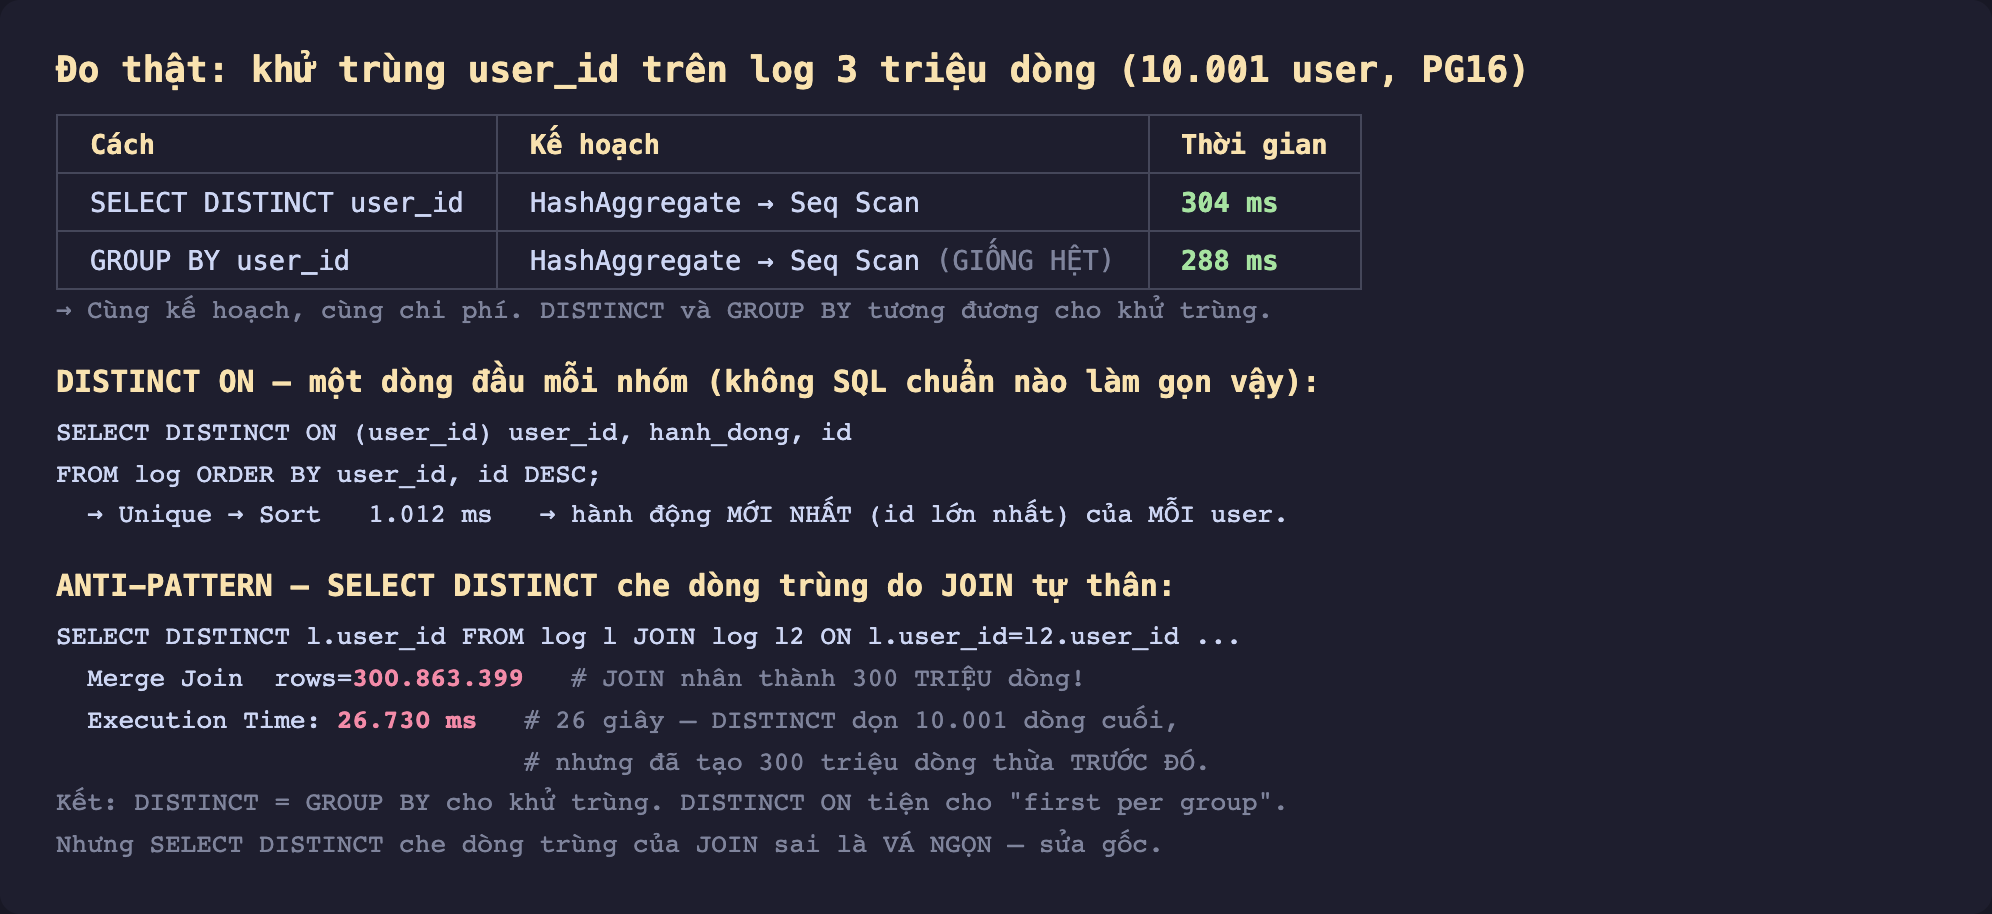
Hình 2: SELECT DISTINCT (304 ms) và GROUP BY (288 ms) cho kế hoạch giống hệt (HashAggregate → Seq Scan). DISTINCT ON: 1.012 ms cho một dòng đầu mỗi user. Anti-pattern: DISTINCT che JOIN nhân 300 triệu dòng → 26.730 ms.
SELECT DISTINCT user_id và GROUP BY user_id cho cùng một kế hoạch — HashAggregate → Seq Scan, cùng chi phí, cùng thời gian (~300 ms). Chúng hoàn toàn tương đương cho việc khử trùng một cột. Chọn cái nào rõ ý hơn: DISTINCT cho khử trùng thuần túy, GROUP BY khi bạn còn cần hàm tổng hợp (count, sum) — điều DISTINCT không làm được.
DISTINCT ON: một dòng đầu mỗi nhóm
PostgreSQL có một mở rộng không thuộc SQL chuẩn: DISTINCT ON. Nó lấy một dòng đầu tiên cho mỗi nhóm theo ORDER BY:
SELECT DISTINCT ON (user_id) user_id, hanh_dong, id
FROM log ORDER BY user_id, id DESC;   -- hành động MỚI NHẤT của mỗi user
ORDER BY user_id, id DESC khiến mỗi nhóm user_id lấy dòng có id lớn nhất — tức bản ghi mới nhất. Đây là cách cực gọn để trả lời "bản ghi gần nhất của mỗi X" mà SQL chuẩn phải dùng window function hoặc subquery tương quan. Đo thật: 1.012 ms (Unique → Sort). Cột trong DISTINCT ON phải khớp phần đầu của ORDER BY.
Anti-pattern: DISTINCT che dòng trùng do JOIN
Đây là phần quan trọng nhất. SELECT DISTINCT thường xuất hiện không phải để khử trùng có chủ đích, mà để che dòng trùng mà một JOIN sai vô tình tạo ra. Đo thật một self-join:
SELECT DISTINCT l.user_id FROM log l JOIN log l2 ON l.user_id=l2.user_id WHERE l.hanh_dong='mua';
Kế hoạch cho thấy Merge Join rows=300.863.399 — JOIN này nhân dòng thành 300 triệu (vì mỗi user_id ở bảng trái khớp mọi dòng cùng user_id ở bảng phải). DISTINCT cuối cùng dọn về 10.001 dòng, nhưng truy vấn đã tạo 300 triệu dòng thừa trước đó — mất 26.730 ms (26 giây!) cho một kết quả lẽ ra tức thì.
Đây là dấu hiệu kinh điển: nếu bạn thấy mình cần SELECT DISTINCT để làm sạch kết quả, hãy hỏi vì sao có dòng trùng ngay từ đầu. Thường là một JOIN không cần thiết hoặc một JOIN một-nhiều mà bạn chỉ cần kiểm tồn tại. Cách sửa gốc: dùng EXISTS (semi join, dừng ở khớp đầu tiên — bài trước đã đo), hoặc bỏ JOIN thừa. DISTINCT chỉ vá phần thấy được, không sửa phần tốn kém.
Đánh đổi cần cân nhắc
DISTINCT không xấu — lạm dụng nó mới xấu. Khử trùng có chủ đích bằng DISTINCT là hoàn toàn hợp lệ và rõ ý. Vấn đề chỉ nảy sinh khi nó che giấu một truy vấn tạo dòng trùng không đáng có.
GROUP BY khi cần tổng hợp; DISTINCT khi chỉ khử trùng. Ranh giới rõ ràng: SELECT user_id, count(*) ... GROUP BY user_id cần GROUP BY. SELECT DISTINCT user_id gọn hơn khi chỉ muốn danh sách giá trị phân biệt. Đừng viết GROUP BY khi không có hàm tổng hợp — dùng DISTINCT cho rõ ý.
Index có thể giúp cả hai. Nếu cột khử trùng có index và số giá trị phân biệt ít, PostgreSQL có thể dùng Index Only Scan + Unique thay vì HashAggregate quét cả bảng — nhanh hơn nữa. Kiểm bằng EXPLAIN.
Ba ý mang về
- DISTINCT và GROUP BY cho kế hoạch giống hệt khi khử trùng một cột (đo thật, cùng HashAggregate, 304 và 288 ms) — chọn cái rõ ý hơn: DISTINCT cho khử trùng thuần, GROUP BY khi cần hàm tổng hợp.
DISTINCT ONlà mở rộng PostgreSQL tiện lợi cho "một dòng đầu mỗi nhóm" (bản ghi mới nhất của mỗi user) mà SQL chuẩn phải dùng window/subquery — cột phải khớp đầuORDER BY.- Cảnh giác
SELECT DISTINCTche dòng trùng do JOIN sai: đo thật, một self-join nhân 300 triệu dòng rồi DISTINCT dọn về 10.001 mất 26 giây — sửa gốc bằngEXISTShoặc bỏ JOIN thừa, đừng vá bằng DISTINCT.
Phần sau ta so hai cách hợp kết quả thường bị nhầm: Phần sau đo UNION vs UNION ALL — vì sao UNION âm thầm thêm bước khử trùng tốn kém, và khi nào UNION ALL là lựa chọn đúng.
