UNION và UNION ALL khác nhau đúng một chữ, và nhiều người dùng UNION theo phản xạ vì nó gõ ngắn hơn ý niệm "gộp hai kết quả". Nhưng hai câu này không tương đương: UNION phải khử trùng toàn bộ kết quả gộp — một bước ẩn có thể là Sort tràn đĩa. Bài này đo thật cái giá đó, và chỉ ra trường hợp tồi tệ nhất: khi hai tập vốn đã không trùng nhau, UNION vẫn trả tiền cho việc khử trùng mà chẳng loại được dòng nào.
Khác biệt cốt lõi: một bước dedup ẩn
Định nghĩa chính xác: UNION = UNION ALL + DISTINCT trên toàn bộ kết quả gộp.
-- UNION ALL: nối thẳng, giữ MỌI dòng (kể cả trùng)
SELECT id FROM don_2023 UNION ALL SELECT id FROM don_2024;

-- UNION: gộp RỒI khử trùng toàn bộ (thêm bước Sort/Unique ẩn)
SELECT id FROM don_2023 UNION     SELECT id FROM don_2024;
UNION ALL chỉ là Append — nối hai luồng dòng lại rồi trả ra, không xử lý gì thêm. UNION phải gom tất cả rồi loại dòng trùng, nghĩa là nó cần sắp xếp hoặc băm cả kết quả để tìm dòng giống nhau. Trên tập lớn, bước đó thường là phần đắt nhất của cả truy vấn.
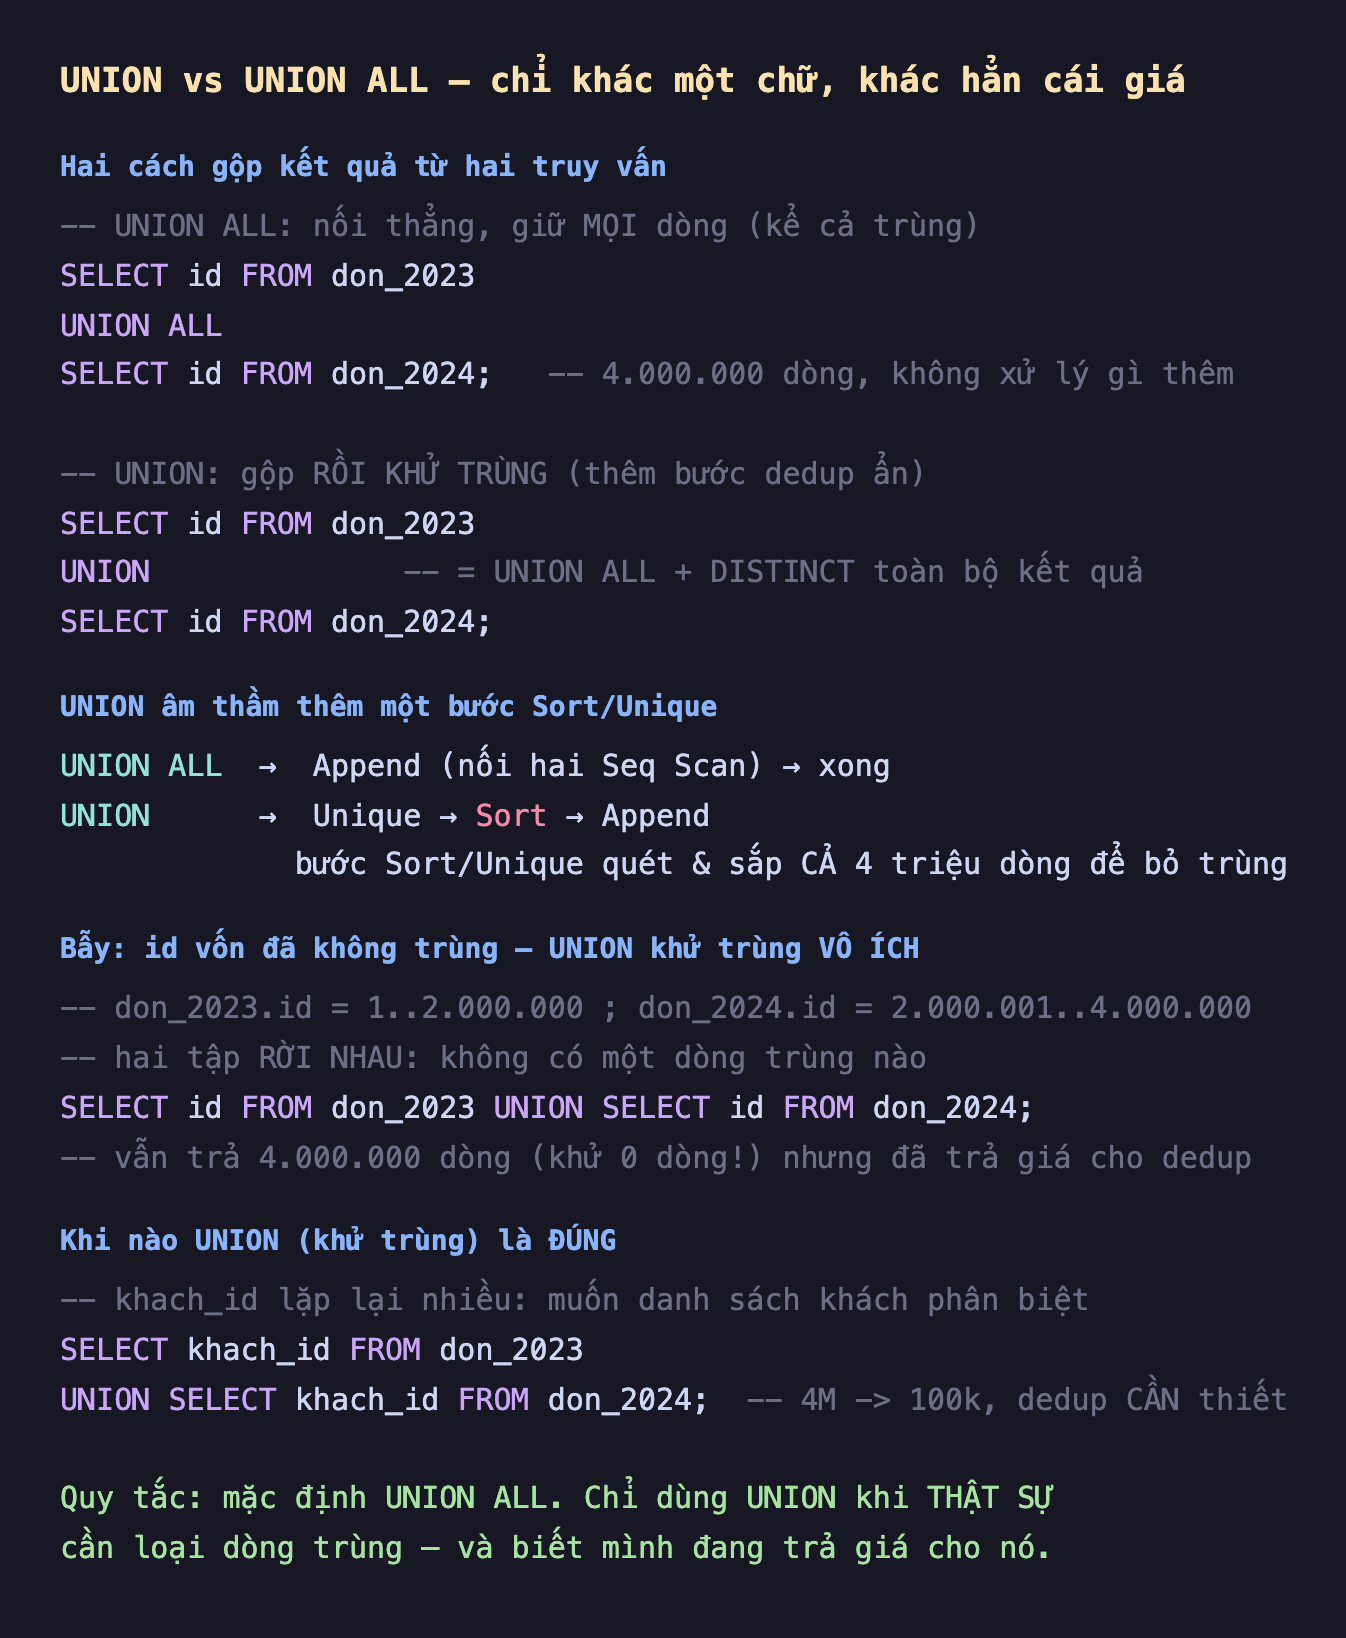
Hình 1: UNION bằng UNION ALL cộng một bước khử trùng toàn bộ. Bước đó là Sort/Unique quét cả kết quả — và trên hai tập rời nhau nó là chi phí thuần túy vô ích.
Đo thật: UNION khử 0 dòng nhưng chậm 2,8 lần
Dựng hai bảng đơn hàng 2 triệu dòng mỗi bảng: don_2023 có id từ 1 đến 2.000.000, don_2024 có id từ 2.000.001 đến 4.000.000. Hai tập id rời nhau hoàn toàn — không có một dòng nào trùng.
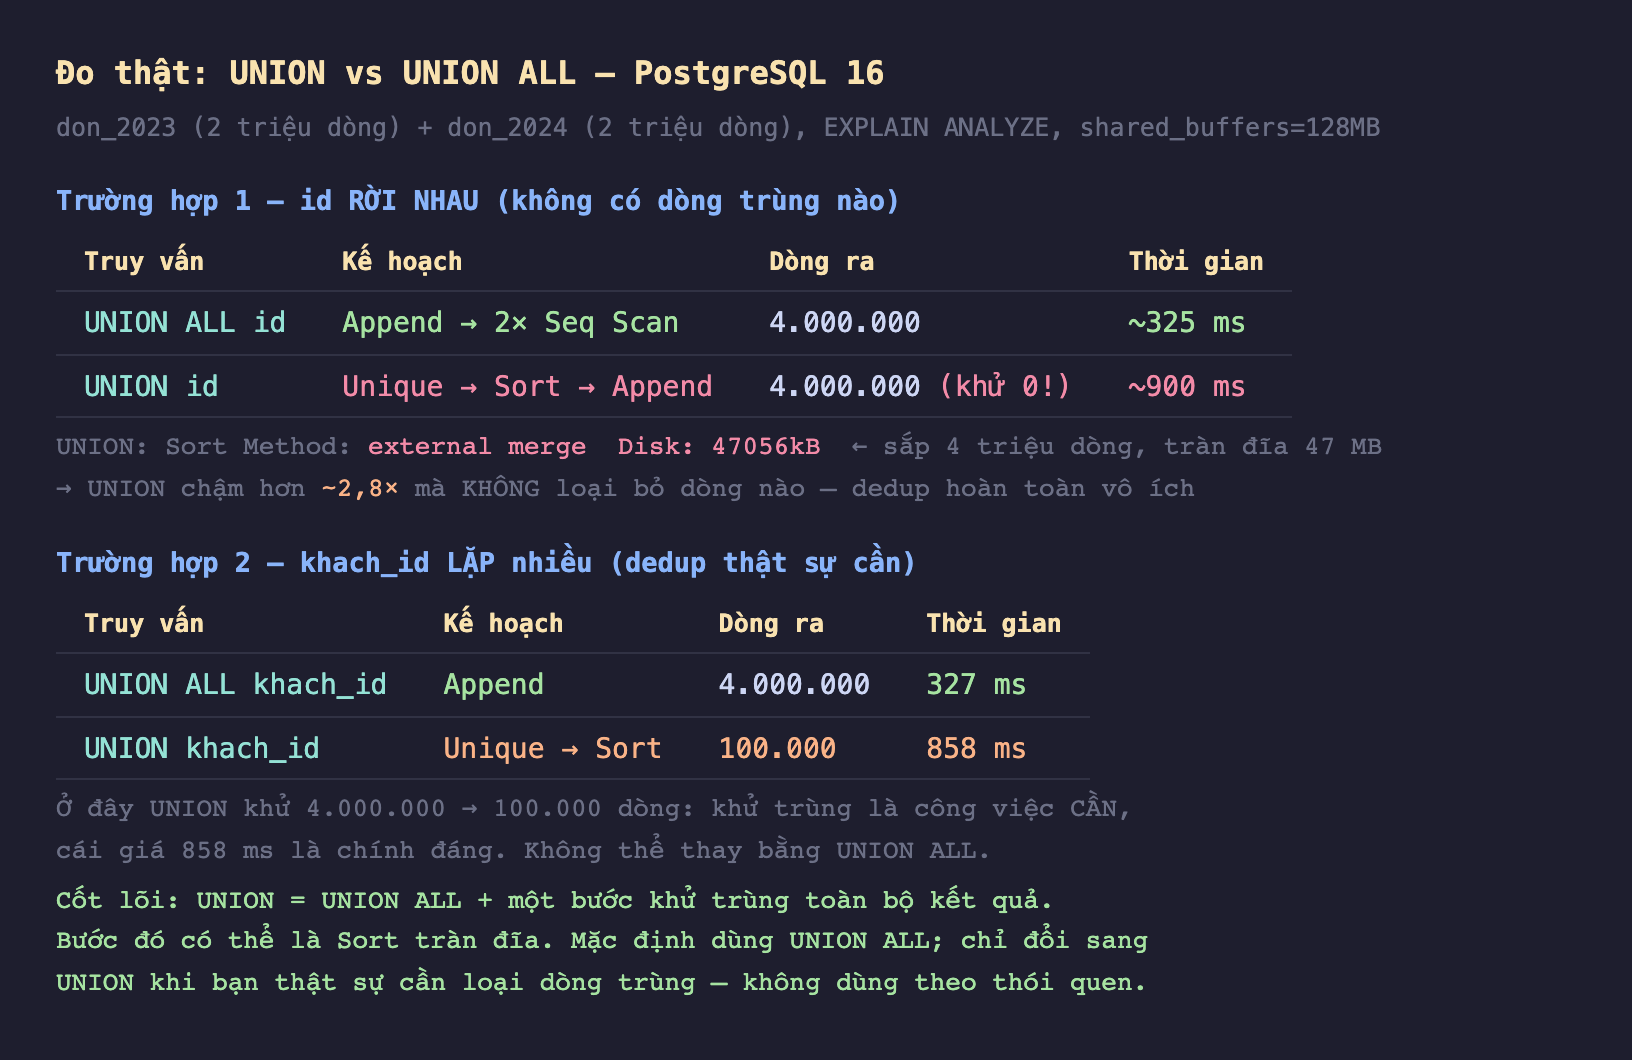
Hình 2: Trên hai tập id rời nhau, UNION ALL chạy ~325 ms (Append), còn UNION chạy ~900 ms (Unique → Sort, tràn đĩa 47 MB) và trả về đúng 4 triệu dòng — khử 0 dòng. Trường hợp khach_id lặp nhiều: UNION khử 4 triệu xuống 100 nghìn, cái giá 858 ms là chính đáng.
Con số nói rõ:
UNION ALL id:Appendtrên haiSeq Scan, 4.000.000 dòng, ~325 ms.UNION id:Unique → Sort → Append, cũng 4.000.000 dòng — khử đúng 0 dòng vì hai tập rời nhau — nhưng mất ~900 ms. Kế hoạch ghi rõSort Method: external merge Disk: 47056kB: PostgreSQL phải sắp cả 4 triệu dòng và tràn 47 MB ra đĩa, chỉ để phát hiện rằng chẳng có dòng nào trùng.
Đây là cái bẫy kinh điển: UNION luôn trả giá cho việc khử trùng, kể cả khi không có gì để khử. Chậm hơn 2,8 lần cho một kết quả y hệt. Nếu bạn biết chắc hai nguồn không giao nhau (ví dụ dữ liệu chia theo năm, theo vùng, theo khoá riêng biệt), dùng UNION là tự phạt mình.
Khi nào UNION là lựa chọn đúng
UNION không xấu — nó giải quyết một bài toán thật: gộp và loại dòng trùng. Đo thật trường hợp cần nó: gộp khach_id từ hai bảng để lấy danh sách khách phân biệt. Mỗi bảng có 2 triệu dòng nhưng chỉ 100.000 khách, nên có rất nhiều trùng lặp.
-- muốn danh sách khách xuất hiện ở một trong hai năm, không lặp
SELECT khach_id FROM don_2023 UNION SELECT khach_id FROM don_2024;
UNION ALL khach_id: 4.000.000 dòng (đầy trùng lặp), 327 ms — nhưng kết quả sai ý định nếu bạn muốn danh sách phân biệt.UNION khach_id: khử về 100.000 dòng, 858 ms. Ở đây bước khử trùng làm đúng việc cần làm; cái giá là chính đáng và không thể tránh bằngUNION ALL.
Ranh giới rõ ràng: nếu kết quả cần loại dòng trùng để đúng, dùng UNION. Nếu bạn biết không có trùng, hoặc trùng lặp là chấp nhận được (hoặc bạn sẽ tự xử lý sau), dùng UNION ALL.
Đánh đổi cần cân nhắc
Mặc định nên là UNION ALL, không phải UNION. Nhiều codebase dùng UNION như phản xạ. Hãy đảo lại: viết UNION ALL trước, chỉ đổi sang UNION khi bạn xác định kết quả thật sự cần khử trùng. Cách này khiến ý định rõ ràng — người đọc thấy UNION thì biết "ở đây có dòng trùng cần loại", không phải "người viết gõ cho nhanh".
Bước dedup của UNION có thể tràn đĩa. Như đo thật, nó dùng Sort (hoặc HashAggregate) trên toàn bộ kết quả gộp. Với tập lớn vượt work_mem, nó tràn ra đĩa (47 MB ở ví dụ trên) và chậm hẳn. Nếu buộc phải dùng UNION trên dữ liệu lớn, cân work_mem như các bài Sort đã bàn để giữ thao tác trong bộ nhớ.
UNION khử trùng trên TẤT CẢ các cột được chọn. Một điểm dễ nhầm: UNION coi hai dòng là trùng khi mọi cột giống nhau, không phải chỉ một cột khoá. SELECT id, ngay FROM a UNION SELECT id, ngay FROM b sẽ giữ hai dòng cùng id nếu ngay khác — có thể không phải ý bạn. Khi cần khử trùng theo một khoá cụ thể, DISTINCT ON hoặc GROUP BY (như bài trước) mới là công cụ đúng, không phải UNION.
Ba ý mang về
UNION=UNION ALL+ một bước khử trùng toàn bộ kết quả — bước ẩn đó là Sort/Unique quét cả kết quả gộp và có thể tràn đĩa;UNION ALLchỉ làAppendnối thẳng, rẻ hơn nhiều.UNIONluôn trả giá cho dedup kể cả khi không có gì để khử: đo thật trên hai tập rời nhau,UNIONsắp 4 triệu dòng (tràn 47 MB) để loại đúng 0 dòng, chậm hơnUNION ALL2,8 lần một cách vô ích.- Mặc định dùng
UNION ALL, chỉ đổi sangUNIONkhi kết quả thật sự cần loại dòng trùng (như gộpkhach_id4 triệu → 100 nghìn, cái giá 858 ms chính đáng) — và nhớUNIONso trùng trên mọi cột, không phải một khoá.
Phần sau ta xét một công cụ gộp mạnh nhưng ít người biết dùng đúng: Phần sau mổ xẻ LATERAL join — vì sao nó cho phép subquery tham chiếu bảng bên trái, và khi nào nó thay được vòng lặp ở tầng ứng dụng.
