Bạn cần hiển thị "mỗi bản ghi bán hàng kèm tổng doanh số của chính nhân viên đó". GROUP BY không làm được — nó gộp các dòng lại, mất từng dòng chi tiết. Bài trước ta thấy subquery tương quan làm được nhưng có thể chậm. Câu trả lời gọn nhất là window function: tính tổng hợp nhưng giữ nguyên mỗi dòng. Bài này mổ xẻ cách chúng hoạt động và ba cách tối ưu — trọng tâm là bước Sort ẩn đằng sau chúng.
Window function làm gì
Điểm khác biệt cốt lõi: GROUP BY gộp nhiều dòng thành một; window function tính tổng hợp qua một "cửa sổ" các dòng mà vẫn trả về từng dòng gốc.
SELECT id, nhanvien_id, doanh_so,
       sum(doanh_so) OVER (PARTITION BY nhanvien_id) AS tong_nv
FROM ban_hang;
Mỗi dòng bán hàng vẫn xuất hiện, kèm thêm cột tong_nv là tổng doanh số của nhân viên đó — tính trong một lượt quét. Không window, bạn phải self-join hoặc subquery tương quan (chạy N lần như bài trước). Window function vừa gọn hơn về mã, vừa thường nhanh hơn.
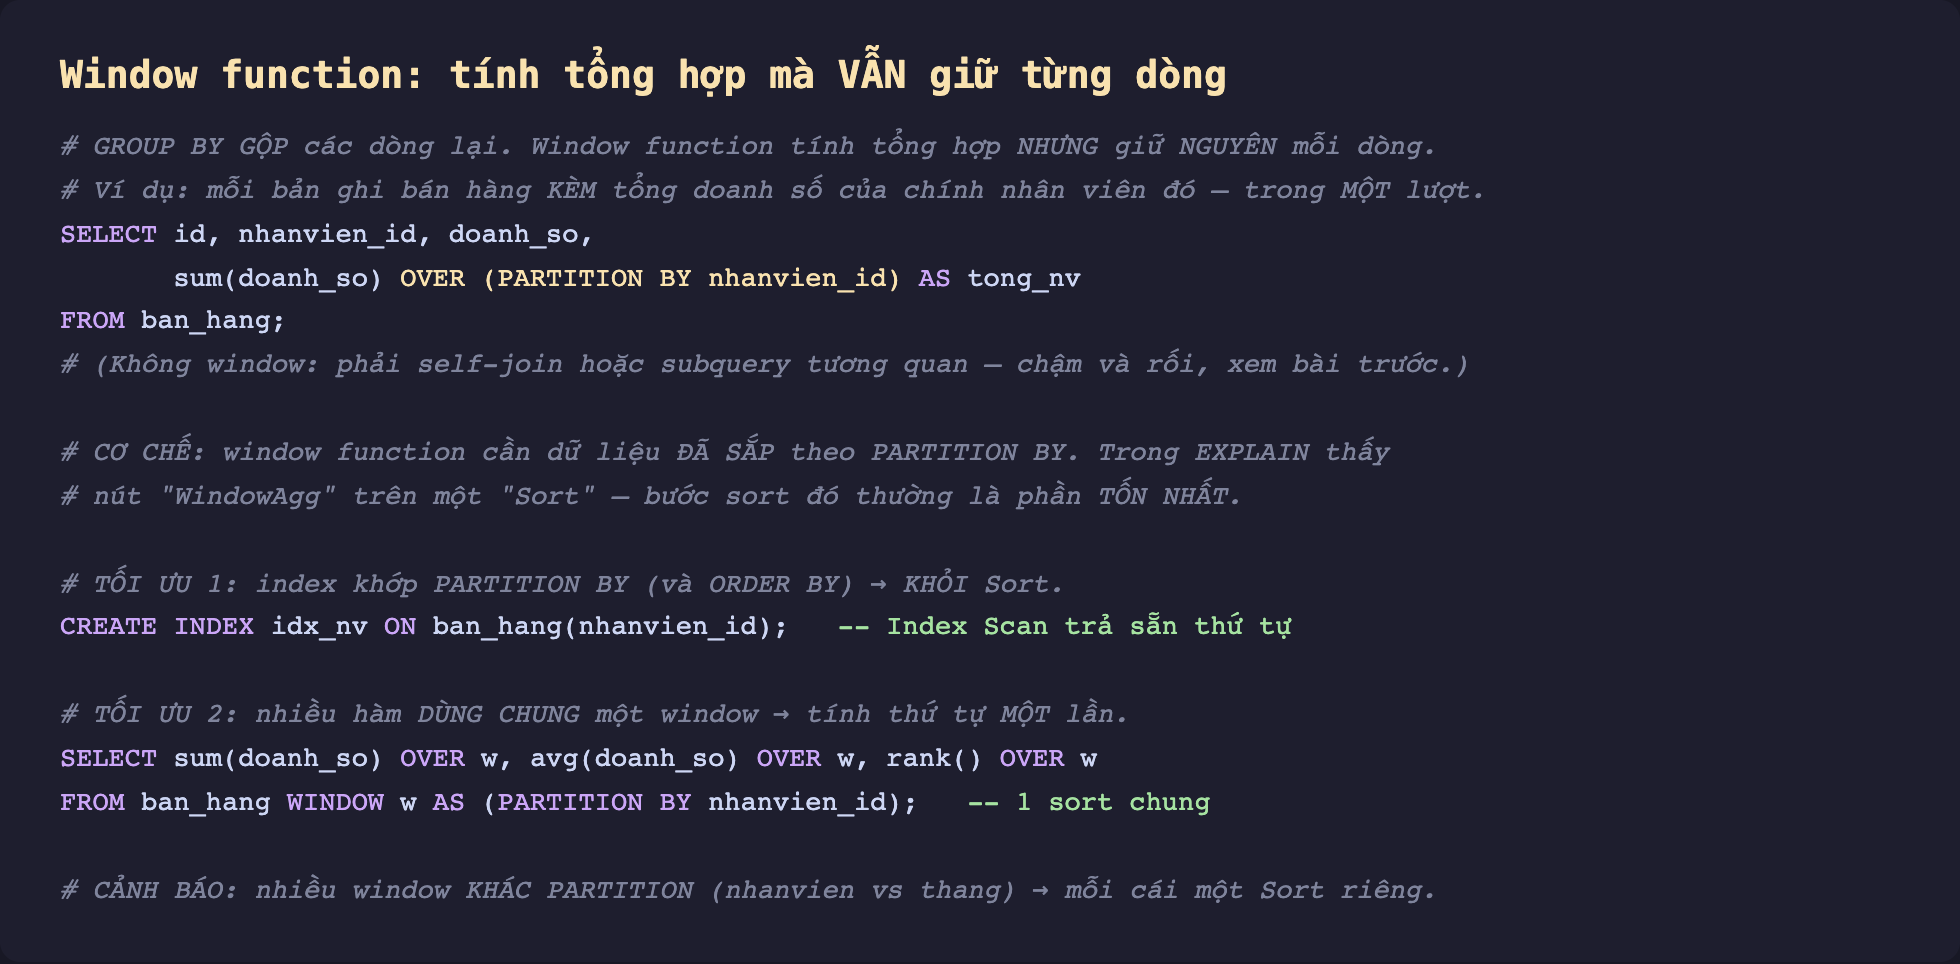
Hình 1: Window function giữ mỗi dòng nhưng thêm cột tổng hợp. Nó cần dữ liệu sắp theo PARTITION BY — bước Sort đó thường tốn nhất. Tối ưu: index khớp và gom các hàm cùng window.
Bước tốn nhất: Sort theo PARTITION BY
Để tính tổng hợp theo từng phân vùng, PostgreSQL cần dữ liệu đã sắp theo PARTITION BY. Trong EXPLAIN, bạn thấy nút WindowAgg nằm trên một Sort — và bước Sort đó thường là phần đắt nhất của truy vấn.
Đo thật trên bảng ban_hang 2 triệu dòng:
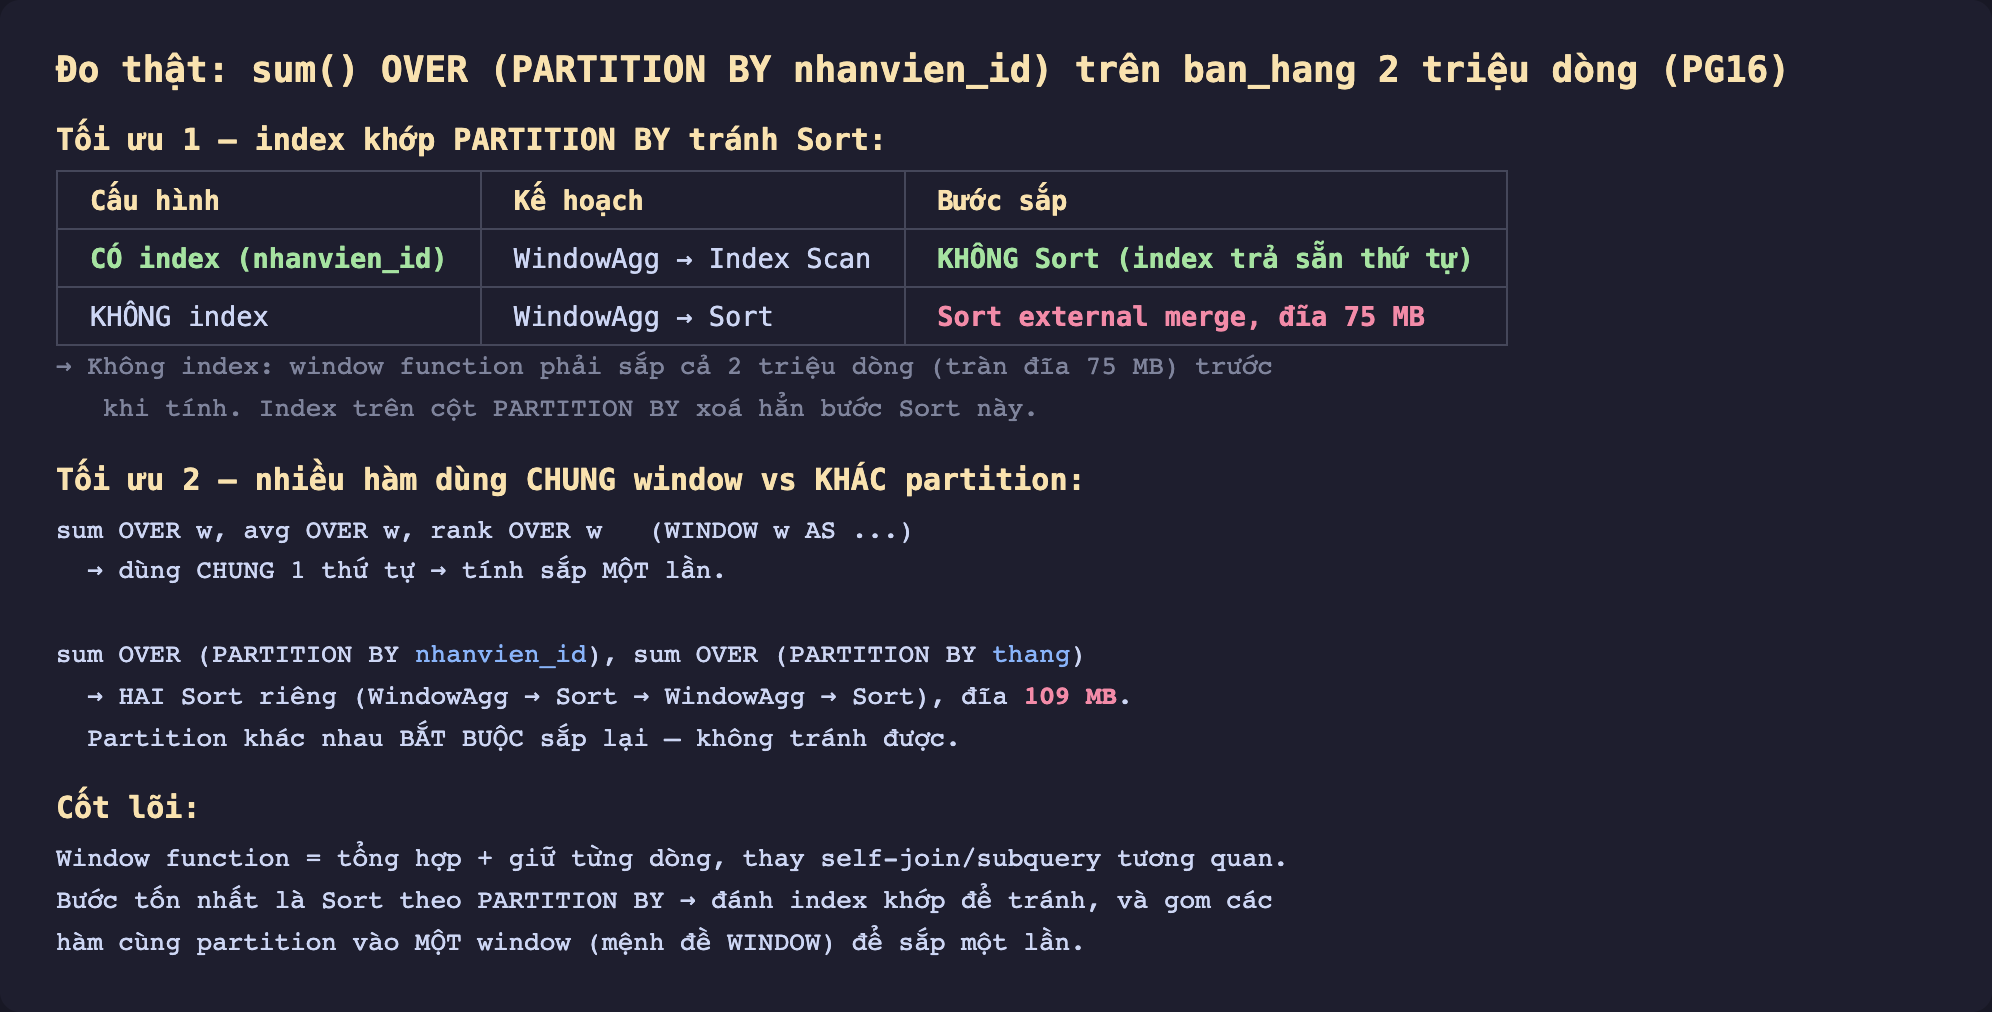
Hình 2: Có index trên nhanvien_id: WindowAgg → Index Scan, không cần Sort (index trả sẵn thứ tự). Không index: WindowAgg → Sort external merge tràn 75 MB ra đĩa. Hai window khác partition cần hai Sort riêng (đĩa 109 MB).
Ba cách tối ưu
1. Index khớp PARTITION BY (và ORDER BY) xóa bước Sort. Vì window function cần dữ liệu sắp theo PARTITION BY, một index trên đúng cột đó cho Index Scan trả dữ liệu sẵn theo thứ tự — PostgreSQL bỏ qua nút Sort hoàn toàn. Đo thật: có index nhanvien_id thì kế hoạch là WindowAgg → Index Scan không Sort; bỏ index thì phải Sort external merge tràn 75 MB ra đĩa. Nếu window function chạy thường xuyên trên cột cụ thể, một index khớp là tối ưu lớn nhất.
2. Gom các hàm cùng phân vùng vào một window. Nếu bạn dùng nhiều window function trên cùng PARTITION BY/ORDER BY, khai một lần bằng mệnh đề WINDOW và tham chiếu lại — PostgreSQL tính thứ tự một lần thay vì mỗi hàm một lần:
SELECT id, sum(doanh_so) OVER w, avg(doanh_so) OVER w, rank() OVER w
FROM ban_hang WINDOW w AS (PARTITION BY nhanvien_id ORDER BY doanh_so DESC);
3. Chấp nhận rằng phân vùng khác nhau cần Sort riêng. Nếu một truy vấn có sum() OVER (PARTITION BY nhanvien_id) và sum() OVER (PARTITION BY thang), hai phân vùng khác nhau bắt buộc hai lần sắp — đo thật cho thấy hai nút Sort riêng (đĩa 109 MB). Không có cách tránh; chỉ có thể canh work_mem để chúng không tràn đĩa, hoặc tách truy vấn nếu hợp lý.
Đánh đổi cần cân nhắc
Window function thắng self-join/subquery cho "tổng hợp + giữ dòng", nhưng cần Sort. Với dữ liệu đã có index phù hợp, chúng cực nhanh. Với dữ liệu không sắp sẵn, bước Sort là chi phí chính — cân work_mem để tránh tràn đĩa (như bài Sort đã đo).
Không lạm dụng khi GROUP BY đủ. Nếu bạn chỉ cần giá trị tổng hợp (không cần từng dòng), GROUP BY gọn và thường nhanh hơn — nó gộp dòng nên xử lý ít dữ liệu hơn ở các bước sau. Window function là cho tình huống cần cả hai: chi tiết dòng và tổng hợp.
ROWS/RANGE frame ảnh hưởng hiệu năng. Window function hỗ trợ khung trượt (ROWS BETWEEN ... cho running total, moving average). Khung phức tạp tính tốn kém hơn tổng hợp toàn phân vùng; dùng khung mặc định (toàn phân vùng) khi không cần trượt.
Ba ý mang về
- Window function tính tổng hợp mà vẫn giữ từng dòng — thay thế self-join và subquery tương quan cho bài toán "mỗi dòng kèm tổng hợp nhóm của nó" trong một lượt quét.
- Bước tốn nhất là Sort theo
PARTITION BY: đo thật, không index thì window function phải sắp cả 2 triệu dòng (tràn 75 MB ra đĩa); một index khớp cột phân vùng cho Index Scan trả sẵn thứ tự và xóa hẳn bước Sort. - Gom các hàm cùng phân vùng vào một mệnh đề
WINDOWđể sắp một lần; phân vùng khác nhau bắt buộc Sort riêng (đo thật hai Sort, đĩa 109 MB) — canhwork_memđể tránh tràn đĩa.
Phần sau ta so hai cách khử trùng lặp thường bị nhầm là như nhau: Phần sau đo DISTINCT vs GROUP BY — khi nào cho cùng kế hoạch, khi nào khác, và cái nào rõ ý hơn.
