Viết SELECT k.id, (SELECT count(*) FROM don WHERE khach_id = k.id) FROM khach k trông rất tự nhiên — mỗi khách kèm số đơn của họ. Nhưng cái subquery tham chiếu k.id của truy vấn ngoài đó có một đặc tính ẩn: nó chạy lại một lần cho mỗi dòng ngoài. Với 100.000 khách, nó chạy 100.000 lần. Bài này đo khi nào điều đó vô hại và khi nào nó biến truy vấn thành 41 giây, cùng cách viết lại an toàn.
Subquery tương quan là gì, và loops=N
Subquery tương quan là subquery tham chiếu cột của truy vấn ngoài (d.khach_id = k.id). Vì kết quả phụ thuộc dòng ngoài hiện tại, PostgreSQL không thể tính nó một lần — nó phải chạy lại cho từng dòng ngoài. Trong EXPLAIN ANALYZE, điều này hiện ra dưới dạng một SubPlan với loops bằng số dòng ngoài.
SELECT k.id, (SELECT count(*) FROM don d WHERE d.khach_id = k.id) FROM khach k;
--   -> SubPlan 1  ... loops=100000   (chạy 100.000 lần!)
Số phận của mẫu này phụ thuộc hoàn toàn vào index trên cột tương quan.
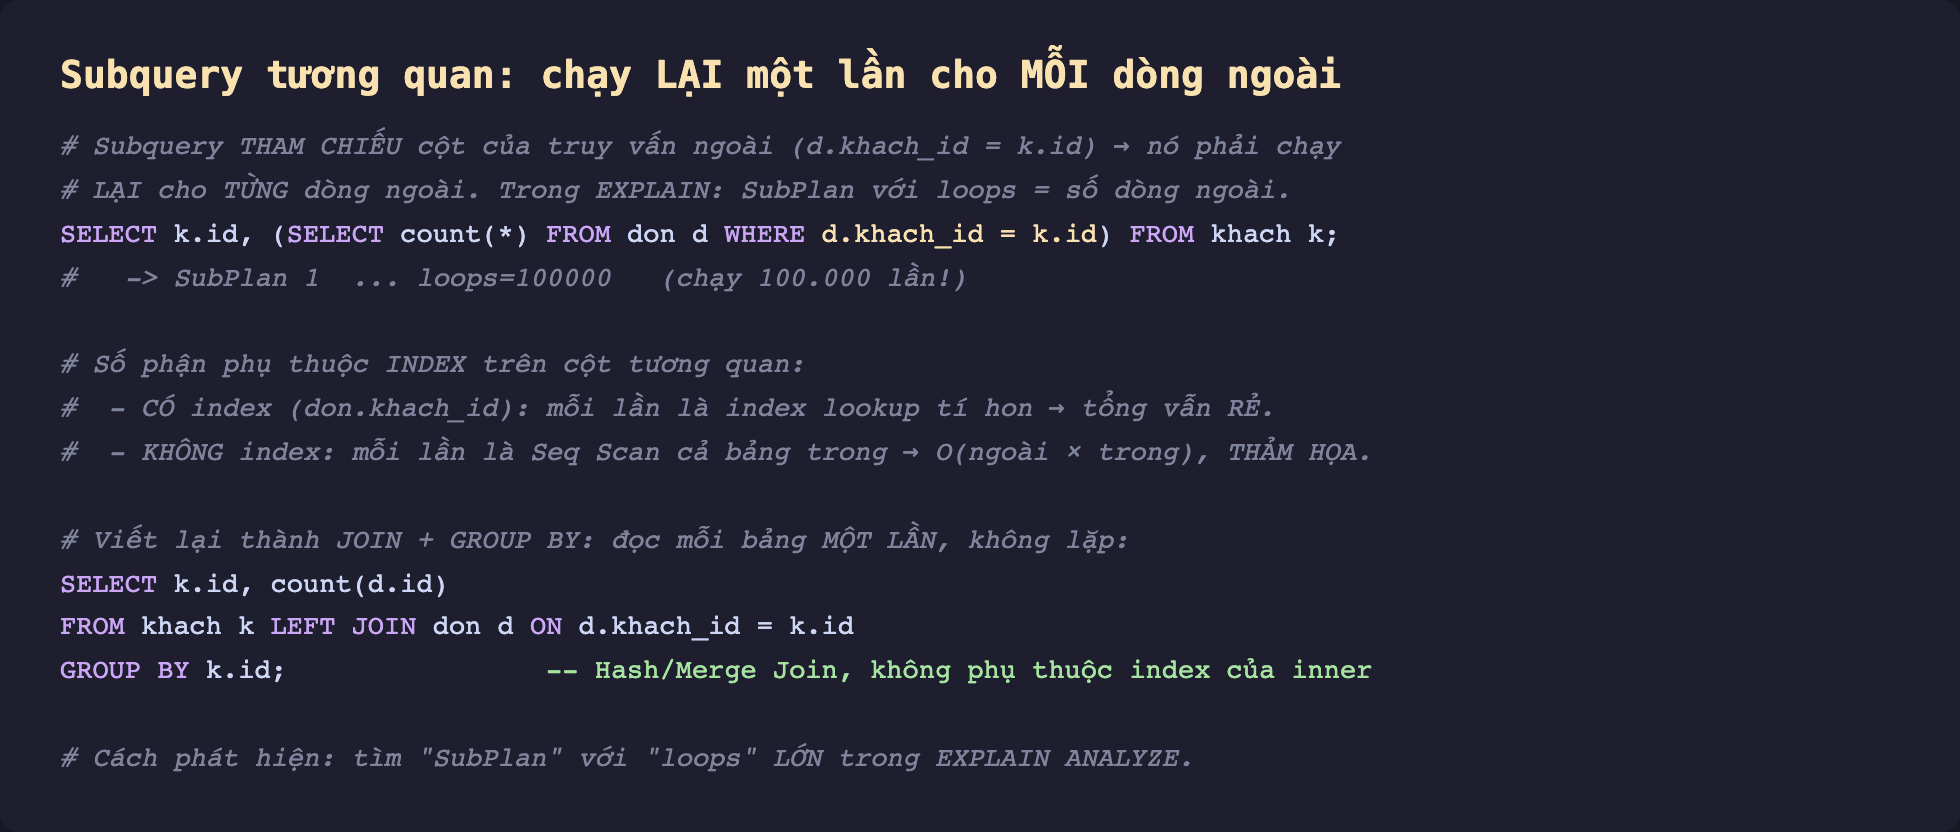
Hình 1: Subquery tương quan chạy loops=N lần (một lần mỗi dòng ngoài). Có index inner thì mỗi lần là lookup rẻ; không có thì mỗi lần là full scan. Cách sửa: JOIN + GROUP BY.
Đo thật: cùng truy vấn, 176 ms hay 41 giây
Trường hợp 1 — inner có index (don.khach_id), 100.000 khách × 2 triệu đơn:
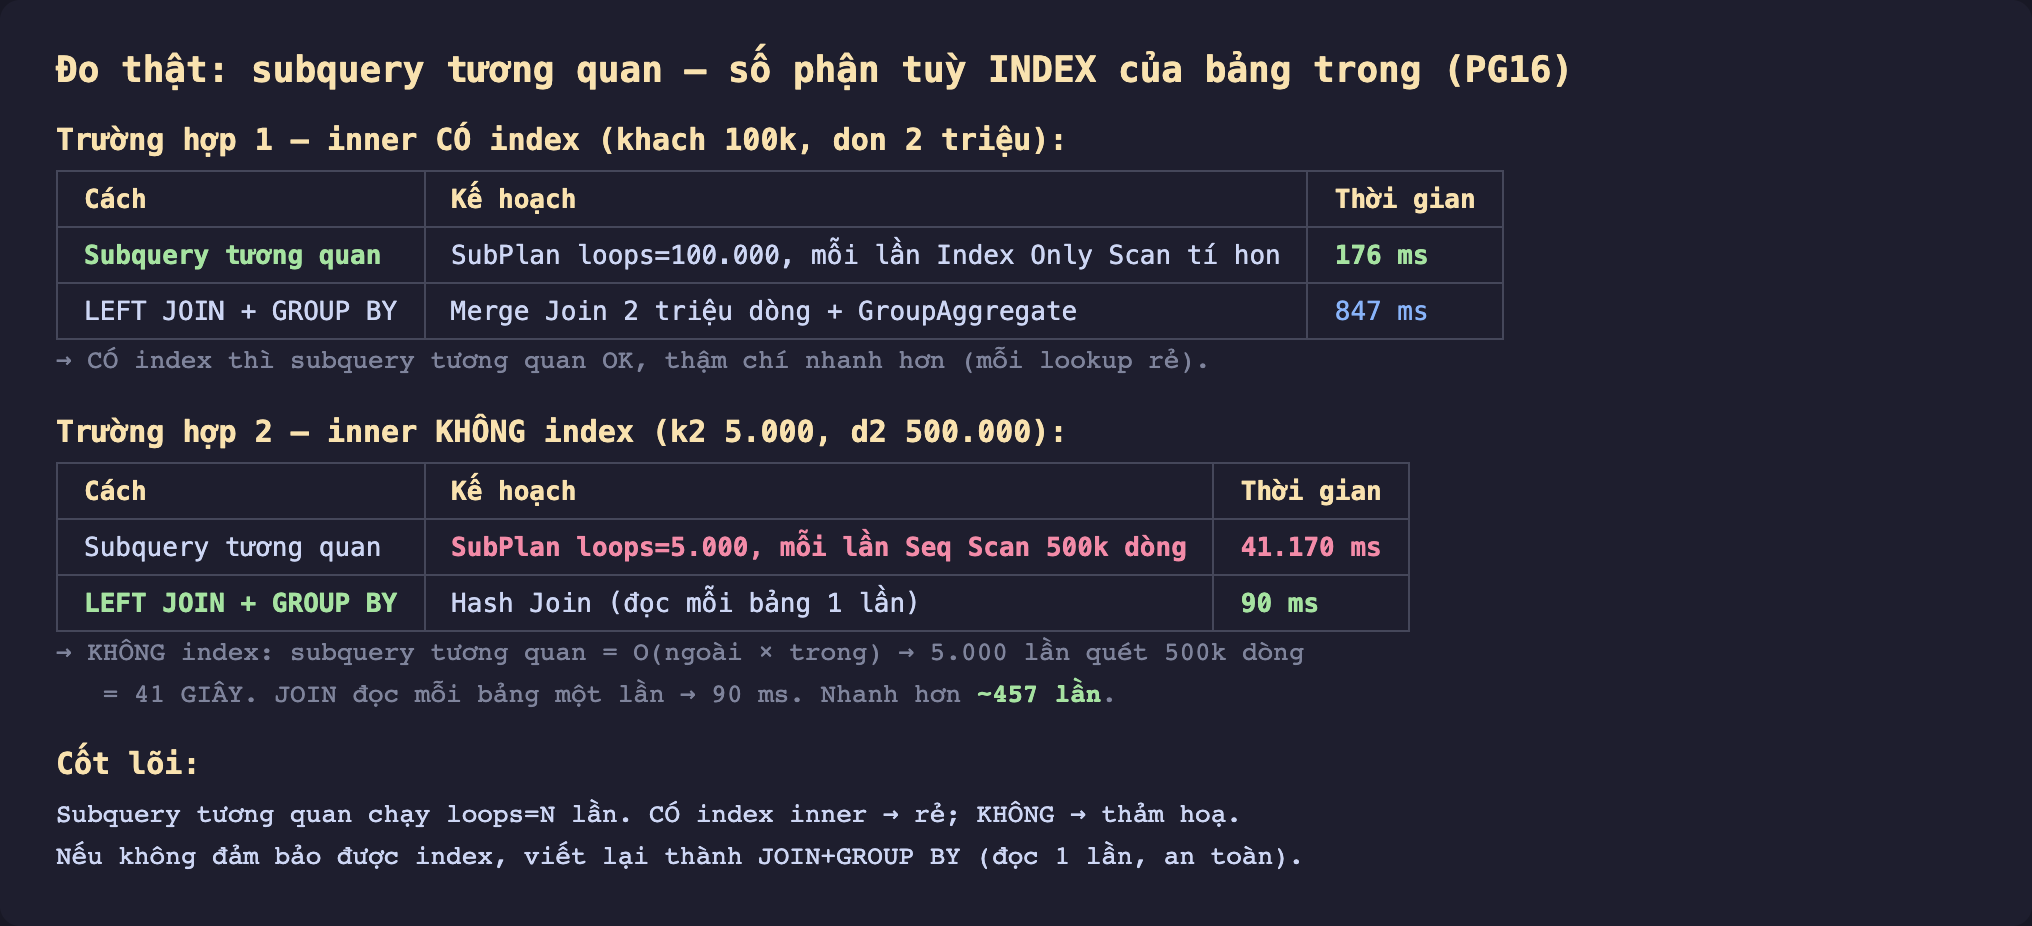
Hình 2: Inner có index: subquery tương quan 176 ms (loops=100.000 nhưng mỗi lookup rẻ), thậm chí nhanh hơn JOIN 847 ms. Inner không index: subquery tương quan 41.170 ms (loops=5.000 × seq scan 500k) so với JOIN 90 ms — nhanh hơn ~457 lần.
- Có index (100k × 2M): subquery tương quan
loops=100000, mỗi lần làIndex Only Scantí hon — 176 ms. Đáng ngạc nhiên, nó còn nhanh hơnLEFT JOIN + GROUP BY(847 ms), vì JOIN phải tạo cả 2 triệu dòng rồi mới gom.
Trường hợp 2 — inner không index, 5.000 dòng ngoài × 500.000 dòng trong:
- Subquery tương quan:
loops=5000, nhưng giờ mỗi lần làSeq Scantoàn bộ 500.000 dòng — 41.170 ms (41 giây!). Đó là O(ngoài × trong): 5.000 × 500.000 = 2,5 tỷ lần đọc. - LEFT JOIN + GROUP BY:
Hash Joinđọc mỗi bảng đúng một lần — 90 ms. Nhanh hơn ~457 lần.
Bài học rõ ràng: subquery tương quan không phải xấu hay tốt tuyệt đối — nó rẻ nếu inner có index phù hợp, thảm họa nếu không. Con số loops × chi phí mỗi lần quyết định tất cả.
Khi nào viết lại thành JOIN
Khi không đảm bảo được index inner. JOIN + GROUP BY đọc mỗi bảng một lần bất kể index, nên nó an toàn — không bao giờ rơi vào O(n×m). Nếu bạn không chắc cột tương quan có index (hoặc không thể thêm), viết lại thành JOIN là lựa chọn phòng thủ.
SELECT k.id, count(d.id) AS so_don
FROM khach k LEFT JOIN don d ON d.khach_id = k.id
GROUP BY k.id;
LEFT JOIN để giữ dòng không có bản khớp (khách không đơn vẫn xuất hiện với count 0), tương đương subquery trả về 0.
Window function cho tính toán "theo dòng còn giữ chi tiết". Nếu bạn cần cả dòng chi tiết và một tổng hợp (ví dụ mỗi đơn kèm tổng đơn của khách đó), window function (sum(...) OVER (PARTITION BY khach_id)) thường gọn và nhanh hơn subquery tương quan lặp lại — chủ đề bài sau.
Đánh đổi cần cân nhắc
Subquery tương quan có index đôi khi là lựa chọn tốt nhất. Đừng máy móc thay mọi subquery tương quan bằng JOIN. Khi inner có index và bạn chỉ cần một giá trị vô hướng cho mỗi dòng ngoài (không cần tất cả dòng khớp), subquery tương quan có thể nhanh hơn JOIN (như 176 ms so với 847 ms ở trên) vì nó không tạo dòng trung gian khổng lồ.
JOIN + GROUP BY có thể tạo dòng trung gian lớn. Ngược lại, khi mỗi dòng ngoài khớp rất nhiều dòng trong, JOIN nhân dòng ra rồi mới gom — tốn bộ nhớ và thời gian. Đây là lý do JOIN chậm hơn ở trường hợp 1.
Luôn đọc loops trong EXPLAIN ANALYZE. Đây là công cụ chẩn đoán chính: SubPlan với loops lớn và mỗi lần tốn kém (seq scan) là cờ đỏ. loops lớn nhưng mỗi lần rẻ (index lookup) thì không sao. Con số quan trọng là loops × thời gian mỗi loop.
Ba ý mang về
- Subquery tương quan chạy lại một lần cho mỗi dòng ngoài (
loops=Ntrong EXPLAIN ANALYZE) — vì nó tham chiếu cột truy vấn ngoài; số phận phụ thuộc index trên cột tương quan. - Có index inner thì rẻ, không có thì O(n×m): đo thật, cùng ý định chạy 176 ms với index nhưng 41 giây không index (5.000 lần seq scan 500k dòng) — so với 90 ms của JOIN.
- Viết lại thành JOIN + GROUP BY khi không đảm bảo được index (đọc mỗi bảng một lần, an toàn), hoặc window function khi cần giữ chi tiết — nhưng subquery tương quan có index vẫn có thể là lựa chọn tốt nhất khi chỉ cần một giá trị vô hướng.
Phần sau ta đi sâu vào công cụ vừa nhắc: Phần sau mổ xẻ window function — cách tính tổng hợp mà vẫn giữ từng dòng, và tối ưu chúng để tránh sort thừa.
