Gần như mọi ứng dụng đều phân trang, và gần như mọi ứng dụng đều làm bằng LIMIT ... OFFSET .... Nó chạy tốt trên trang đầu, nên không ai để ý vấn đề — cho tới khi người dùng cuộn tới trang 500 và trang tải chậm hẳn. Bí mật khó chịu: OFFSET chậm dần theo độ sâu trang, và nó là tuyến tính. Bài này đo thật cái giá đó trên bảng 2 triệu dòng, và một cách phân trang giữ tốc độ không đổi ở mọi trang: keyset.
Vì sao OFFSET chậm dần
OFFSET N không "nhảy" tới trang cần. PostgreSQL vẫn phải quét từ đầu, đếm và vứt bỏ N dòng đầu tiên, rồi mới trả về LIMIT dòng tiếp theo. Trang càng sâu, N càng lớn, càng nhiều dòng phải quét rồi bỏ đi vô ích.
SELECT id, tieu_de FROM bai ORDER BY ngay, id
LIMIT 20 OFFSET 1990000;   -- quét + vứt 1,99 triệu dòng chỉ để lấy 20 dòng!
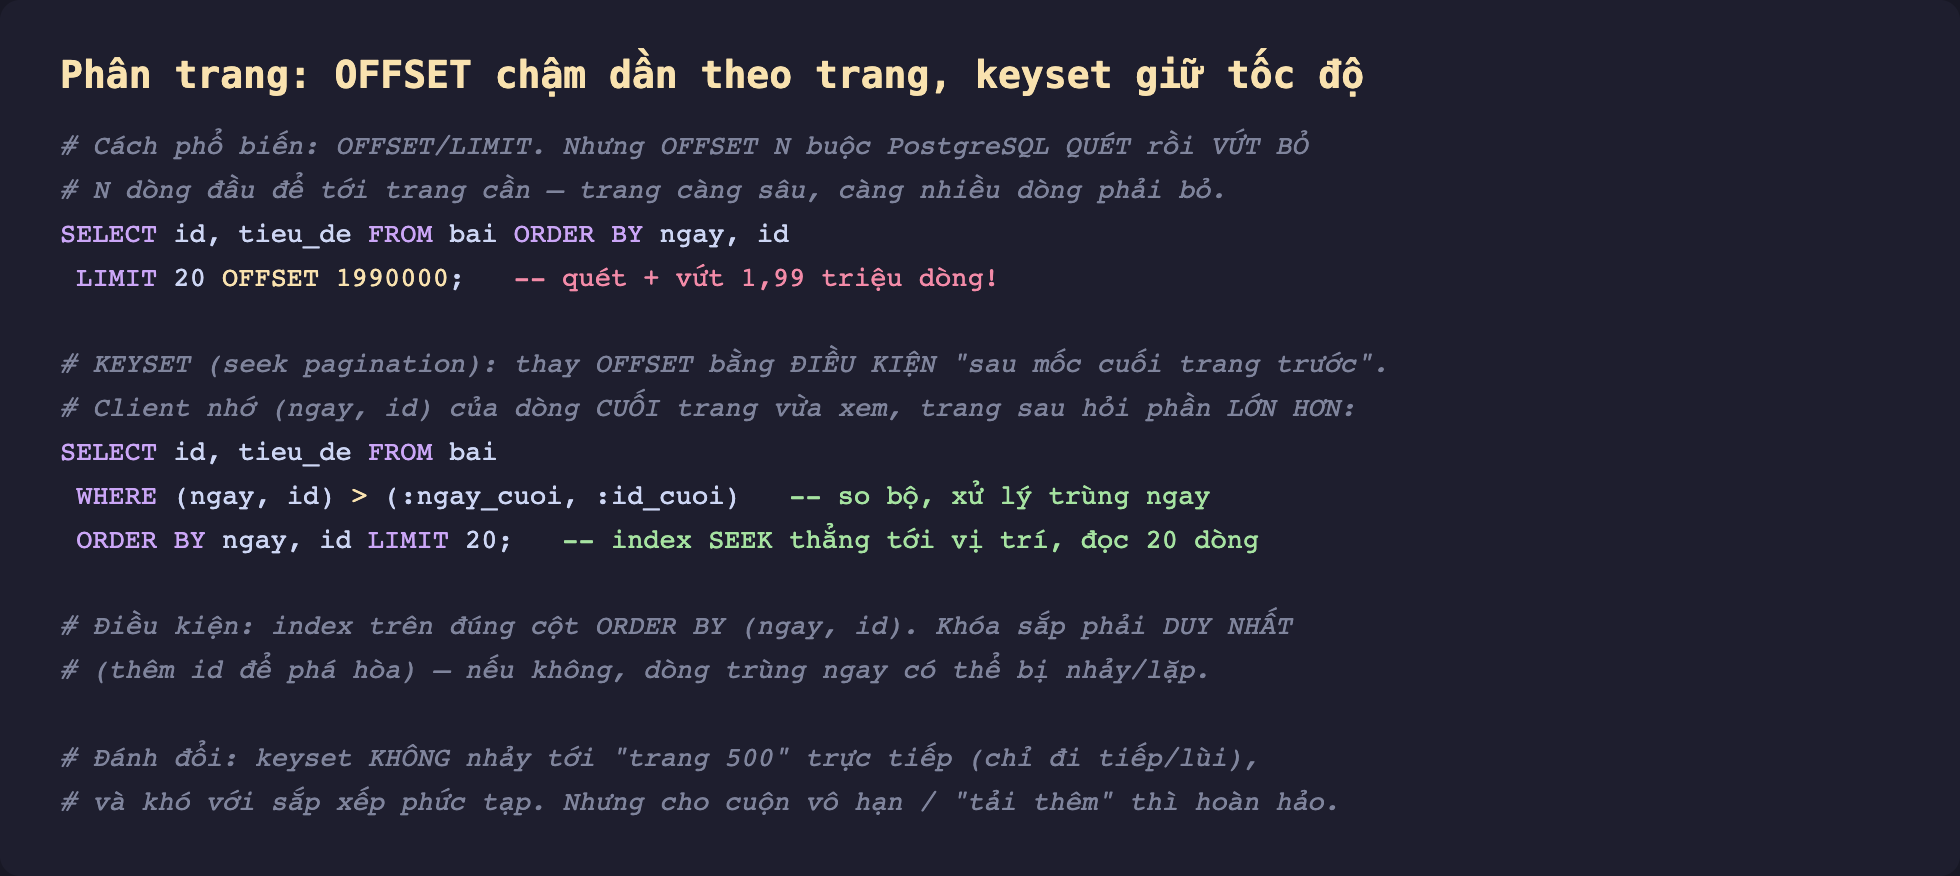
Hình 1: OFFSET quét và vứt bỏ mọi dòng trước trang cần. Keyset thay OFFSET bằng điều kiện (ngay, id) > mốc_cuối, cho index seek thẳng tới vị trí.
Đo thật: từ 0,036 ms tới 142 ms
Phân trang bảng bai 2 triệu dòng, mỗi trang 20 dòng, đo thời gian ở các độ sâu khác nhau:
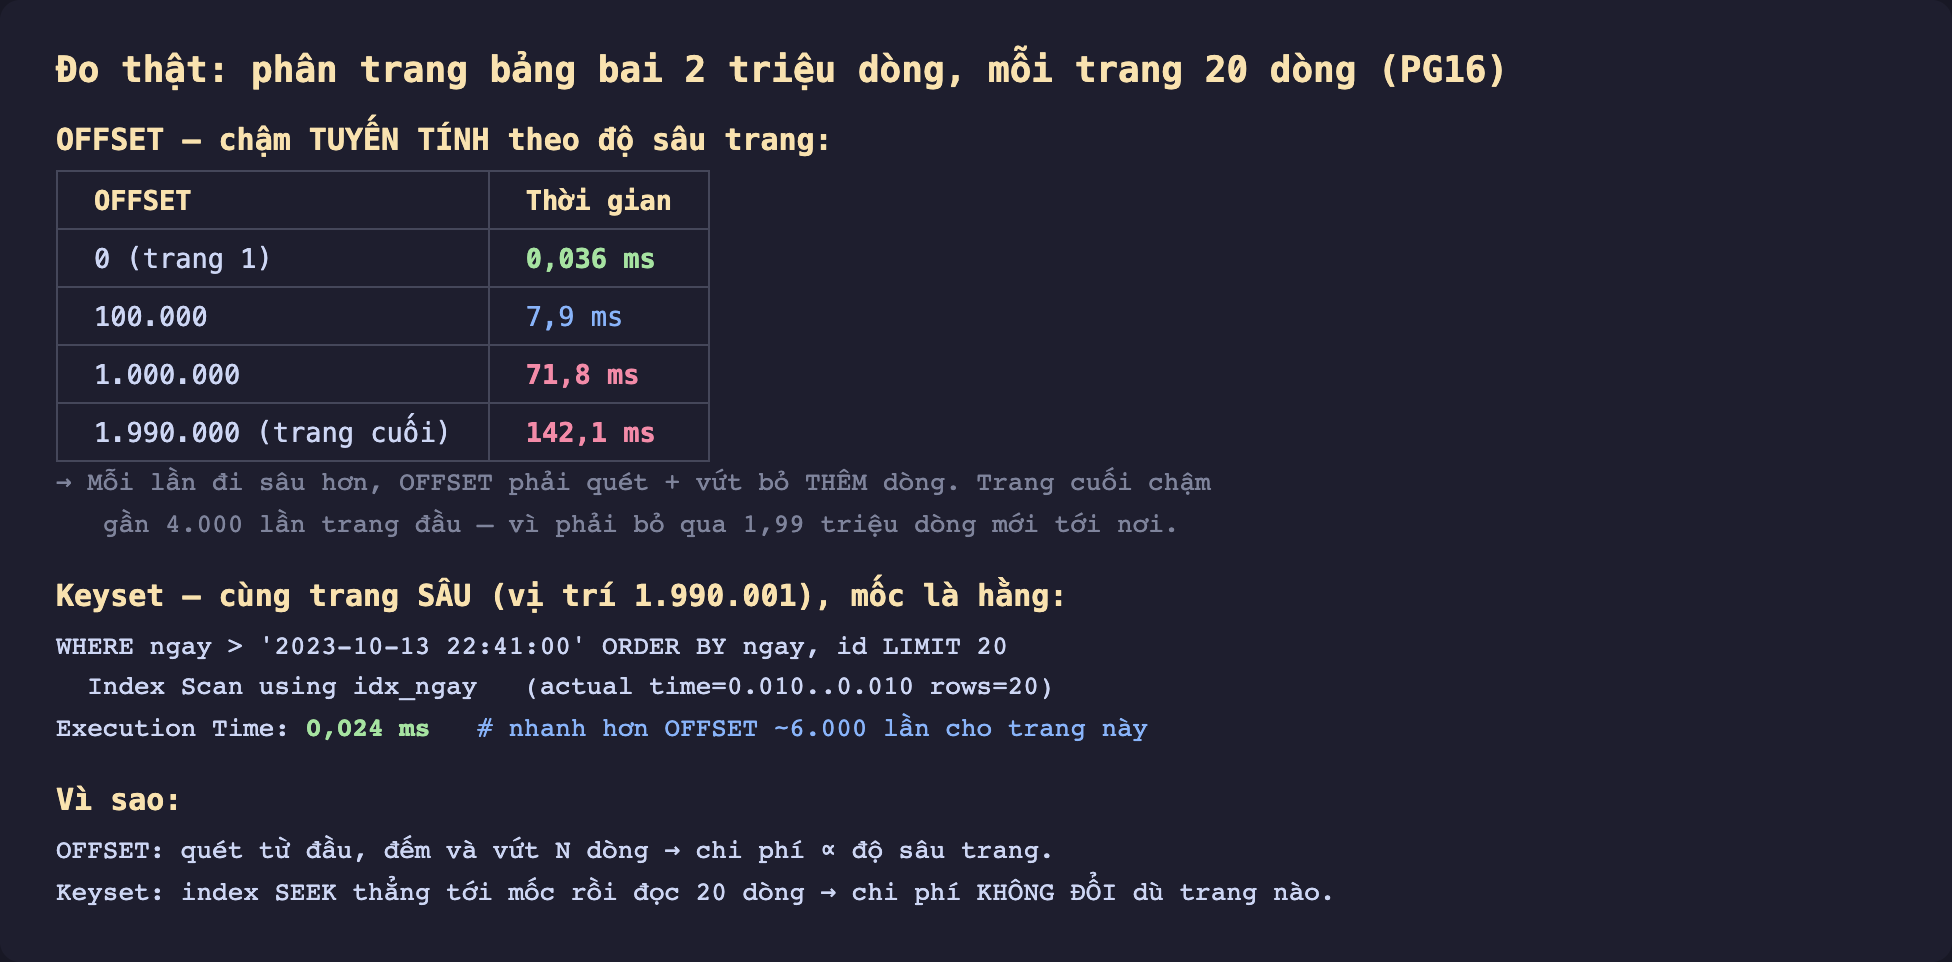
Hình 2: OFFSET tăng tuyến tính — 0,036 ms (trang 1), 7,9 ms, 71,8 ms, 142,1 ms (trang cuối). Keyset cùng trang sâu chỉ 0,024 ms nhờ index seek thẳng tới mốc.
Kết quả OFFSET rất rõ:
- OFFSET 0 (trang 1): 0,036 ms.
- OFFSET 100.000: 7,9 ms.
- OFFSET 1.000.000: 71,8 ms.
- OFFSET 1.990.000 (trang cuối): 142,1 ms.
Thời gian tăng tuyến tính theo OFFSET. Trang cuối chậm gần 4.000 lần trang đầu — không phải vì trả về nhiều dữ liệu hơn (vẫn 20 dòng), mà vì phải quét qua 1,99 triệu dòng để tới nơi.
Keyset pagination: tốc độ không đổi
Keyset (còn gọi seek pagination) bỏ OFFSET, thay bằng một điều kiện WHERE. Client nhớ giá trị sắp xếp của dòng cuối trang vừa xem, và trang sau hỏi những dòng "lớn hơn mốc đó":
SELECT id, tieu_de FROM bai
WHERE (ngay, id) > (:ngay_cuoi, :id_cuoi)   -- so sánh bộ (row comparison)
ORDER BY ngay, id LIMIT 20;
Đo thật cùng trang sâu (vị trí 1.990.001), với mốc là hằng số: 0,024 ms — nhanh hơn OFFSET ~6.000 lần cho trang này. Kế hoạch là Index Scan using idx_ngay seek thẳng tới mốc rồi đọc đúng 20 dòng. Chi phí không đổi dù trang thứ 1 hay trang thứ 100.000 — vì index đưa PostgreSQL tới vị trí ngay lập tức, không phải quét từ đầu.
Điều kiện để keyset đúng
Cần index trên đúng cột ORDER BY. Ở đây idx_ngay(ngay, id) khớp ORDER BY ngay, id — nếu không có index phù hợp, keyset cũng phải quét.
Khóa sắp xếp phải duy nhất. Nếu chỉ sắp theo ngay mà nhiều dòng cùng ngay, dùng WHERE ngay > mốc có thể nhảy hoặc lặp dòng ở ranh giới trang. Cách sửa: thêm một cột duy nhất (id) vào khóa sắp, và so sánh bộ (ngay, id) > (mốc_ngay, mốc_id). So sánh bộ này xử lý đúng trường hợp trùng ngay.
Đánh đổi cần cân nhắc
Keyset không nhảy trực tiếp tới "trang 500". Nó chỉ đi tiếp và lùi từ vị trí hiện tại — vì nó cần mốc của trang trước. Nếu giao diện cần nút "tới trang N bất kỳ", keyset không làm được trực tiếp. Nhưng với cuộn vô hạn và nút "tải thêm" (kiểu feed mạng xã hội, danh sách sản phẩm), keyset là hoàn hảo — đó cũng là kiểu phân trang phổ biến nhất hiện nay.
Khó với sắp xếp phức tạp nhiều cột hoặc cho phép đổi hướng sắp. Điều kiện WHERE bộ trở nên phức tạp khi sắp theo nhiều cột với hướng khác nhau (ORDER BY a DESC, b ASC). OFFSET đơn giản hơn về mặt viết mã.
OFFSET vẫn ổn cho tập nhỏ. Nếu bảng chỉ vài nghìn dòng, hoặc người dùng gần như không bao giờ tới trang sâu, OFFSET đơn giản là đủ. Chỉ đổi sang keyset khi phân trang trên bảng lớn và trang sâu là chuyện thật sự xảy ra.
Ba ý mang về
- OFFSET chậm tuyến tính theo độ sâu trang vì PostgreSQL phải quét rồi vứt bỏ mọi dòng trước trang cần: đo thật, cùng lấy 20 dòng nhưng trang cuối mất 142 ms so với 0,036 ms của trang đầu (gần 4.000 lần).
- Keyset pagination giữ tốc độ không đổi bằng cách thay OFFSET bằng điều kiện
(cột_sắp) > mốc_cuối, cho index seek thẳng tới vị trí — cùng trang sâu chỉ 0,024 ms, nhanh hơn OFFSET ~6.000 lần. - Keyset cần index khớp
ORDER BYvà khóa sắp duy nhất (dùng so sánh bộ(ngay, id)để xử lý trùng); nó lý tưởng cho cuộn vô hạn/tải thêm nhưng không nhảy tới trang bất kỳ được — OFFSET vẫn ổn cho tập nhỏ.
Phần sau ta xét một cạm bẫy hiệu năng đến từ tầng ứng dụng chứ không phải SQL: Phần sau đo vấn đề N+1 query — vì sao vòng lặp gọi một truy vấn cho mỗi dòng giết hiệu năng, và cách gộp thành một.
