SELECT * là câu SQL đầu tiên ai cũng học, và là thói quen khó bỏ. Nó tiện: gõ nhanh, không cần nhớ tên cột. Nhưng trong code chạy production, nó là một phản mẫu tốn kém — và cái giá không hiển nhiên cho tới khi đo. Bài này đo thật ba tác hại của SELECT * trên bảng 2 triệu dòng có một cột mô tả dài, gồm một con số gây sốc: chậm gấp 9,5 lần và truyền dữ liệu gấp 95 lần.
Tác hại 1: phá index-only scan
Bảng sp có covering index trên gia kèm INCLUDE (ma) — nghĩa là index chứa sẵn cả gia và ma. Truy vấn chỉ cần hai cột đó có thể trả lời hoàn toàn từ index, không chạm bảng (Index Only Scan). Nhưng SELECT * phá vỡ điều đó:
CREATE INDEX idx_gia_ma ON sp(gia) INCLUDE (ma);

SELECT gia, ma FROM sp WHERE gia=603858;   -- Index Only Scan (width=13)
SELECT *        FROM sp WHERE gia=603858;   -- Index Scan, phải đọc heap (width=985)
Đo thật: SELECT gia, ma cho Index Only Scan với width=13 — chỉ đọc index. SELECT * buộc Index Scan phải vào heap lấy toàn bộ dòng, width=985 — vì nó cần cả cột mo_ta_dai 960 ký tự mà covering index không chứa.
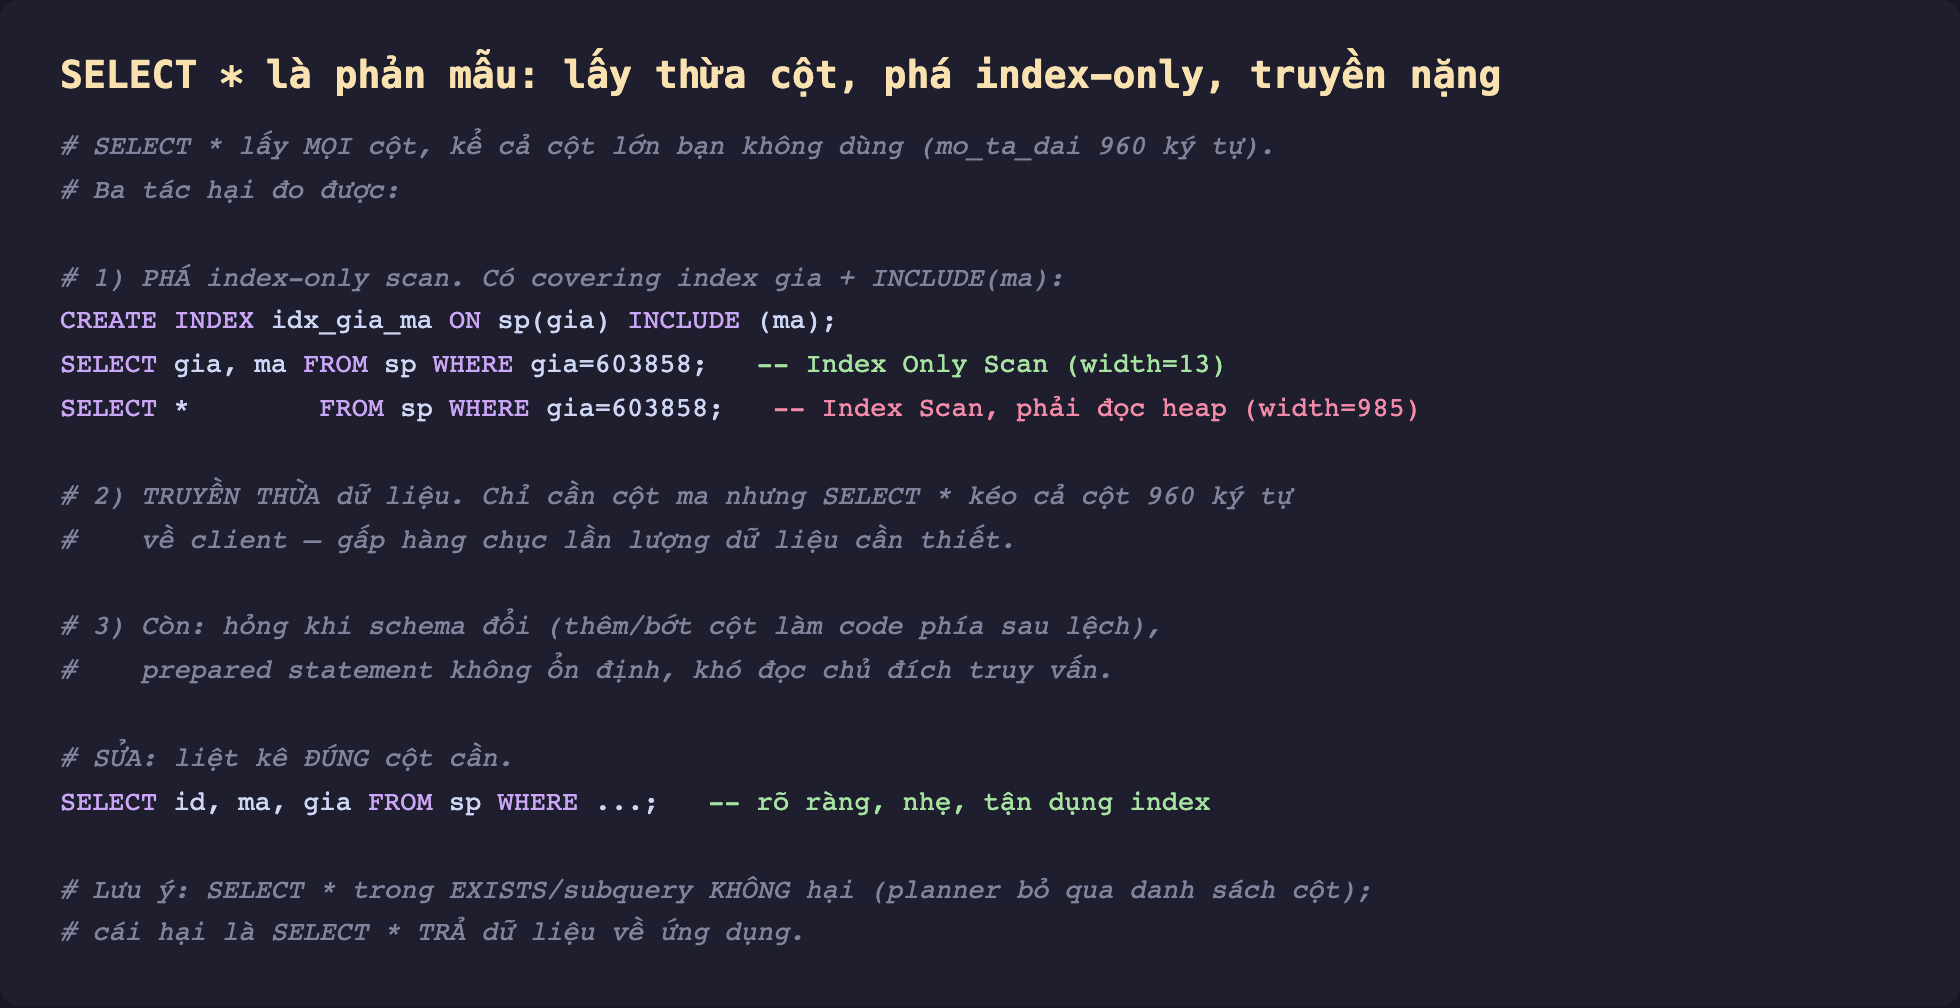
Hình 1: SELECT * phá index-only scan (buộc đọc heap), truyền thừa dữ liệu, và làm truy vấn dễ vỡ khi schema đổi. Cách sửa: liệt kê đúng cột cần.
Tác hại 2: truyền dữ liệu gấp 95 lần
Đây là con số gây sốc. Lấy một khoảng 200.000 dòng, so SELECT ma (một cột hẹp) với SELECT *:
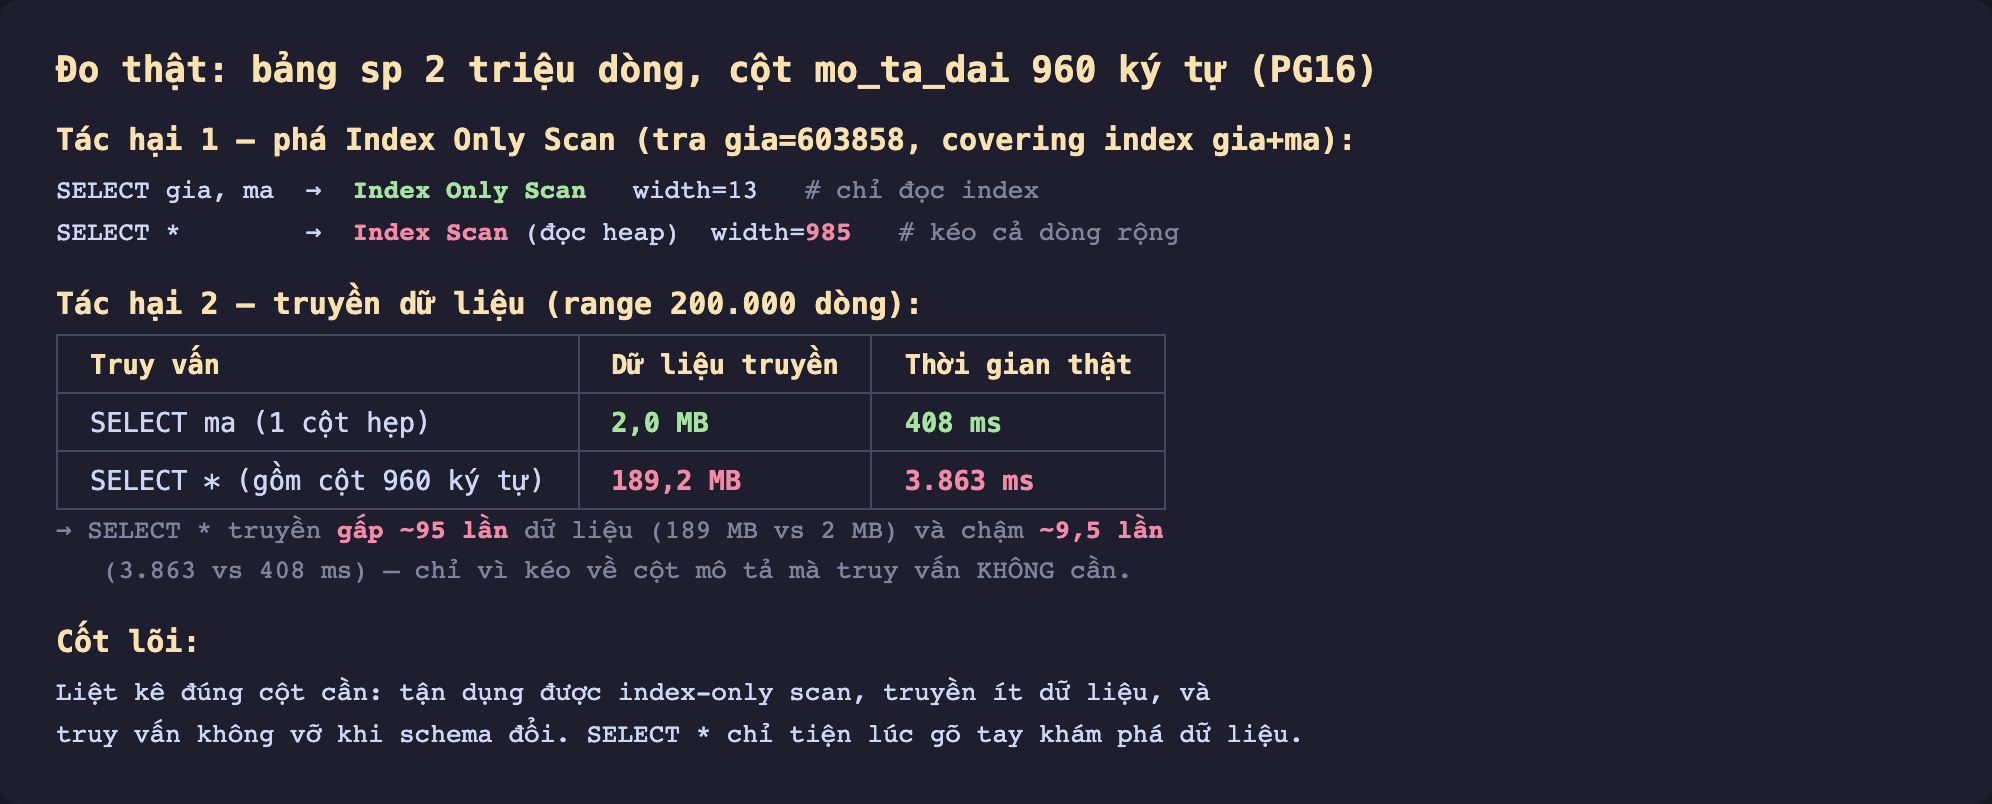
Hình 2: Range 200.000 dòng. SELECT ma: 2,0 MB, 408 ms. SELECT *: 189,2 MB, 3.863 ms. Lấy thừa cột mô tả 960 ký tự khiến truyền gấp ~95 lần và chậm ~9,5 lần.
Kết quả:
SELECT ma(một cột hẹp): truyền 2,0 MB, mất 408 ms.SELECT *(gồm cộtmo_ta_dai960 ký tự): truyền 189,2 MB, mất 3.863 ms.
Chậm gấp 9,5 lần, truyền dữ liệu gấp 95 lần — chỉ vì kéo về client cột mô tả mà truy vấn không hề dùng. Trên ứng dụng web thật, dữ liệu này còn phải đi qua mạng, qua ORM, qua serialization — chi phí nhân lên ở mọi tầng.
Tác hại 3: dễ vỡ và khó đọc
Ngoài hiệu năng, SELECT * còn gây hại về mặt bảo trì:
Vỡ khi schema đổi. Thêm một cột vào bảng làm SELECT * trả về nhiều cột hơn — code phía sau dựa vào thứ tự/số cột (ví dụ INSERT INTO ... SELECT *) sẽ lệch hoặc lỗi. Bớt một cột thì code đọc cột đó vỡ.
Prepared statement không ổn định. Kế hoạch và kiểu dữ liệu trả về của SELECT * phụ thuộc schema hiện tại; đổi bảng có thể làm prepared statement đã cache không còn khớp.
Che giấu chủ đích. Đọc SELECT id, ten, email FROM users biết ngay truy vấn cần gì. SELECT * FROM users không cho biết cột nào thực sự được dùng — khó tối ưu, khó review.
Cách sửa, và một ngoại lệ
Liệt kê đúng cột cần. Đơn giản vậy thôi:
SELECT id, ma, gia FROM sp WHERE ...; -- rõ ràng, nhẹ, tận dụng index
Bạn được index-only scan khi có thể, truyền ít dữ liệu, và truy vấn không vỡ khi schema đổi.
Một ngoại lệ quan trọng: SELECT * trong EXISTS/subquery không hại. WHERE EXISTS (SELECT * FROM ...) hoàn toàn ổn — planner bỏ qua danh sách cột trong EXISTS (nó chỉ kiểm tra sự tồn tại của dòng), nên không lấy cột nào cả. Cái hại là SELECT * trả dữ liệu về ứng dụng, không phải bản thân dấu sao.
Đánh đổi cần cân nhắc
SELECT * tiện cho khám phá tương tác. Gõ tay trong psql để xem bảng có gì, SELECT * FROM t LIMIT 5 là hoàn toàn hợp lý. Phản mẫu là dùng nó trong code ứng dụng chạy lặp đi lặp lại.
Đừng lấy cột lớn nếu không hiển thị. Cột text/bytea/jsonb lớn (mô tả, ảnh, log) là thủ phạm chính. Nếu trang danh sách chỉ hiện tên và giá, đừng SELECT * kéo cả cột mô tả — lấy nó riêng ở trang chi tiết khi cần.
Cân nhắc với ORM. Nhiều ORM mặc định SELECT *. Kiểm cấu hình để chỉ lấy cột cần (projection / .only() / .select()), đặc biệt cho bảng có cột lớn.
Ba ý mang về
SELECT *phá index-only scan: truy vấn chỉ cần cột trong covering index đượcIndex Only Scan(width=13, không đọc heap), nhưngSELECT *buộc đọc heap lấy cả dòng rộng (width=985).SELECT *truyền thừa dữ liệu khủng khiếp: đo thật, lấy 200.000 dòng truyền 189 MB thay vì 2 MB (~95 lần) và chậm 3.863 ms thay vì 408 ms (~9,5 lần) — chỉ vì kéo cột mô tả không dùng.- Liệt kê đúng cột cần trong code: nhẹ hơn, tận dụng index, không vỡ khi schema đổi — chỉ dùng
SELECT *khi khám phá tương tác, và nhớSELECT *trongEXISTSthì vô hại.
Phần sau ta xét một thói quen tốn kém khác trong truy vấn thật: Phần sau đo vì sao phân trang bằng OFFSET chậm dần theo trang, và cách keyset pagination giữ tốc độ không đổi.
