Trang danh sách bài viết của bạn hiển thị 100 bài kèm số bình luận mỗi bài. Code chạy tốt lúc dev với vài bài, nhưng lên production với dữ liệu thật thì trang tải 4 giây. Thủ phạm thường là N+1 query — một mẫu chống hiệu năng đến từ tầng ứng dụng, không phải SQL, và thường do ORM sinh ra ngầm mà lập trình viên không thấy. Bài này đo thật cái giá của nó, và một phát hiện bất ngờ: vấn đề không nằm ở query.
N+1 là gì
Mẫu N+1: chạy 1 truy vấn lấy danh sách, rồi trong một vòng lặp chạy thêm N truy vấn — mỗi truy vấn cho một dòng — để lấy dữ liệu liên quan. Tổng cộng N+1 truy vấn.
bai_list = query("SELECT id, tieu_de FROM bai_viet LIMIT 100")   # 1 truy vấn
for bai in bai_list:
    so_bl = query("SELECT count(*) FROM binh_luan WHERE bai_id=?", bai.id)  # +100!
# → Tổng 101 truy vấn = 101 lần đi-về (round-trip) giữa app và DB
Nguy hiểm nhất là N+1 thường vô hình trong code. Với ORM, một dòng for bai in bai_list: print(bai.binh_luan.count()) trông vô hại nhưng sinh ra 100 truy vấn ngầm. Bạn không viết SQL nào, nên không nhận ra.
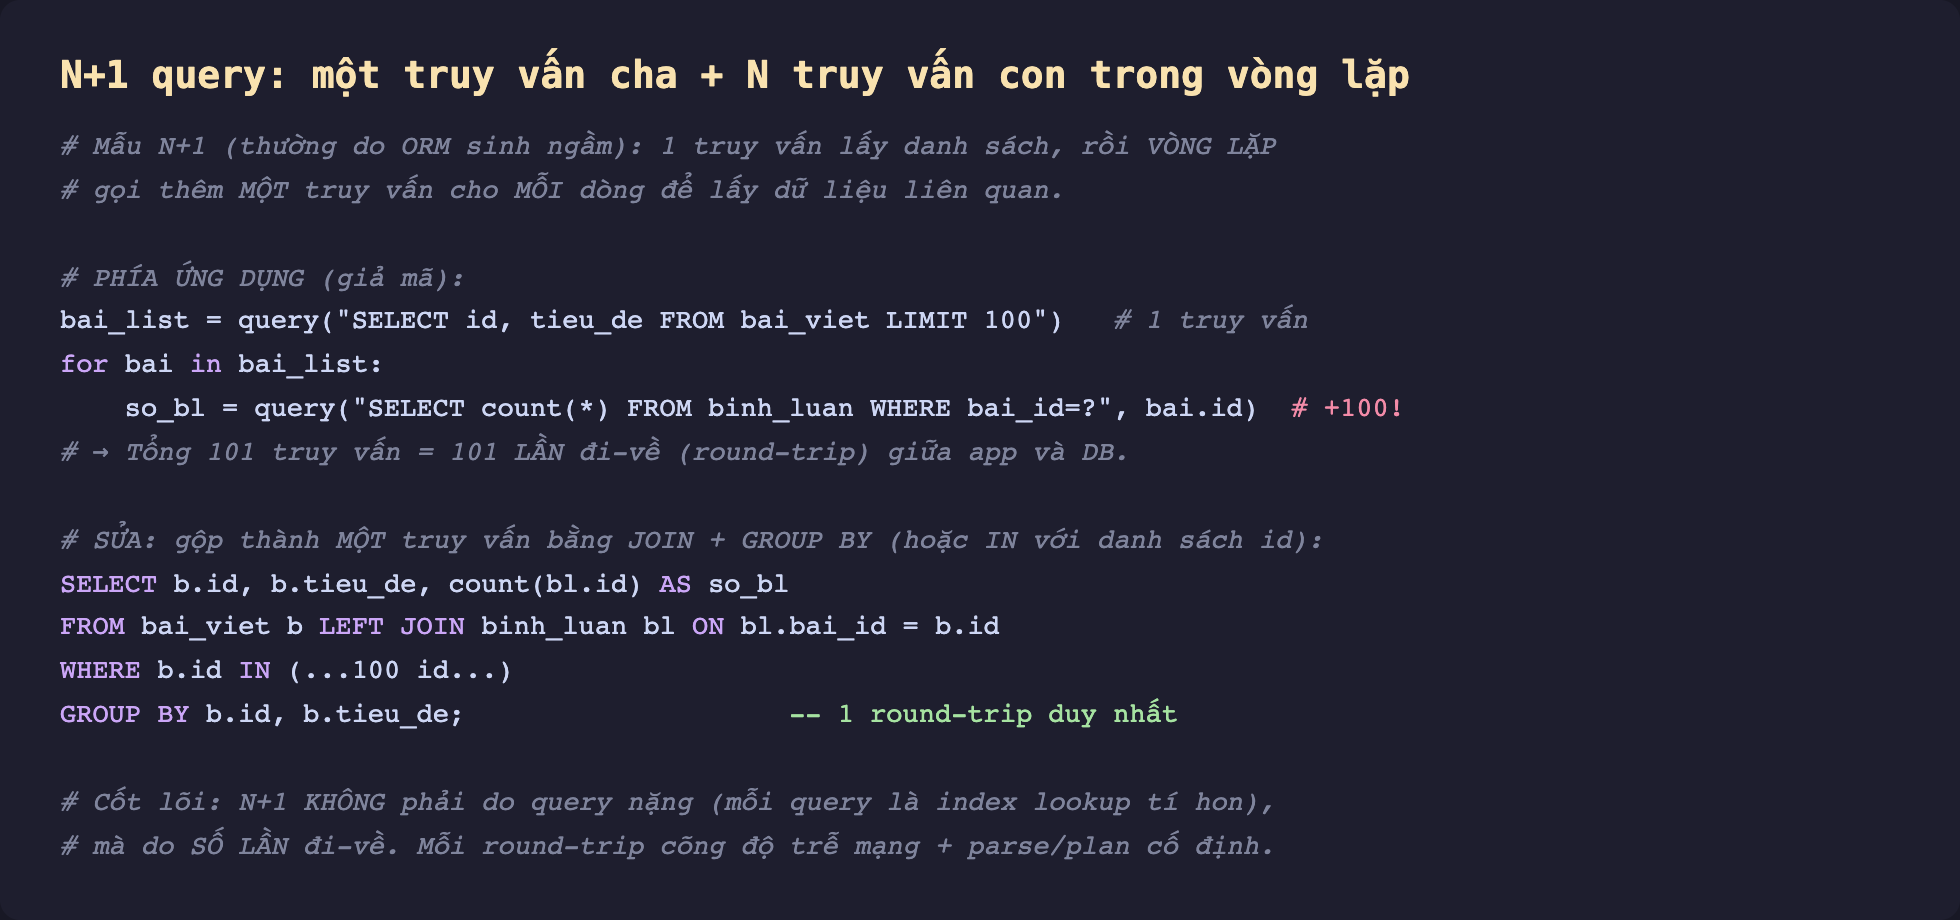
Hình 1: N+1 chạy 1 truy vấn cha + N truy vấn con trong vòng lặp. Cách sửa: gộp thành một truy vấn bằng LEFT JOIN + GROUP BY (hoặc IN với danh sách id).
Đo thật: vấn đề không phải query, mà là round-trip
Đây là phát hiện quan trọng nhất. Đo N+1 (100 bài, mỗi bài một truy vấn đếm bình luận) so với một JOIN gộp:
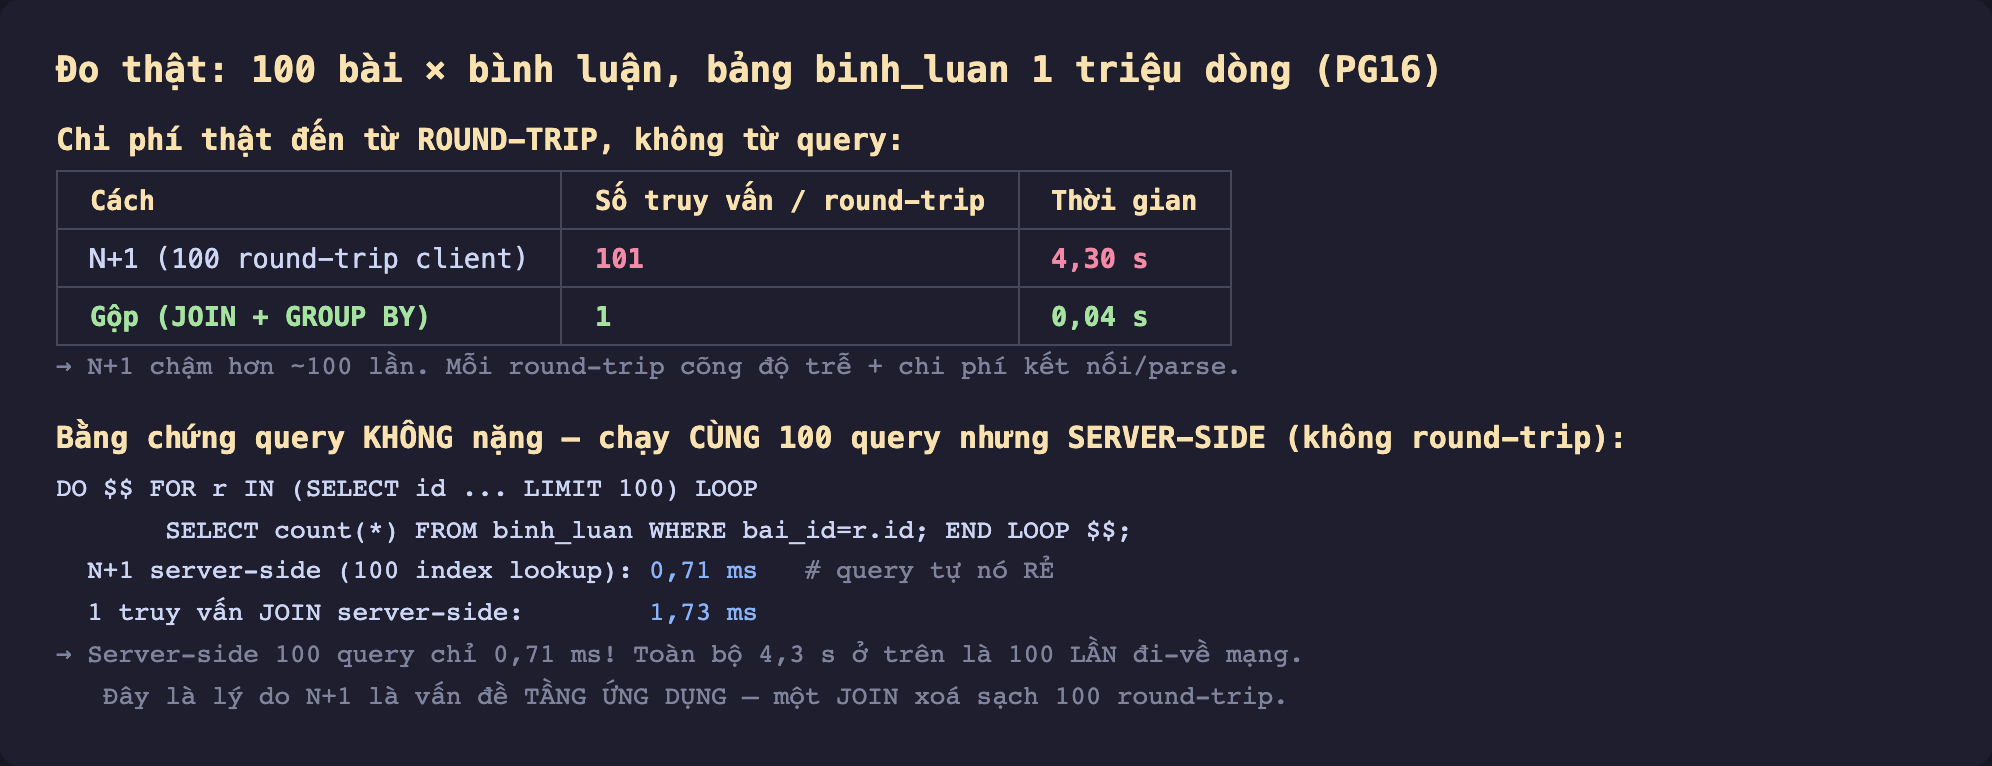
Hình 2: N+1 (100 round-trip client): 4,30 s. Gộp (1 JOIN): 0,04 s — nhanh ~100 lần. Nhưng chạy cùng 100 query server-side (không round-trip) chỉ 0,71 ms — chứng minh chi phí là round-trip, không phải query.
Kết quả gồm hai lớp:
- N+1 từ client (100 round-trip riêng): 4,30 s.
- Gộp bằng một JOIN: 0,04 s — nhanh hơn ~100 lần.
Nhưng đây mới là điều bất ngờ: chạy cùng 100 truy vấn đó server-side trong một vòng lặp plpgsql (không round-trip mạng) chỉ mất 0,71 ms. Mỗi truy vấn con là một index lookup tí hon, cực rẻ. Vậy 4,3 giây kia ở đâu ra? Toàn bộ là 100 lần đi-về mạng — mỗi round-trip cõng độ trễ mạng cộng chi phí kết nối/parse/plan cố định.
Đây là bài học cốt lõi: N+1 không phải vấn đề query, mà là vấn đề số lần đi-về. Bạn không thể sửa nó bằng cách thêm index hay tối ưu từng query — mỗi query đã nhanh sẵn. Cách sửa duy nhất là giảm số round-trip, và một JOIN gộp 101 round-trip thành 1.
Cách sửa
Gộp bằng JOIN + GROUP BY. Thay vì lặp, hỏi tất cả trong một truy vấn:
SELECT b.id, b.tieu_de, count(bl.id) AS so_bl
FROM bai_viet b LEFT JOIN binh_luan bl ON bl.bai_id = b.id
WHERE b.id IN (...100 id...)
GROUP BY b.id, b.tieu_de;
LEFT JOIN để bài không có bình luận vẫn xuất hiện (với count 0). Một round-trip duy nhất.
Với ORM, dùng eager loading. Mọi ORM lớn đều có cơ chế nạp sẵn quan hệ trong một (hoặc ít) truy vấn: JOIN FETCH (JPA/Hibernate), .includes()/.preload() (Rails), selectinload/joinedload (SQLAlchemy), .prefetch_related()/.select_related() (Django). Bật nó cho các quan hệ bạn lặp qua.
Hoặc gom id rồi một truy vấn IN. Nếu không JOIN được, ít nhất gom 100 id lại và chạy một truy vấn WHERE bai_id IN (...) rồi phân phối kết quả trong code — vẫn là 1 round-trip thay vì 100.
Đánh đổi cần cân nhắc
Connection pooling giảm nhẹ nhưng không xóa N+1. Có pool kết nối thì mỗi round-trip không phải mở kết nối mới, nhưng vẫn tốn độ trễ mạng và parse/plan cho từng query. N round-trip vẫn chậm hơn 1 nhiều lần; pooling chỉ làm hằng số nhỏ hơn.
JOIN gộp có thể lấy thừa dữ liệu. Nếu mỗi bài có nhiều bình luận và bạn JOIN lấy cả nội dung (không phải count), một bài 1000 bình luận sẽ nhân dòng — dữ liệu cha lặp lại 1000 lần. Khi đó cân nhắc hai truy vấn (một cho bài, một cho bình luận WHERE bai_id IN (...)) thay vì một JOIN khổng lồ. Vẫn là 2 round-trip, không phải 101.
Đừng ngại chút phức tạp SQL để đổi lấy round-trip. Một JOIN + GROUP BY hơi khó viết hơn một vòng lặp, nhưng đổi 100× tốc độ thì luôn đáng. Đây là nơi hiểu SQL thắng ORM tiện lợi.
Ba ý mang về
- N+1 là 1 truy vấn cha + N truy vấn con trong vòng lặp, thường do ORM sinh ngầm và vô hình trong code — đo thật, 101 round-trip mất 4,30 s so với 0,04 s của một JOIN gộp (~100 lần).
- Chi phí N+1 là round-trip, không phải query: cùng 100 truy vấn chạy server-side (không round-trip) chỉ 0,71 ms — mỗi query là index lookup tí hon; cách sửa là giảm số lần đi-về, không phải tối ưu từng query.
- Gộp bằng
LEFT JOIN+GROUP BY, hoặc eager loading của ORM (JOIN FETCH,.includes,selectinload,prefetch_related); connection pooling chỉ giảm nhẹ chứ không xóa được vấn đề.
Phần sau ta so ba cách viết cùng một điều kiện "có tồn tại": Phần sau đo EXISTS vs IN vs JOIN — cái nào nhanh hơn, khi nào, và cạm bẫy NOT IN với NULL.
