"Khách nào có đơn hàng?" — một câu hỏi đơn giản, ba cách viết SQL: EXISTS, IN, hay JOIN với DISTINCT. Câu hỏi kinh điển: cái nào nhanh hơn? Câu trả lời có một điều bất ngờ dễ chịu và một cạm bẫy nguy hiểm. Bài này đo cả ba trên bảng 500 nghìn khách + 2 triệu đơn, và mổ xẻ lỗi NOT IN với NULL — một lỗi cho kết quả sai lặng lẽ, không báo lỗi nào.
Đo thật: EXISTS và IN giống hệt nhau
Ba cách viết cùng ý định "khách có đơn":
SELECT * FROM khach k WHERE EXISTS (SELECT 1 FROM don_hang d WHERE d.khach_id=k.id);
SELECT * FROM khach k WHERE k.id IN (SELECT khach_id FROM don_hang);
SELECT DISTINCT k.* FROM khach k JOIN don_hang d ON d.khach_id=k.id;
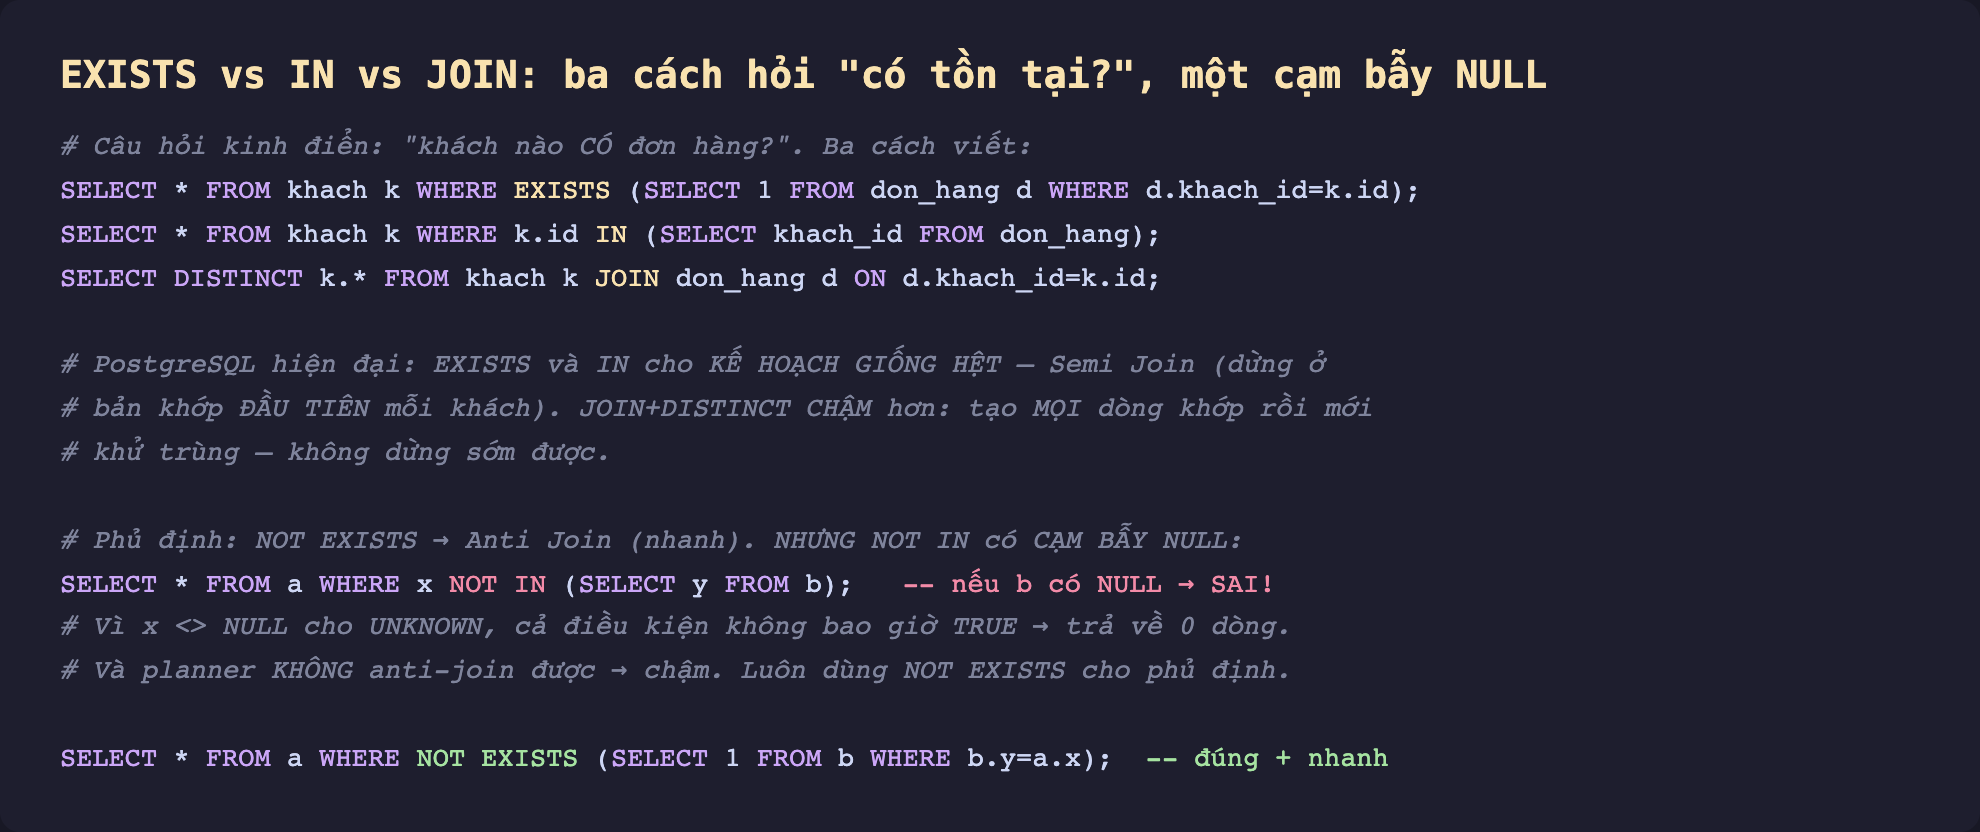
Hình 1: Ba cách viết "có tồn tại". EXISTS và IN cho cùng kế hoạch (semi join); JOIN+DISTINCT chậm hơn; và NOT IN có cạm bẫy NULL — luôn dùng NOT EXISTS cho phủ định.
Kết quả đo:
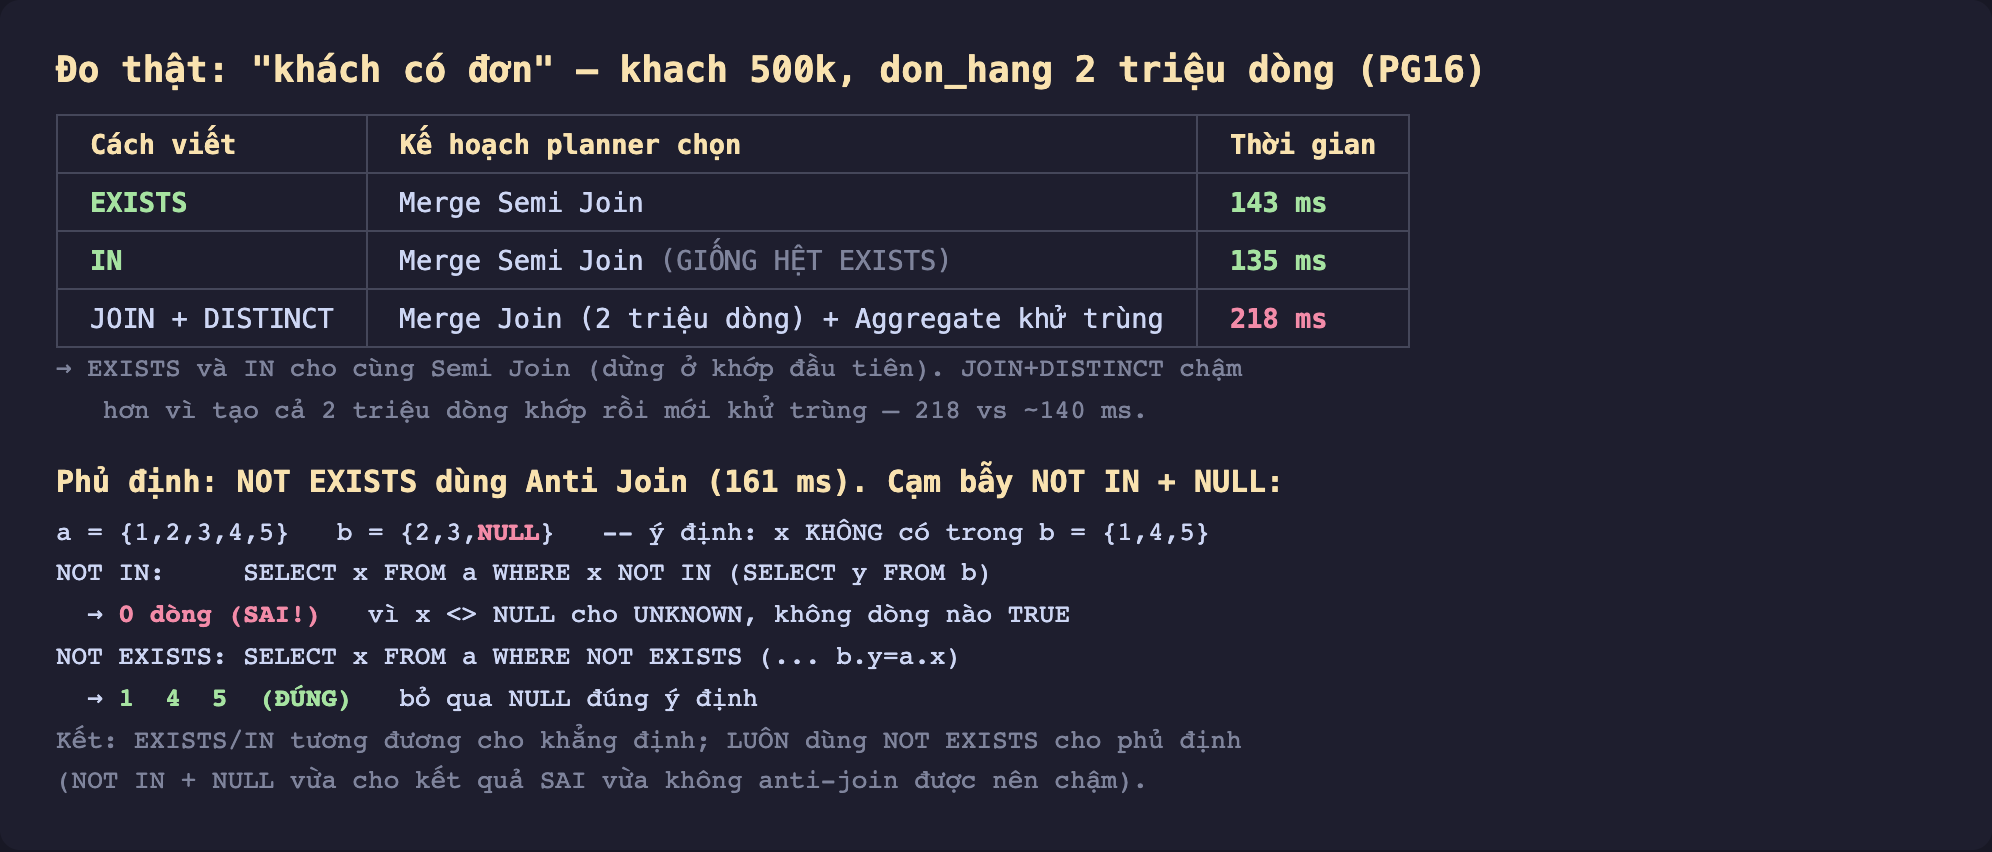
Hình 2: EXISTS 143 ms và IN 135 ms — cùng Merge Semi Join, giống hệt nhau. JOIN+DISTINCT 218 ms — tạo 2 triệu dòng khớp rồi khử trùng. NOT IN với NULL trả về 0 dòng (sai) so với NOT EXISTS đúng.
- EXISTS:
Merge Semi Join, 143 ms. - IN:
Merge Semi Join— kế hoạch y hệt, 135 ms. - JOIN + DISTINCT:
Merge Jointạo 2 triệu dòng khớp rồiAggregatekhử trùng, 218 ms.
Điều bất ngờ dễ chịu: PostgreSQL hiện đại tối ưu EXISTS và IN thành cùng một kế hoạch — semi join. Bạn không cần chọn giữa hai; planner biến chúng thành cùng thứ. "EXISTS nhanh hơn IN" là huyền thoại từ các phiên bản/CSDL cũ.
Semi join là chìa khóa: nó dừng ở bản khớp đầu tiên cho mỗi khách — không cần tìm hết đơn của khách đó, chỉ cần biết có ít nhất một. JOIN + DISTINCT không làm được vậy: nó tạo mọi cặp khớp (cả 2 triệu dòng) rồi mới khử trùng, nên chậm hơn.
Phủ định và cạm bẫy NOT IN với NULL
Với câu hỏi ngược "khách không có đơn", NOT EXISTS dùng anti join (đo thật 161 ms) — hiệu quả tương tự semi join. Nhưng NOT IN ẩn một cạm bẫy nguy hiểm nhất trong bài này.
Xét ví dụ nhỏ: a = {1,2,3,4,5}, b = {2,3,NULL}. Ý định: tìm các x không có trong b, mong đợi {1,4,5}:
SELECT x FROM a WHERE x NOT IN (SELECT y FROM b);   -- trả về 0 dòng (SAI!)
SELECT x FROM a WHERE NOT EXISTS (SELECT 1 FROM b WHERE b.y=a.x);  -- 1,4,5 (ĐÚNG)
NOT IN trả về 0 dòng — sai hoàn toàn. Vì sao? x NOT IN (2, 3, NULL) tương đương x<>2 AND x<>3 AND x<>NULL. Mà x<>NULL luôn cho UNKNOWN (không phải TRUE), nên cả biểu thức không bao giờ TRUE — không dòng nào lọt. Chỉ cần một NULL trong tập con, NOT IN trả về rỗng.
Đây là lỗi lặng lẽ: không có thông báo lỗi, truy vấn chạy bình thường, chỉ là kết quả sai. Trên production nó âm thầm bỏ sót dữ liệu. Và tệ hơn, planner không anti-join được NOT IN khi có thể có NULL, nên nó cũng chậm.
Quy tắc: luôn dùng NOT EXISTS cho phủ định. Nó đúng ngữ nghĩa (bỏ qua NULL đúng ý định), và được tối ưu thành anti join nhanh.
Đánh đổi và khi nào chọn cái nào
EXISTS/IN tương đương — chọn theo tính dễ đọc. Vì cùng kế hoạch, dùng cái nào rõ nghĩa hơn với truy vấn của bạn. EXISTS với điều kiện tương quan phức tạp thường dễ đọc; IN với danh sách hằng (IN (1,2,3)) tự nhiên hơn.
JOIN khi bạn cần cột từ bảng kia. Nếu ngoài việc kiểm tồn tại, bạn còn cần dữ liệu từ don_hang (tổng tiền, đơn mới nhất), thì JOIN là đúng — nhưng khi đó không cần DISTINCT nếu quan hệ một-một, và cẩn thận nhân dòng nếu một-nhiều. Chỉ dùng JOIN + DISTINCT để kiểm tồn tại là lãng phí.
NOT IN chỉ an toàn khi cột chắc chắn NOT NULL. Nếu cột trong subquery có ràng buộc NOT NULL, NOT IN không dính bẫy. Nhưng dựa vào điều đó là mong manh — thêm một dòng NULL sau này làm hỏng lặng lẽ. NOT EXISTS an toàn trong mọi trường hợp, nên cứ mặc định dùng nó.
Ba ý mang về
- EXISTS và IN cho kế hoạch giống hệt trong PostgreSQL hiện đại — cùng
Semi Joindừng ở khớp đầu tiên (đo thật 143 và 135 ms); "EXISTS nhanh hơn IN" là huyền thoại cũ, chọn cái dễ đọc hơn. - JOIN + DISTINCT chậm hơn để kiểm tồn tại (218 ms) vì tạo mọi dòng khớp rồi mới khử trùng, không dừng sớm được — chỉ JOIN khi thật sự cần cột từ bảng kia.
- NOT IN với NULL cho kết quả sai lặng lẽ (trả về 0 dòng vì
x<>NULLlà UNKNOWN) và không anti-join được — luôn dùngNOT EXISTScho phủ định, nó vừa đúng vừa nhanh (anti join).
Phần sau ta xét một cấu trúc SQL vừa làm code sạch vừa có cạm bẫy hiệu năng tinh vi: Phần sau mổ xẻ CTE (WITH) — khi nào PostgreSQL "materialize" nó thành rào chắn tối ưu, và thay đổi lớn ở PG12.
