Truy vấn của bạn hay lọc WHERE kh_id = ? AND trang_thai = ?. Bạn nên tạo hai index đơn cột — một cho kh_id, một cho trang_thai — hay một index ghép chứa cả hai? Câu trả lời không hiển nhiên, và chọn sai để lại hoặc index chậm hoặc index thừa. Bài này đo cả hai trên bảng 3 triệu dòng, rồi làm rõ luật quan trọng nhất khi dùng index ghép: thứ tự cột.
Đo thật: index ghép nhanh gấp 4 lần
Bảng dh (đơn hàng) 3 triệu dòng. Truy vấn WHERE kh_id = 42 AND trang_thai = 3 khớp 32 dòng (kh_id = 42 khớp 277, trang_thai = 3 khớp 374.473). So hai cách:
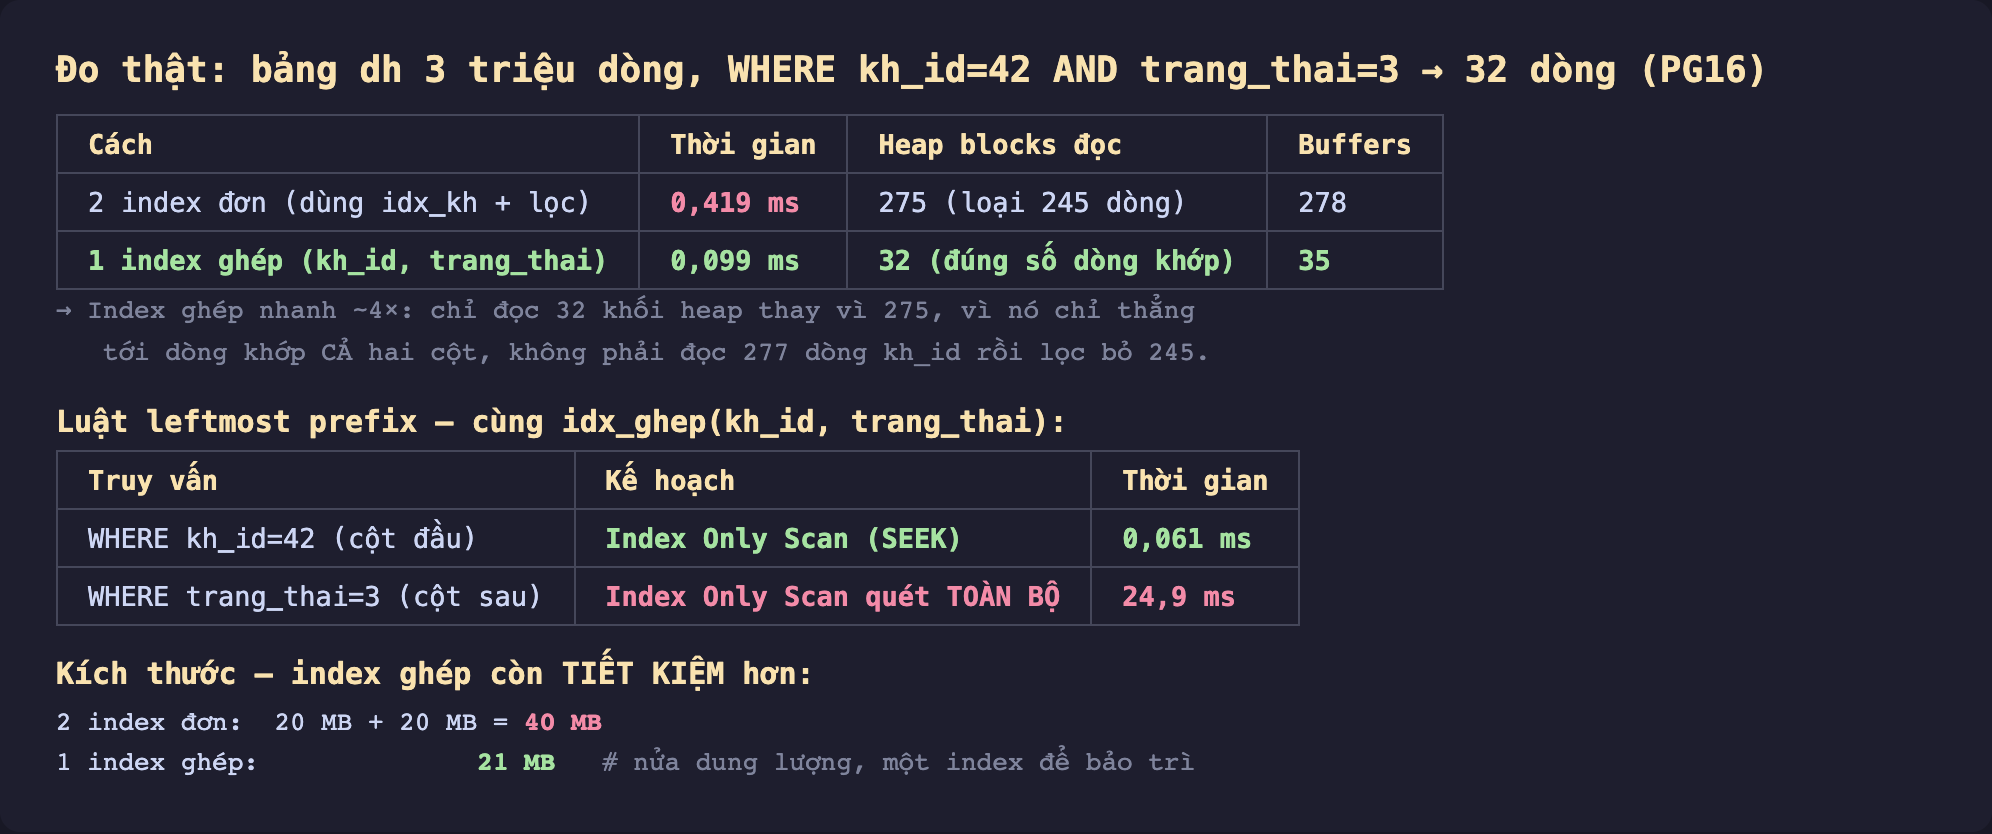
Hình 1: Cùng truy vấn AND hai cột. Hai index đơn: planner dùng idx_kh (277 dòng) rồi lọc bỏ 245 — 0,419 ms, đọc 275 khối heap. Một index ghép: chỉ thẳng tới 32 dòng khớp — 0,099 ms, đọc 32 khối. Nhanh ~4 lần.
Điểm mấu chốt nằm ở cột "Heap blocks đọc":
- Hai index đơn: PostgreSQL chọn index chọn lọc hơn (
idx_kh, vìkh_id = 42chỉ 277 dòng), đọc cả 277 dòng đó từ heap, rồi lọc bỏ 245 dòng cótrang_thai ≠ 3. Kết quả 0,419 ms, 278 buffers. - Một index ghép
(kh_id, trang_thai): index đã sắp theo cả hai cột, nên nó chỉ thẳng tới đúng 32 dòng khớp cả hai điều kiện — đọc đúng 32 khối heap. Kết quả 0,099 ms, 35 buffers.
Index ghép không phải đọc thừa 245 dòng rồi vứt đi. Với truy vấn khớp cả hai cột, nó luôn thắng.
Luật quyết định tất cả: leftmost prefix
Nhưng index ghép có một ràng buộc mà nếu không hiểu sẽ tạo index vô dụng: luật leftmost prefix (tiền tố trái nhất). Một index ghép (a, b) được sắp theo a trước, rồi b trong từng nhóm a. Nghĩa là nó seek nhanh được khi truy vấn dùng a (cột đầu), nhưng không seek được khi truy vấn chỉ dùng b (cột sau) — vì b nằm rải rác khắp index.
Đo thật trên cùng idx_ghep(kh_id, trang_thai):
WHERE kh_id = 42(cột đầu): Index Only Scan có seek, 0,061 ms.WHERE trang_thai = 3(cột sau, bỏ qua cột đầu): index không seek được, phải quét toàn bộ index — 24,9 ms, chậm hơn 400 lần.
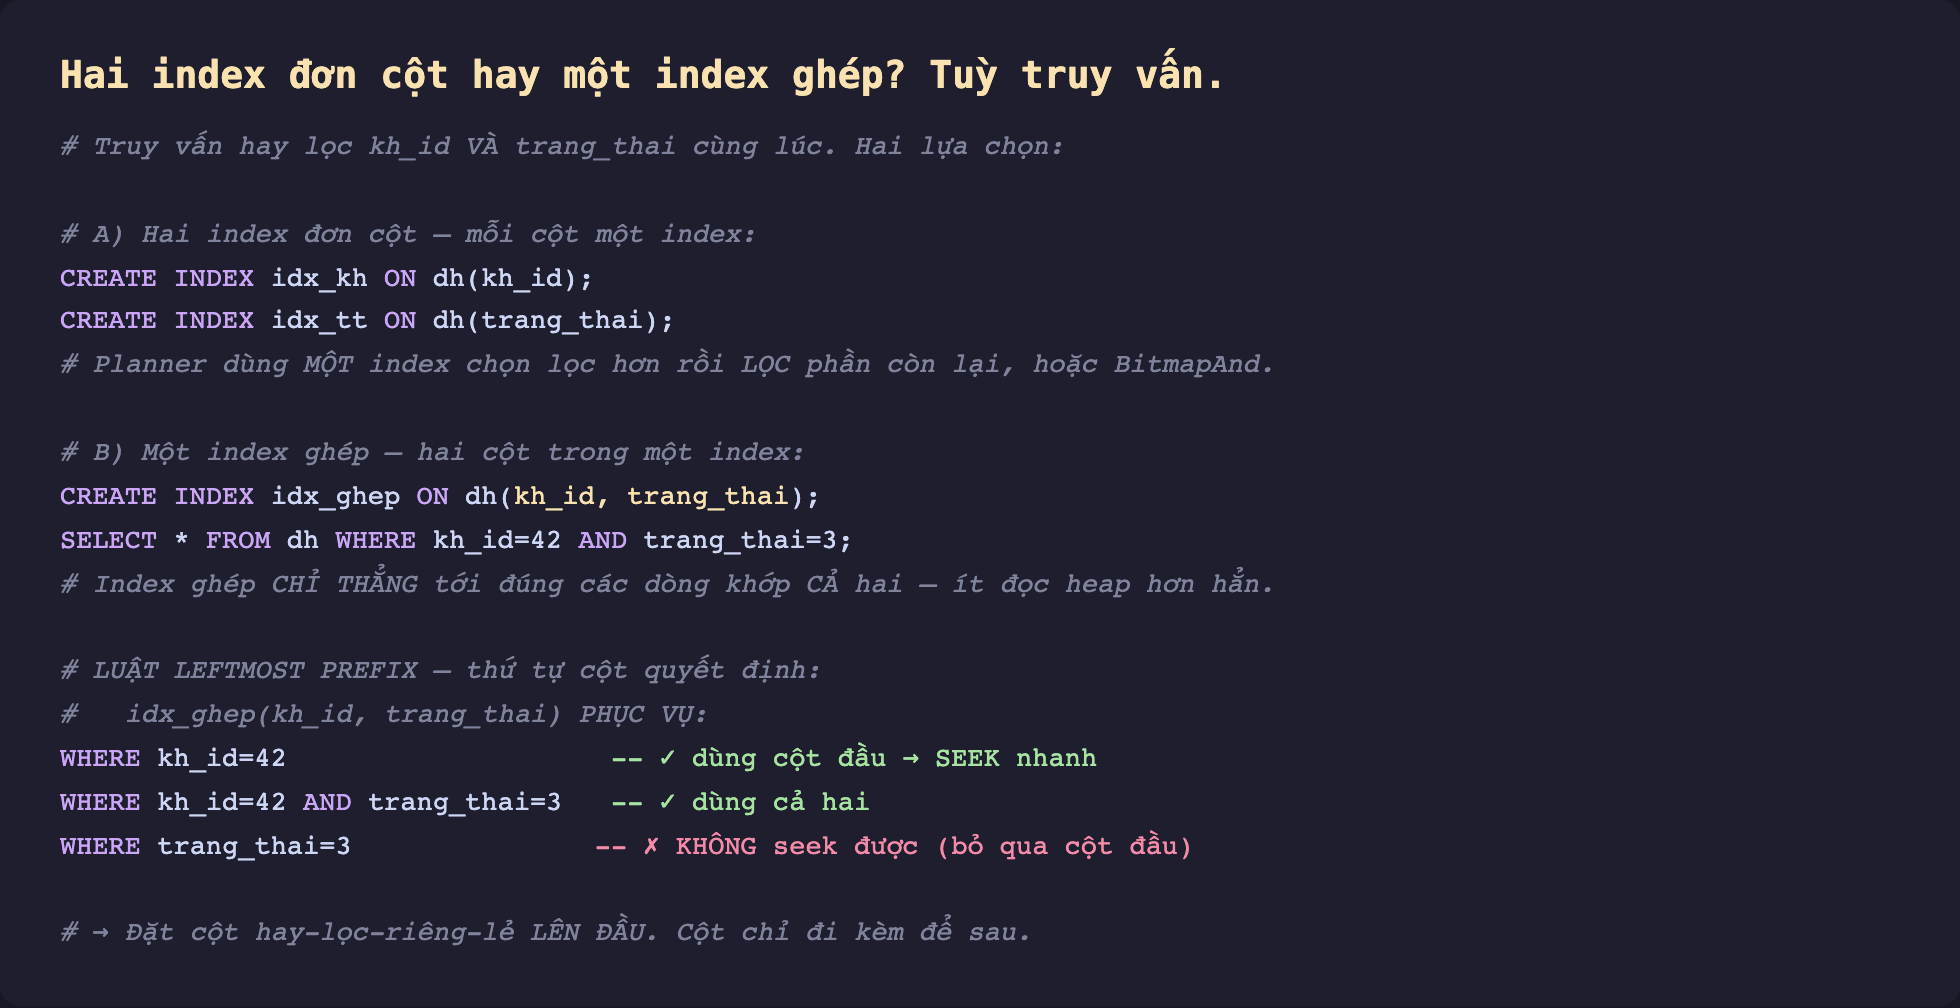
Hình 2: Luật leftmost prefix. idx_ghep(kh_id, trang_thai) phục vụ WHERE kh_id, WHERE kh_id AND trang_thai, nhưng không seek được WHERE trang_thai một mình. Đặt cột hay được lọc riêng lẻ lên đầu.
Đây là quy tắc đặt thứ tự cột: cột nào hay được lọc riêng lẻ thì đặt lên đầu. Nếu bạn hay tra kh_id một mình và tra kh_id + trang_thai, thì (kh_id, trang_thai) phục vụ cả hai. Nhưng nếu bạn cũng hay tra trang_thai một mình, index ghép này không giúp gì cho nó — khi đó cân nhắc thêm một index riêng cho trang_thai, hoặc đảo thứ tự tùy truy vấn nào quan trọng hơn.
Index ghép còn tiết kiệm dung lượng
Một điểm cộng bất ngờ: index ghép nhỏ hơn hai index đơn. Đo thật:
- Hai index đơn:
idx_kh20 MB +idx_tt20 MB = 40 MB. - Một index ghép: 21 MB.
Chỉ bằng một nửa. Vì hai index đơn mỗi cái phải lưu riêng con trỏ dòng (ctid) cho từng dòng — trùng lặp; index ghép lưu một bộ con trỏ duy nhất. Cộng thêm, chỉ có một index để cập nhật khi ghi (rẻ hơn cho INSERT/UPDATE) và một index để bảo trì.
Đánh đổi và khi nào chọn cái nào
Index ghép thắng khi truy vấn hay lọc các cột đó cùng nhau. Nếu kh_id và trang_thai gần như luôn xuất hiện chung trong WHERE, index ghép là lựa chọn rõ ràng: nhanh hơn, nhỏ hơn, ít bảo trì hơn.
Hai index đơn linh hoạt hơn khi các cột được lọc độc lập. Nếu lúc thì tra kh_id một mình, lúc thì trang_thai một mình, lúc thì cả hai, hai index đơn phục vụ được mọi kiểu (và planner có thể BitmapAnd chúng khi cần cả hai) — dù mỗi trường hợp riêng lẻ không nhanh bằng index ghép chuyên dụng.
Đừng tạo cả hai kiểu cho cùng bộ cột. Có idx_ghep(kh_id, trang_thai) rồi thì idx_kh(kh_id) thường thừa — vì index ghép đã phục vụ WHERE kh_id nhờ luật leftmost. Giữ thêm idx_kh chỉ tổ tốn chi phí ghi. Kiểm bằng pg_stat_user_indexes như bài trước.
Ba ý mang về
- Với truy vấn lọc nhiều cột cùng lúc, một index ghép thắng hai index đơn: đo thật, 0,099 ms so với 0,419 ms (~4 lần) vì nó chỉ thẳng tới dòng khớp cả hai cột thay vì đọc thừa rồi lọc — và còn nhỏ hơn (21 MB so với 40 MB).
- Luật leftmost prefix quyết định thứ tự cột: index ghép
(a, b)seek đượcWHERE avàWHERE a AND b(0,061 ms) nhưng không seek đượcWHERE bmột mình (24,9 ms) — đặt cột hay lọc riêng lẻ lên đầu. - Chọn theo cách truy vấn dùng cột: lọc chung → index ghép; lọc độc lập → hai index đơn; và đừng giữ index đơn cho cột đã là tiền tố trái của một index ghép.
Phần sau ta lùi lại một bước để đọc kỹ chính các kiểu quét mà EXPLAIN in ra: Phần sau so sánh Seq Scan, Index Scan và Bitmap Heap Scan — mỗi loại nhanh ở đâu và planner chọn thế nào.
