Bạn thấy Seq Scan trong EXPLAIN và giật mình: "có index sao nó không dùng?". Trước khi vội thêm index hay ép planner, cần hiểu điều này: PostgreSQL chọn kiểu quét theo số dòng truy vấn trả về, chứ không phải theo việc có index hay không. Ba kiểu quét chính — Seq Scan, Index Scan, Bitmap Heap Scan — mỗi cái thắng ở một vùng, và planner tính toán để chọn đúng. Bài này đo cả ba trên bảng 3 triệu dòng và chứng minh vì sao đôi khi Seq Scan mới là lựa chọn nhanh nhất.
Ba kiểu quét, ba vùng thắng
Cùng bảng sanpham 3 triệu dòng (219 MB), cùng cột gia có index. Thay đổi độ rộng khoảng lọc để lấy ít hay nhiều dòng, planner chọn kiểu quét khác nhau:
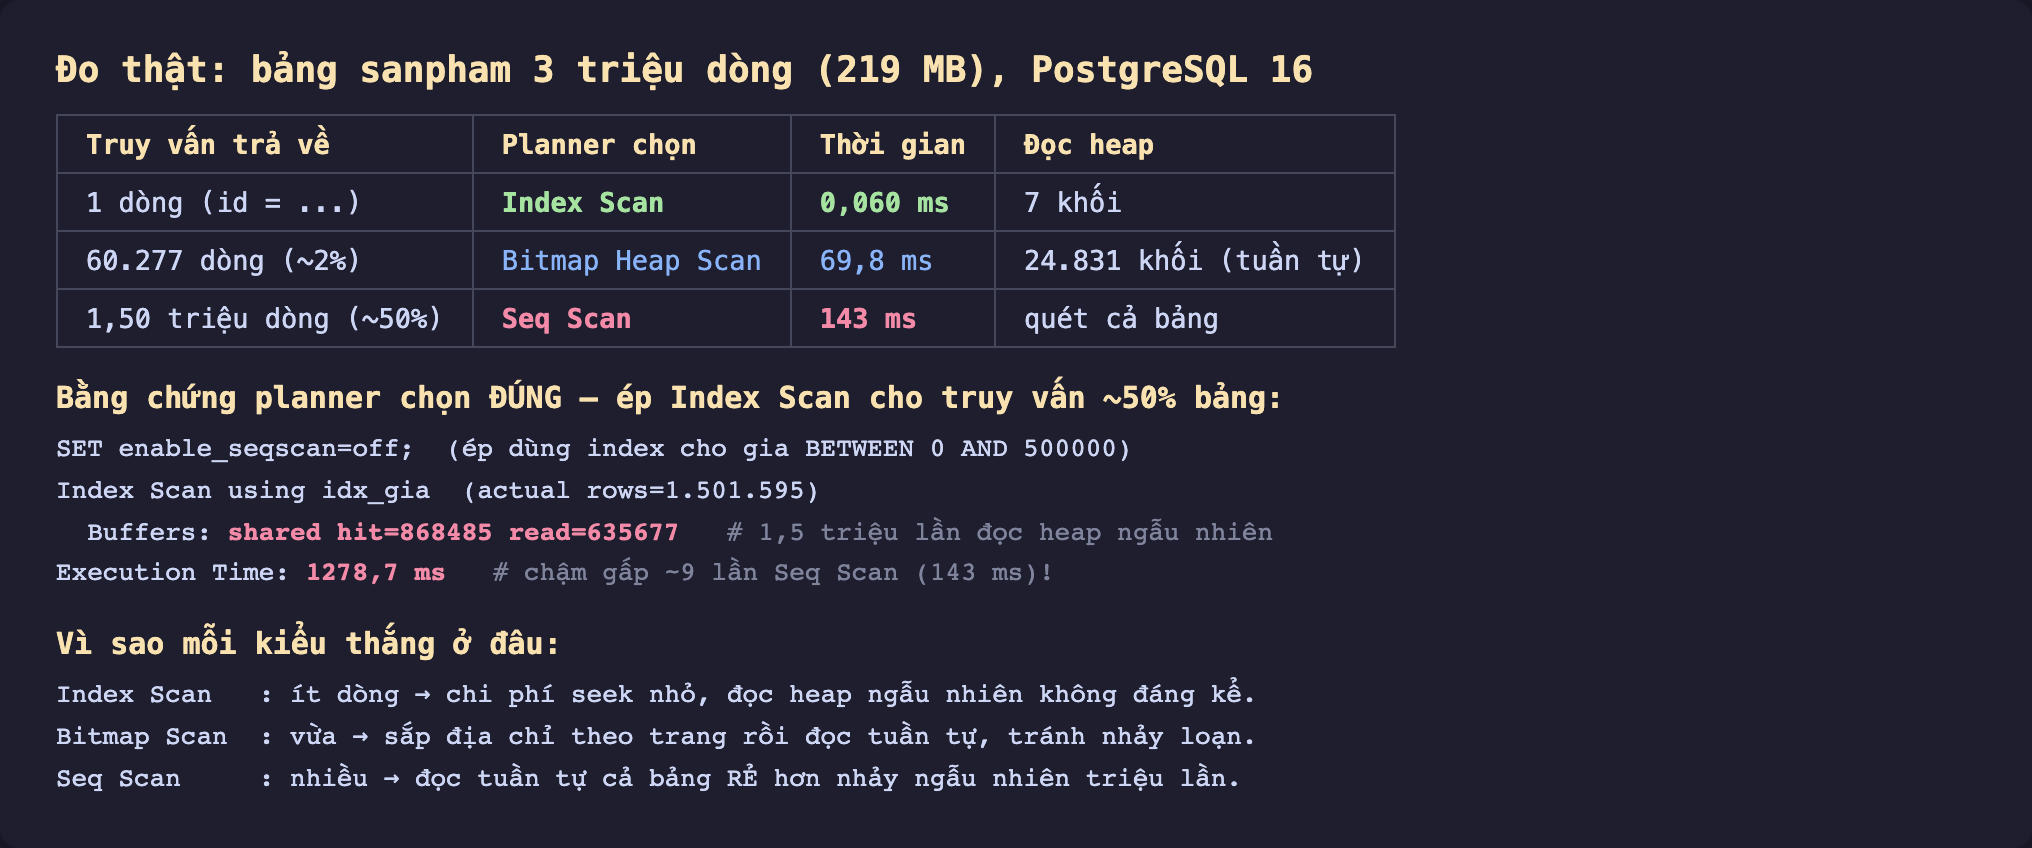
Hình 1: Cùng bảng, cùng index. 1 dòng → Index Scan (0,060 ms). ~2% (60.277 dòng) → Bitmap Heap Scan (69,8 ms). ~50% (1,5 triệu dòng) → Seq Scan (143 ms). Planner đổi kiểu quét theo số dòng, không theo việc có index.
Index Scan (lấy rất ít dòng): PostgreSQL đi thẳng trong cây index tới từng dòng khớp, rồi đọc dòng đó từ heap. Với 1 dòng, chỉ chạm 7 khối, xong trong 0,060 ms. Đây là kiểu nhanh nhất — khi số dòng đủ ít.
Bitmap Heap Scan (lấy số vừa, rải rác): với 60.277 dòng nằm rải khắp bảng, đi từng dòng theo thứ tự index sẽ khiến địa chỉ heap nhảy loạn (đọc ngẫu nhiên, đắt). Thay vào đó PostgreSQL dựng một bitmap các dòng khớp, sắp theo thứ tự trang, rồi đọc heap tuần tự — 24.831 khối theo thứ tự, 69,8 ms.
Seq Scan (lấy phần lớn bảng): với 1,5 triệu dòng (~50%), planner bỏ hẳn index và quét thẳng cả bảng theo thứ tự đĩa — 143 ms. Nghe phản trực giác, nhưng đây là lựa chọn đúng.
SELECT * FROM sanpham WHERE id = 1234567;                     -- Index Scan
SELECT * FROM sanpham WHERE gia BETWEEN 500000 AND 520000;    -- Bitmap Heap Scan
SELECT * FROM sanpham WHERE gia BETWEEN 0 AND 500000;         -- Seq Scan
Vì sao Seq Scan lại thắng khi lấy nửa bảng
Đây là phần quan trọng nhất, và đo thật chứng minh rõ ràng. Ép PostgreSQL dùng index cho truy vấn lấy ~50% bảng (SET enable_seqscan = off):
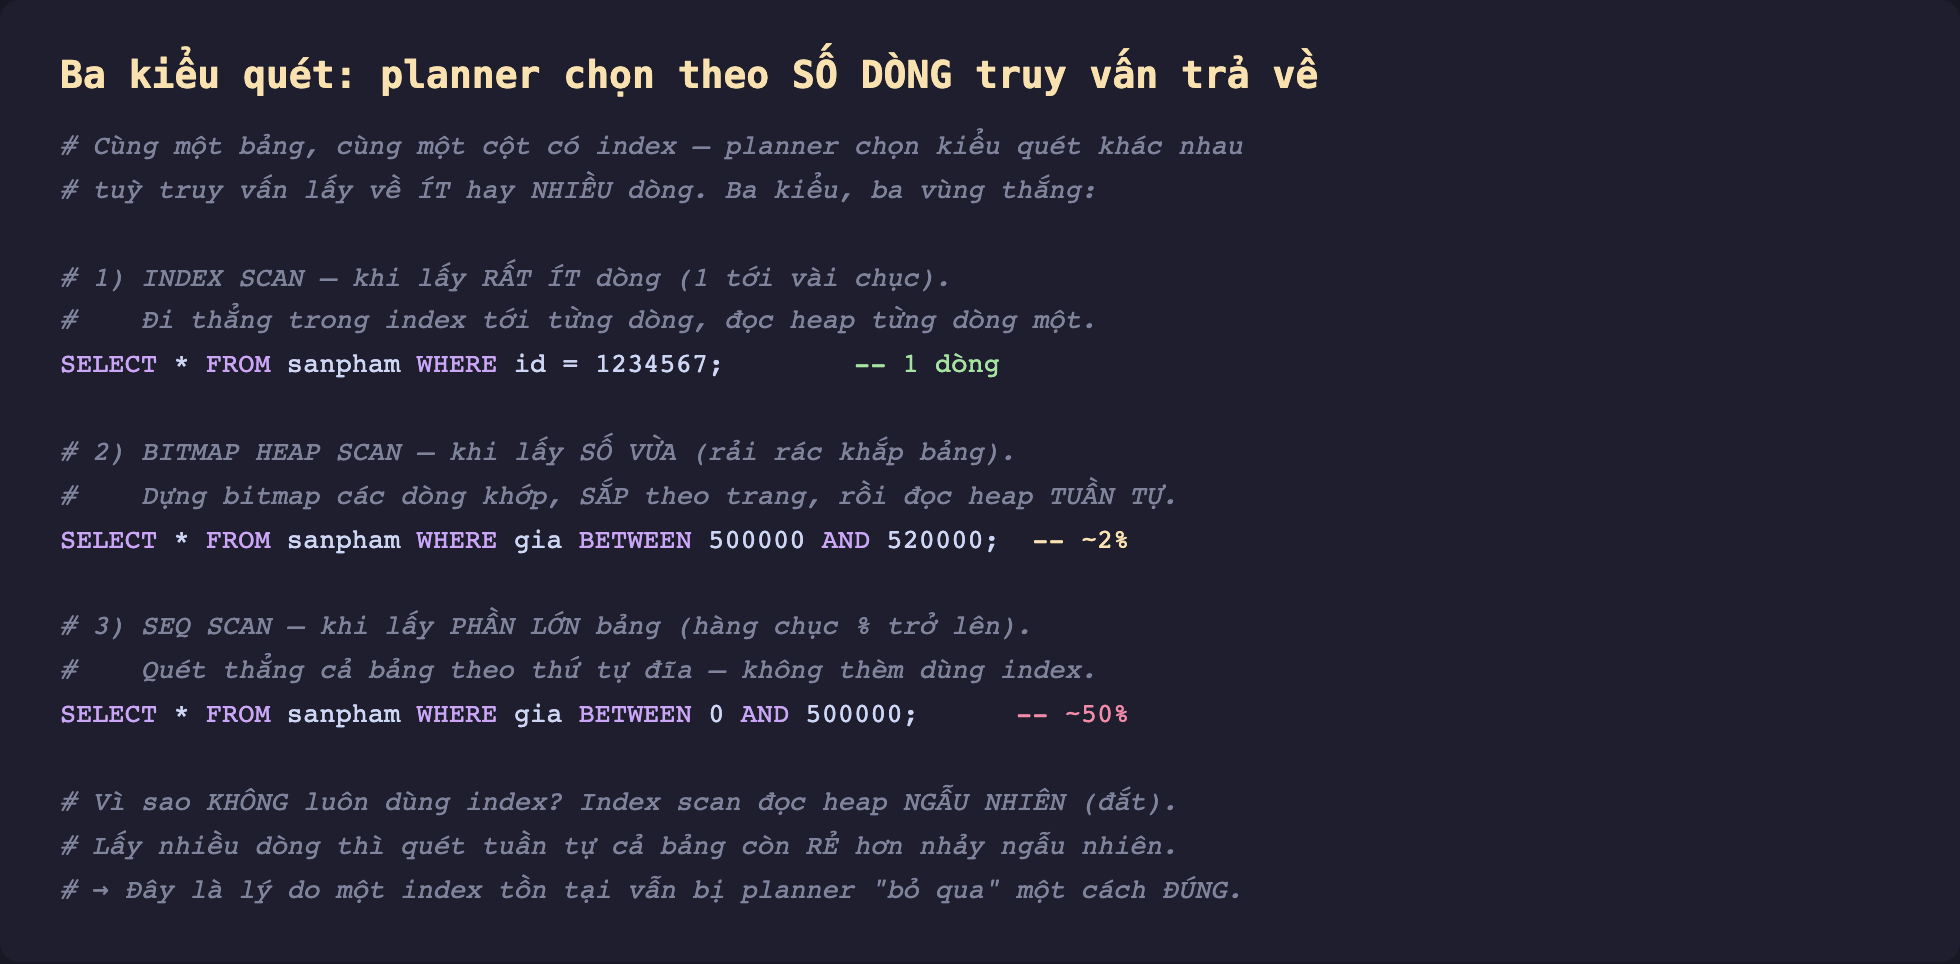
Hình 2: Ba kiểu quét và vùng thắng của từng cái. Index scan đọc heap ngẫu nhiên (đắt); khi lấy nhiều dòng, quét tuần tự cả bảng rẻ hơn — đó là lý do planner "bỏ qua" index một cách đúng.
Kết quả ép index scan: 1.278 ms — chậm gấp gần 9 lần so với Seq Scan (143 ms). Nhìn Buffers: shared hit=868485 read=635677: index scan phải thực hiện 1,5 triệu lần đọc heap ngẫu nhiên, mỗi dòng một lần nhảy tới một trang có thể bất kỳ. Seq Scan chỉ đọc mỗi trang đúng một lần, theo thứ tự — đó là truy cập tuần tự, mà PostgreSQL định giá seq_page_cost = 1 so với random_page_cost = 4 cho truy cập ngẫu nhiên.
Nói cách khác: khi bạn lấy phần lớn bảng, gần như mọi trang đều chứa dòng bạn cần. Đọc tuần tự cả bảng một lượt rẻ hơn nhiều so với dùng index để nhảy tới từng dòng theo thứ tự lung tung. Planner biết điều này qua thống kê, và chọn Seq Scan một cách đúng đắn — không phải vì "quên" index.
Đọc EXPLAIN cho đúng
Ba dấu hiệu để nhận ra planner đang làm gì:
Thấy Seq Scan không phải lúc nào cũng xấu. Nếu truy vấn thật sự lấy phần lớn bảng, Seq Scan là đúng. Chỉ lo khi thấy Seq Scan kèm Rows Removed by Filter lớn và kết quả trả về ít — đó mới là dấu hiệu thiếu index.
Bitmap Heap Scan là vùng trung gian tự nhiên. Thấy nó nghĩa là truy vấn lấy "vừa đủ nhiều để index scan không đáng, vừa đủ ít để không cần seq scan". Kèm Heap Blocks: exact=N cho biết đọc bao nhiêu trang.
Ước lượng dòng sai là gốc của kế hoạch tệ. Planner chọn dựa trên ước lượng số dòng. Nếu EXPLAIN ANALYZE cho thấy rows ước lượng lệch xa actual rows, planner có thể chọn nhầm kiểu quét — khi đó cần ANALYZE lại bảng để cập nhật thống kê (chủ đề của các bài sau).
Ba ý mang về
- Planner chọn kiểu quét theo số dòng trả về, không theo việc có index: đo thật, cùng bảng cho Index Scan (1 dòng, 0,060 ms), Bitmap Heap Scan (~2%, 69,8 ms), Seq Scan (~50%, 143 ms).
- Seq Scan thắng khi lấy phần lớn bảng vì đọc tuần tự rẻ hơn đọc ngẫu nhiên: ép index scan cho truy vấn ~50% bảng mất 1.278 ms — chậm gấp 9 lần Seq Scan vì 1,5 triệu lần đọc heap ngẫu nhiên.
Seq Scantrong EXPLAIN không đồng nghĩa với "thiếu index" — chỉ đáng lo khi kết quả ít mà vẫn Seq Scan kèmRows Removed by Filterlớn; và kế hoạch tệ thường bắt nguồn từ ước lượng dòng sai.
Phần sau ta bước sang cách PostgreSQL nối hai bảng: Phần sau mổ xẻ Nested Loop Join — kiểu join đơn giản nhất, khi nào nó nhanh và khi nào thành thảm họa.
