Ba bài trước ta thấy mỗi index đánh thuế lên mọi lần ghi, phình theo thời gian, và tốn công bảo trì. Vậy điều tệ nhất là gì? Một index gánh toàn bộ chi phí đó mà không truy vấn nào dùng tới. Nó chỉ nằm đó, làm chậm INSERT/UPDATE, chiếm dung lượng và bộ nhớ đệm, đổi lại con số không. May thay, PostgreSQL đếm chính xác từng lần mỗi index được dùng — nên tìm ra "index vô công" là chuyện đơn giản. Bài này đo thật cách làm.
PostgreSQL đếm mọi lần index được dùng
Mỗi khi một index được planner chọn để chạy một truy vấn, PostgreSQL tăng bộ đếm idx_scan của index đó trong view pg_stat_user_indexes. idx_scan = 0 nghĩa là: từ lần reset thống kê gần nhất tới giờ, chưa truy vấn nào dùng index này.
Thử nghiệm: tạo bảng khách hàng 2 triệu dòng với 5 index, reset thống kê, rồi chạy một tải chỉ tra theo email và sdt. Sau đó soi pg_stat_user_indexes:
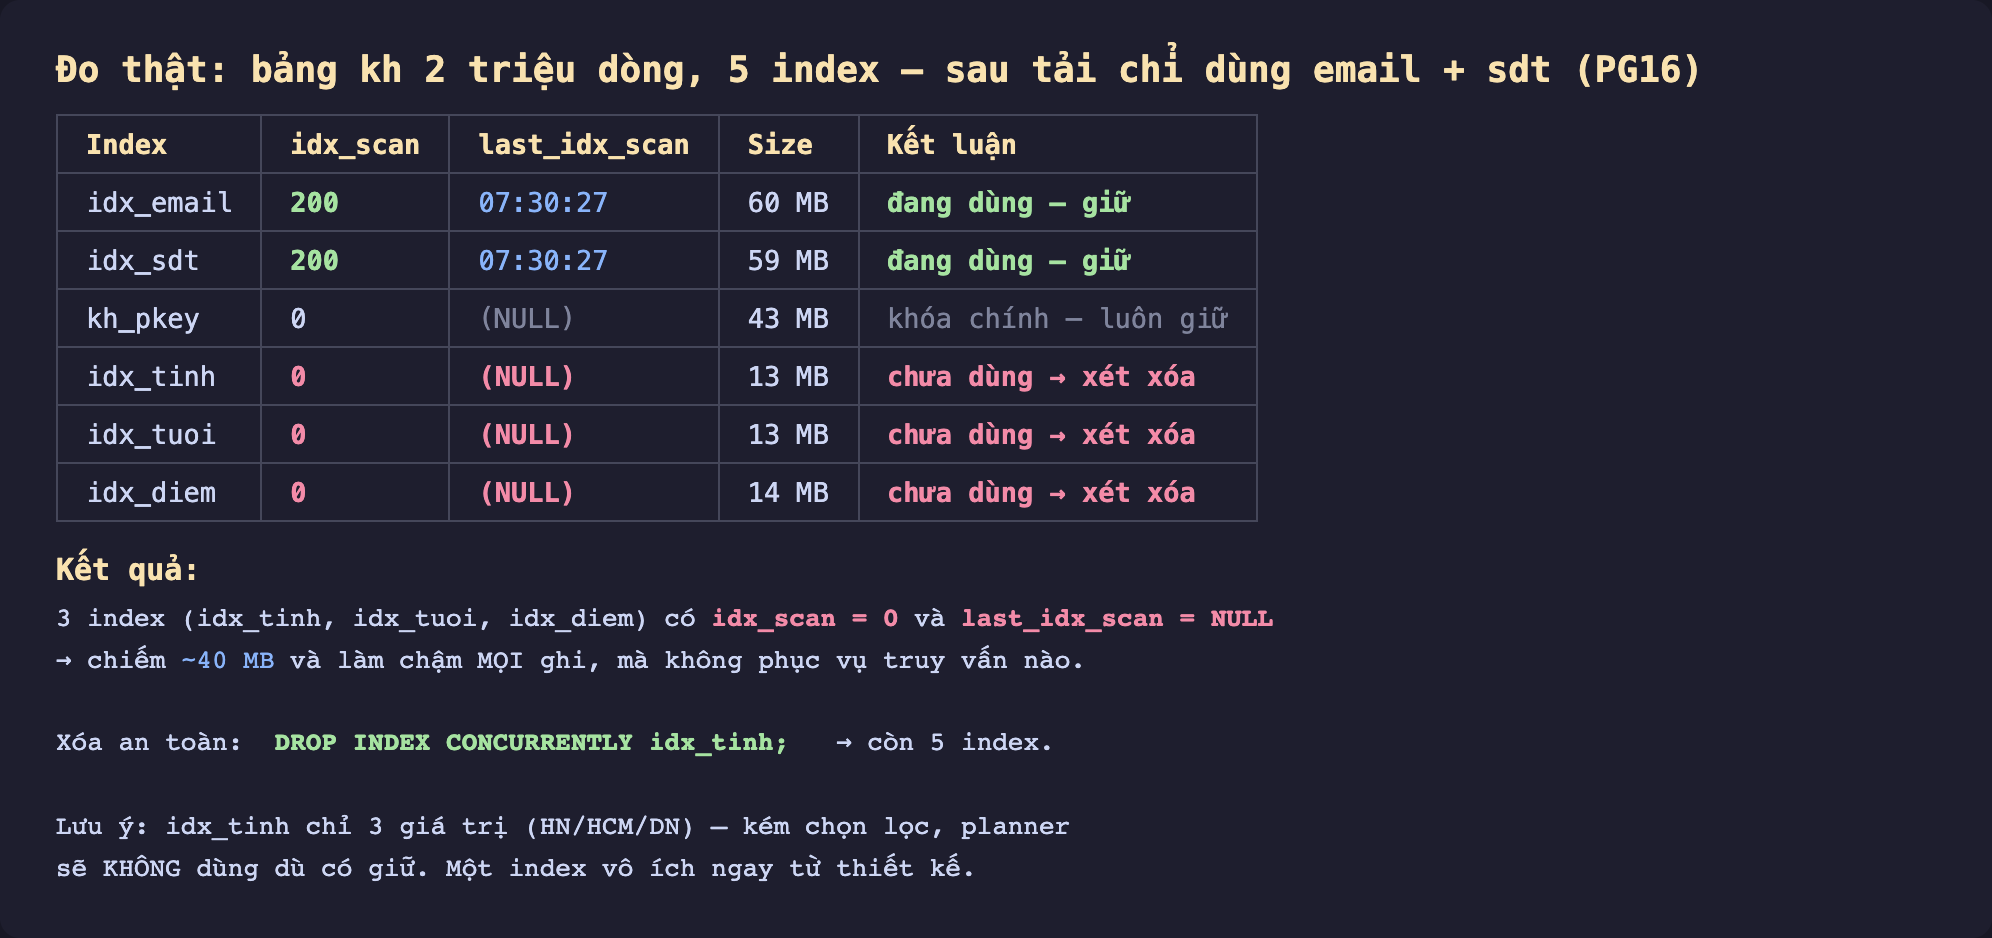
Hình 1: Sau tải, idx_email và idx_sdt mỗi cái 200 lần dùng; ba index idx_tinh, idx_tuoi, idx_diem có idx_scan = 0 và last_idx_scan = NULL — chưa bao giờ được dùng, chiếm ~40 MB và làm chậm mọi ghi.
Ba index kia — idx_tinh, idx_tuoi, idx_diem — hoàn toàn không được chạm tới. Chúng chiếm ~40 MB và, quan trọng hơn, mỗi lần INSERT/UPDATE vào bảng đều phải cập nhật cả ba, không đổi lại lợi ích đọc nào.
Câu truy vấn phát hiện, và cột mới của PostgreSQL 16
Câu tìm index thừa cần loại trừ index của ràng buộc — khóa chính và unique không được xóa dù idx_scan = 0, vì chúng cưỡng chế tính đúng đắn dữ liệu chứ không phải để tăng tốc đọc:
SELECT s.indexrelname, s.idx_scan,
       pg_size_pretty(pg_relation_size(s.indexrelid)) AS size
FROM pg_stat_user_indexes s
JOIN pg_index i ON i.indexrelid = s.indexrelid
WHERE s.idx_scan = 0
  AND NOT i.indisprimary      -- giữ khóa chính
  AND NOT i.indisunique       -- giữ index cưỡng chế UNIQUE
ORDER BY pg_relation_size(s.indexrelid) DESC;
PostgreSQL 16 thêm một cột đắt giá: last_idx_scan — thời điểm index được dùng lần cuối, hoặc NULL nếu chưa bao giờ. Trước PG16 bạn chỉ biết idx_scan = 0 mà không rõ "bằng 0 vì thống kê mới reset" hay "thực sự chưa từng dùng". Giờ last_idx_scan = NULL xác nhận nó chưa bao giờ được dùng kể từ khi thống kê bắt đầu.
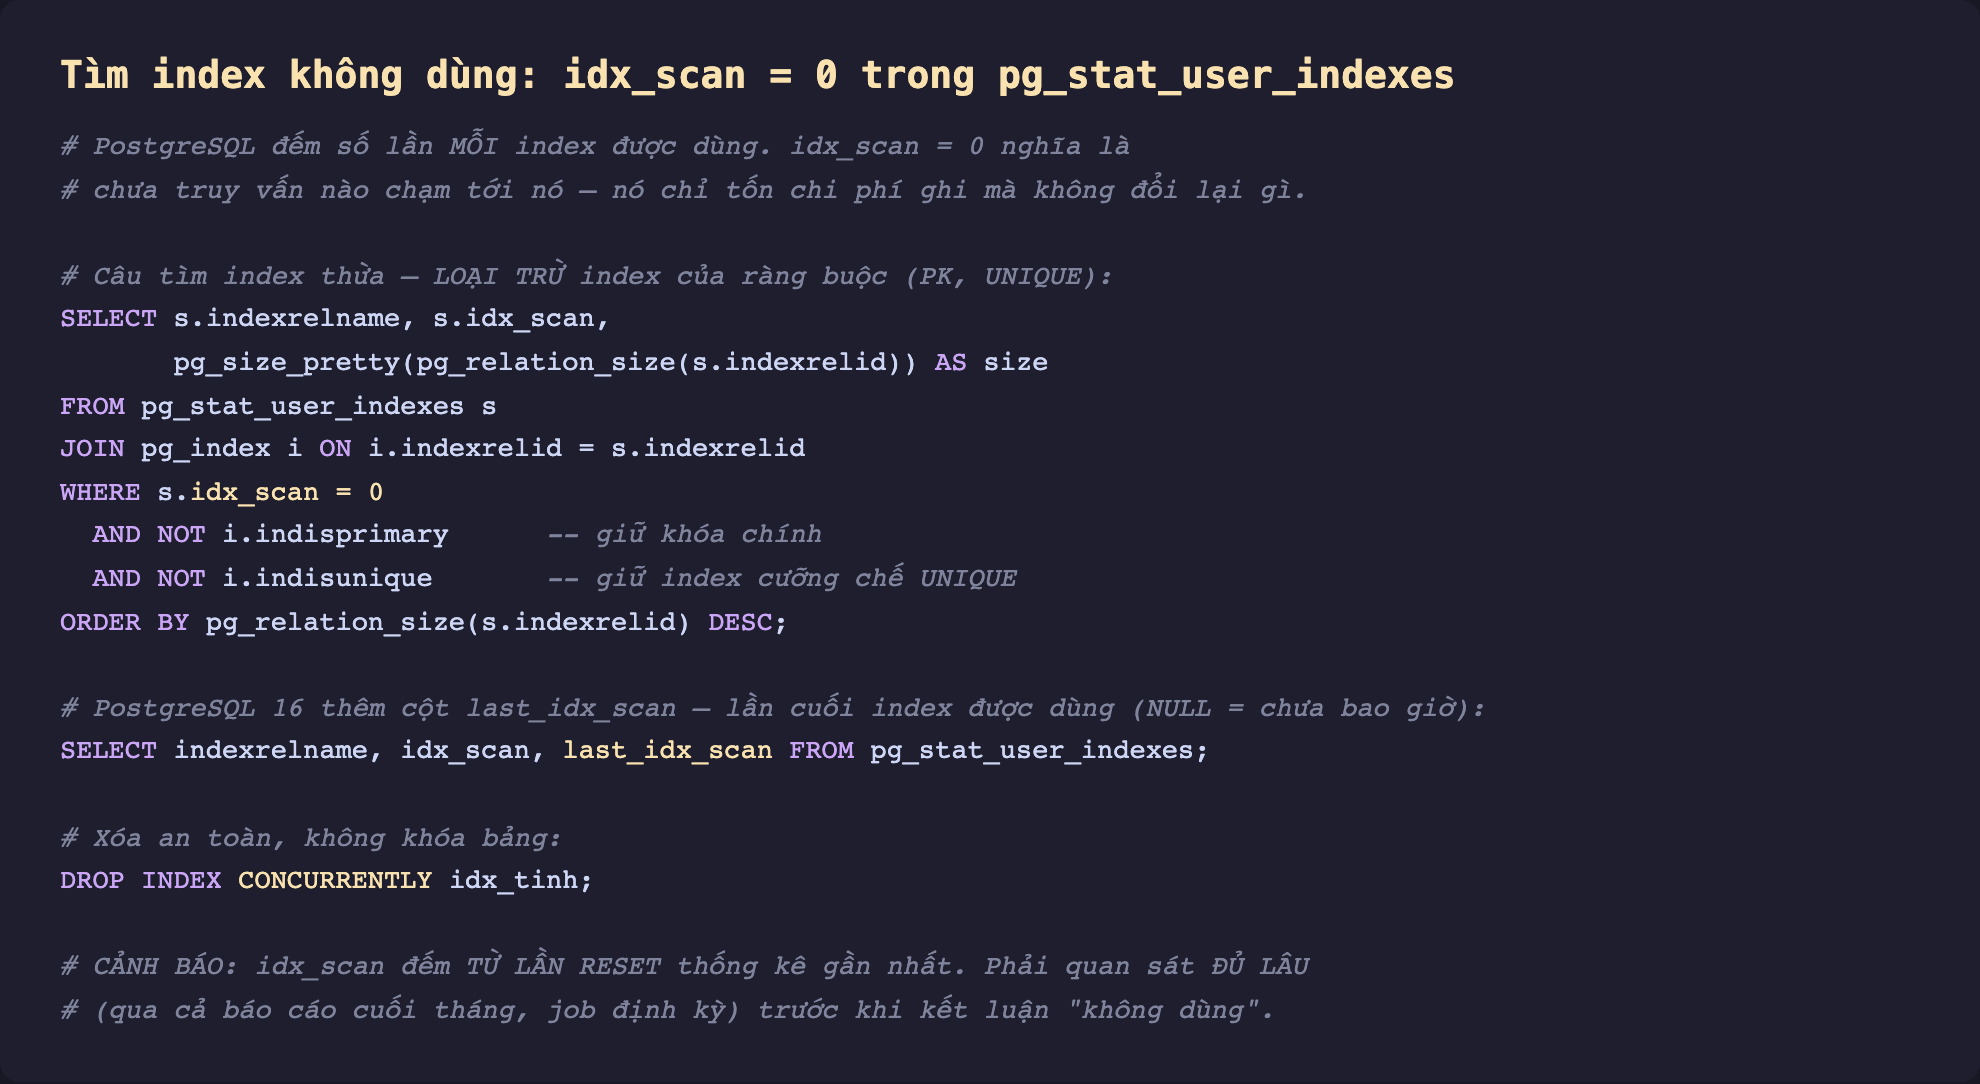
Hình 2: Câu phát hiện index thừa loại trừ indisprimary và indisunique; PostgreSQL 16 bổ sung last_idx_scan. Xóa an toàn bằng DROP INDEX CONCURRENTLY.
Xóa an toàn
Như bài về CONCURRENTLY đã nói, DROP INDEX thường lấy AccessExclusiveLock khóa cả bảng. Dùng DROP INDEX CONCURRENTLY để xóa mà không chặn truy vấn:
DROP INDEX CONCURRENTLY idx_tinh;
Một ví dụ đáng chú ý từ dữ liệu: idx_tinh đánh trên cột tinh chỉ có 3 giá trị (HN/HCM/DN). Đây là index vô ích ngay từ thiết kế — như bài về độ chọn lọc đã đo, planner sẽ chọn seq scan thay vì index khi mỗi giá trị khớp cả phần ba bảng. Nó không bao giờ được dùng dù bạn giữ. Xóa nó là dọn sạch một sai lầm thiết kế.
Cạm bẫy: đừng kết luận vội
Đây là phần quan trọng nhất — xóa nhầm một index đang dùng có thể làm sập hiệu năng production:
idx_scan chỉ đếm từ lần reset thống kê gần nhất. Nếu ai đó vừa chạy pg_stat_reset() hôm qua, mọi index sẽ trông như chưa dùng. Phải biết thống kê được tích lũy từ bao giờ (stats_reset trong pg_stat_database) và quan sát đủ lâu.
Quan sát phải bao trọn mọi chu kỳ. Một index có thể chỉ được dùng bởi báo cáo cuối tháng, job dọn dữ liệu hàng quý, hay truy vấn admin hiếm hoi. Quan sát một tuần rồi xóa có thể giết đúng index mà báo cáo cuối tháng cần. Nguyên tắc an toàn: theo dõi ít nhất qua một chu kỳ nghiệp vụ đầy đủ.
Thống kê không đồng bộ giữa các replica. Trên hệ thống có replica đọc, một index có thể idx_scan = 0 trên primary nhưng được dùng nhiều trên replica (nơi truy vấn đọc chạy). Phải kiểm cả các replica trước khi xóa.
Giữ lại kịch bản khôi phục. Trước khi xóa, lưu lại câu CREATE INDEX của nó. Nếu xóa nhầm, tạo lại được — nhưng trên bảng lớn việc tạo lại tốn thời gian, nên thà chắc chắn trước.
Ba ý mang về
idx_scan = 0trongpg_stat_user_indexeschỉ ra index chưa truy vấn nào dùng — đo thật, 3 index chiếm ~40 MB và làm chậm mọi ghi mà không phục vụ đọc; câu phát hiện phải loại trừindisprimaryvàindisunique.- PostgreSQL 16 thêm
last_idx_scancho biết lần cuối index được dùng (NULL= chưa bao giờ) — phân biệt rõ "chưa dùng bao giờ" với "chưa dùng gần đây", điều màidx_scanđơn thuần không nói được. - Xóa an toàn bằng
DROP INDEX CONCURRENTLY, nhưng đừng kết luận vội: thống kê chỉ tính từ lần reset gần nhất, phải quan sát qua trọn chu kỳ nghiệp vụ, kiểm cả replica, và lưu câuCREATE INDEXđể khôi phục.
Phần sau ta bàn một quyết định thiết kế index thường gặp: Phần sau đo xem nên tạo nhiều index đơn cột hay một index ghép nhiều cột, và mỗi cách thắng ở đâu.
