Bạn khai một cột email UNIQUE và yên tâm rằng "mỗi email chỉ có một dòng". Đúng — trừ một chỗ: bạn có thể chèn bao nhiêu dòng NULL email cũng được, và PostgreSQL không hề phản đối. Bài này mổ xẻ ràng buộc duy nhất từ bên trong: nó thật ra là một index B-tree, khác gì với CREATE UNIQUE INDEX, và vì sao NULL lại lọt qua — tất cả đo thật trên PostgreSQL 16.
Ràng buộc duy nhất là một index, không phải phép màu
Khi bạn khai UNIQUE trên một cột, PostgreSQL tự tạo một unique index B-tree để cưỡng chế nó. Không có index thì mỗi lần INSERT sẽ phải quét toàn bảng để xem giá trị đã tồn tại chưa — quá đắt. Index vừa là công cụ kiểm tra trùng, vừa là cấu trúc tra cứu nhanh.
CREATE TABLE tk (id bigserial PRIMARY KEY, email text UNIQUE, sdt text);
Xem lại bảng bằng \d tk, ta thấy hai index tự sinh — một cho khóa chính, một cho ràng buộc duy nhất:
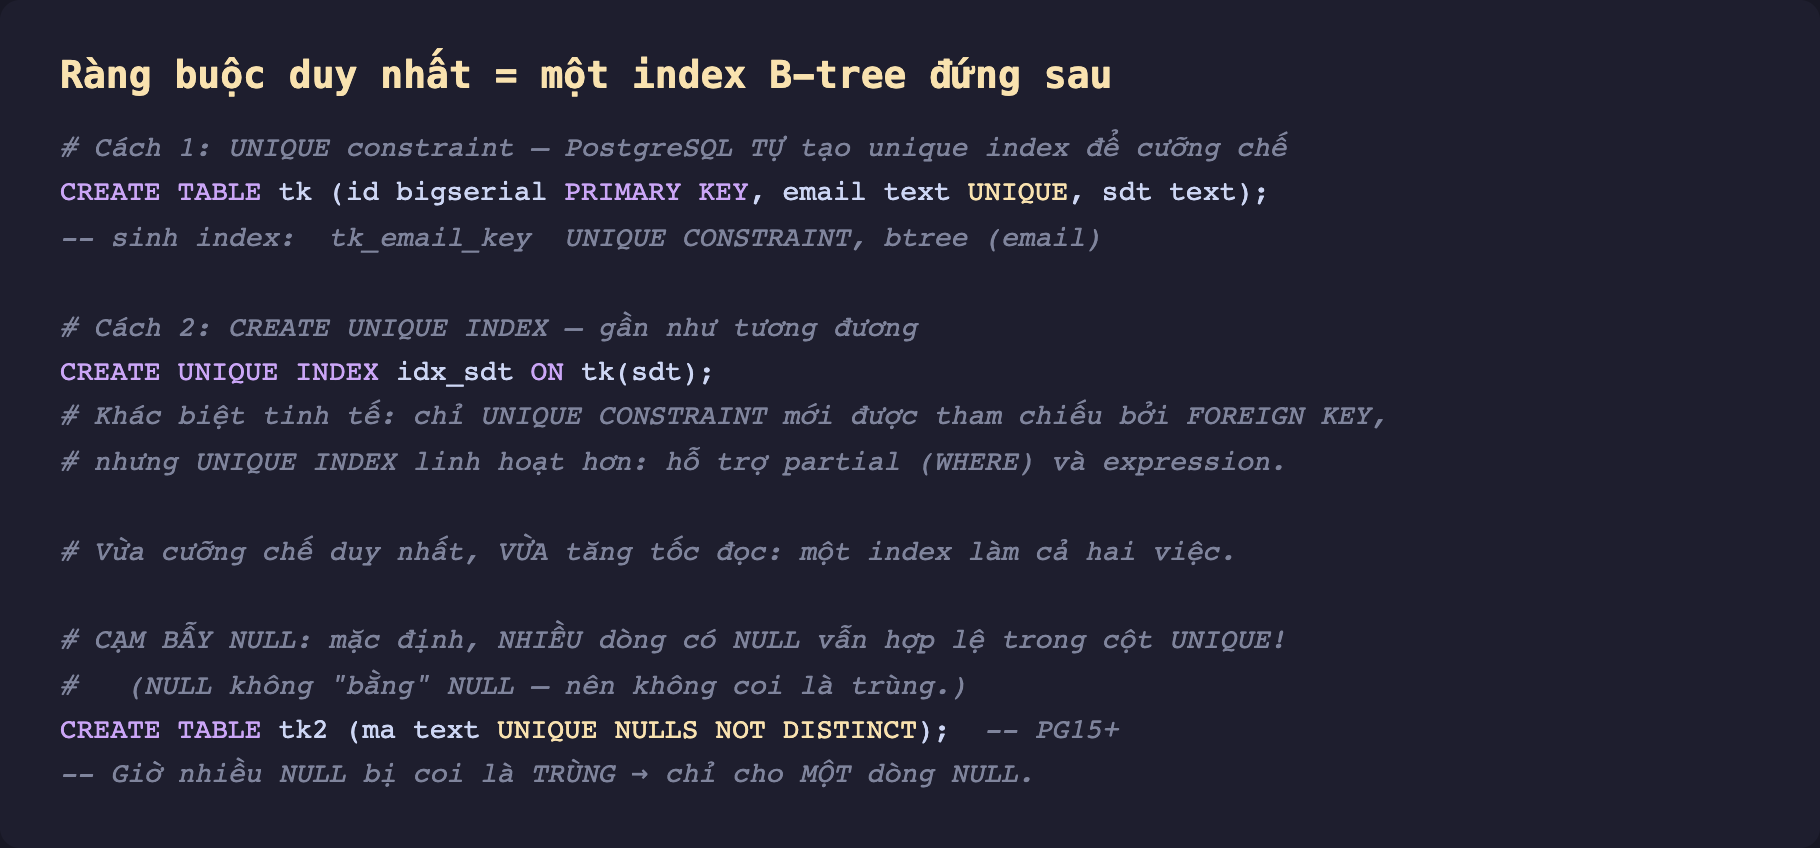
Hình 1: Hai cách tạo ràng buộc duy nhất. UNIQUE trên cột sinh ra index tự động; CREATE UNIQUE INDEX tạo thủ công cùng hiệu lực. Cả hai đều là B-tree và đều tăng tốc truy vấn lọc theo cột đó.
-- Cách 2: tạo unique index thủ công, hiệu lực tương đương ràng buộc
CREATE UNIQUE INDEX idx_sdt ON tk(sdt);
Khác biệt tinh tế giữa hai cách: chỉ UNIQUE CONSTRAINT (khai ở tầng ràng buộc) mới được FOREIGN KEY của bảng khác tham chiếu tới. Ngược lại, CREATE UNIQUE INDEX linh hoạt hơn: nó hỗ trợ partial index (WHERE ...) và expression index (lower(email)) — hai thứ mà ràng buộc UNIQUE thuần không làm được. Nếu chỉ cần cưỡng chế duy nhất đơn giản, dùng UNIQUE; nếu cần duy nhất có điều kiện, dùng unique index thủ công.
Chèn trùng: lỗi thật trông ra sao
Ràng buộc chỉ có nghĩa khi nó thực sự chặn. Chèn một email đã tồn tại, PostgreSQL từ chối ngay ở tầng CSDL:
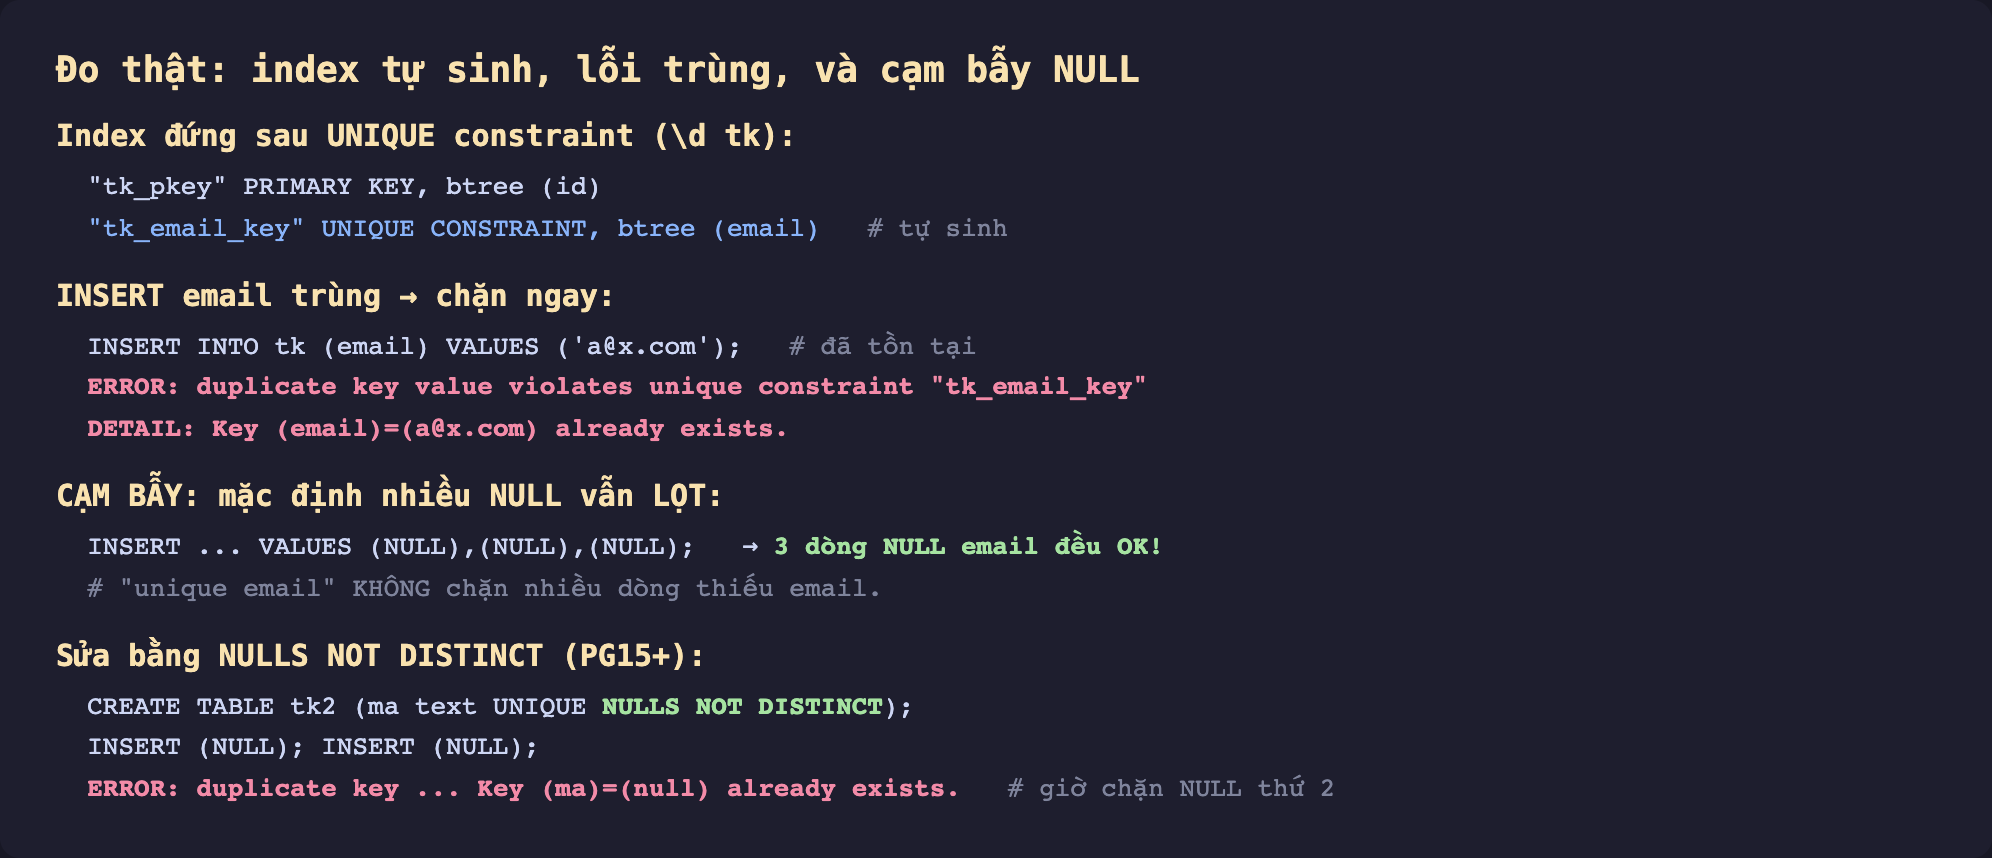
Hình 2: Đo thật trên PostgreSQL 16. Chèn email trùng bị chặn ngay với thông báo duplicate key value violates unique constraint, kèm dòng DETAIL chỉ đúng giá trị gây trùng. Nhưng ba dòng NULL email lại lọt hết.
INSERT INTO tk (email) VALUES ('a@x.com');   -- lần hai, email đã tồn tại
-- ERROR:  duplicate key value violates unique constraint "tk_email_key"
-- DETAIL:  Key (email)=(a@x.com) already exists.
Dòng DETAIL rất đáng giá khi gỡ lỗi: nó nói cột nào và giá trị nào gây trùng. Ứng dụng nên bắt lỗi này (mã SQLSTATE 23505) và dịch sang thông báo thân thiện thay vì để ngoại lệ 500 lọt ra người dùng.
Cái bẫy NULL: "duy nhất" không chặn được nhiều dòng trống
Đây là chỗ khiến nhiều người ngã. Theo chuẩn SQL, NULL không bằng bất kỳ giá trị nào, kể cả một NULL khác. Vì hai NULL không được coi là "bằng nhau", chúng không bị coi là trùng — nên một cột UNIQUE chấp nhận vô số dòng NULL:
INSERT INTO tk (email) VALUES (NULL), (NULL), (NULL);   -- cả 3 đều OK!
SELECT count(*) FROM tk WHERE email IS NULL;            -- 3
Hệ quả thực tế: nếu bạn định nghĩa email UNIQUE với ý "mỗi người dùng một email duy nhất", nhưng cho phép email để trống, thì ràng buộc không ngăn được ba tài khoản cùng thiếu email. Đây thường không phải điều bạn muốn.
PostgreSQL 15 trở lên cho cách sửa gọn: NULLS NOT DISTINCT. Khai như vậy thì các NULL bị coi là bằng nhau, và chỉ một dòng NULL được phép:
CREATE TABLE tk2 (id int, ma text UNIQUE NULLS NOT DISTINCT);
INSERT INTO tk2 VALUES (1, NULL);
INSERT INTO tk2 VALUES (2, NULL);
-- ERROR:  duplicate key value violates unique constraint "tk2_ma_key"
-- DETAIL:  Key (ma)=(null) already exists.
Trước PostgreSQL 15, muốn cùng hiệu quả bạn phải dùng một partial unique index kết hợp — ví dụ CREATE UNIQUE INDEX ON tk (email) WHERE email IS NOT NULL để chỉ ép duy nhất trên các dòng có email, hoặc tách một cột "định danh" NOT NULL riêng. NULLS NOT DISTINCT làm chuyện đó thành một dòng khai báo.
Đánh đổi cần cân nhắc
Ràng buộc duy nhất không miễn phí. Mỗi index unique là một cấu trúc phải cập nhật theo từng lần ghi: INSERT và UPDATE cột đó đều phải sửa cả B-tree, và phải kiểm tra trùng trước khi cho qua. Trên bảng ghi rất nhiều, mỗi ràng buộc duy nhất là một khoản chi cho đường ghi. Đừng rải UNIQUE lên mọi cột "nghe có vẻ nên duy nhất" — chỉ đặt ở nơi tính duy nhất là quy tắc nghiệp vụ thật.
Ngược lại, vì ràng buộc duy nhất chính là một index, bạn được một index tra cứu miễn phí kèm theo. Một cột vừa cần duy nhất vừa hay bị lọc WHERE email = ... thì UNIQUE giải quyết cả hai — không cần tạo thêm index riêng.
Ba ý mang về
- Ràng buộc
UNIQUEđược cưỡng chế bằng một index B-tree tự sinh — nó vừa chặn trùng vừa tăng tốc tra cứu theo cột đó; không cần thêm index riêng cho cột đãUNIQUE. UNIQUEconstraint vàCREATE UNIQUE INDEXgần tương đương nhưng không giống hệt: chỉ ràng buộc mới đượcFOREIGN KEYtham chiếu, còn unique index thủ công mới hỗ trợ partial (WHERE) và expression.- Mặc định, cột
UNIQUEcho nhiều dòng NULL vì NULL không bằng NULL — dùngNULLS NOT DISTINCT(PostgreSQL 15+) hoặc partial unique index để chỉ cho một dòng NULL khi nghiệp vụ đòi hỏi.
Phần sau ta bước sang một cơ chế thú vị: khi truy vấn dùng nhiều điều kiện, PostgreSQL không nhất thiết chọn một index mà có thể kết hợp nhiều index cùng lúc. Phần sau nói về bitmap scan — cách planner gộp kết quả từ vài index qua một bitmap trong bộ nhớ.
