Bạn có hai cột hay lọc chung: trang_thai và tinh_id. Mỗi cột đã có index riêng, nhưng khi lọc cả hai bằng AND, mỗi index một mình lại khớp hàng chục nghìn dòng — không đủ chọn lọc để đáng dùng. PostgreSQL có một nước đi thứ ba mà nhiều người không để ý: nó dùng cả hai index cùng lúc, giao kết quả lại, rồi mới chạm vào bảng. Cơ chế đó gọi là bitmap scan. Bài này mổ xẻ nó trên một bảng 2 triệu dòng thật.
Vấn đề: hai index, không cái nào đủ chọn lọc
Bảng don (đơn hàng) có 2 triệu dòng, index riêng trên trang_thai và tinh_id. Phân bố dữ liệu thật:
trang_thai = 3→ 249.565 dòng (một phần tám bảng)tinh_id = 10→ 31.690 dòng- Cả hai cùng lúc → chỉ 3.928 dòng
CREATE INDEX idx_don_tt   ON don(trang_thai);
CREATE INDEX idx_don_tinh ON don(tinh_id);

SELECT count(*) FROM don WHERE trang_thai = 3 AND tinh_id = 10;
Nếu chỉ dùng một index — ví dụ idx_don_tinh cho tinh_id = 10 — planner phải đọc 31.690 dòng từ heap rồi lọc bỏ những dòng trang_thai <> 3. Nếu dùng idx_don_tt thì còn tệ hơn: 249.565 dòng. Cả hai đều lãng phí. Điều ta muốn là giao hai tập lại trước khi đọc bảng.
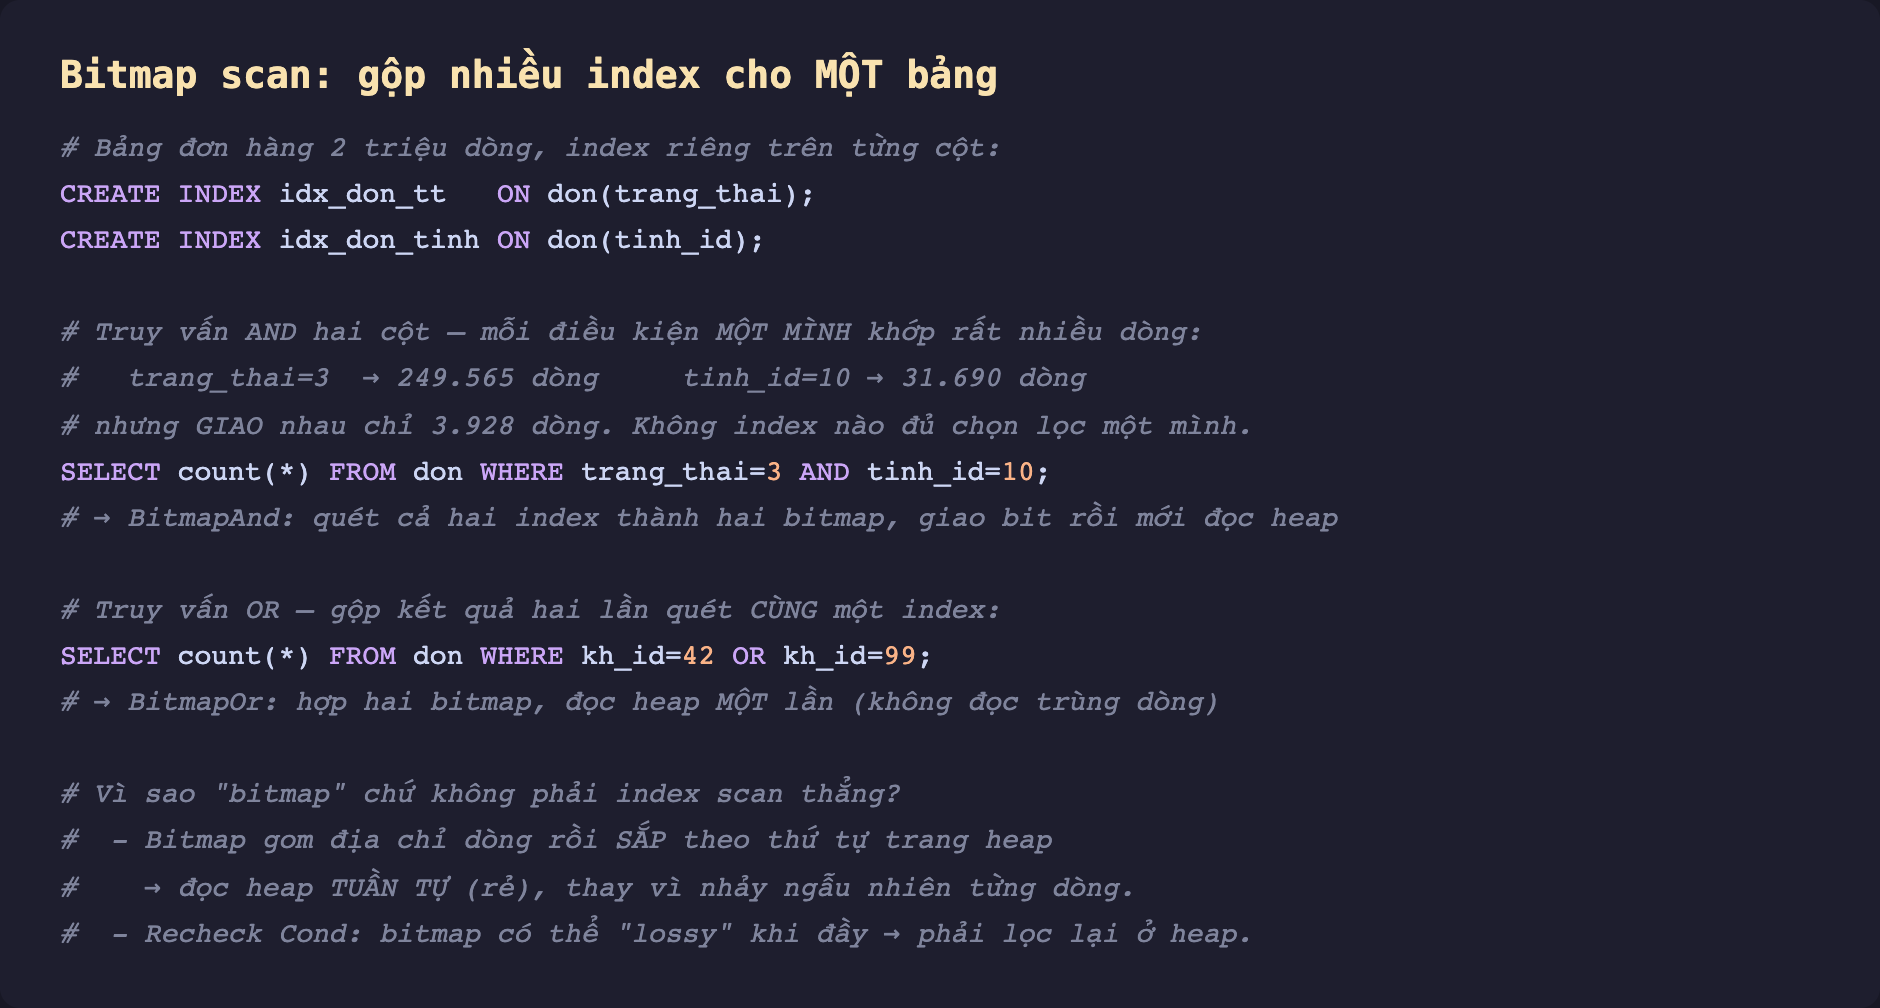
Hình 1: Hai kiểu bitmap gộp index. BitmapAnd giao hai bitmap khi điều kiện nối bằng AND; BitmapOr hợp hai bitmap khi nối bằng OR. Cả hai đều đọc heap đúng một lần, theo thứ tự trang.
BitmapAnd: giao hai bitmap trước khi chạm bảng
Đây là kế hoạch thật mà PostgreSQL 16 chọn:
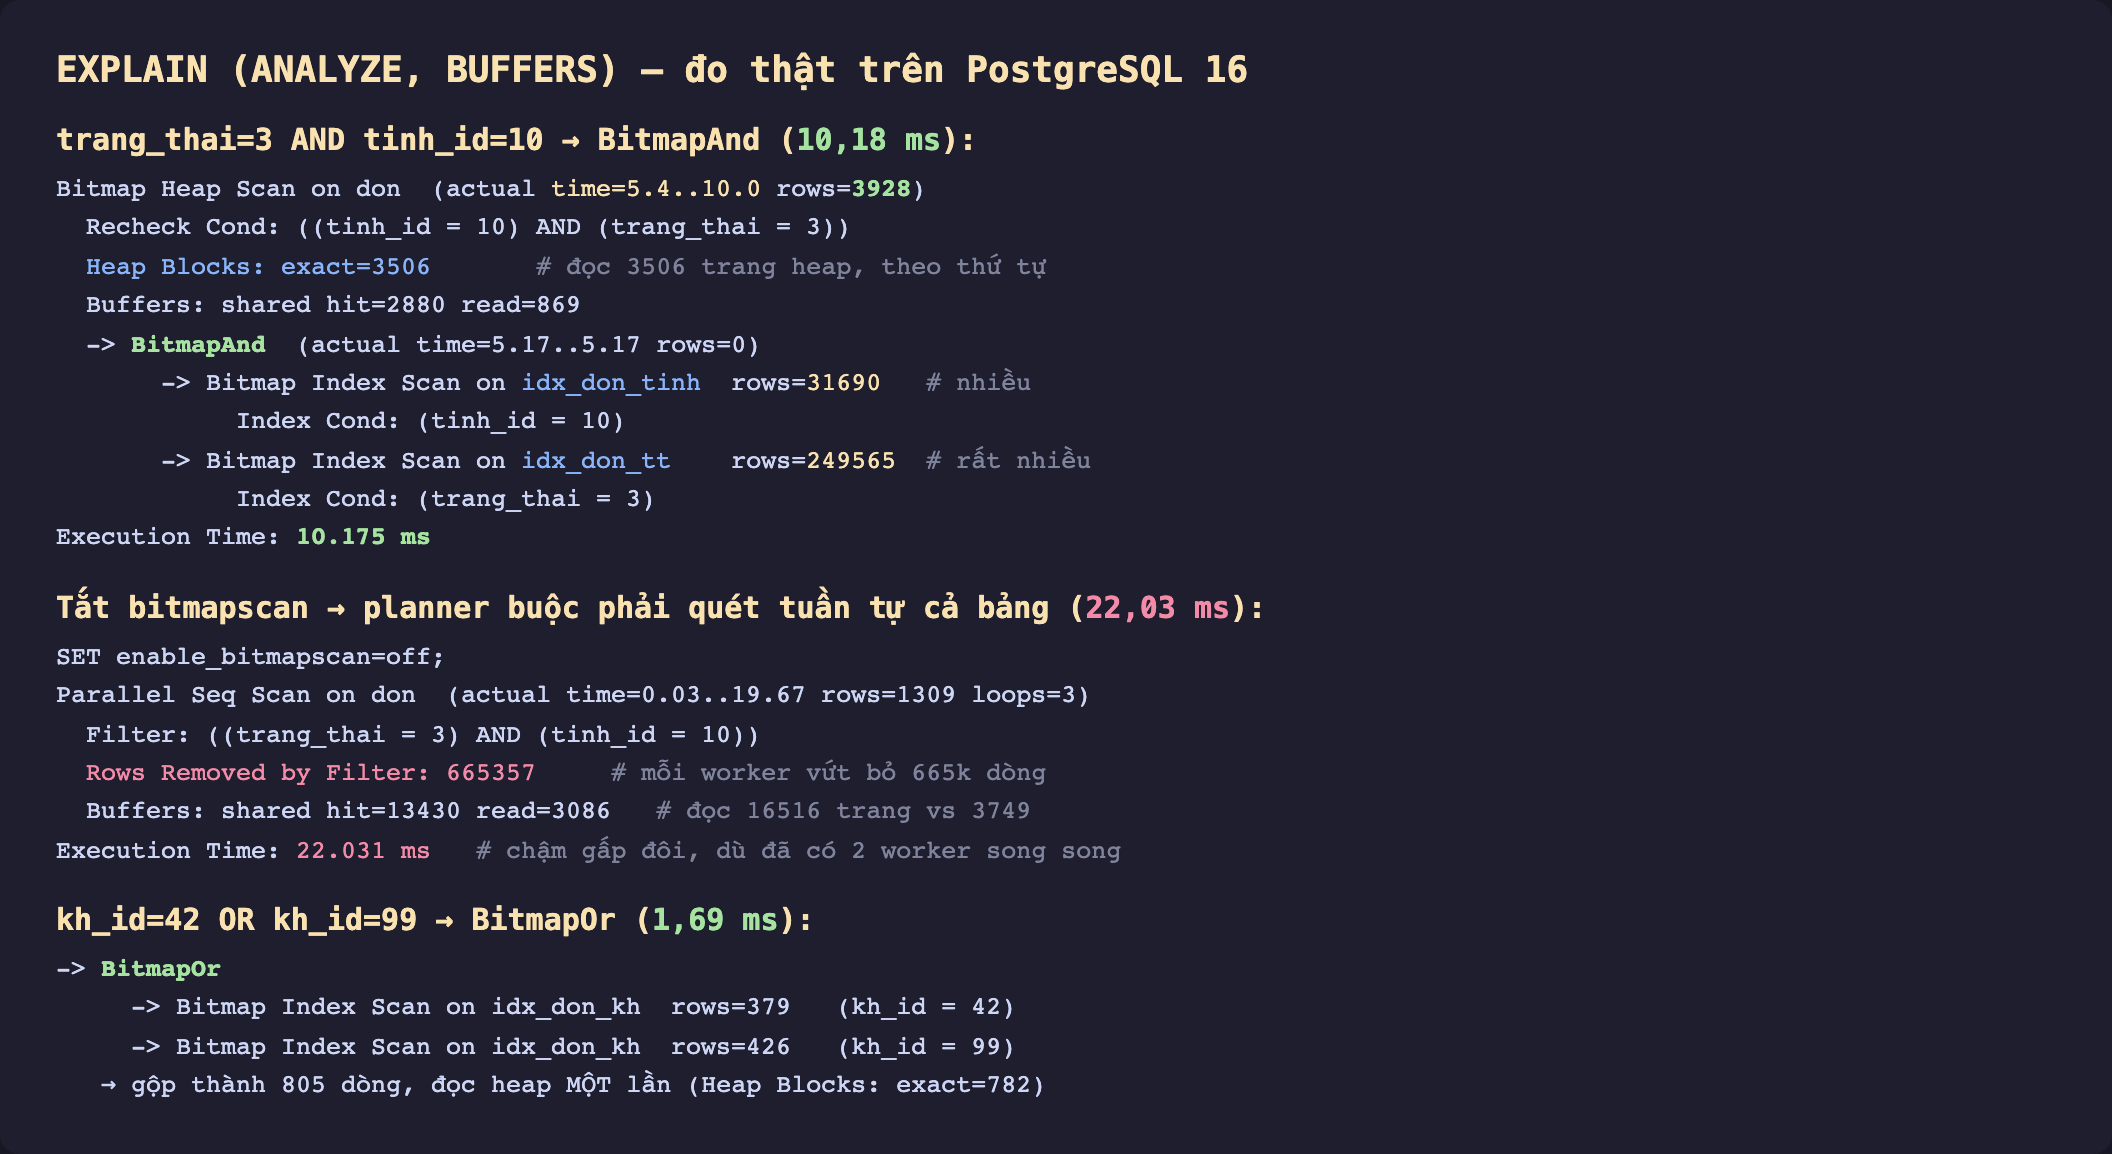
Hình 2: BitmapAnd chạy hai Bitmap Index Scan (31.690 và 249.565 dòng), giao chúng thành 3.928 dòng, rồi Bitmap Heap Scan đọc 3.506 trang heap trong 10,18 ms. Tắt bitmap đi, planner phải quét tuần tự cả bảng và mất 22 ms.
Đọc kế hoạch từ dưới lên:
- Hai
Bitmap Index Scanchạy trên hai index. Chúng không trả về dòng — chúng dựng một bitmap trong bộ nhớ, mỗi bit ứng với một dòng (hoặc một trang) thỏa điều kiện của index đó. BitmapAndgiao hai bitmap bằng phép AND từng bit. Kết quả là bitmap chỉ giữ dòng thỏa cả hai điều kiện — ước lượng 3.828 dòng, thực tế 3.928.Bitmap Heap Scanđọc heap theo bitmap cuối cùng — chỉ 3.506 trang, và đọc theo thứ tự trang tăng dần.
Con số đắt giá nhất: khi tắt bitmap (SET enable_bitmapscan=off), planner không còn cách gộp index nào khác nên rơi về Parallel Seq Scan — quét cả 2 triệu dòng, mỗi worker loại bỏ 665.357 dòng bằng Filter, đọc 16.516 trang và mất 22,03 ms dù đã có hai worker song song. Bitmap chỉ đọc 3.749 trang và xong trong 10,18 ms.
Vì sao phải qua bitmap, không index scan thẳng?
Câu hỏi tự nhiên: sao không cứ index scan trên một index rồi lọc phần còn lại? Hai lý do:
Thứ nhất — gộp được nhiều index. Index scan thường chỉ dùng đúng một index. Bitmap là cách duy nhất để giao (AND) hay hợp (OR) kết quả từ nhiều index cho cùng một bảng.
Thứ hai — thứ tự đọc heap. Index scan trả về dòng theo thứ tự của index, nghĩa là địa chỉ heap nhảy lung tung — mỗi dòng có thể ở một trang ngẫu nhiên (random I/O, đắt: random_page_cost=4 so với seq_page_cost=1). Bitmap thì gom hết địa chỉ dòng, sắp theo thứ tự trang heap, rồi đọc tuần tự. Chú ý dòng Heap Blocks: exact=3506 — đó là số trang đọc, theo thứ tự, không quay lại trang cũ.
Recheck Cond và bitmap "lossy"
Để ý dòng Recheck Cond trong kế hoạch. Bitmap có hai chế độ: exact (mỗi bit là một dòng) và lossy (mỗi bit là một trang — dùng khi bitmap quá to, vượt work_mem). Ở chế độ lossy, bitmap chỉ nói "trang này có thể có dòng khớp", nên sau khi đọc trang, PostgreSQL phải kiểm lại điều kiện trên từng dòng — đó là việc của Recheck Cond. Trong lần đo này bitmap còn exact (Heap Blocks: exact=3506, không có dòng lossy=), nên recheck gần như không tốn gì; nhưng khi kết quả lớn và work_mem nhỏ, bitmap chuyển lossy và recheck bắt đầu ăn CPU. Đó là một lý do để canh work_mem cho các truy vấn bitmap lớn.
BitmapOr: hợp thay vì giao
Với điều kiện OR, PostgreSQL dùng BitmapOr:
SELECT count(*) FROM don WHERE kh_id = 42 OR kh_id = 99;
Nó quét idx_don_kh hai lần (379 và 426 dòng), hợp hai bitmap thành 805 dòng, rồi đọc heap một lần duy nhất (Heap Blocks: exact=782) trong 1,69 ms. Điểm hay: nếu một dòng thỏa cả hai nhánh, bitmap OR chỉ giữ nó một lần — không đọc trùng, không cần DISTINCT. Đây là lý do OR trên cùng một cột (hoặc các cột đều có index) thường nhanh bất ngờ, khác hẳn định kiến "OR luôn chậm".
Đánh đổi cần cân nhắc
Bitmap scan không phải luôn thắng. Dựng bitmap tốn công lập chỉ mục trong bộ nhớ; nếu một điều kiện đã rất chọn lọc (vài chục dòng), một Index Scan thẳng trên đúng index đó thường rẻ hơn — và planner biết điều này, nó chỉ chọn BitmapAnd khi không index nào đủ chọn lọc một mình. Ngoài ra bitmap không giữ được thứ tự dòng, nên nếu truy vấn có ORDER BY khớp với thứ tự index, index scan có thể thắng vì tránh được bước sort. Đừng ép kế hoạch bằng tay ngoài lúc thử nghiệm — hãy để EXPLAIN ANALYZE nói cho bạn biết cái nào thực sự nhanh trên dữ liệu của bạn.
Ba ý mang về
- Bitmap scan cho phép PostgreSQL dùng nhiều index cùng lúc trên một bảng:
BitmapAndgiao các điều kiệnAND,BitmapOrhợp các điều kiệnOR— hữu ích nhất khi không index nào đủ chọn lọc một mình (ở đây 249k giao 31k còn 3.928 dòng, 10 ms so với 22 ms khi seq scan). - Bitmap tồn tại để đọc heap tuần tự: nó gom địa chỉ dòng, sắp theo thứ tự trang rồi đọc một lượt, biến truy cập ngẫu nhiên đắt đỏ thành tuần tự rẻ — và với
ORthì đọc heap đúng một lần, không trùng. - Đọc
Recheck CondvàHeap Blocks: bitmapexactgần như không tốn recheck, nhưng khi vượtwork_memnó chuyểnlossy(bit là cả trang) và phải kiểm lại từng dòng — canhwork_memcho truy vấn bitmap lớn.
Phần sau ta bước sang một loại index hoàn toàn khác, dành cho dữ liệu không phải kiểu vô hướng đơn giản: Phần sau nói về GIN index — cách nó lập chỉ mục bên trong jsonb, mảng, và văn bản để tìm kiếm toàn văn.
