Index B-tree đánh chỉ mục cả giá trị của một cột — tuyệt vời cho email = '...' hay tuoi > 18, nhưng vô dụng khi bạn hỏi "sản phẩm nào có tag hot?" hoặc "jsonb nào chứa {"mau":"do"}?". Với những cột chứa nhiều giá trị bên trong một ô — jsonb, mảng, văn bản — PostgreSQL có một loại index khác: GIN (Generalized Inverted Index). Nó đánh chỉ mục từng thành phần bên trong ô: mỗi khoá/giá trị jsonb, mỗi phần tử mảng, mỗi từ trong văn bản. Bài này đo GIN trên bảng 1 triệu dòng thật.
Ý tưởng: chỉ mục ngược
GIN là một inverted index — giống mục lục cuối sách. Thay vì "dòng 5 chứa các từ [a, b, c]", nó lưu chiều ngược: "từ a xuất hiện ở các dòng [5, 8, 12]". Nhờ vậy, hỏi "dòng nào chứa a?" chỉ là một lần tra khoá, không cần quét bảng.
-- 1) jsonb: toán tử chứa @>
CREATE INDEX idx_sp_tt ON sp USING gin (thuoc_tinh jsonb_path_ops);

-- 2) mảng text[]: @> nghĩa là "chứa tất cả phần tử này"
CREATE INDEX idx_sp_tags ON sp USING gin (tags);

-- 3) full-text: GIN trên biểu thức to_tsvector
CREATE INDEX idx_sp_fts ON sp USING gin (to_tsvector('simple', mo_ta));
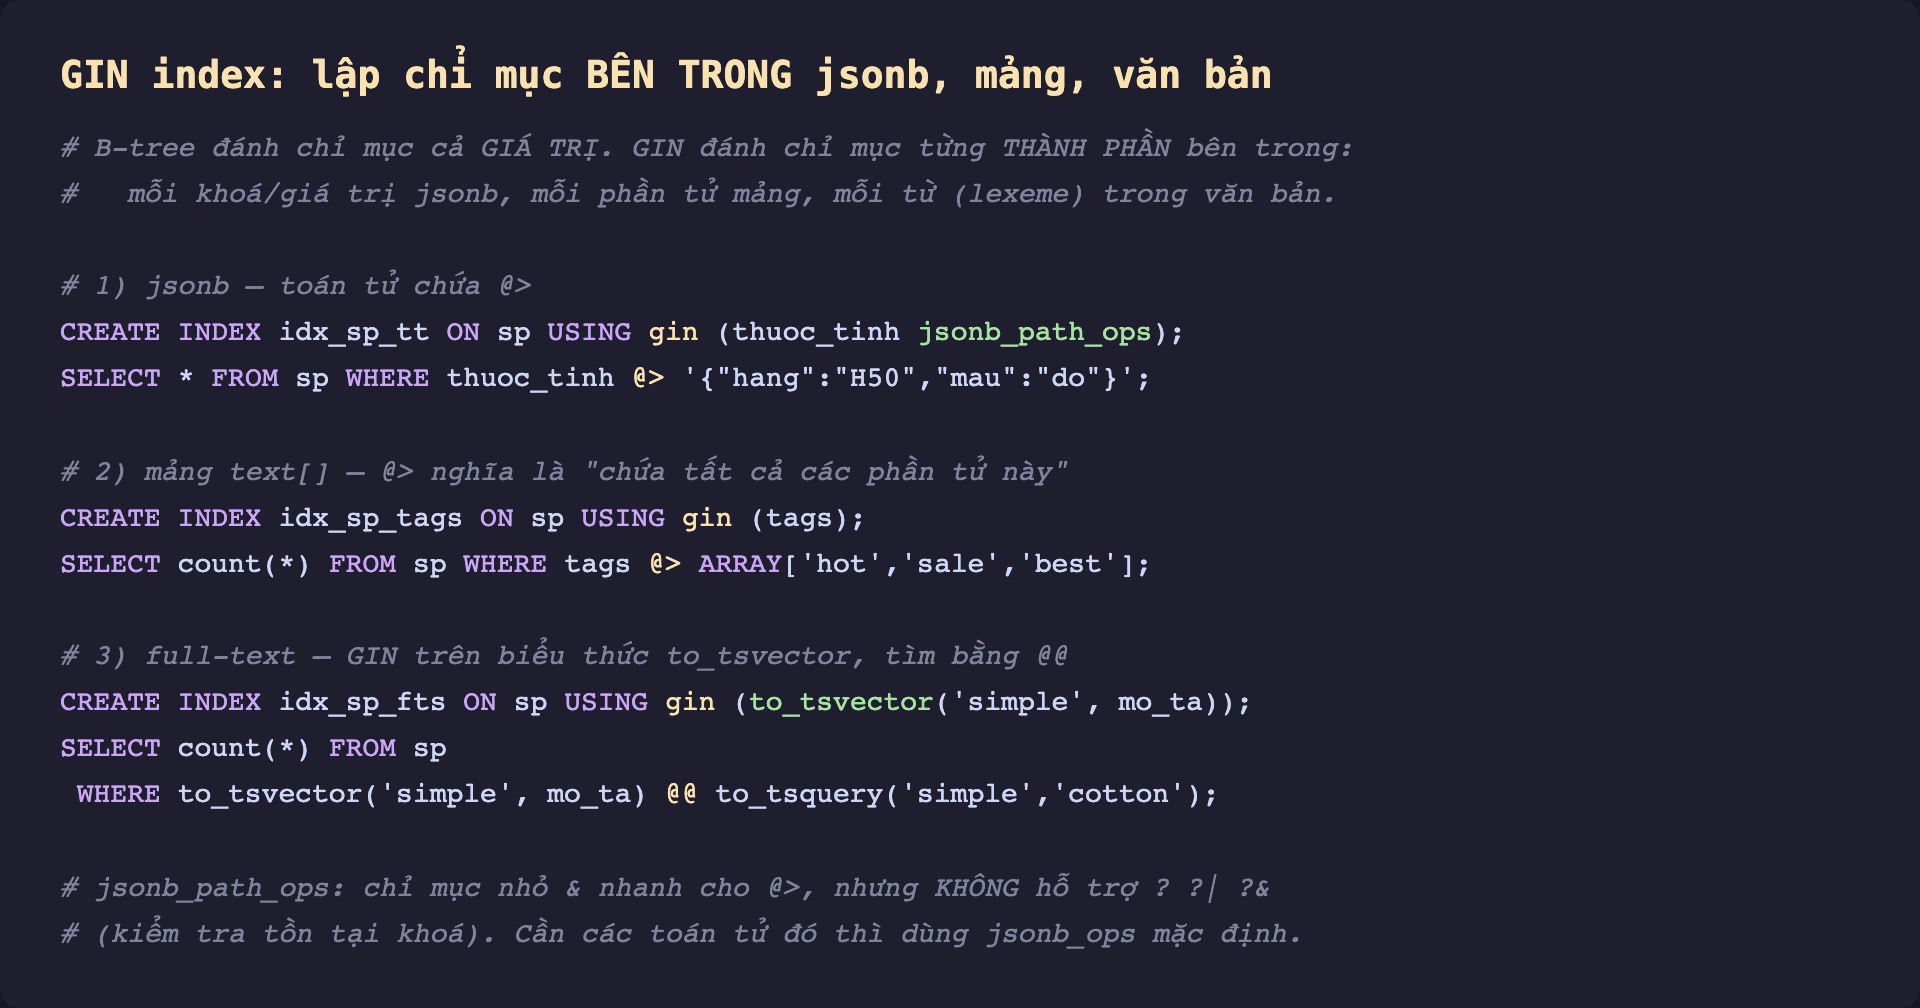
Hình 1: Ba cách dùng GIN. Điểm chung: cột chứa nhiều giá trị con, và truy vấn hỏi "có chứa X không" (@> cho jsonb/mảng, @@ cho full-text). GIN tách từng thành phần con ra làm khoá index.
Đo thật: ba truy vấn, ba mức thắng
Bảng sp có 1 triệu sản phẩm: cột thuoc_tinh kiểu jsonb, tags kiểu text[], mo_ta kiểu text. Chạy EXPLAIN (ANALYZE, BUFFERS) trước và sau khi tạo GIN:
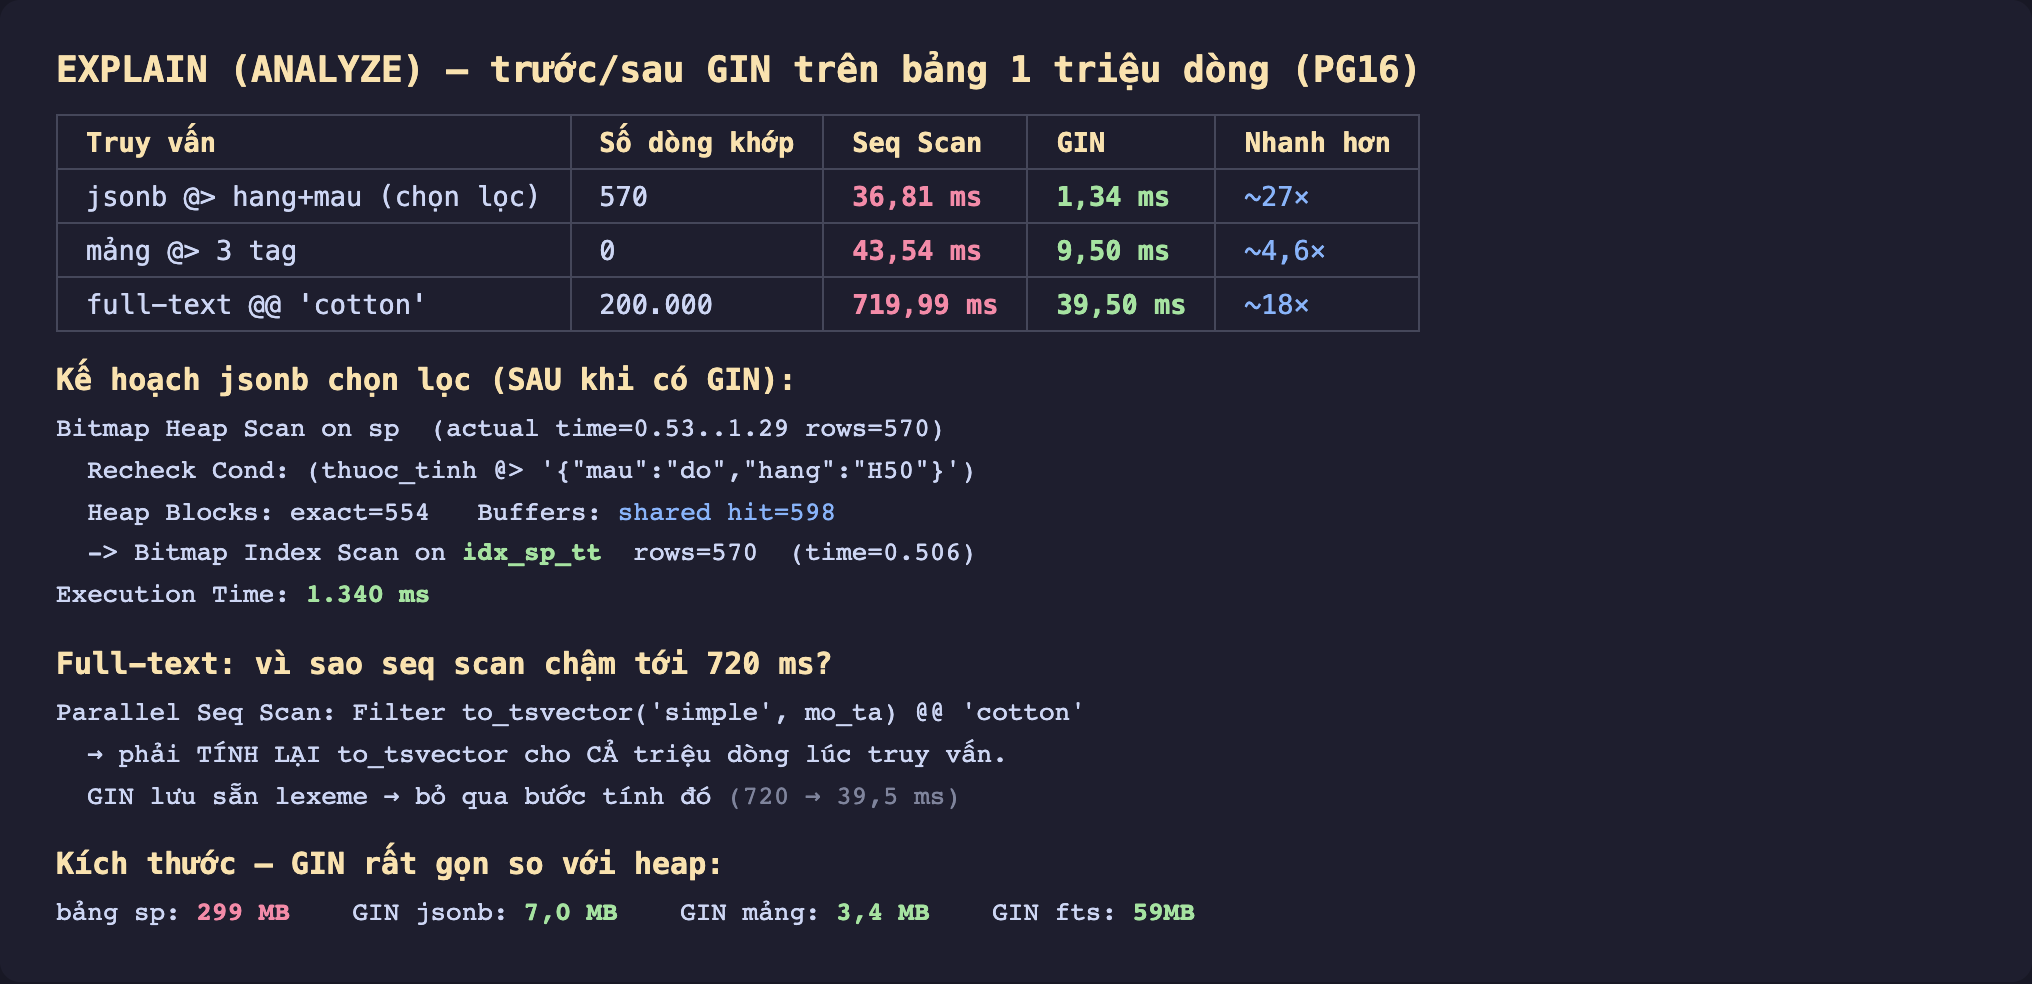
Hình 2: Trước/sau GIN. jsonb chọn lọc: 36,81 ms → 1,34 ms (~27×). Full-text cotton (200.000 dòng): 719,99 ms → 39,50 ms (~18×). GIN jsonb và mảng rất gọn (7 MB, 3,4 MB) so với bảng 299 MB.
Đọc kỹ ba dòng:
jsonb chọn lọc (570 dòng) — truy vấn thuoc_tinh @> '{"hang":"H50","mau":"do"}'. Không index, PostgreSQL quét tuần tự cả triệu dòng, loại bỏ 333k dòng mỗi worker: 36,81 ms. Có GIN, nó tra hai khoá hang=H50 và mau=do, giao lại, đọc đúng 554 trang heap: 1,34 ms. Nhanh gấp 27 lần.
Full-text (200.000 dòng) — đây là ca thắng đậm nhất về ý nghĩa. Không index, mệnh đề to_tsvector('simple', mo_ta) @@ to_tsquery('cotton') buộc PostgreSQL tính lại to_tsvector cho cả triệu dòng ngay lúc truy vấn — tách từ, chuẩn hoá, dựng vector — mất 719,99 ms. GIN lưu sẵn các lexeme (từ đã chuẩn hoá), nên bỏ hẳn bước tính đó và chỉ tra khoá cotton: 39,50 ms. Điểm mấu chốt: GIN full-text không chỉ tránh quét bảng, nó còn tránh tính toán lại — đó là lý do khác biệt lớn tới vậy dù kết quả tận 200k dòng.
Mảng (0 dòng) — tags @> ARRAY['hot','sale','best']. Kể cả khi không dòng nào khớp, GIN biết điều đó sau khi giao ba danh sách khoá (9,50 ms) thay vì quét cả bảng để chắc chắn (43,54 ms).
jsonb_ops hay jsonb_path_ops?
Với jsonb, GIN có hai lớp toán tử:
jsonb_ops(mặc định): đánh chỉ mục cả khoá lẫn giá trị. Hỗ trợ nhiều toán tử:@>(chứa),?(có khoá này không),?|,?&.jsonb_path_ops: chỉ đánh chỉ mục đường dẫn tới giá trị. Index nhỏ hơn và nhanh hơn cho truy vấn@>, nhưng không hỗ trợ các toán tử kiểm tra tồn tại khoá (?,?|,?&).
Ở đây ta dùng jsonb_path_ops (index chỉ 7 MB) vì chỉ cần @>. Nếu ứng dụng còn hỏi "jsonb này có khoá khuyen_mai không" thì phải dùng jsonb_ops. Chọn sai lớp toán tử là index nằm đó mà truy vấn vẫn seq scan — không lỗi, chỉ chậm.
Đánh đổi: GIN không miễn phí
Ba cái giá cần biết trước khi rải GIN khắp nơi:
Ghi chậm hơn B-tree. Mỗi lần INSERT/UPDATE một ô jsonb hay mảng, GIN phải cập nhật nhiều khoá (một cho mỗi phần tử con), không phải một. PostgreSQL giảm nhẹ bằng fastupdate (gom cập nhật vào một danh sách chờ rồi trộn sau), nhưng bản chất GIN vẫn nặng đường ghi hơn B-tree. Cân nhắc với bảng ghi rất nhiều.
Kích thước không phải lúc nào cũng nhỏ. GIN jsonb và mảng ở đây rất gọn (7 MB, 3,4 MB) vì mỗi ô ít phần tử con. Nhưng GIN full-text lên tới 59 MB — vì mỗi mô tả sinh ra nhiều lexeme, và mỗi lexeme là một khoá. Văn bản càng dài, index full-text càng phình. Vẫn nhỏ hơn heap 299 MB, nhưng đừng cho rằng "GIN luôn tí hon".
Không thắng khi truy vấn kém chọn lọc. Đo thêm tags @> ARRAY['hot','moi'] khớp 125.000 dòng (12,5% bảng): GIN vẫn được dùng nhưng bước đọc heap thống trị, kết quả 55 ms — chậm hơn cả seq scan. Khi bạn lấy về một phần lớn bảng, không index nào cứu được; chi phí nằm ở việc đọc dữ liệu, không ở việc tìm nó.
Ba ý mang về
- GIN đánh chỉ mục các thành phần bên trong một ô — mỗi khoá jsonb, mỗi phần tử mảng, mỗi lexeme văn bản — nên trả lời "có chứa X không" (
@>,@@) bằng một lần tra khoá thay vì quét bảng: jsonb chọn lọc nhanh gấp 27 lần, full-text gấp 18 lần trong phép đo này. - Full-text được lợi kép: GIN vừa tránh quét bảng vừa tránh tính lại
to_tsvectorcho từng dòng — nguồn gốc của khác biệt 720 ms so với 39,5 ms; luôn tạo GIN trên biểu thứcto_tsvectorbạn thật sự dùng trong truy vấn. - GIN nặng đường ghi và không luôn nhỏ (index full-text ở đây 59 MB), lại không thắng khi truy vấn lấy về phần lớn bảng — chọn
jsonb_path_opskhi chỉ cần@>, và chỉ đặt GIN ở nơi truy vấn thật sự chọn lọc.
Phần sau ta sang một họ index khác hẳn, chuyên cho dữ liệu có thứ tự không gian: Phần sau nói về GiST — cách nó đánh chỉ mục hình học, kiểu range, và tìm kiếm láng giềng gần nhất (KNN).
